
Apuntes · Capítulo 1Lenguajes regulares
Lenguajes y autómatas finitos
Lenguajes y autómatas finitos
En Análisis y Diseño de Algoritmos resolvieron problemas: dado un grafo, el camino más corto; dado un arreglo, el k-ésimo menor. El curso terminó con una sospecha incómoda. Para algunos problemas, como colorear un grafo con tres colores, nadie conoce un algoritmo rápido, y tampoco nadie ha demostrado que no exista. Este curso va al fondo de esa sospecha, y para eso tiene que empezar más atrás, con tres preguntas.
- ¿Qué es calcular? Hasta ahora “algoritmo” fue algo que se reconoce al verlo: pseudocódigo, un programa en C++. Para demostrar que un problema no tiene algoritmo, eso no alcanza. Hay que decir con precisión matemática qué es una máquina que calcula, y recién entonces se puede razonar sobre todas las máquinas posibles a la vez.
- ¿Qué no se puede calcular? Hay problemas bien definidos, con respuesta sí o no para cada entrada, que ningún programa resuelve, por más tiempo y memoria que tenga. No es que nadie haya encontrado el programa: se demuestra que no existe. El más famoso pregunta si un programa dado termina con una entrada dada.
- ¿Qué cuesta demasiado? Entre los problemas que sí se pueden resolver, algunos parecen exigir un tiempo que crece exponencialmente con la entrada. Aquí están los problemas NP-completos que conocieron en Algoritmos, y la pregunta abierta más importante del área: si P es igual a NP.
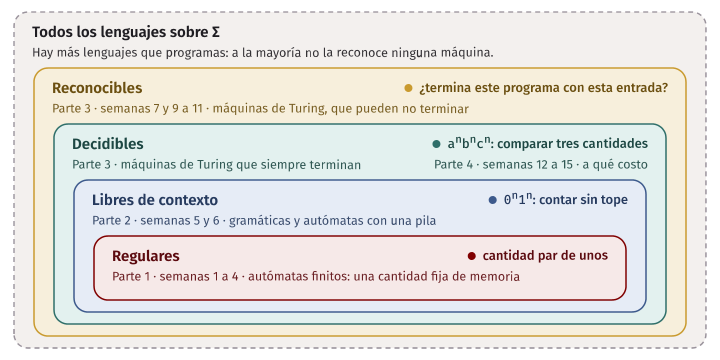
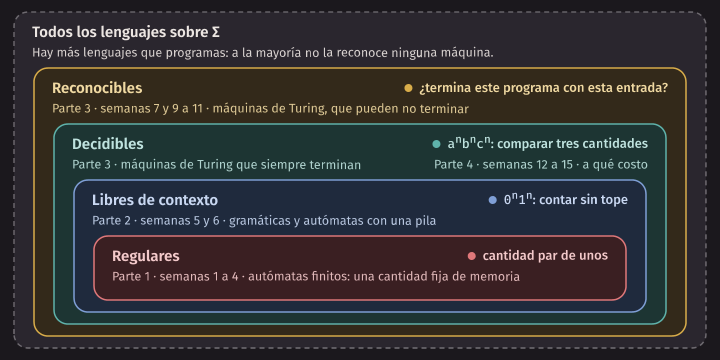
El camino va de la máquina más simple a la más general. Cada modelo se define, se programa, y se le busca el límite: algo que no puede hacer, con su demostración. Son cuatro partes.
| Parte | Semanas | El modelo | Su límite |
|---|---|---|---|
| 1. Lenguajes regulares | 1 a 4 | Autómatas finitos: una cantidad fija de memoria | No pueden contar sin tope |
| 2. Lenguajes libres de contexto | 5 y 6 | Gramáticas y autómatas con una pila | No pueden comparar tres cantidades |
| 3. Computabilidad | 7 y 9 a 11 | Máquinas de Turing: memoria sin límite | Hay problemas que ninguna resuelve |
| 4. Complejidad | 12 a 15 | Máquinas de Turing con tiempo y espacio medidos | Lo que cuesta demasiado, y lo que sigue abierto |
Esta semana tiene dos mitades. En la primera fijamos el vocabulario de todo el curso: cadenas y lenguajes. Todo problema con respuesta sí o no se va a escribir como un lenguaje, y toda máquina se va a juzgar por el lenguaje que reconoce. En la segunda aparece la primera máquina, el autómata finito determinista: lee su entrada una sola vez, de izquierda a derecha, y solo recuerda en cuál de una cantidad fija de estados está. Es poco, y aun así alcanza para mucho. Aprenderemos a diseñar uno, a demostrar que hace lo que decimos, y a combinar dos en uno solo con la construcción del producto.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Alfabetos y cadenas y Lenguajes. Antes de la sesión B, Máquinas con memoria fija. Con eso llegan con el vocabulario y con el primer autómata ya visto.
En clase: Sesión A, de Alfabetos y cadenas a Hay más lenguajes que programas. Sesión B, de Máquinas con memoria fija a Complemento.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, La definición formal de un DFA otra vez y El código de la semana. Para ampliar, Lo que un DFA no puede hacer y las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, capítulo 0, la parte sobre cadenas y lenguajes, y sec. 1.1 (Finite Automata). Erickson, Models of Computation, notas 1 (Strings) y 3 (Finite-state automata). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-01. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/dfa_sim.
Alfabetos y cadenas
Un alfabeto (alphabet) es un conjunto finito y no vacío. Sus elementos se llaman símbolos (symbols). Lo escribimos . Algunos alfabetos que usaremos:
- , el alfabeto binario. Es el de casi todos los ejemplos.
- , cuando conviene que los símbolos no parezcan números.
- , o el conjunto de los caracteres ASCII, cuando la cadena es un texto.
Qué son los símbolos no importa. Importa que sean finitos y que se puedan distinguir uno de otro.
Una cadena (string) sobre es una secuencia finita de símbolos de , escritos uno detrás de otro: es una cadena sobre , y es una cadena sobre . Usaremos las letras del final del abecedario, , , , , , , para nombrar cadenas, y las del principio, , , , para nombrar símbolos.
La longitud de una cadena es la cantidad de símbolos que tiene, contando las repeticiones. Se escribe . Así, y .
Hay exactamente una cadena de longitud 0: la que no tiene ningún símbolo. Se llama cadena vacía (empty
string) y se escribe . La letra no es un símbolo del alfabeto: es el nombre que le
damos a esa cadena para poder escribirla, porque de otro modo no se vería en el papel. En C++ es "".
El conjunto de todas las cadenas sobre se escribe . Tiene a , a cada símbolo
como cadena de longitud 1, y sigue sin fin. El programa strings_demo las lista en un orden que usaremos mucho:
primero las más cortas y, entre las de igual longitud, en el orden del alfabeto.
$ build/strings_demo
Σ = {0, 1}. Las cadenas de Σ* con longitud a lo sumo 3, en orden:
  ε 0 1 00 01 10 11 000 001 010 011 100 101 110 111

 n   cadenas de longitud n   cadenas de longitud ≤ n
 0                 1                        1
 1                 2                        3
 2                 4                        7
 3                 8                       15
 4                16                       31
 5                32                       63
 6                64                      127
 7               128                      255
 8               256                      511
 9               512                     1023
10              1024                     2047
El programa imprime además un ejemplo de prefijos y sufijos, que está unas líneas más abajo. Las dos columnas de la tabla se explican contando. Una cadena de longitud se arma eligiendo veces un símbolo, y cada elección tiene opciones: hay cadenas de longitud . Con son , y de longitud a lo sumo son
Para la fórmula da : la cadena vacía.
Dos cosas sobre que conviene tener claras desde ahora:
- es infinito, pero cada una de sus cadenas es finita. No existen cadenas infinitas en este curso.
- se puede listar: en el orden de arriba, cada cadena aparece en alguna posición finita. La cadena es la número 13 si contamos desde 1. Esta observación vuelve al final de la sesión.
Concatenación
La concatenación (concatenation) de dos cadenas y es la cadena que resulta de escribir a continuación de . Se escribe . Si y , entonces y .
- La cadena vacía es el elemento neutro: , para toda .
- Es asociativa: . Por eso se escribe sin paréntesis.
- No es conmutativa: .
Repetir una cadena veces se escribe con un exponente: , con copias. Así, y . Por convención , igual que un producto sin factores vale 1. El reverso (reversal) de , que se escribe , es la misma cadena leída de derecha a izquierda: .
Error común. Leer como el número cero al cubo. En este curso los símbolos no son números: es la cadena , y tiene longitud 5.
Prefijos, sufijos y subcadenas
Sean y dos cadenas.
- es un prefijo (prefix) de si para alguna cadena : empieza con .
- es un sufijo (suffix) de si para alguna cadena : termina con .
- es una subcadena (substring) de si para algunas cadenas , : aparece dentro de , con sus símbolos seguidos.
En las tres definiciones, las cadenas , pueden ser vacías. Por eso es prefijo, sufijo y subcadena de toda cadena, y toda cadena lo es de sí misma. Y todo prefijo y todo sufijo es una subcadena.
w = abba, |w| = 4
prefijos (5):   {ε, a, ab, abb, abba}
sufijos (5):    {ε, a, ba, bba, abba}
subcadenas (9): {ε, a, b, ab, ba, bb, abb, bba, abba}
Estas son las últimas líneas que imprime build/strings_demo. Una cadena de longitud tiene exactamente
prefijos, uno por cada longitud de 0 a , y sufijos. Subcadenas distintas tiene a lo sumo
: una por cada par de posiciones de inicio y fin, más la vacía. Para el máximo es 11, y
tiene 9 porque algunas se repiten: la subcadena aparece dos veces y la
también.
“Subcadena” exige que los símbolos estén seguidos. La cadena no es subcadena de , aunque sus dos símbolos aparezcan en ese orden.
En C++. Una cadena es un
std::string, y la cadena vacía es"", consize()igual a 0. La concatenación esu + v, un prefijo esw.substr(0, k)y un sufijo esw.substr(k). Un símbolo es unchar. Las funcionesprefixes,suffixesysubstringsdelanguages.hson las tres definiciones de arriba, escritas consubstr.
Inducción sobre cadenas
Casi todas las demostraciones de las primeras semanas son por inducción sobre la longitud de una cadena. La inducción es la de Matemática Discreta. Lo único nuevo es en qué se apoya: toda cadena no vacía se arma agregando un símbolo a una cadena más corta.
Dicho con precisión, una cadena sobre es de una de dos formas:
- , o
- , donde es una cadena sobre y es un símbolo de .
En el segundo caso, y quedan determinados por : es el último símbolo y es todo lo anterior. Esto permite definir funciones sobre cadenas por casos, igual que una función recursiva tiene un caso base y uno recursivo. La longitud y la concatenación, que arriba describimos con palabras, quedan así:
El punto de es la concatenación, que aquí escribimos de forma explícita para que se vea qué se está definiendo. La segunda columna dice: para concatenar con una cadena que termina en , se concatena con lo anterior y se agrega al final.
Con las definiciones escritas así, las propiedades se demuestran y no solo se creen. Un ejemplo corto, que además fija el esquema que seguiremos todo el curso.
Afirmación. Para todas las cadenas y , .
Demostración. Por inducción sobre la longitud de . La cadena queda fija, cualquiera.
Caso base: , es decir, . Entonces por la definición de concatenación, y .
Hipótesis de inducción: la afirmación vale para toda cadena de longitud .
Paso inductivo: sea una cadena de longitud . Como no es vacía, con . Entonces:
Con eso la afirmación vale para todas las cadenas , de cualquier longitud. ∎
La afirmación es obvia, y por eso sirve de ejemplo: lo que interesa es la forma. El caso base es la cadena vacía. El paso inductivo le quita el último símbolo a la cadena, aplica la hipótesis a lo que queda y vuelve a poner el símbolo. Cuando demostremos que un autómata es correcto, el paso inductivo será exactamente el momento en que el autómata lee un símbolo más.
Error común. Empezar la inducción en las cadenas de longitud 1. El caso base es , de longitud 0. Si se olvida, la demostración no dice nada sobre la cadena vacía, y la cadena vacía es justo la entrada con la que más programas y más autómatas fallan.
Lenguajes
Un lenguaje (language) sobre es un conjunto de cadenas sobre . Es decir, un subconjunto de . Cualquiera: no se le pide ninguna estructura ni ningún significado.
Algunos lenguajes sobre :
- , un lenguaje finito con tres cadenas.
- . Tiene a , a , a , a , y no a ni a .
- .
- : algunos ceros seguidos de la misma cantidad de unos.
- .
- , el lenguaje de todas las cadenas.
- , el lenguaje que no tiene ninguna.
Salvo el primero y el último, todos son infinitos, y ese es el caso normal. Un lenguaje infinito no se puede dar con una lista: se da con una condición que dice qué cadenas están. Todo el curso gira alrededor de una pregunta sobre esas condiciones: dado un lenguaje y una cadena , ¿se puede saber mecánicamente si ? ¿Con qué máquina? ¿Con cuánto esfuerzo?
Hay dos lenguajes pequeños que se confunden todo el tiempo.
- es el lenguaje vacío: no tiene ninguna cadena. .
- es el lenguaje que tiene una sola cadena, la cadena vacía. .
Y , sin llaves, no es un lenguaje: es una cadena. Los tres objetos son de tipos distintos, y en C++ se ve enseguida.
En C++. Si un lenguaje finito es un
std::set<std::string>, entonces es{}, un conjunto consize() == 0, y es{""}, un conjunto consize() == 1cuyo único elemento es unstd::stringconsize() == 0. La cadena es"", que ni siquiera es del mismo tipo que los otros dos.
Error común. Confundir , la cadena sin símbolos, con , el lenguaje sin cadenas. Una caja vacía no es lo mismo que no tener caja. “El autómata acepta ” dice que una cadena concreta, la vacía, está en su lenguaje. “El lenguaje del autómata es ” dice que no acepta ninguna cadena, tampoco la vacía. La sección siguiente muestra que las dos se comportan distinto en cada operación.
Operaciones sobre lenguajes
Los lenguajes son conjuntos, así que tienen las operaciones de conjuntos. Sean y lenguajes sobre .
- Unión: .
- Intersección: .
- Complemento: el complemento de es . El complemento siempre es respecto de : hay que saber cuál es el alfabeto. Lo escribimos “el complemento de ” o, en las fórmulas, .
Y tienen dos operaciones propias, que vienen de la concatenación de cadenas.
- Concatenación: . Todas las maneras de pegar una cadena de con una de , en ese orden.
- Potencias y estrella: , , y la estrella de Kleene (Kleene star) es la unión de todas las potencias:
Una cadena está en si se puede partir en cero o más trozos, cada uno de . Cero trozos da la cadena vacía, así que está en siempre, sea lo que sea. La notación es un caso de esta: las cadenas que se parten en trozos de un símbolo, que son todas.
El programa languages_demo calcula estas operaciones con dos lenguajes finitos. La estrella y el complemento
son infinitos, así que solo muestra sus cadenas más cortas.
$ build/languages_demo
A = {0, 01}    B = {ε, 1, 01}

A ∪ B = {ε, 0, 1, 01}
A ∩ B = {01}
AB    = {0, 01, 001, 011, 0101}
BA    = {0, 01, 10, 010, 101, 0101}
A²    = {00, 001, 010, 0101}
A*, hasta longitud 3:              {ε, 0, 00, 01, 000, 001, 010}
complemento de A, hasta longitud 2: {ε, 1, 00, 10, 11}

|∅| = 0    |{ε}| = 1
∅A   = ∅
{ε}A = {0, 01}
∅ ∪ A = {0, 01}
∅*   = {ε}
{ε}* = {ε}
∅⁰   = {ε}    ∅¹ = ∅
Vale la pena mirar tres cosas en esa salida.
tiene 5 cadenas y no 6. tiene 2 cadenas y tiene 3, así que hay 6 maneras de elegir y . Pero dos de ellas dan la misma cadena: y . En general , y la igualdad puede fallar.
. La cadena está en , porque , y no está en , porque toda cadena de empieza con .
y hacen cosas opuestas. Concatenar con no cambia nada: , porque . Concatenar con lo destruye todo: , porque para formar hace falta elegir una de , y no hay ninguna. En cambio, en la unión es el que no cambia nada. Es la misma relación que hay entre el 1 y el 0 en la multiplicación: hace de 1 y hace de 0.
Y la línea más rara: . Sale de la definición sin forzar nada. La potencia es por definición, y todas las demás potencias son vacías, porque . La unión de con muchos conjuntos vacíos es . Con palabras: la única cadena que se puede partir en cero o más trozos tomados de es la que se parte en cero trozos.
Idea clave. Un lenguaje es un conjunto de cadenas, y nada más. no tiene cadenas, tiene una, y las tiene todas. Las operaciones que importan son cinco: unión, intersección, complemento, concatenación y estrella.
De problemas a lenguajes
Un problema de decisión (decision problem) es un problema en el que cada entrada tiene respuesta sí o no. ¿Es un número primo? ¿Es este grafo conexo? ¿Tiene esta fórmula una asignación que la haga verdadera? ¿Compila este programa?
Para una computadora, la entrada de un problema siempre es una cadena: los bytes de un archivo, lo que llega por la entrada estándar. Así que un problema de decisión parte a en dos: las cadenas con respuesta sí y las demás. Con eso basta para describirlo.
Idea clave. Un problema de decisión es un lenguaje: el conjunto de las entradas cuya respuesta es sí. Resolver el problema es decidir, dada una cadena, si está en ese lenguaje.
“¿Es primo?” es el lenguaje
y preguntar si 11 es primo es preguntar si . Al pasar de un problema a un lenguaje hay que tomar decisiones que normalmente no se dicen:
- Cómo se escribe la entrada. Aquí, el número en binario. Un grafo se puede escribir como su lista de aristas, con algún separador. Cualquier objeto finito se puede escribir como cadena, y más adelante escribiremos para “la cadena que representa a ”. Mientras la representación sea razonable, cuál se elija no cambia lo que se puede calcular. Sí puede cambiar cuánto cuesta, y eso se verá en la parte de complejidad.
- Qué pasa con las cadenas mal formadas. Si la entrada debía ser un grafo y llega una cadena que no representa ninguno, la respuesta es no: esa cadena no está en el lenguaje. No hay un tercer caso.
- Los detalles de la representación. ¿Se permiten ceros a la izquierda? ¿Qué número representa ? Cada elección da un lenguaje distinto, aunque el problema “sea el mismo”. Cuando importe, lo diremos.
Por qué basta estudiar problemas de decisión
Muchos problemas reales no son de sí o no: piden un número, un camino, un programa traducido. Aun así, el curso entero trabaja con problemas de decisión, por tres razones.
Son lo más simple que ya es difícil. Si no se puede decidir si existe un camino de costo a lo sumo , tampoco se puede hallar el camino más barato: quien lo halla, responde de paso la pregunta de sí o no. Un resultado de imposibilidad para la versión de decisión vale entonces para la versión completa. Como este curso trata sobre todo de límites, la versión de decisión es la que conviene.
Casi siempre se puede volver. Con un programa que decide, se suele reconstruir la respuesta completa haciéndole varias preguntas. Si es un número, se pregunta “¿el bit de es 1?” para cada , y cada una de esas es una pregunta de sí o no sobre la entrada . Lo vieron en Algoritmos con los problemas de optimización y su versión con umbral.
Dan un solo tipo de objeto. Si todo problema es un lenguaje, se pueden comparar problemas que no se parecen en nada, clasificarlos por la máquina que hace falta para decidirlos, y aplicarles las mismas operaciones.
Hay más lenguajes que programas
Antes de construir ninguna máquina ya se puede responder, a grandes rasgos, la segunda pregunta del curso. El argumento es de puro conteo, y por ahora va sin formalizar: qué es exactamente un “programa” y qué es “decidir” se precisa en las semanas 7 y 9, donde este mismo argumento vuelve completo.
Los programas se pueden listar. Un programa en C++ es un archivo de texto: una cadena sobre el alfabeto de los caracteres. Vimos que todas las cadenas sobre un alfabeto se pueden poner en una lista, primero las más cortas. Si de esa lista dejamos solo las cadenas que son programas, queda una lista de todos los programas: el primero, el segundo, el tercero, sin fin, y cada programa aparece en alguna posición.
Cada programa decide a lo sumo un lenguaje: el de las entradas con las que responde sí. Entonces los lenguajes que algún programa decide también se pueden listar: es el del primer programa, el del segundo, y así.
Los lenguajes no se pueden listar. Supongamos que alguien nos da una lista cualquiera de lenguajes sobre : Vamos a construir un lenguaje que no está en ella. Listamos también las cadenas en el orden de siempre: , , , , … Y definimos
Es decir, para decidir si la cadena número entra en , miramos el lenguaje número y hacemos lo contrario. Entonces no puede ser , porque está en exactamente uno de los dos. Tampoco puede ser , porque difieren en . En general para todo , porque difieren en . El lenguaje no está en la lista.
Juntando las dos mitades: si la lista es la de los lenguajes que algún programa decide, es un lenguaje que ningún programa decide.
Hay una forma de sentir la diferencia de tamaños con números pequeños. Un lenguaje se arma decidiendo, para cada cadena, si entra o no. Solo con las 7 cadenas binarias de longitud a lo sumo 2 ya hay lenguajes distintos. Con las 15 de longitud a lo sumo 3, hay . Los lenguajes son todas las maneras de elegir un subconjunto de , y eso es muchísimo más que .
El argumento tiene un defecto que es justo lo que hace interesante al resto del curso: no dice cuál problema no se puede resolver. El lenguaje depende de una lista y no se parece a nada que alguien quiera calcular. Podría ser que todos los problemas con una descripción razonable sí tengan programa. En la semana 9 veremos que no: hay problemas concretos, naturales y útiles que ningún programa decide.
Con esto termina la primera mitad. Tenemos el vocabulario, y sabemos que hay lenguajes fuera del alcance de cualquier máquina. Ahora empezamos por el otro extremo: la máquina más simple, y los lenguajes que sí alcanza.
Máquinas con memoria fija
Piensen en la puerta automática de un supermercado, de las que giran hacia adentro. Tiene dos sensores: uno delante, que detecta a quien quiere entrar, y otro detrás, que detecta si hay alguien en el espacio que la puerta barre al abrirse. El controlador de la puerta es una computadora muy pequeña. No guarda una historia de lo que pasó ni cuenta personas. En cada instante solo sabe una cosa, si la puerta está cerrada o abierta, y con eso y la señal de los sensores decide qué hacer:
| Estado | ninguno | delante | detrás | ambos |
|---|---|---|---|---|
| cerrada | cerrada | abierta | cerrada | cerrada |
| abierta | cerrada | abierta | abierta | abierta |
La tabla se lee por filas. Si la puerta está cerrada y solo hay alguien delante, se abre. Si además hay alguien detrás, se queda cerrada, para no golpearlo. Si está abierta, se queda abierta mientras haya alguien en cualquiera de los dos lados, y se cierra cuando no hay nadie. Toda la “memoria” del controlador es un bit: en cuál de las dos filas está.
Un torniquete es otra máquina igual. Tiene dos estados, bloqueado y libre, y le pueden pasar dos cosas: que entre una moneda o que alguien empuje. Con una moneda queda libre. Con un empujón, si estaba libre deja pasar y vuelve a bloquearse, y si estaba bloqueado no pasa nada. Si a la moneda la llamamos y al empujón , lo que le pasa al torniquete durante el día es una cadena sobre , y podemos seguirla:
$ build/run_dfa machines/turnstile.dfa emme
w = emme
  bloqueado -e-> bloqueado -m-> libre -m-> libre -e-> bloqueado
  termina en bloqueado, que está en F: acepta
La línea del medio es la historia completa: el estado antes de leer nada, y el estado después de cada símbolo. La segunda moneda se perdió: el torniquete ya estaba libre y no tiene dónde anotar que le deben una pasada. Para recordar cuántas monedas entraron haría falta un estado por cada cantidad posible, y la máquina tiene dos.
La última línea habla de aceptar, y eso es lo que convierte a estas máquinas en algo que decide lenguajes. Se
marcan algunos estados como de aceptación, y la máquina acepta una cadena si, después de leerla completa,
queda en uno de ellos. En el archivo machines/turnstile.dfa el estado marcado es bloqueado, así que la
máquina acepta exactamente las secuencias que dejan el torniquete bloqueado.
Ahora un ejemplo donde el lenguaje interesa por sí mismo.
Problema. Decidir si una cadena binaria tiene una cantidad par de unos.
Un programa normal contaría los unos y al final miraría si el contador es par. Pero el contador no hace falta: basta recordar si la cantidad de unos leídos hasta ahora es par o impar. Eso es un bit, dos estados. Al leer un , la paridad no cambia. Al leer un , cambia. Antes de leer nada hay cero unos, y cero es par.
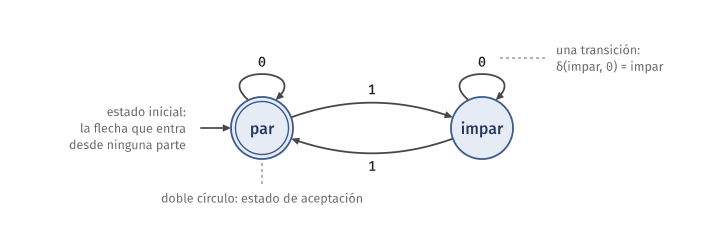
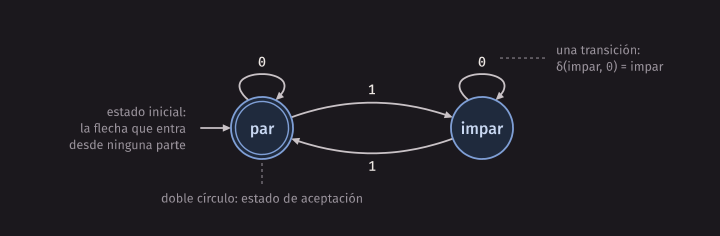
Este dibujo es un diagrama de estados. Cada círculo es un estado. La flecha que entra desde ninguna parte señala el estado inicial. El doble círculo marca los estados de aceptación. Cada flecha con una etiqueta es una transición: desde este estado, con este símbolo, se pasa a aquel.
$ build/run_dfa machines/even_ones.dfa 1101 '' 0110
w = 1101
  par -1-> impar -1-> par -0-> par -1-> impar
  termina en impar, que no está en F: rechaza
w = ε
  par
  termina en par, que está en F: acepta
w = 0110
  par -0-> par -1-> impar -1-> par -0-> par
  termina en par, que está en F: acepta
Con la cadena vacía la máquina no se mueve: termina donde empezó, en par, y acepta. Es lo correcto, porque
tiene cero unos.
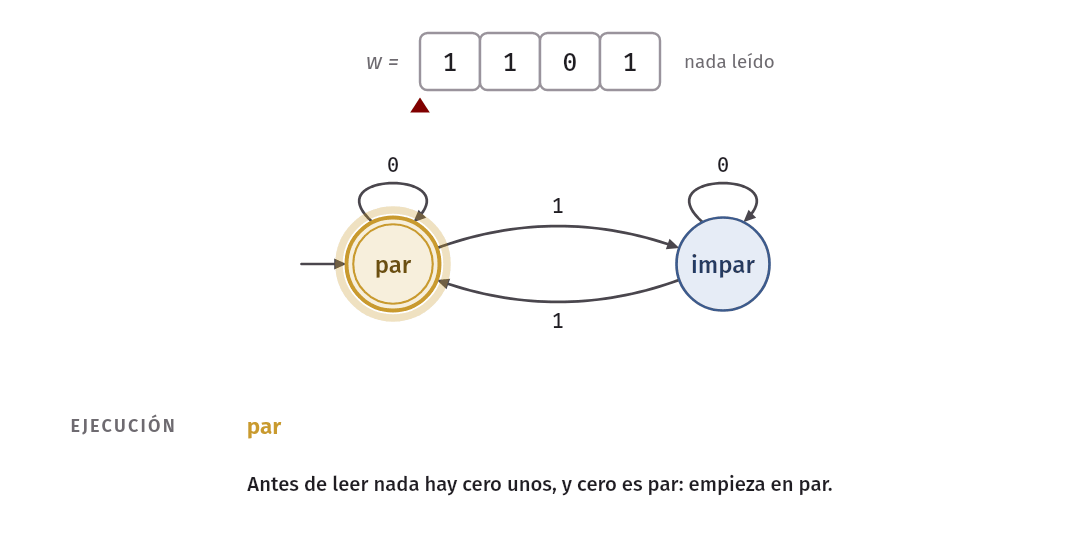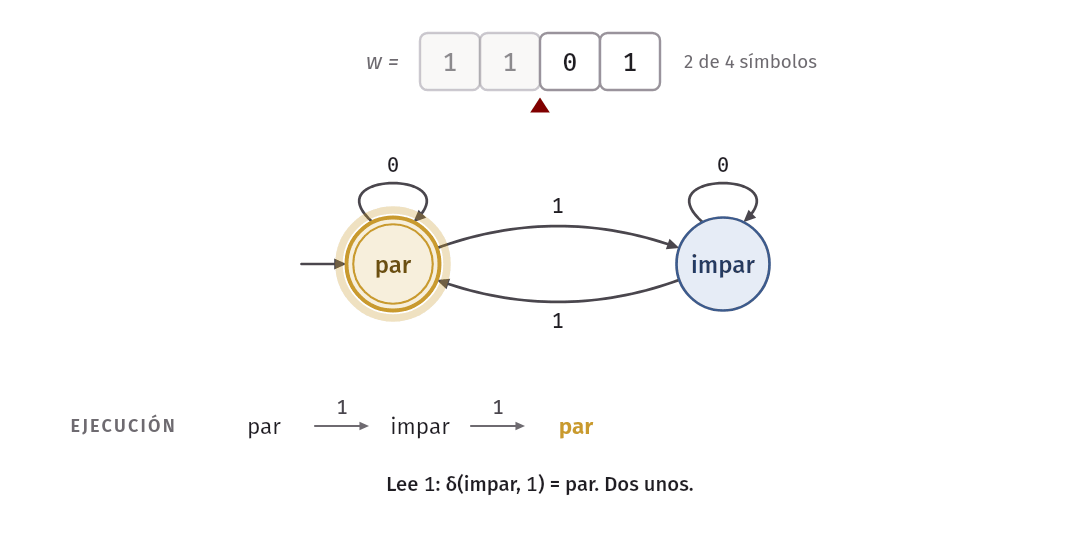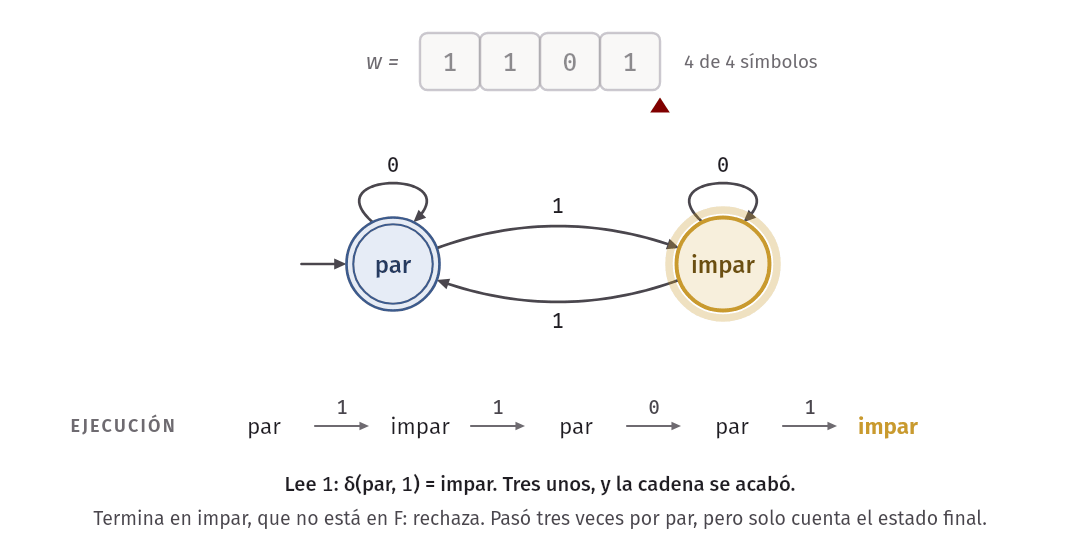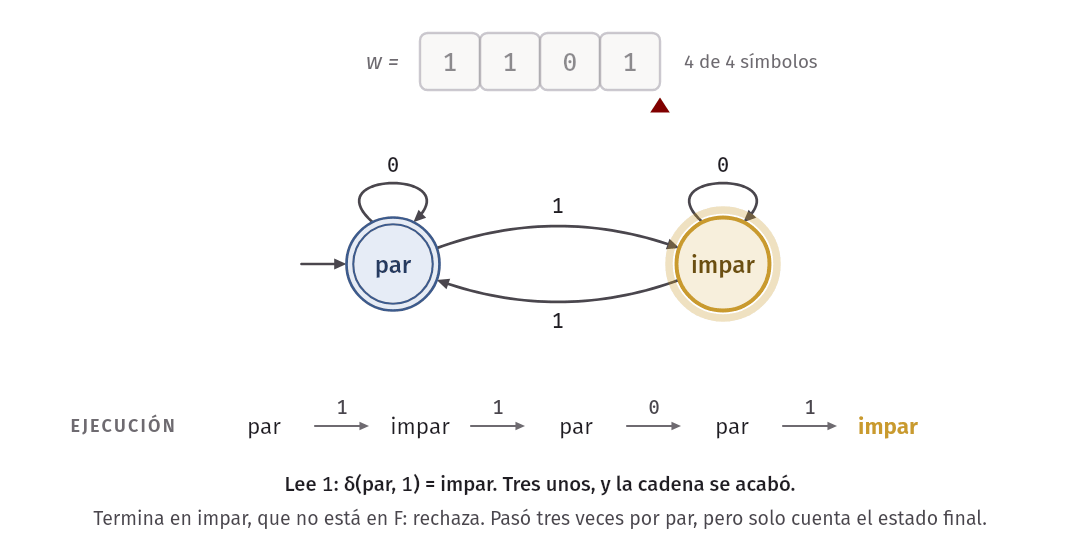
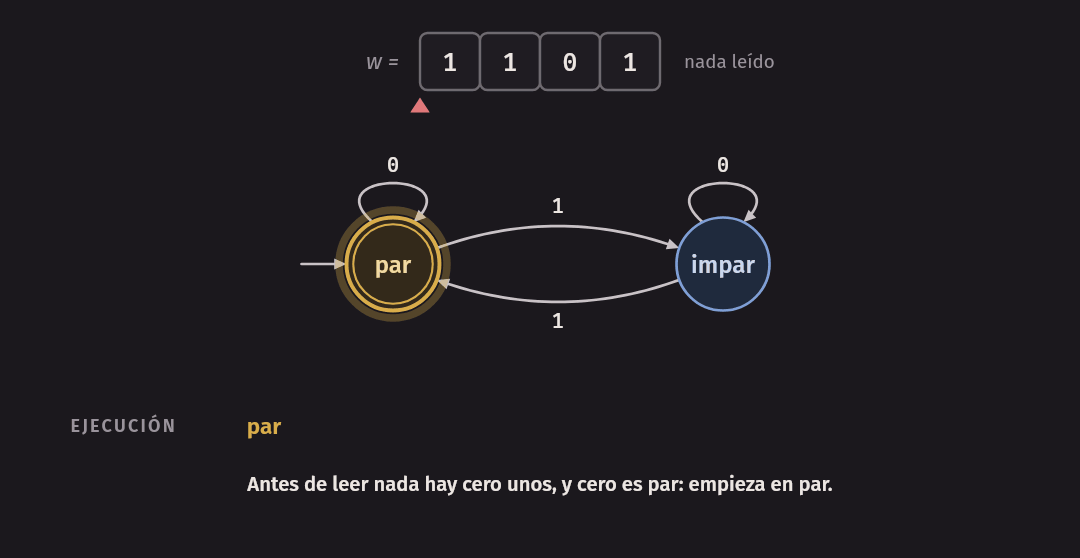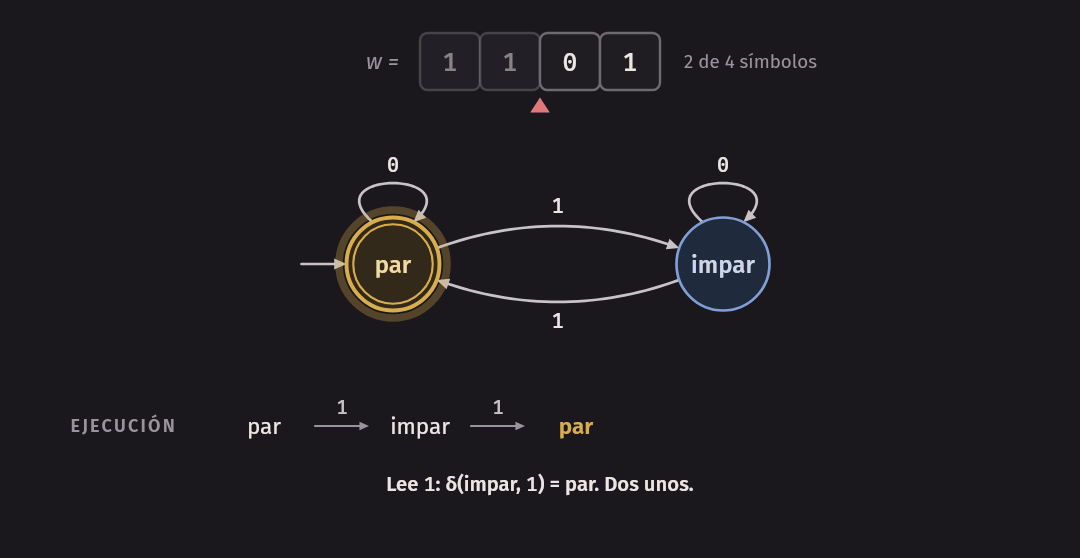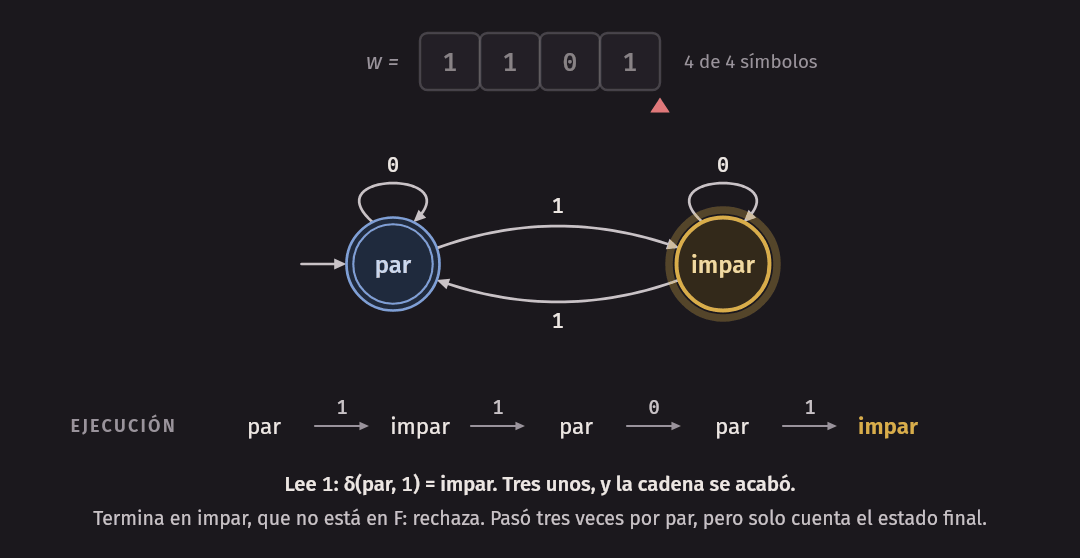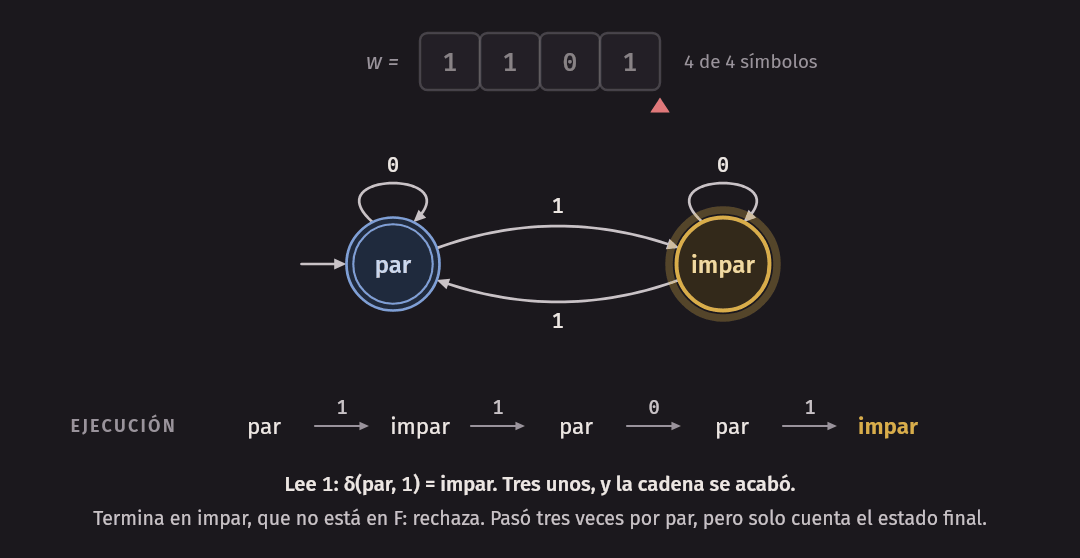
Idea clave. Un autómata finito lee la entrada una sola vez, de izquierda a derecha, y no puede volver atrás ni anotar nada. Todo lo que sabe de lo que ya leyó es en qué estado está. La cantidad de estados es fija: no crece con la entrada.
En la práctica. Esta forma de programar aparece cada vez que un sistema reacciona a eventos con poca memoria: el controlador de un ascensor o de un semáforo, el estado de una conexión de red (cerrada, esperando, establecida), el flujo de pantallas de un cajero. Y aparece dentro de las herramientas de texto: el analizador léxico de un compilador, que parte el código fuente en tokens, es un autómata finito.
La definición formal de un DFA
Los tres ejemplos tienen las mismas piezas: unos estados, unos símbolos, una regla para pasar de un estado a otro, un estado donde se empieza y unos estados que significan sí. La definición formal es la lista de esas piezas.
Definición. Un autómata finito determinista (deterministic finite automaton), o DFA, es una quíntupla , donde:
- es un conjunto finito, el de los estados.
- es un alfabeto.
- es la función de transición (transition function).
- es el estado inicial (start state).
- es el conjunto de los estados de aceptación (accept states).
En este curso se usan las siglas en inglés, DFA, NFA y PDA, que son las de Sipser y las de casi toda la documentación. Los libros en español escriben AFD (autómata finito determinista), AFN (no determinista) y AP (autómata de pila). Son los mismos objetos: ténganlo presente si buscan en esas fuentes.
Cada parte de la definición dice algo que conviene leer despacio.
- es una función de en . Recibe un estado y un símbolo, y devuelve un estado: . Que sea una función quiere decir dos cosas a la vez. Está definida para todos los pares: desde cada estado sale una flecha con cada símbolo, sin excepción. Y da un solo resultado: no salen dos flechas con el mismo símbolo. De ahí la palabra determinista: el estado actual y el símbolo leído determinan el siguiente estado, sin elección. La semana próxima quitaremos esa condición.
- Hay un solo estado inicial. Es por costumbre, aunque en un archivo puede llamarse como sea.
- es cualquier subconjunto de . Puede tener un estado, varios, todos, o ninguno: es legal, y da un autómata que no acepta nada. El estado inicial puede estar en .
- es finito. Es la única limitación de la máquina, y todo lo que un DFA no puede hacer sale de ahí.
El autómata de la paridad, escrito como quíntupla, es con , , , , y dada por:
Esta es la tabla de transiciones: una fila por estado, una columna por símbolo, y en cada casilla . La tabla y el diagrama dicen lo mismo. Cada casilla de la tabla es una flecha del diagrama, y al revés. Lo único que la tabla no muestra es cuál es el estado inicial y cuáles son de aceptación, y por eso se anotan aparte o con marcas. El diagrama sirve para pensar, y la tabla para programar y para comprobar que no falta nada: una casilla vacía es una transición olvidada, y salta a la vista.
En el formato del curso, que está descrito en code/formats.md, la misma quíntupla es un archivo de texto con
un campo por componente. Este es machines/even_ones.dfa:
# Cadenas binarias con una cantidad par de unos.
states: par impar
alphabet: 0 1
start: par
accept: par
delta:
par 0 par
par 1 impar
impar 0 impar
impar 1 par
Después de delta: va una línea por cada casilla de la tabla: estado símbolo destino. El programa show_dfa
lee un archivo y lo muestra de las dos maneras:
$ build/show_dfa machines/even_ones.dfa
Q  = {par, impar}
Σ  = {0, 1}
q0 = par
F  = {par}

     δ      0      1
-> * par    par    impar
     impar  impar  par

estados alcanzables desde par: 2 de 2
En la tabla que imprime, -> marca el estado inicial y * los de aceptación.
En C++. El
struct Dfadedfa.htiene los cinco componentes con los nombres del formato:states,alphabet,delta,startyaccept. La función es unstd::mapcuya clave es el par (estado, símbolo) y cuyo valor es el estado de destino, así quedelta.at({"par", '1'})es . Unstd::mapguarda un solo valor por clave: la estructura ya impide que haya dos flechas con el mismo símbolo. Que no falte ninguna lo revisacheck_dfa.
La función de transición extendida y el lenguaje de un DFA
La definición dice qué es un DFA. Falta decir qué hace con una cadena. La función avanza un símbolo. Para avanzar una cadena entera se la aplica una vez por símbolo, y eso es una definición recursiva como las de la sección de inducción.
Definición. La función de transición extendida (extended transition function) de es , definida así:
es el estado en el que queda la máquina si empieza en y lee completa. La primera línea dice que sin leer nada no se mueve. La segunda, que para leer primero lee y después da un paso con .
Con el autómata de la paridad y , la definición se desenrolla así:
Los estados que aparecen al resolver de adentro hacia afuera, , , ,
, son los mismos que run_dfa imprime de izquierda a derecha. Esa secuencia de estados se llama
la ejecución de con . Si , es la secuencia con
y . Tiene estados, uno más que los símbolos de , y su último
estado es . Sipser define la aceptación con esta secuencia, y es lo mismo dicho de otro modo.
Definición. acepta la cadena si . Si no, la rechaza. El lenguaje de es el conjunto de las cadenas que acepta:
Se dice que reconoce el lenguaje .
Tres precisiones sobre estas palabras, que se usan con cuidado todo el semestre.
- Una máquina acepta cadenas y reconoce un lenguaje. Reconoce uno solo: . Si no acepta ninguna cadena, igual reconoce un lenguaje, que es .
- ” reconoce ” quiere decir , con igualdad. tiene que aceptar todas las cadenas de y ninguna otra. Un autómata con acepta todas las cadenas de cualquier lenguaje, y no por eso los reconoce: reconoce .
- Solo cuenta el estado final. Que la ejecución pase por un estado de aceptación a mitad de camino no significa nada.
Error común. Decir que acepta porque “pasa por” un estado de aceptación. Con el autómata de la paridad, la ejecución de es , , , , : visita
partres veces y termina enimpar. La rechaza.
Una propiedad de que se usa todo el tiempo, casi sin nombrarla: leer es leer y, desde donde se quedó, leer .
Lema (de la concatenación). Para todo estado y todas las cadenas , : .
Demostración. Por inducción sobre la longitud de , con y fijos.
Caso base: . Entonces , y por la primera línea de la definición . Son iguales.
Paso inductivo: , y suponemos que el lema vale para . Entonces:
∎
El lema dice algo fuerte sobre lo que la máquina puede saber. Si dos cadenas y llevan al mismo estado, entonces y también, para cualquier continuación . Después de leer , la máquina no distingue si leyó o : el estado es todo lo que recuerda.
En C++. Así queda en
dfa.h. El ciclo aplica la segunda línea de la definición una vez por símbolo. Con la cadena vacía no da ninguna vuelta y devuelve : la primera línea.inline std::string delta_star(const Dfa& m, std::string q, const std::string& w) { for (char a : w) { q = step(m, q, a); } return q; } inline bool accepts(const Dfa& m, const std::string& w) { return m.accept.count(delta_star(m, m.start, w)) > 0; }Simular un DFA cuesta un paso por símbolo, y la memoria que usa no depende de la longitud de : una variable con el estado actual. Ningún otro modelo del curso va a ser tan barato.
Cómo diseñar un DFA
Diseñar un autómata es programar con una restricción extraña: no hay variables. Lo único que el programa puede recordar es en qué línea está. El método que sigue convierte esa restricción en una pregunta.
- Pónganse en el lugar de la máquina. Los símbolos llegan de uno en uno. No saben cuántos faltan, y después de cada uno les pueden decir “ahí terminó: ¿la cadena está en el lenguaje?”. Tienen que poder responder siempre.
- Decidan qué hay que recordar. ¿Qué necesitan saber de lo ya leído para responder ahora y para seguir respondiendo después de cualquier continuación? Tiene que ser una lista finita de posibilidades.
- Un estado por posibilidad. Cada estado es un hecho sobre lo leído hasta el momento: “la cantidad de unos es par”, “termina en 0”. Escriban ese hecho junto al estado. Es la documentación del autómata y será su demostración.
- Las transiciones salen solas. Para cada estado y cada símbolo: si el hecho del estado es cierto y llega este símbolo, ¿qué hecho pasa a ser cierto? Llenen la tabla completa, casilla por casilla.
- Inicial y aceptación. El estado inicial es el hecho que cumple la cadena vacía. Los de aceptación son los hechos que implican que la cadena está en el lenguaje.
- Prueben con cadenas cortas, empezando por y por las de longitud 1, antes de demostrar nada.
Los tres diseños que siguen están en machines/, y los usaremos el resto del capítulo.
Termina en 01
Lenguaje. .
Qué recordar. Para saber si la cadena termina en basta conocer sus dos últimos símbolos. Eso da un autómata correcto con 7 estados: uno por cada cadena de longitud menor que 2, que son , y , y uno por cada par de últimos símbolos, , , y . Pero se recuerda de más. Lo que importa de lo leído es cuánto avance hay hacia un final:
| Estado | Lo que dice de lo leído hasta ahora |
|---|---|
| No termina en ni en : no hay nada aprovechable | |
| Termina en : si ahora llega un , termina en | |
| Termina en |
Las tres posibilidades se excluyen entre sí y cubren todas las cadenas, porque una cadena que termina en termina en y no en .
Las transiciones. Si llega un , la cadena pasa a terminar en , venga de donde venga: la columna del es toda . Si llega un , termina en solo si antes terminaba en , es decir, solo desde . Desde o desde , con un la cadena termina en o es la cadena , y no hay nada aprovechable: .
$ build/show_dfa machines/ends_01.dfa
Q  = {q0, q1, q2}
Σ  = {0, 1}
q0 = q0
F  = {q2}

     δ   0   1
->   q0  q1  q0
     q1  q1  q2
   * q2  q1  q0

estados alcanzables desde q0: 3 de 3
El estado inicial es , porque no termina en ni en . El de aceptación es .
$ build/run_dfa machines/ends_01.dfa 110101 010
w = 110101
  q0 -1-> q0 -1-> q0 -0-> q1 -1-> q2 -0-> q1 -1-> q2
  termina en q2, que está en F: acepta
w = 010
  q0 -0-> q1 -1-> q2 -0-> q1
  termina en q1, que no está en F: rechaza
En la primera ejecución la máquina llega a después de leer , sale, y vuelve a entrar. De hay que poder salir: que lo leído termine en es cierto ahora y deja de serlo con el símbolo siguiente.
Contiene 101
Lenguaje. .
Qué recordar. Aquí hay un hecho que, una vez cierto, no deja de serlo: si ya apareció, la cadena está en termine como termine. Mientras no haya aparecido, importa cuánto de un está armado al final de lo leído.
| Estado | Lo que dice de lo leído hasta ahora |
|---|---|
| No contiene , y no termina en ni en | |
| No contiene , y termina en | |
| No contiene , y termina en | |
| Contiene |
Las transiciones. Las que avanzan son fáciles: con va a , con va a , y con va a . Las difíciles son las que no avanzan, porque hay que decidir cuánto se conserva.
- con : lo leído termina en . No avanzó, pero el último puede ser el inicio de un . Se queda en .
- con : lo leído termina en . Ningún final de sirve como inicio de . Vuelve a .
- con : sigue sin terminar en ni en . Se queda en .
- con cualquier símbolo: sigue conteniendo . Se queda en .
$ build/show_dfa machines/contains_101.dfa
Q  = {q0, q1, q2, q3}
Σ  = {0, 1}
q0 = q0
F  = {q3}

     δ   0   1
->   q0  q0  q1
     q1  q2  q1
     q2  q0  q3
   * q3  q3  q3

estados alcanzables desde q0: 4 de 4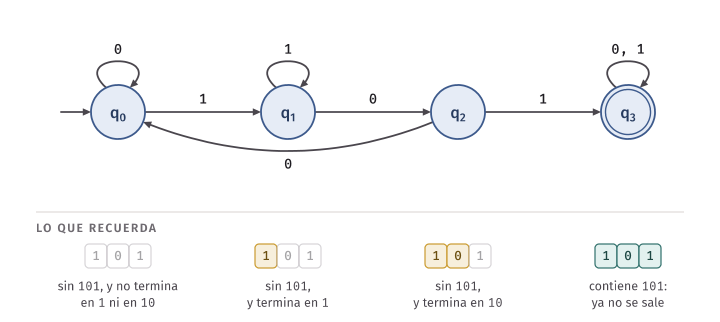
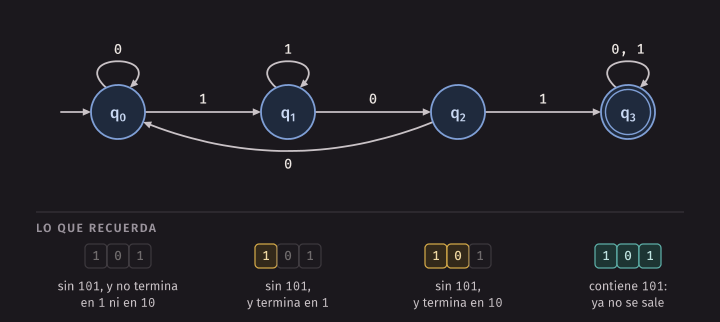
$ build/run_dfa machines/contains_101.dfa 1100101 11011 110011
w = 1100101
  q0 -1-> q1 -1-> q1 -0-> q2 -0-> q0 -1-> q1 -0-> q2 -1-> q3
  termina en q3, que está en F: acepta
w = 11011
  q0 -1-> q1 -1-> q1 -0-> q2 -1-> q3 -1-> q3
  termina en q3, que está en F: acepta
w = 110011
  q0 -1-> q1 -1-> q1 -0-> q2 -0-> q0 -1-> q1 -1-> q1
  termina en q1, que no está en F: rechaza
Error común. Mandar con de vuelta a , con la idea de que “se rompió el patrón y hay que empezar de nuevo”. Con ese cambio la cadena se rechaza: después de la máquina estaría en , el la dejaría en , y ya no alcanzaría a ver el del final. Cuando un intento falla, parte de lo leído puede servir para el intento siguiente.
El estado es un estado del que no se sale: todas sus flechas vuelven a él. Aquí es de aceptación, y significa “ya ganó”. En la sección El estado trampa aparece su gemelo, el que significa “ya perdió”.
Múltiplos de 3 en binario
Lenguaje.
Hay que fijar la representación, como se dijo en De problemas a lenguajes. El número se lee con el bit más significativo primero, se permiten ceros a la izquierda, y la cadena vacía representa el 0. Llamemos al número que representa : , , .
Qué recordar. El número no se puede recordar: crece sin tope y los estados son finitos. Pero no hace falta el número, sino su resto al dividirlo entre 3, que solo puede ser 0, 1 o 2. La pregunta es si el resto se puede mantener al día leyendo un bit más, y la respuesta viene de cómo funciona la base 2. Agregar un bit a la derecha de un número lo duplica y le suma :
Por ejemplo, y . Entonces el resto nuevo depende solo del resto viejo y del bit: si deja resto , deja el resto de .
| Estado | Lo que dice | Con : resto de | Con : resto de |
|---|---|---|---|
| deja resto 0 | |||
| deja resto 1 | 3, resto | ||
| deja resto 2 | 4, resto | 5, resto |
El estado inicial es , porque , y el de aceptación también es .
$ build/run_dfa machines/multiple_of_3.dfa 10101 1101 0011
w = 10101
  r0 -1-> r1 -0-> r2 -1-> r2 -0-> r1 -1-> r0
  termina en r0, que está en F: acepta
w = 1101
  r0 -1-> r1 -1-> r0 -0-> r0 -1-> r1
  termina en r1, que no está en F: rechaza
w = 0011
  r0 -0-> r0 -0-> r0 -1-> r1 -1-> r0
termina en r0, que está en F: aceptaes . es 13, que deja resto 1, y la máquina termina en . Los prefijos de valen 1, 2, 5, 10 y 21, con restos 1, 2, 2, 1 y 0: los estados de la ejecución, uno por uno.
Idea clave. Diseñar un DFA es decidir qué recordar. Cada estado es un hecho sobre lo leído hasta ahora, los hechos se excluyen entre sí y cubren todos los casos, y cada transición dice cómo cambia el hecho al llegar un símbolo. Si lo que hay que recordar no cabe en una lista finita, no hay DFA.
En la práctica. El autómata de Contiene 101 es un buscador de texto: lee una sola vez, nunca retrocede en la entrada, y avisa cuando apareció el patrón. Las herramientas que buscan patrones en archivos muy grandes trabajan con autómatas así, construidos por un programa a partir del patrón. En la semana 3 veremos esa construcción, y el laboratorio será un
greppequeño.
Demostrar que un DFA es correcto
Probar un autómata con muchas cadenas da confianza, y las pruebas de esta semana lo hacen con todas las cadenas de longitud hasta 12. Pero un lenguaje infinito no se termina de probar. Para afirmar hace falta una demostración, y hay un método que funciona casi siempre.
El método es demostrar más de lo que se pide. No solo que acepta las cadenas correctas, sino en qué estado queda con cada cadena. Se escribe una afirmación por estado, que es el hecho que se anotó al diseñar, y se demuestran todas juntas por inducción sobre la longitud de la cadena.
¿Por qué demostrar más es más fácil? Porque la hipótesis de inducción también dice más. Para saber qué pasa con hay que saber dónde quedó la máquina con , y ” está o no está en el lenguaje” no alcanza para saberlo.
La demostración para la paridad
Afirmación. Sea el autómata de machines/even_ones.dfa. Para toda cadena
:
- si tiene una cantidad par de unos, y
- si tiene una cantidad impar de unos.
Demostración. Por inducción sobre .
Caso base: . Tiene cero unos, que es una cantidad par, y por definición. Se cumple.
Paso inductivo: sea , y supongamos la afirmación para . Hay cuatro casos, según la paridad de los unos de y según .
- tiene una cantidad par de unos y . Por hipótesis , así que . Y tiene los mismos unos que : una cantidad par. Se cumple.
- par y . , y tiene un uno más que : una cantidad impar. Se cumple.
- impar y . , y tiene los mismos unos que . Se cumple.
- impar y . , y tiene un uno más: una cantidad par. Se cumple.
∎
Cada caso del paso inductivo es una casilla de la tabla de transiciones. La demostración recorre la tabla y comprueba, casilla por casilla, que el hecho del estado de llegada es cierto.
Corolario. es el lenguaje de las cadenas con una cantidad par de unos. En efecto, acepta si y solo si , y por la afirmación eso pasa si y solo si tiene una cantidad par de unos. Las dos direcciones salen de la misma afirmación: si tiene cantidad par, termina en y se acepta; si tiene cantidad impar, termina en y se rechaza.
La demostración para Termina en 01
Afirmación. Sea el autómata de machines/ends_01.dfa. Para toda cadena
:
- (a) si termina en , entonces ;
- (b) si termina en , entonces ;
- (c) si no termina en ni en , entonces .
Toda cadena cumple exactamente una de las tres condiciones, así que la afirmación dice en qué estado queda con cada cadena.
Demostración. Por inducción sobre .
Caso base: . No termina en ni en , así que le toca (c), y . Se cumple.
Paso inductivo: sea , y supongamos la afirmación para . Llamemos , de modo que .
- . Entonces termina en , y le toca (b): hay que ver que . La columna del de la tabla es en las tres filas, así que se cumple sea cual sea . Aquí ni siquiera se usa la hipótesis.
- y termina en . Entonces termina en , y le toca (a). Por la hipótesis (b) aplicada a , . Y . Se cumple.
- y no termina en . Entonces termina en y su penúltimo símbolo, si existe, no es : no termina en ni en , y le toca (c). Como no termina en , por la hipótesis le tocó (a) o (c), así que es o . En la tabla, y . Se cumple.
∎
Corolario. , el lenguaje de las cadenas que terminan en . Si termina en , por (a) queda en y la acepta. Si no termina en , le toca (b) o (c), queda en o en , que no están en , y la rechaza.
Para los otros dos diseños el esquema es idéntico, y quedan como ejercicios. Las afirmaciones son las de sus tablas de estados. En Múltiplos de 3 se reduce a una línea: , donde es el resto de entre 3, y el paso inductivo es la cuenta junto con las seis casillas de la tabla.
Idea clave. Para demostrar que un DFA reconoce un lenguaje se escribe una afirmación por estado, ” queda en exactamente con las cadenas que cumplen tal cosa”, y se demuestran todas a la vez por inducción sobre la longitud. El caso base es la cadena vacía y el estado inicial. El paso inductivo es la tabla de transiciones, casilla por casilla.
Error común. Demostrar una sola dirección. “Toda cadena que termina en es aceptada” no basta: un autómata que acepta todo también lo cumple. Hay que mostrar además que las demás cadenas se rechazan. Con una afirmación por estado, las dos direcciones salen juntas.
Las pruebas de la semana comprueban estas afirmaciones por fuerza bruta: test_dfa recorre todas las cadenas
binarias de longitud a lo sumo 12, que son , y verifica con cada una que el autómata queda en
el estado que su afirmación dice. No reemplaza la demostración, pero encuentra en segundos una casilla mal
llenada.
El estado trampa
Lenguaje. .
El primer intento suele tener dos estados: , “todavía no leí nada”, y , “empezó con ”, que es de aceptación y del que no se sale. La flecha de a lleva un . ¿Y con ? Si la cadena empieza con ya no está en , así que es tentador no dibujar nada: “ahí la máquina se muere”.
Eso no es un DFA. En un DFA, es una función definida para todos los pares, y el archivo
errors/missing_trap.dfa, que describe ese intento, no se puede cargar:
$ build/show_dfa errors/missing_trap.dfa
error: errors/missing_trap.dfa: falta la transición δ(q0, 0): en un DFA, δ es total
La solución es darle un lugar a “ya perdió”: un estado que no es de aceptación y del que no se sale. Se llama estado trampa.
$ build/show_dfa machines/starts_with_1.dfa
Q  = {q0, q1, trampa}
Σ  = {0, 1}
q0 = q0
F  = {q1}

     δ       0       1
->   q0      trampa  q1
   * q1      q1      q1
     trampa  trampa  trampa

estados alcanzables desde q0: 3 de 3
El estado trampa también es un hecho sobre lo leído, como cualquier otro: “la cadena empezó con ”. Y como cualquier otro, cuenta en el número de estados.
Error común. Olvidar el estado trampa y dejar transiciones sin definir. En un DFA, es total: de cada estado sale exactamente una flecha por cada símbolo. Muchos libros y muchas pizarras omiten el estado trampa en los dibujos para que queden limpios, con el acuerdo de que una flecha que falta va a él. En este curso se escribe siempre. El formato
.dfalo exige, y más abajo veremos una construcción, la del complemento, que da una respuesta equivocada si falta.
Hay un segundo error que el formato detecta: dos transiciones para el mismo estado y el mismo símbolo.
$ build/show_dfa errors/two_transitions.dfa
error: errors/two_transitions.dfa: línea 9: transición repetida para δ(q0, 0): en un DFA hay una sola
Una máquina que puede elegir entre dos flechas no es determinista. No es un disparate: es el modelo de la semana próxima, el NFA. Pero no es un DFA.
Lenguajes regulares
Ya hay varios lenguajes para los que construimos un DFA. Tienen nombre.
Definición. Un lenguaje es regular (regular language) si algún DFA lo reconoce.
Los lenguajes , , y de las secciones anteriores son regulares, y también el de la paridad. Para demostrar que un lenguaje es regular basta con mostrar un DFA y demostrar que lo reconoce. Para demostrar que no lo es hay que probar que ningún DFA sirve, de ningún tamaño, y eso pide herramientas que llegan en la semana 4.
Los lenguajes regulares son la primera clase de lenguajes del curso, la más pequeña. Las preguntas que nos haremos sobre cada clase son siempre las mismas: qué máquinas la definen, qué lenguajes quedan fuera, y si la clase es cerrada bajo las operaciones de lenguajes. Es decir: si y están en la clase, ¿también están , , el complemento de ? El resto del capítulo responde eso para tres operaciones.
La construcción del producto
Problema. Tenemos un DFA que reconoce las cadenas con una cantidad par de unos, y un DFA que reconoce las que terminan en . Queremos un DFA para las cadenas que cumplen las dos condiciones.
Un programa normal correría con la cadena, luego con la misma cadena, y juntaría las respuestas. Un DFA no puede: lee la entrada una sola vez. Tiene que correr las dos máquinas a la vez, símbolo por símbolo. Para eso necesita recordar en qué estado va cada una, y eso es un par de estados. Hay una cantidad finita de pares, así que cada par puede ser un estado de la máquina nueva.
Construcción. Sean y dos DFA con el mismo alfabeto. El producto de y es el DFA con:
- , los pares con y .
- : cada componente avanza con su propia función.
- , los dos estados iniciales.
- depende de lo que se quiera:
- para la intersección, : los pares donde los dos aceptan;
- para la unión, : los pares donde alguno acepta.
Es un DFA: es finito, con estados, y está definida para todos los pares y todos los símbolos, porque y lo están.
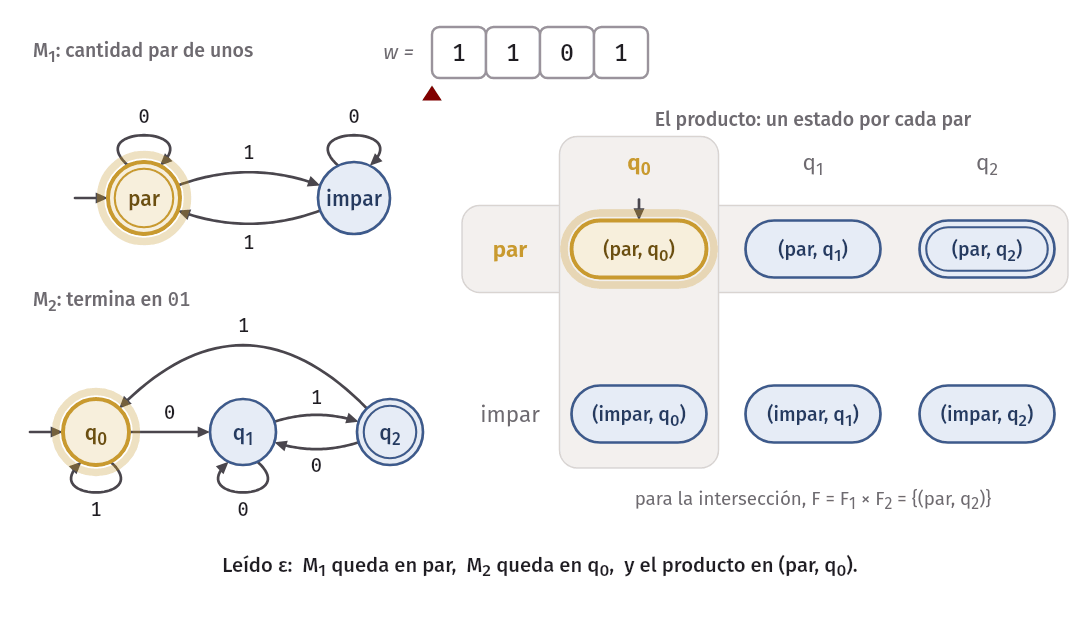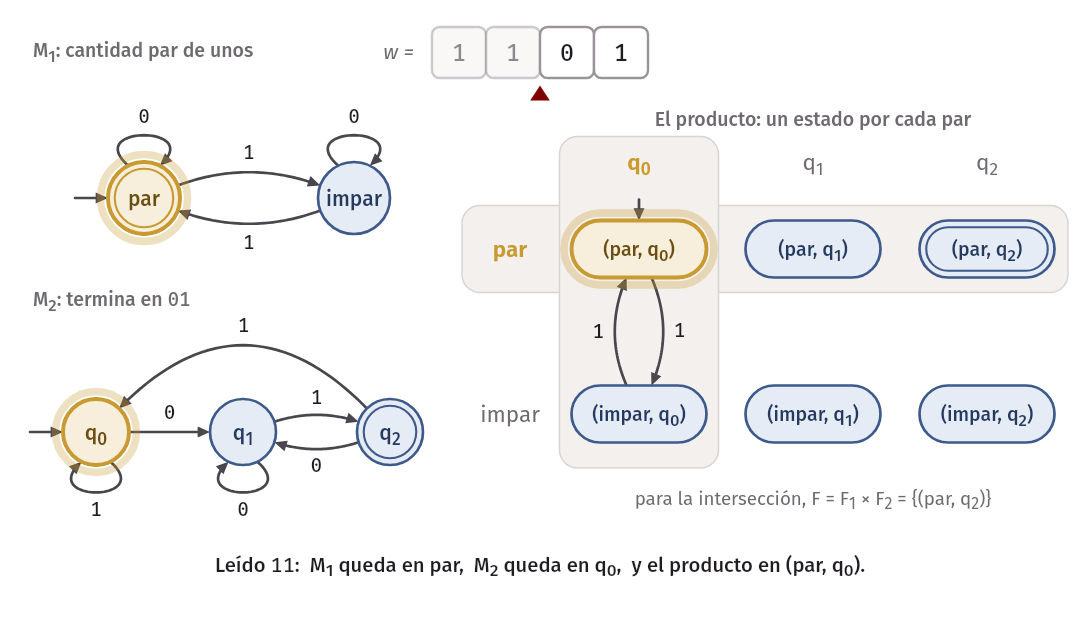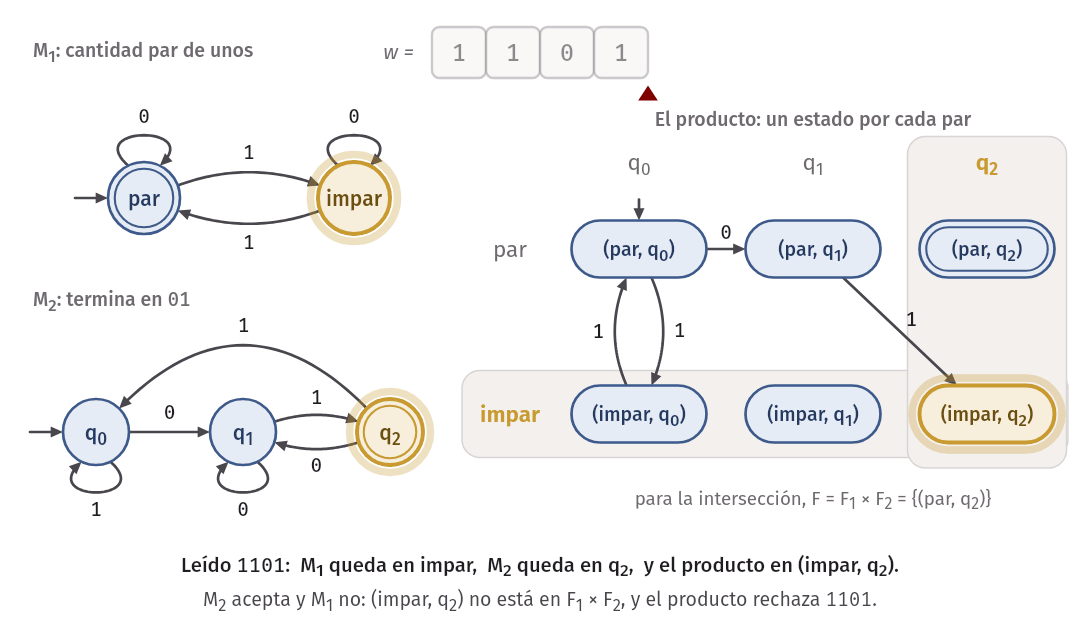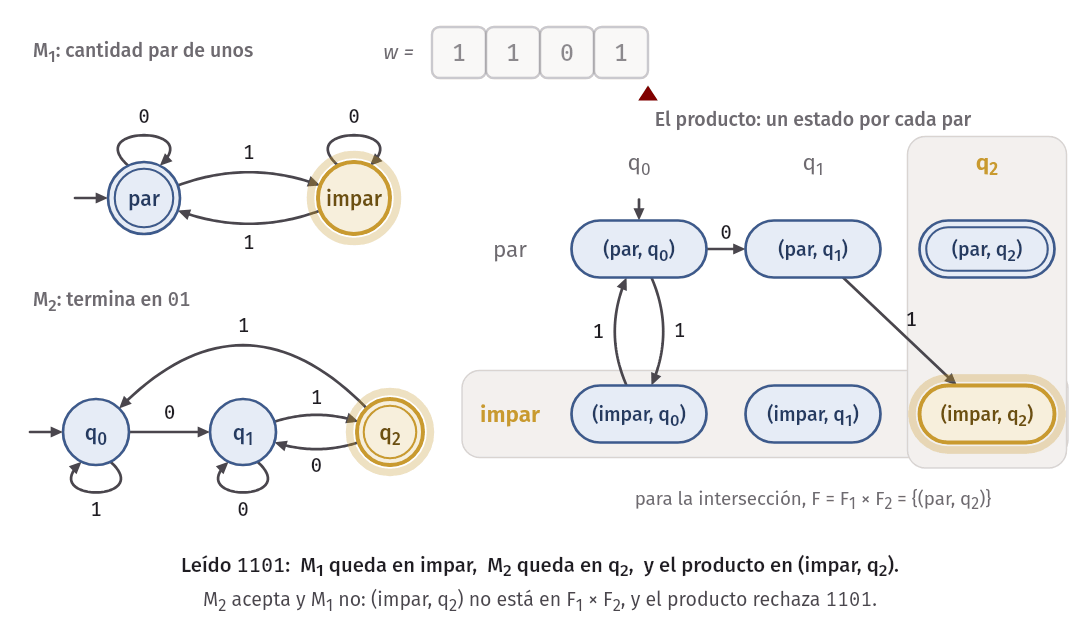
Con los dos autómatas del problema, el producto tiene estados. Conviene pensarlos como una cuadrícula, con una fila por estado de y una columna por estado de :
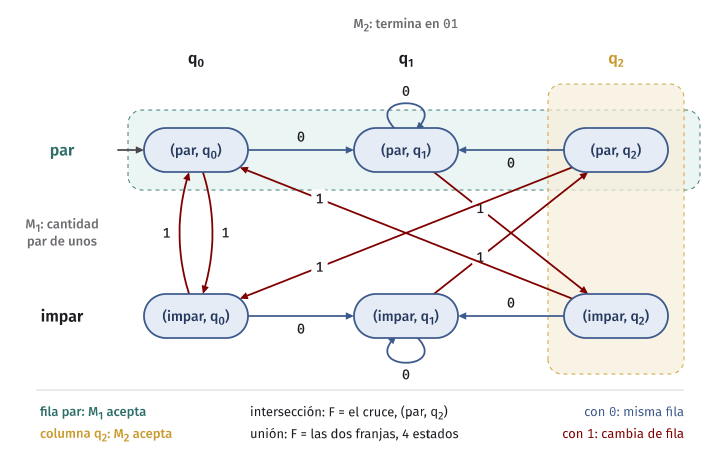
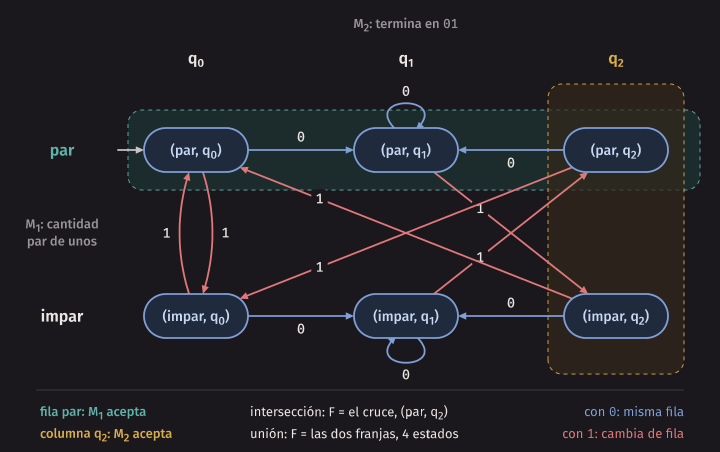
Un no cambia la paridad, así que con la máquina se mueve dentro de su fila. Un
la cambia siempre de fila. La columna se mueve como en . El programa product aplica la
construcción a dos archivos y escribe el resultado en el mismo formato:
$ build/product inter machines/even_ones.dfa machines/ends_01.dfa
# Producto de machines/even_ones.dfa y machines/ends_01.dfa: intersección.
# 2 × 3 = 6 estados.
states: (par,q0) (par,q1) (par,q2) (impar,q0) (impar,q1) (impar,q2)
alphabet: 0 1
start: (par,q0)
accept: (par,q2)
delta:
(par,q0) 0 (par,q1)
(par,q0) 1 (impar,q0)
(par,q1) 0 (par,q1)
(par,q1) 1 (impar,q2)
(par,q2) 0 (par,q1)
(par,q2) 1 (impar,q0)
(impar,q0) 0 (impar,q1)
(impar,q0) 1 (par,q0)
(impar,q1) 0 (impar,q1)
(impar,q1) 1 (par,q2)
(impar,q2) 0 (impar,q1)
(impar,q2) 1 (par,q0)
El único estado de aceptación es : cantidad par de unos y termina en .
Como la salida es un archivo .dfa, se le puede pasar a run_dfa, que lee de la entrada estándar si en lugar
del archivo se le da -:
$ build/product inter machines/even_ones.dfa machines/ends_01.dfa | build/run_dfa - 1101 1001
w = 1101
  (par,q0) -1-> (impar,q0) -1-> (par,q0) -0-> (par,q1) -1-> (impar,q2)
  termina en (impar,q2), que no está en F: rechaza
w = 1001
  (par,q0) -1-> (impar,q0) -0-> (impar,q1) -0-> (impar,q1) -1-> (par,q2)
  termina en (par,q2), que está en F: acepta
La ejecución con , al lado de las dos ejecuciones por separado:
| Leído | El producto | ||
|---|---|---|---|
La columna del producto es, fila por fila, el par formado por las otras dos. Eso es lo que hay que demostrar. termina en pero tiene tres unos: la acepta, no, y el producto para la intersección la rechaza.
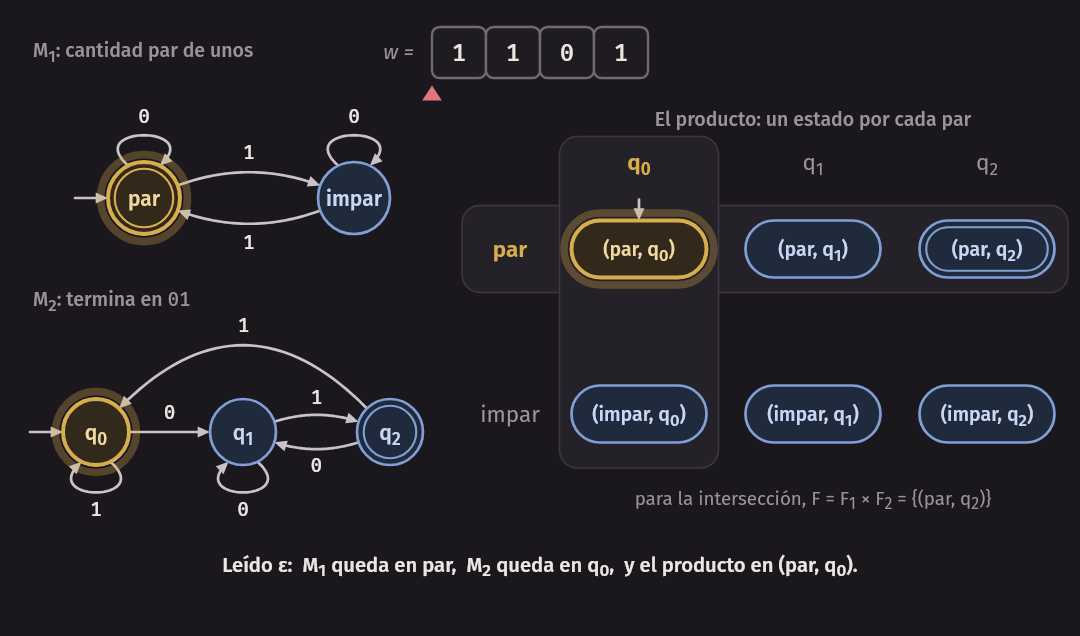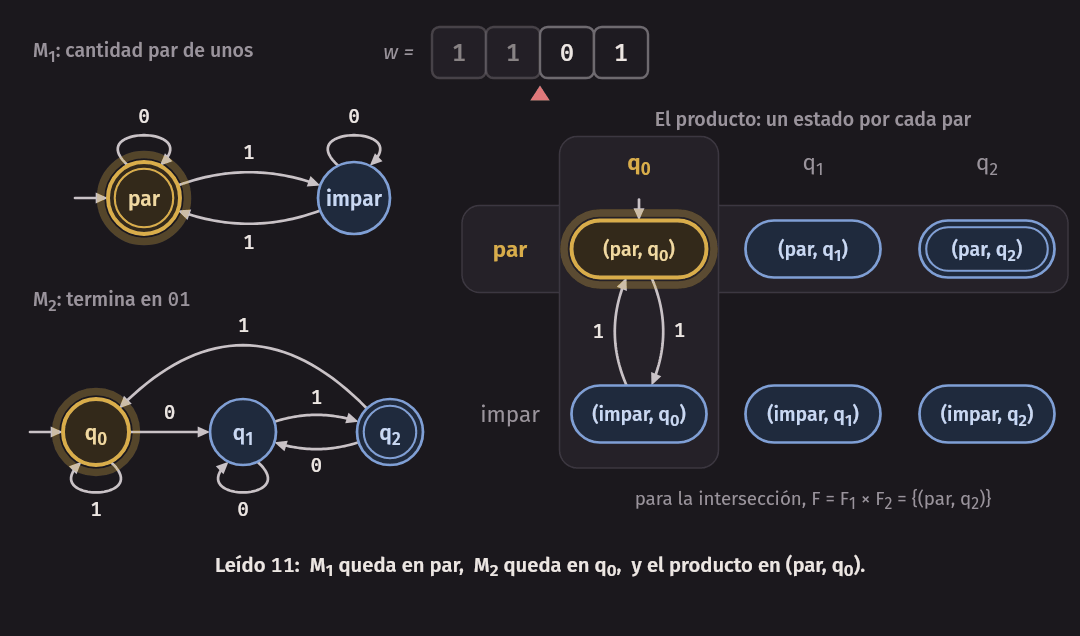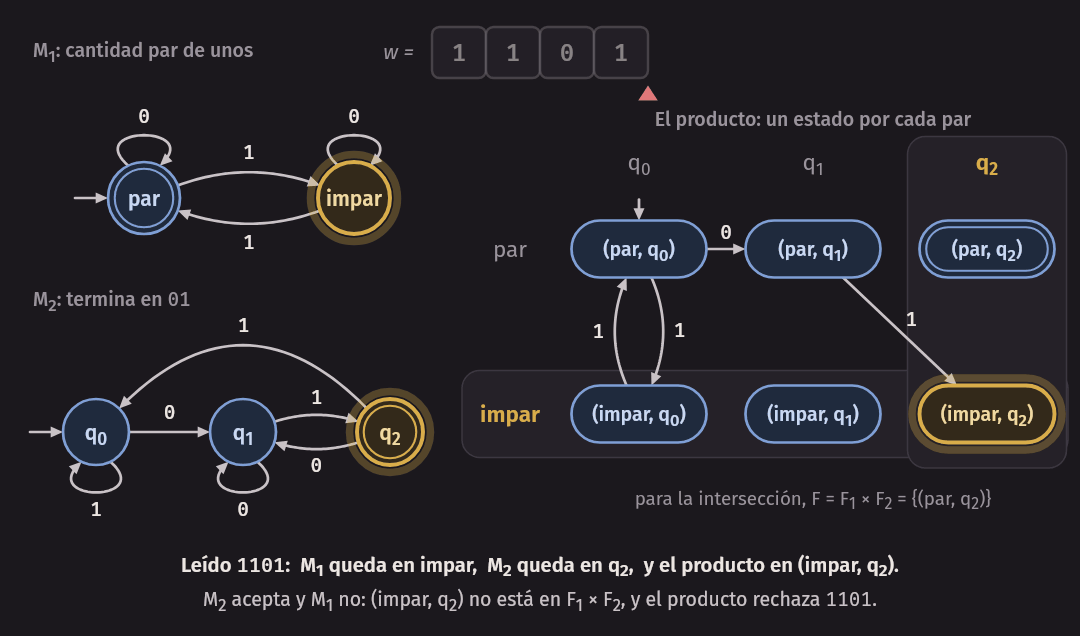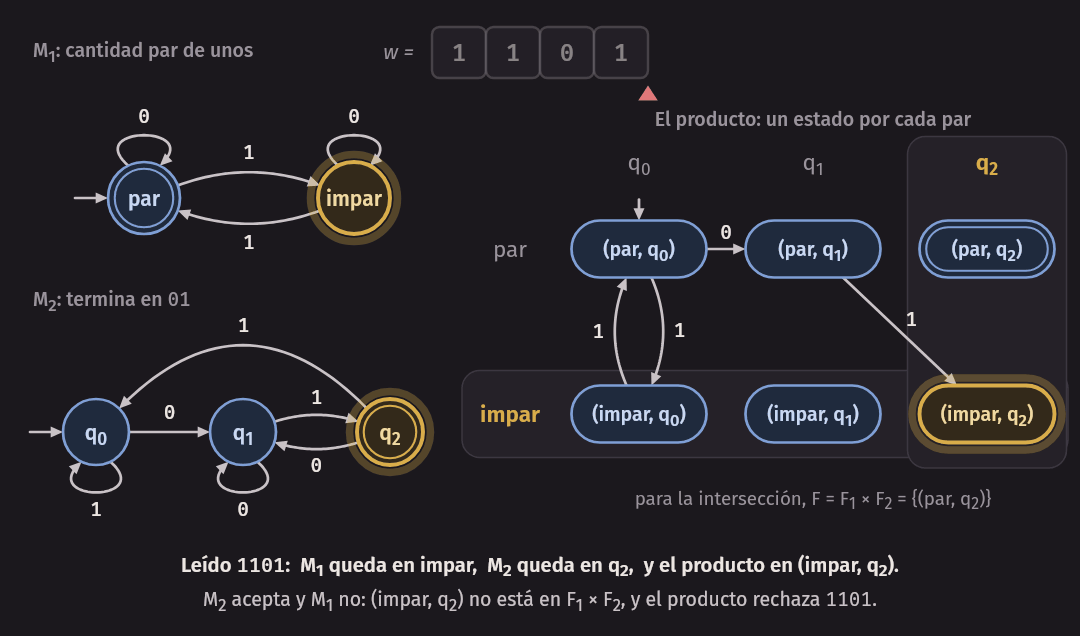
Por qué funciona
Lema (del producto). Para todo par y toda cadena : .
Con palabras: correr el producto es lo mismo que correr las dos máquinas, cada una por su lado, y juntar los resultados.
Demostración. Por inducción sobre .
Caso base: . Por la definición de la función extendida, , y también y . Los dos lados son .
Paso inductivo: , y suponemos el lema para . Entonces:
∎
Teorema. Si y son lenguajes regulares sobre el mismo alfabeto, entonces y también son regulares.
Demostración. Por construcción. Como y son regulares, hay DFA y con y .
Qué se construye: el producto de y , con .
Por qué reconoce : para toda cadena ,
Cada línea es un “si y solo si”, así que la cadena de equivalencias demuestra las dos direcciones: toda cadena de se acepta, y toda cadena aceptada está en . Luego .
Para la unión: se toma la misma máquina con . La cadena de equivalencias es la misma con “o” en lugar de “y” en las tres últimas líneas. ∎
Si los alfabetos no coinciden, primero se igualan: se usa en las dos máquinas, y a cada una se le agrega un estado trampa al que van los símbolos que no conocía. Una cadena con un símbolo ajeno a no está en , y la trampa dice exactamente eso.
La misma máquina con distinto F
Para la unión no hay que construir nada nuevo. Los estados, las transiciones y el estado inicial son los mismos, y solo cambia cuáles se marcan:
$ build/product union machines/even_ones.dfa machines/ends_01.dfa | head -6
# Producto de machines/even_ones.dfa y machines/ends_01.dfa: unión.
# 2 × 3 = 6 estados.
states: (par,q0) (par,q1) (par,q2) (impar,q0) (impar,q1) (impar,q2)
alphabet: 0 1
start: (par,q0)
accept: (par,q0) (par,q1) (par,q2) (impar,q2)
En la cuadrícula, la unión marca toda la fila par y toda la columna q2: cuatro estados. La intersección
marcaba solo el cruce.
Error común. Usar para la unión, o creer que el de la unión es . Lo segundo ni siquiera tiene el tipo correcto: es un conjunto de estados sueltos, y los estados del producto son pares. Para la unión, un par es de aceptación si alguna de sus componentes lo es: .
Idea clave. El producto corre dos DFA a la vez: su estado es el par de estados de los dos. El conjunto elige qué se hace con las dos respuestas. Con una máquina de estados salen la unión, la intersección y cualquier otra combinación de ” acepta” y ” acepta”.
¿Todos los pares se alcanzan?
El producto de un autómata de 3 estados y uno de 4 tiene 12 estados. Que todos sirvan es otra cosa. Un estado es alcanzable si alguna cadena lleva hasta él desde el estado inicial. Los que no lo son están en la definición, pero ninguna ejecución pasa por ellos, y se pueden borrar sin cambiar el lenguaje.
En el ejemplo de la cuadrícula se alcanzan los 6. No siempre es así. El caso extremo es el producto de una máquina consigo misma:
$ build/product inter machines/even_ones.dfa machines/even_ones.dfa --alcanzables
# Producto de machines/even_ones.dfa y machines/even_ones.dfa: intersección.
# 2 × 2 = 4 estados, 2 alcanzables.
states: (par,par) (impar,impar)
alphabet: 0 1
start: (par,par)
accept: (par,par)
delta:
(par,par) 0 (par,par)
(par,par) 1 (impar,impar)
(impar,impar) 0 (impar,impar)
(impar,impar) 1 (par,par)
Las dos copias leen lo mismo y van siempre en el mismo estado: no puede pasar.
Un caso menos artificial es el producto de Termina en 01 y Contiene 101, de estados. El
programa informa 3 × 4 = 12 estados, 8 alcanzables, y deja estos:
(q0,q0) (q0,q1) (q0,q3) (q1,q0) (q1,q2) (q1,q3) (q2,q1) (q2,q3)Los cuatro que faltan son pares de hechos que se contradicen. Por ejemplo diría que lo leído termina en , por el primer autómata, y termina en , por el segundo. Y diría que termina en y que no termina en .
En la práctica. Un programa que construye productos no genera los pares: parte del par inicial y agrega solo los que va encontrando al seguir las transiciones, como un recorrido de un grafo. Con dos máquinas no importa. Con el producto de diez máquinas de 10 estados, la diferencia es entre pares posibles y los que de verdad aparecen. La misma idea vuelve la semana próxima, en la construcción de subconjuntos.
Complemento
Teorema. Si es un lenguaje regular sobre , su complemento también es regular.
Demostración. Por construcción. Sea un DFA con .
Qué se construye: . La misma máquina, con los estados de aceptación intercambiados: los que lo eran dejan de serlo, y los que no lo eran pasan a serlo.
Por qué reconoce el complemento: y tienen los mismos estados y la misma , así que tienen la misma . Para toda cadena , el estado existe y es uno solo, y está en o en , pero no en los dos. Entonces:
∎
$ build/complement machines/starts_with_1.dfa
# Complemento de machines/starts_with_1.dfa.
states: q0 q1 trampa
alphabet: 0 1
start: q0
accept: q0 trampa
delta:
q0 0 trampa
q0 1 q1
q1 0 q1
q1 1 q1
trampa 0 trampa
trampa 1 trampa
El complemento de “empieza con ” son las cadenas que no empiezan con : la vacía, que
queda en , y las que empiezan con , que quedan en trampa. Los dos estados son ahora de
aceptación.
La demostración usa, en una frase que es fácil pasar por alto, que existe para toda cadena. Eso vale porque es total. Con el “autómata” de dos estados sin trampa, la cuenta sale mal: al intercambiar quedaría solo como estado de aceptación. La cadena no tiene por dónde seguir desde , así que no se acepta ni antes ni después del intercambio. Pero no empieza con : debería estar en el complemento. El intercambio solo es correcto cuando toda cadena termina en algún estado.
Error común. Complementar un autómata al que le falta el estado trampa. Primero se completa y después se intercambian los estados de aceptación. El mismo cuidado hará falta la semana próxima: en un NFA, intercambiar los estados de aceptación no da el complemento.
Con complemento e intersección, la unión sale también de las leyes de De Morgan: es el complemento de
la intersección de los complementos. Si se hace con máquinas, el resultado es el mismo producto con el mismo
que da la construcción directa, y test_product lo comprueba.
Lo que un DFA no puede hacer
Todo lo construido esta semana recuerda una cantidad acotada de información: una paridad, un resto, los últimos símbolos. El lenguaje de la sección Lenguajes pide otra cosa. Para saber si los unos son tantos como los ceros hay que recordar cuántos ceros hubo, y esa cantidad no tiene tope.
La intuición de por qué ningún DFA alcanza es esta. Supongan un DFA con estados, y denle a leer las cadenas . Son cadenas y hay estados, así que dos de ellas, digamos y con , lo dejan en el mismo estado. Por el lema de la concatenación, desde ahí la máquina hará lo mismo con cualquier continuación: y terminan en el mismo estado, y se aceptan las dos o se rechazan las dos. Pero la primera está en el lenguaje y la segunda no. Un DFA con estados no puede distinguir cantidades.
Esto es solo la idea. La demostración cuidadosa, y dos herramientas generales para demostrar que un lenguaje no es regular, son el tema de la semana 4. Antes, en las semanas 2 y 3, veremos que los lenguajes regulares son más robustos de lo que parece: darle a la máquina la capacidad de adivinar no agrega ningún lenguaje, y las expresiones regulares describen exactamente la misma clase.
El código de la semana
code/week-01/
├── languages.h           cadenas y lenguajes finitos: prefijos, concatenación, estrella
├── strings_demo.cpp      las primeras cadenas de Σ*, y los prefijos, sufijos y subcadenas
├── languages_demo.cpp    operaciones con lenguajes finitos; ∅ frente a {ε}
├── dfa.h                 struct Dfa, lectura del formato .dfa, δ*, producto y complemento
├── show_dfa.cpp          muestra un .dfa como quíntupla y como tabla
├── run_dfa.cpp           la ejecución de un DFA con una o más cadenas
├── product.cpp           construcción del producto de dos .dfa
├── complement.cpp        complemento de un .dfa
├── machines/             los autómatas del capítulo, en formato .dfa
├── errors/               tres descripciones que no son un DFA
├── test_languages.cpp    pruebas de la sesión A
├── test_dfa.cpp          cada autómata contra un predicado; una afirmación por estado
├── test_product.cpp      el producto reconoce la intersección y la unión; complemento
└── lab/dfa_sim/          el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Las pruebas comprueban con assert lo
que este capítulo afirma. test_languages revisa los conteos de cadenas, los ejemplos de prefijos y las
operaciones con y . test_dfa compara cada autómata de machines/ con una función
de C++ que decide el mismo lenguaje mirando la cadena completa, sobre las 8191 cadenas de longitud a lo sumo 12,
y comprueba la afirmación de cada estado, las ejecuciones copiadas en estos apuntes y el lema de la
concatenación. test_product comprueba el lema del producto desde todos los pares, que el producto reconoce la
intersección y la unión, el complemento, y cuántos estados se alcanzan en cada ejemplo.
$ make test
test_languages: ok
test_dfa: ok (6 autómatas, 8191 cadenas cada uno)
test_product: ok
Todas las pruebas pasaron.
Los archivos de machines/ son:
| Archivo | Lenguaje | Estados |
|---|---|---|
even_ones.dfa |
Cantidad par de unos | 2 |
ends_01.dfa |
Termina en | 3 |
contains_101.dfa |
Contiene | 4 |
multiple_of_3.dfa |
Múltiplos de 3 en binario | 3 |
starts_with_1.dfa |
Empieza con , con estado trampa | 3 |
turnstile.dfa |
Secuencias que dejan bloqueado el torniquete | 2 |
Para experimentar, copien uno, cámbienle una transición y vuelvan a correr run_dfa con las mismas cadenas.
Si rompen la definición, show_dfa les dirá qué falta.
En dfa.h, es un std::map con los nombres de los estados como cadenas. Se eligió así para que el
código se lea como la definición, y no por velocidad: cada paso busca en el mapa comparando nombres. Para los
ejemplos del capítulo sobra.
El laboratorio
En lab/dfa_sim está el enunciado, un esqueleto y los casos. El problema es escribir un simulador: la entrada
es un DFA en formato .dfa seguido de una lista de cadenas, y la salida es acepta o rechaza por cada una.
cd lab/dfa_sim
make        # compila solution.cpp
make test   # corre el juez con todos los casos
dfa.h ya trae una función que simula, y pueden leerla. El trabajo del laboratorio es otro: leer el formato
completo, con el bloque de cadenas, y pasar los casos de borde. Por eso solution.cpp se escribe sin incluir
dfa.h. Los casos incluyen la cadena vacía, un DFA sin estados de aceptación, uno que acepta todo, estados
inalcanzables y tres entradas grandes. Lean las cadenas con std::getline: una línea vacía es la cadena
, y >> se la salta. El simulador que escriban les servirá las semanas siguientes para probar sus
propios autómatas.
Resumen
- Una cadena es una secuencia finita de símbolos de un alfabeto . La cadena vacía tiene longitud 0. es el conjunto de todas las cadenas: es infinito, y se puede listar.
- Las cadenas se definen por casos, o , y las propiedades se demuestran por inducción sobre la longitud, quitando el último símbolo. El caso base es .
- Un lenguaje es un conjunto de cadenas. no tiene ninguna, tiene una, y es una cadena y no un lenguaje. , y .
- Las operaciones sobre lenguajes son unión, intersección, complemento, concatenación y estrella. siempre contiene a .
- Un problema de decisión es un lenguaje: el de las entradas con respuesta sí. Hay que fijar cómo se escribe la entrada.
- Los programas se pueden listar y los lenguajes no: hay lenguajes que ningún programa decide. El argumento no dice cuáles. Eso llega en la semana 9.
- Un DFA es . La función es total y da un solo estado: una flecha por cada estado y cada símbolo. El diagrama y la tabla de transiciones dicen lo mismo.
- es el estado al que se llega desde leyendo : y . acepta si , y reconoce el lenguaje de las cadenas que acepta. Solo cuenta el estado final.
- Diseñar un DFA es decidir qué recordar: cada estado es un hecho sobre lo leído. Demostrar que es correcto es probar una afirmación por estado, por inducción sobre la longitud.
- Lo que “ya perdió” va a un estado trampa. No se dejan transiciones sin definir.
- Un lenguaje es regular si algún DFA lo reconoce.
- La construcción del producto corre dos DFA a la vez con estados . Con reconoce la intersección, y con los pares donde alguno acepta, la unión. Tiene estados, y no todos son siempre alcanzables.
- El complemento se obtiene cambiando por . Funciona porque es total.
- Los lenguajes regulares son cerrados bajo unión, intersección y complemento.
Ejercicios
- Sea . Escriban todos sus prefijos, todos sus sufijos y todas sus subcadenas distintas, y
cuéntenlas. Comprueben con
build/strings_demo 01101. ¿Qué cadena binaria de longitud 5 tiene menos subcadenas distintas, y cuántas tiene? - ¿Cuántas cadenas tiene ? ¿Y ? Calculen , ,
, y , y
expliquen cada resultado con la definición. Después modifiquen
languages_demo.cpppara comprobarlos. - Sean y . Calculen , , y las cadenas de de longitud a lo sumo 4. ¿Cuántas cadenas tiene , y por qué no son ? Den dos lenguajes de tres cadenas cada uno cuya concatenación tenga nueve, y otros dos cuya concatenación tenga menos.
- Definan el reverso por casos: y . Demuestren por inducción sobre que . Digan en qué paso usan que la concatenación es asociativa y en cuál que es su neutro. Después demuestren que .
- Escriban como lenguaje cada problema, diciendo el alfabeto y cómo se representa la entrada: (a) ¿es un cuadrado perfecto?; (b) ¿está ordenada esta lista de números?; (c) ¿tiene este grafo un ciclo? En cada uno, den una cadena del lenguaje, una que no esté porque la respuesta es no, y una que no esté porque está mal formada.
- Den un DFA para las cadenas sobre que no contienen
aa. Escriban qué recuerda cada estado, la tabla y el archivo.dfa, y síganlo conrun_dfaparaabab,baaby la cadena vacía. ¿Cuál es el estado trampa? - Diseñen un DFA para cada lenguaje sobre , con la tabla de lo que recuerda cada estado: (a) las cadenas de longitud impar; (b) las que empiezan y terminan con el mismo símbolo; (c) las que tienen un en la penúltima posición; (d) las que no terminan en . Para (d), ¿pueden reutilizar un autómata del capítulo?
- Demuestren que el autómata de
machines/contains_101.dfareconoce el lenguaje , con las cuatro afirmaciones de su tabla de estados. ¿En qué caso del paso inductivo se usa que con se queda en ? - Demuestren que el autómata de
machines/multiple_of_3.dfacumple , donde es el resto de entre 3. Después diseñen el DFA de los múltiplos de 5 en binario. ¿Cuántos estados tiene? ¿Qué cambia si el número se lee con el bit menos significativo primero? Diseñen ese autómata para los múltiplos de 3. - Con
product, construyan el autómata de las cadenas que contienen y son múltiplo de 3. ¿Cuántos estados tiene, y cuántos son alcanzables? Sigan a mano la cadena en el producto y comprueben conrun_dfa. Después repitan con Termina en 01 y Empieza con 1: expliquen cada par inalcanzable como dos hechos que se contradicen. - La diferencia y la diferencia simétrica (las cadenas que están en exactamente uno de los dos) también salen del producto. Den el de cada una y demuestren una de las dos con la cadena de equivalencias de este capítulo. ¿Cuántos conjuntos distintos se pueden elegir en el producto de la cuadrícula de 6 estados?
- Si tiene estados, ¿cuántos tiene el DFA del complemento de ? Den un lenguaje regular sobre tal que y su complemento sean infinitos, y otro tal que sea infinito y su complemento finito. ¿Puede un DFA con todos sus estados alcanzables y reconocer el lenguaje ?
- Para programar. Agreguen a
dfa.huna función que decida si , sin probar cadenas: un DFA acepta alguna cadena si y solo si algún estado de aceptación es alcanzable. Con ella y con el producto, escriban un programa que decida si dos DFA reconocen el mismo lenguaje, y úsenlo para comparar el autómata de 7 estados de Termina en 01, el que recuerda los dos últimos símbolos, con el de 3. Este problema vuelve en el laboratorio de la semana 9.