
Apuntes · Capítulo 2Lenguajes regulares
No determinismo
No determinismo
La semana pasada definimos el autómata finito determinista (DFA): en cada estado, con cada símbolo, hay exactamente una flecha que seguir. Con esa máquina diseñamos reconocedores, demostramos que eran correctos y vimos que los lenguajes regulares son cerrados bajo unión, intersección y complemento. Quedaron dos operaciones sin tocar, la concatenación y la estrella, y no fue por descuido: con un DFA no se ve cómo hacerlas. Para reconocer habría que saber dónde termina el trozo de y empieza el de , y un DFA lee la entrada una sola vez, sin poder probar varios cortes.
Esta semana le damos a la máquina una capacidad que parece trampa: elegir. Un autómata finito no determinista (NFA) puede tener, desde un estado y con un símbolo, varias flechas, o ninguna, y puede cambiar de estado sin leer nada. Acepta una cadena si alguna manera de elegir lo lleva a un estado de aceptación. Con esa libertad, los diseños que costaban salen cortos, y la concatenación y la estrella se construyen en dos líneas.
La sorpresa de la semana es que la capacidad nueva no agrega ningún lenguaje. Todo NFA se puede convertir en un DFA que reconoce exactamente lo mismo, con la construcción de subconjuntos. El no determinismo es entonces una herramienta para diseñar y para demostrar, y el precio de quitarlo está en la cantidad de estados, que puede crecer exponencialmente. La misma pregunta, cuánto cuesta simular a una máquina que adivina con una que no adivina, vuelve al final del curso con las máquinas de Turing y el tiempo: ahí es la pregunta de si P es igual a NP, y nadie conoce la respuesta. Aquí sí la vamos a conocer completa.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Un diseño que con un DFA cuesta y Qué cambia en un NFA. Antes de la sesión B, La construcción de subconjuntos hasta el primer ejemplo. Con eso llegan con el primer NFA ya visto y con la idea de la construcción.
En clase: Sesión A, de Un diseño que con un DFA cuesta a Todo DFA es un NFA. Sesión B, de La construcción de subconjuntos a El complemento no se hace en el NFA.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, La clausura ε, La construcción de subconjuntos otra vez y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 1.2 (Nondeterminism), completa: la definición formal, Equivalence of NFAs and DFAs y Closure under the regular operations. Erickson, Models of Computation, nota 4 (Nondeterministic automata). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-02. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/nfa_to_dfa.
Un diseño que con un DFA cuesta
Lenguaje.
Las cadenas , y están en . Las cadenas , y todas las de longitud menor que 3 no están.
Apliquemos el método de la semana pasada: ponerse en el lugar de la máquina y decidir qué recordar. Los símbolos llegan de uno en uno y en cualquier momento pueden decir “ahí terminó”. Cuando llega un , la máquina no sabe si ese será el tercero desde el final: depende de cuántos símbolos falten, y eso no lo ve. Para poder responder siempre, tiene que recordar los tres últimos símbolos que leyó, completos. Hay combinaciones, y hace falta un estado por cada una: un DFA de 8 estados y 16 transiciones. Las cadenas de menos de tres símbolos se acomodan en los mismos estados, como si antes de ellas hubiera ceros. Se puede hacer, y más abajo lo va a construir un programa. Pero el diseño no se parece a la descripción del lenguaje, y si en lugar del tercero fuera el décimo símbolo desde el final, serían estados.
Ahora supongan que la máquina pudiera adivinar. Lee símbolos sin hacer nada, y cuando llega un puede apostar: “este es el tercero desde el final”. Para comprobar la apuesta solo tiene que leer dos símbolos más, cualesquiera, y ver que ahí se acaba la cadena. Eso son cuatro estados:
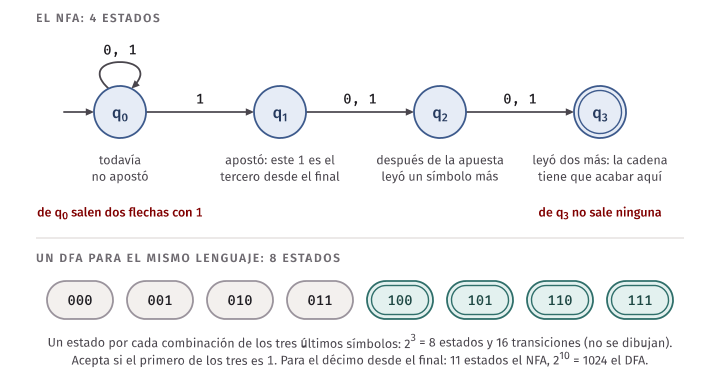
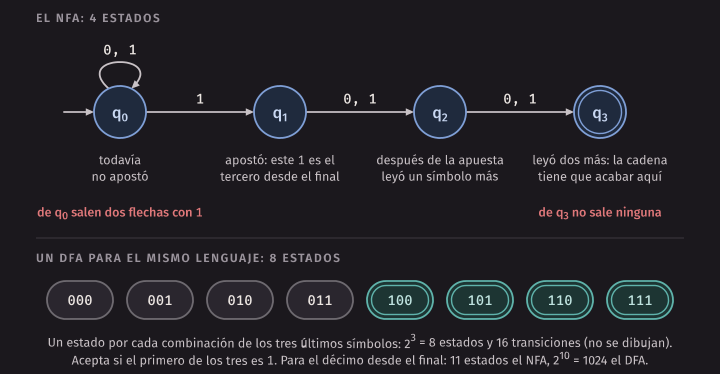
| Estado | Lo que significa |
|---|---|
| Todavía no apostó | |
| Apostó: el que acaba de leer es el tercero desde el final | |
| Después de la apuesta leyó un símbolo más | |
| Después de la apuesta leyó dos símbolos más: si la cadena termina aquí, la apuesta era correcta |
Este dibujo no es un DFA, por dos razones. Del estado salen dos flechas con : una que vuelve a y otra que va a . Y del estado no sale ninguna. Es un autómata finito no determinista, y es la máquina de esta semana.
Qué cambia en un NFA
Un NFA se dibuja igual que un DFA: círculos, flechas con etiquetas, una flecha de entrada para el estado inicial y doble círculo para los estados de aceptación. Cambian tres reglas sobre las flechas.
- Varias flechas con el mismo símbolo. Desde un estado, con un símbolo, puede haber más de un destino. La máquina puede seguir cualquiera de ellos.
- Ninguna flecha. Desde un estado puede no haber flecha con algún símbolo. Si la máquina está ahí y llega ese símbolo, ese intento se acaba: decimos que el camino muere. No hace falta estado trampa.
- Flechas sin símbolo. Una flecha puede llevar la etiqueta . La máquina puede seguirla sin leer nada de la entrada. Se llaman transiciones (ε-transitions) y aparecen dos secciones más abajo.
Y cambia qué significa aceptar. En un DFA la cadena determina un solo recorrido. En un NFA, una misma cadena puede tener muchos recorridos, según qué flecha se elija en cada paso, y algunos terminan en un estado de aceptación y otros no.
Idea clave. Un NFA acepta una cadena si existe al menos un camino que lee la cadena completa y termina en un estado de aceptación. No importa cuántos otros caminos mueran o terminen en otro lado. La rechaza solo si ningún camino lo logra.
El autómata del dibujo está en machines/third_from_end.nfa, en el formato .nfa de code/formats.md:
# El tercer símbolo desde el final es 1.
# q0: espera. q1: adivinó que el 1 que acaba de leer es el tercero desde el final.
# q2: leyó un símbolo más. q3: leyó dos más.
states: q0 q1 q2 q3
alphabet: 0 1
start: q0
accept: q3
delta:
q0 0 q0
q0 1 q0 q1
q1 0 q2
q1 1 q2
q2 0 q3
q2 1 q3
El formato es el de la semana pasada con dos diferencias. Una línea de delta: puede tener varios destinos:
q0 1 q0 q1 dice que desde q0, con 1, se puede ir a q0 o a q1. Y un par de estado y símbolo puede no
tener línea: no hay ninguna para q3. El programa show_nfa muestra la máquina como tabla:
$ build/show_nfa machines/third_from_end.nfa
Q  = {q0, q1, q2, q3}
Σ  = {0, 1}
q0 = q0
F  = {q3}

     δ   0     1        ε
->   q0  {q0}  {q0,q1}  {}
     q1  {q2}  {q2}     {}
     q2  {q3}  {q3}     {}
   * q3  {}    {}       {}

no tiene transiciones ε: E(S) = S para todo conjunto S
En la tabla de un DFA cada casilla era un estado. Aquí cada casilla es un conjunto de estados: todos los
destinos posibles. Los programas del capítulo escriben {} para el conjunto vacío . La fila de
q3 es toda {}: de ahí no sale nada. La columna ε está vacía porque esta máquina no tiene transiciones
. La última línea habla de , la clausura , que se define más abajo.
Sigamos la máquina a mano con . En , el primer solo permite quedarse. Con el primer hay que elegir: quedarse en o apostar y pasar a . Si la máquina apuesta ahí, lee el segundo y pasa a , lee el y pasa a , y la cadena se acabó: está en un estado de aceptación. Ese es un camino que acepta, y con uno basta: . En efecto, el tercer símbolo desde el final de es el primer .
Tres maneras de pensar el no determinismo
Una máquina real no adivina. El no determinismo es una definición matemática, y hay tres imágenes que ayudan a razonar con ella. Las tres dicen lo mismo, y conviene saber pasar de una a otra.
Adivinar bien. La máquina tiene suerte perfecta: cada vez que hay varias flechas, elige la que lleva a aceptar, si alguna lleva. Es la imagen más cómoda para diseñar: uno piensa “la máquina adivina dónde está el tercer símbolo desde el final, y después comprueba”. El NFA no necesita saber cómo adivinar. Solo necesita que, cuando la cadena está en el lenguaje, haya una adivinanza que funcione, y que cuando no está, ninguna adivinanza pueda engañarlo. La segunda mitad es la que se olvida: una apuesta equivocada no puede terminar en aceptación.
Explorar todos los caminos a la vez. Cada vez que hay varias flechas, la máquina se copia a sí misma y cada copia sigue una. Una copia que no tiene flecha con el símbolo que llega desaparece. Al final de la cadena, si alguna copia está en un estado de aceptación, la cadena se acepta. Como dos copias en el mismo estado hacen lo mismo de ahí en adelante, no hace falta contarlas: basta saber en qué estados hay alguna copia. Ese conjunto de estados es lo que un programa lleva para simular un NFA, y es la idea de la sesión B.
Un árbol de ejecuciones. La raíz es el estado inicial. Cada nodo tiene un hijo por cada flecha que puede seguir con el símbolo que toca. El DFA era el caso en que el árbol es una sola rama. La cadena se acepta si alguna hoja, al nivel del final de la cadena, es un estado de aceptación.
El programa paths_nfa escribe el árbol rama por rama, cada una desde la raíz:
$ build/paths_nfa machines/third_from_end.nfa 0110
w = 0110
  q0 -0-> q0 -1-> q0 -1-> q0 -0-> q0    termina en q0, que no está en F
  q0 -0-> q0 -1-> q0 -1-> q1 -0-> q2    termina en q2, que no está en F
  q0 -0-> q0 -1-> q1 -1-> q2 -0-> q3    termina en q3, que está en F
caminos que leen toda la cadena: 3    que mueren antes: 0    que terminan en F: 1
algún camino termina en F: acepta
Hay tres caminos, uno por cada decisión posible: no apostar nunca, apostar en el segundo o apostar en el primero. Solo el último acepta. El segundo apostó tarde: la cadena se acabó antes de llegar a . Con se ve la otra manera de equivocarse:
$ build/paths_nfa machines/third_from_end.nfa 1100
w = 1100
  q0 -1-> q0 -1-> q0 -0-> q0 -0-> q0    termina en q0, que no está en F
  q0 -1-> q0 -1-> q1 -0-> q2 -0-> q3    termina en q3, que está en F
  q0 -1-> q1 -1-> q2 -0-> q3    muere: q3 no tiene transición con 0
caminos que leen toda la cadena: 2    que mueren antes: 1    que terminan en F: 1
algún camino termina en F: acepta
El tercer camino apostó demasiado pronto. Llegó a cuando todavía faltaba un símbolo, y como de no sale ninguna flecha, murió. Pasó por un estado de aceptación y no cuenta: igual que en un DFA, solo importa dónde se está cuando la cadena se acaba. Por eso no tiene flechas de salida: es lo que obliga a que la apuesta sea exacta.
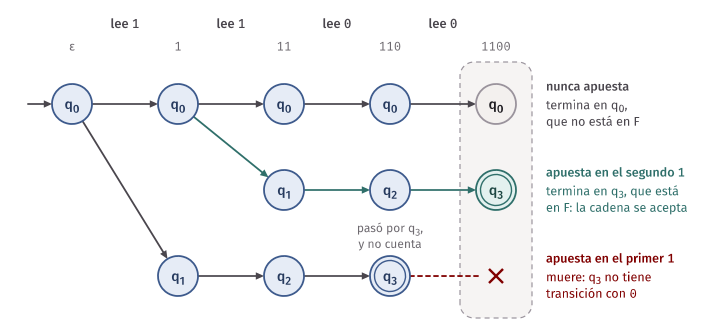
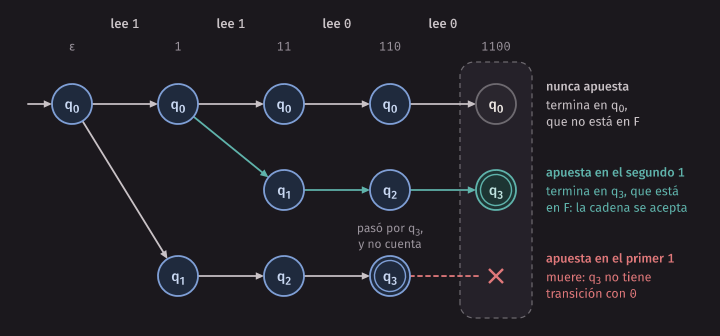
Error común. Creer que el NFA acepta solo si todos los caminos aceptan. Es al revés: basta uno. Con , dos de los tres caminos no aceptan, y la cadena se acepta.
Error común. Creer que el NFA “elige al azar” y que a veces acepta una cadena y a veces no. En un NFA no hay probabilidades ni suerte: que esté en el lenguaje es un hecho sobre la máquina y la cadena, que depende de si existe un camino. Las máquinas que de verdad lanzan monedas son otro modelo, que aparece en la semana 15.
Error común. Decir que un camino que muere “rechaza la cadena”. Un camino que muere no decide nada: solo deja de contar. La cadena se rechaza cuando no queda ningún camino que termine en aceptación.
La definición formal de un NFA
Definición. Un autómata finito no determinista (nondeterministic finite automaton), o NFA, es una quíntupla , donde:
- es un conjunto finito, el de los estados.
- es un alfabeto.
- es la función de transición.
- es el estado inicial.
- es el conjunto de los estados de aceptación.
Cuatro de los cinco componentes son los de un DFA. Toda la diferencia está en el tipo de , y conviene leerlo pieza por pieza.
- Lo que devuelve: . Es el conjunto potencia de : el conjunto de todos los subconjuntos de . Entonces no es un estado, sino un conjunto de estados: los destinos posibles. En el ejemplo, y .
- El conjunto puede ser vacío. : no hay flecha. Así entran en la definición las reglas 1 y 2 de la sección anterior, sin casos especiales. Y sigue siendo una función total: para cada par devuelve exactamente un conjunto, que a veces es .
- Lo que recibe: . El segundo argumento puede ser un símbolo o . es el conjunto de estados a los que se puede pasar desde sin leer nada. Sipser escribe para abreviar .
Error común. Tratar a como un símbolo más del alfabeto. no está en y nunca aparece en la entrada: es la cadena vacía, y una transición es un paso que no consume ningún símbolo. La cadena tiene dos símbolos, y un camino que la lee puede tener dos pasos, o cinco si tres de ellos son transiciones .
Falta decir con la misma precisión qué es aceptar. Con un DFA bastó la función , porque había un solo recorrido. Aquí hay que hablar de caminos.
Definición. Sean y estados de y una cadena sobre . Un camino de a con etiqueta es una secuencia de estados y una secuencia de etiquetas , con y cada , tales que:
- y ;
- para cada de 1 a : cada paso sigue una flecha de la máquina;
- : las etiquetas, concatenadas, forman .
En la condición 3, una etiqueta es la cadena vacía y no aporta nada a la concatenación. Por eso puede ser mayor que : el camino tiene pasos que leen un símbolo y cualquier cantidad de pasos entre ellos. El caso es el camino que no se mueve: va de a con etiqueta .
Definición. acepta la cadena si existe un camino de a algún estado de con etiqueta . El lenguaje de es
y se dice que reconoce .
Cada línea que imprime paths_nfa y que lee toda la cadena es un camino desde con etiqueta , en el
sentido de esta definición. Un camino que muere no lo es: sus etiquetas forman solo un prefijo de .
En C++. El
struct Nfadenfa.hes elstruct Dfade la semana pasada con un solo tipo cambiado. El valor dedeltaya no es un estado, sino un conjunto:using StateSet = std::set<std::string>; struct Nfa { std::vector<std::string> states; // Q, en el orden del archivo std::vector<char> alphabet; // Σ std::map<std::pair<std::string, char>, StateSet> delta; // δ : Q × (Σ ∪ {ε}) → P(Q) std::string start; // q0 StateSet accept; // F ⊆ Q };Una clave que no está en el mapa vale : la función
delta_of(n, q, a)devuelve el conjunto guardado o uno vacío. Para se usa la constanteEPS, un carácter que ningún archivo puede tener como símbolo. A diferencia decheck_dfa, la funcióncheck_nfano exige que haya una línea por cada par.
Transiciones ε
Una transición deja que la máquina cambie de estado sin leer. Sirve para decir “aquí se puede saltar esta parte” o “aquí se puede pasar a otra máquina”, y es la pieza con la que se arman todas las construcciones de la sesión B.
Lenguaje. .
La semana pasada, el DFA de Contiene 101 pidió cuidado: en cada estado había que pensar cuánto de lo leído servía para un intento nuevo cuando el actual fallaba. Con un NFA no hace falta. La máquina adivina dónde empieza el patrón, lo comprueba símbolo por símbolo, y si se equivocó, ese camino muere y no pasa nada. Los dos patrones, y , se diferencian en que el segundo no tiene el del medio: una transición permite saltárselo.
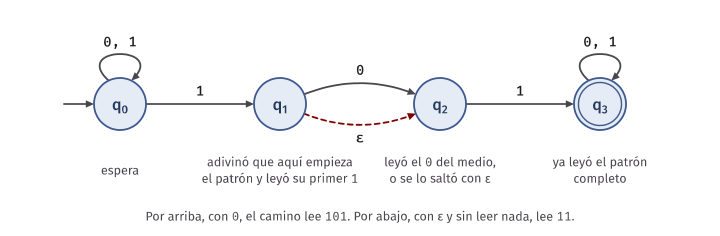
$ build/show_nfa machines/contains_101_or_11.nfa
Q  = {q0, q1, q2, q3}
Σ  = {0, 1}
q0 = q0
F  = {q3}

     δ   0     1        ε
->   q0  {q0}  {q0,q1}  {}
     q1  {q2}  {}       {q2}
     q2  {}    {q3}     {}
   * q3  {q3}  {q3}     {}

clausura ε de cada estado:
  E({q0}) = {q0}
  E({q1}) = {q1,q2}
  E({q2}) = {q2}
  E({q3}) = {q3}
En el archivo, la transición se escribe con eps en el lugar del símbolo: q1 eps q2. Desde
hay dos maneras de llegar a : leyendo un , que es el del medio de , o sin
leer nada, que es el caso de . El estado tiene flechas hacia sí mismo: una vez visto el
patrón, lo que siga no importa.
$ build/paths_nfa machines/contains_101_or_11.nfa 0101
w = 0101
  q0 -0-> q0 -1-> q0 -0-> q0 -1-> q0    termina en q0, que no está en F
  q0 -0-> q0 -1-> q0 -0-> q0 -1-> q1    termina en q1, que no está en F
  q0 -0-> q0 -1-> q0 -0-> q0 -1-> q1 -ε-> q2    termina en q2, que no está en F
  q0 -0-> q0 -1-> q1 -0-> q2 -1-> q3    termina en q3, que está en F
  q0 -0-> q0 -1-> q1 -ε-> q2    muere: q2 no tiene transición con 0
caminos que leen toda la cadena: 4    que mueren antes: 1    que terminan en F: 1
algún camino termina en F: acepta
El cuarto camino es el que acepta: apostó a que el patrón empezaba en el primer y leyó . El quinto hizo la misma apuesta pero tomó la transición , esperando un : llegó un y murió. El segundo y el tercero son la misma apuesta en el último , con y sin el paso final: los dos leen toda la cadena, y por eso son dos caminos distintos con la misma etiqueta.
Un segundo ejemplo, en el que las transiciones van en cadena.
Lenguaje. Sobre , las cadenas formadas por algunas , después algunas y después algunas , donde cada bloque puede ser vacío: , , y están; y no.
$ build/show_nfa machines/abc_blocks.nfa
Q  = {qa, qb, qc}
Σ  = {a, b, c}
q0 = qa
F  = {qc}

     δ   a     b     c     ε
->   qa  {qa}  {}    {}    {qb}
     qb  {}    {qb}  {}    {qc}
   * qc  {}    {}    {qc}  {}

clausura ε de cada estado:
  E({qa}) = {qa,qb,qc}
  E({qb}) = {qb,qc}
  E({qc}) = {qc}
Cada estado lee su letra, y una transición pasa al bloque siguiente. La máquina adivina cuándo se acabó cada bloque. Este autómata acepta la cadena vacía aunque su estado inicial no es de aceptación: el camino , con dos pasos , tiene etiqueta y termina en .
$ build/paths_nfa machines/abc_blocks.nfa ac
w = ac
  qa -a-> qa -ε-> qb -ε-> qc -c-> qc    termina en qc, que está en F
  qa -ε-> qb -ε-> qc    muere: qc no tiene transición con a
caminos que leen toda la cadena: 1    que mueren antes: 1    que terminan en F: 1
algún camino termina en F: acepta
La clausura ε
Para seguir un NFA con transiciones hay que saber, en cada momento, a dónde se puede llegar “gratis”.
Definición. Sea un conjunto de estados. La clausura (ε-closure) de es
Un camino con etiqueta es uno cuyos pasos son todos transiciones : cero pasos, uno, o varios seguidos. De la definición salen tres propiedades que usaremos sin nombrarlas.
- , porque el camino de cero pasos va de cada estado a sí mismo.
- Si , entonces .
- : después de cerrar, no queda nada por agregar, porque dos caminos seguidos son un camino .
En el autómata de los bloques, : desde se llega a con un paso y a con dos. En el de Contiene 101 o 11, y la clausura de los demás estados no agrega nada. Si un NFA no tiene transiciones , para todo .
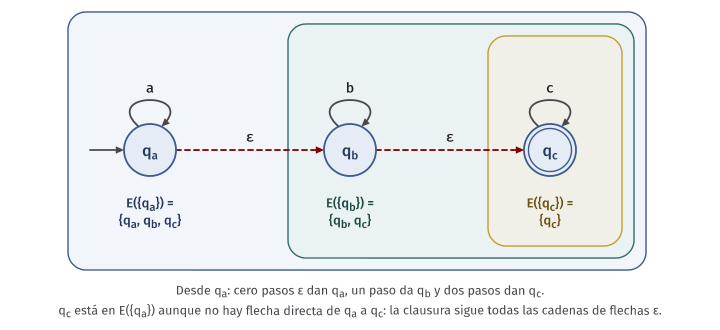
Error común. Seguir una sola transición y detenerse. La clausura sigue todas las cadenas de transiciones : está en aunque no haya flecha directa de a . El error contrario también aparece: olvidar que mismo está dentro de .
Calcular es un problema de grafos que ya conocen. Si se dejan solo las flechas , queda un grafo dirigido, y son los vértices alcanzables desde . Cualquier recorrido sirve:
algoritmo clausura(N, S)
    E ← S
    pendientes ← los estados de S
    mientras pendientes no esté vacío
        q ← sacar uno de pendientes
        para cada r en δ(q, ε)
            si r no está en E entonces
                agregar r a E
                agregar r a pendientes
            fin si
        fin para
    fin mientras
    devolver E
fin algoritmo
Cada estado entra en pendientes a lo sumo una vez, así que el algoritmo termina aunque las transiciones
formen un ciclo.
En C++. Es el recorrido en anchura de Algoritmos, con una cola.
closure.insert(r).secondes verdadero solo sirno estaba: marca el estado como visto y avisa si era nuevo, en una sola operación.inline StateSet eps_closure(const Nfa& n, const StateSet& s) { StateSet closure = s; std::queue<std::string> pending; for (const std::string& q : s) { pending.push(q); } while (!pending.empty()) { std::string q = pending.front(); pending.pop(); for (const std::string& r : delta_of(n, q, EPS)) { if (closure.insert(r).second) { pending.push(r); } } } return closure; }
Seguir un NFA: el conjunto de estados activos
Listar todos los caminos sirve para entender, pero no para calcular: una cadena de símbolos puede tener una cantidad exponencial de caminos. La segunda imagen del no determinismo da un método mejor. No interesa cuántas copias de la máquina hay, sino en qué estados hay alguna. Llamamos estados activos a esos estados. Antes de leer nada, los estados activos son el inicial y todo lo que se alcanza desde él con transiciones . Cada símbolo transforma el conjunto de estados activos en otro.
Definición. La función de transición extendida de un NFA trabaja sobre conjuntos de estados. Para :
La segunda línea se lee en tres pasos: se toman los estados activos después de ; desde cada uno se siguen todas las flechas con y se juntan los destinos; y se cierra el resultado con las transiciones . El conjunto de estados activos después de leer es .
Hagámoslo a mano con el autómata de Contiene 101 o 11 y . En cada fila, la tercera columna junta los destinos de las flechas con el símbolo leído, y la cuarta le aplica la clausura.
| Leído | Símbolo | Destinos de las flechas | Estados activos |
|---|---|---|---|
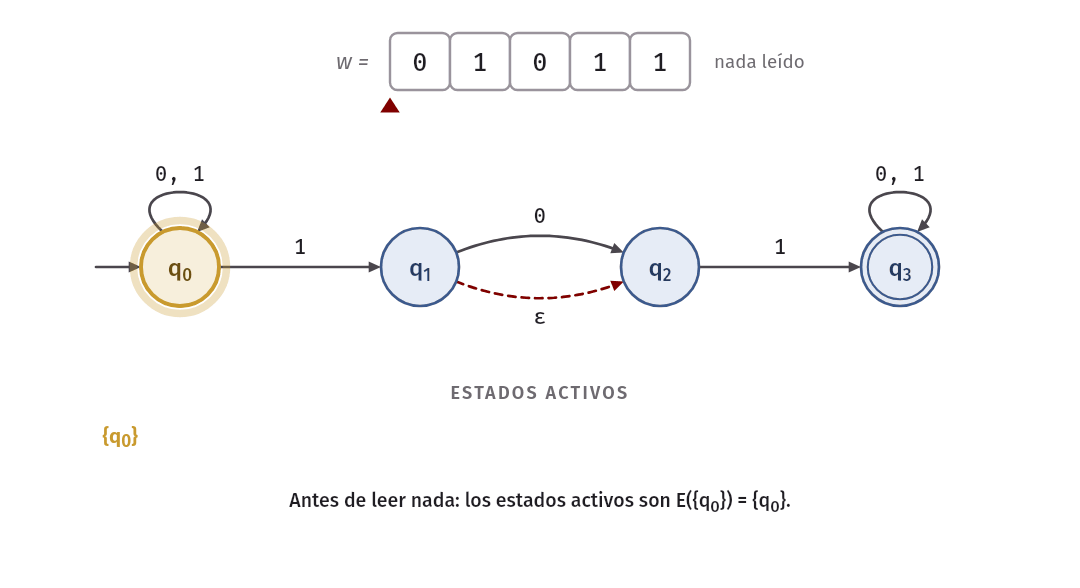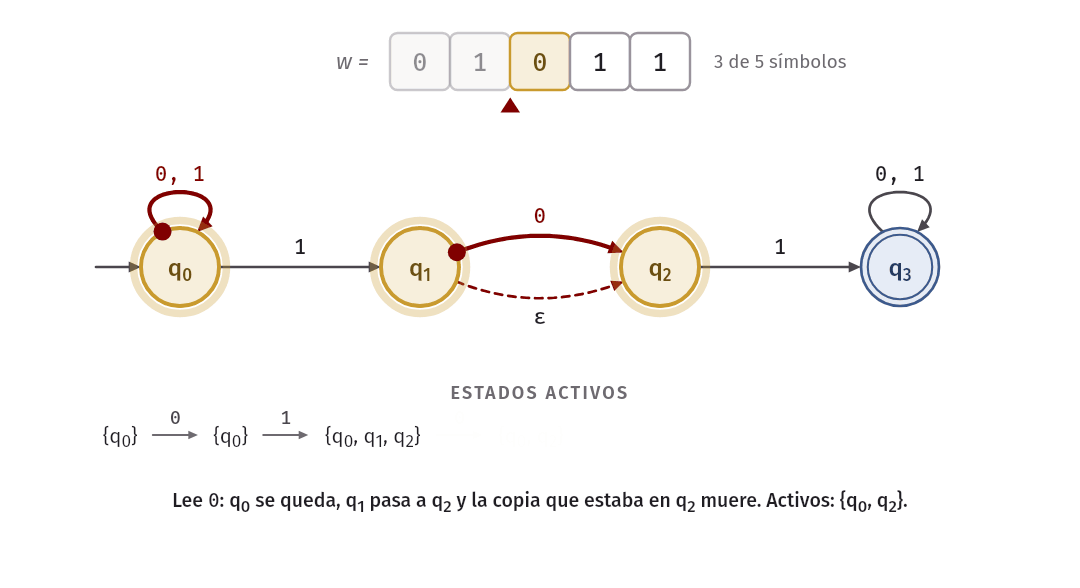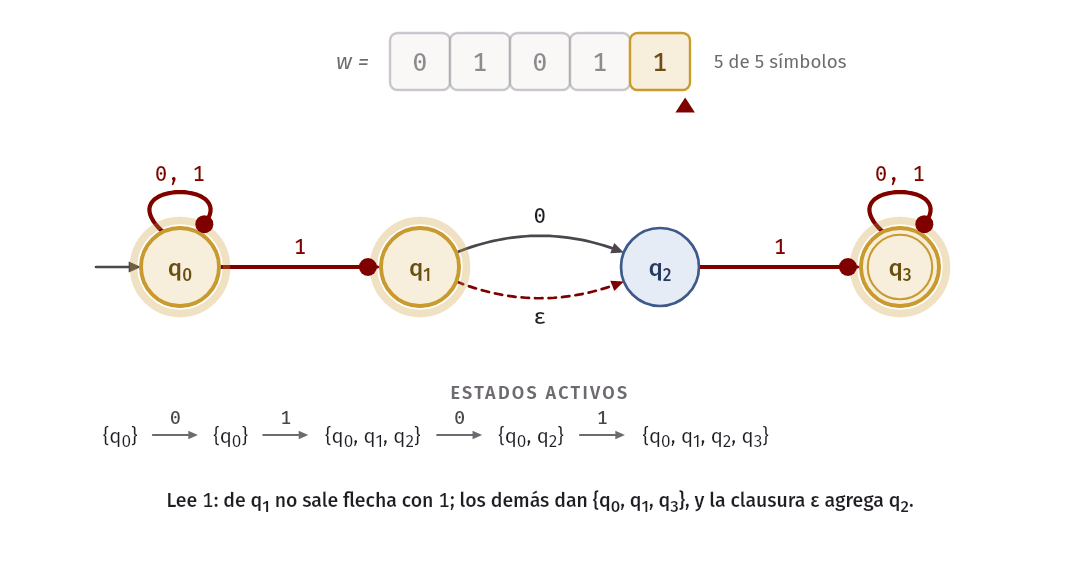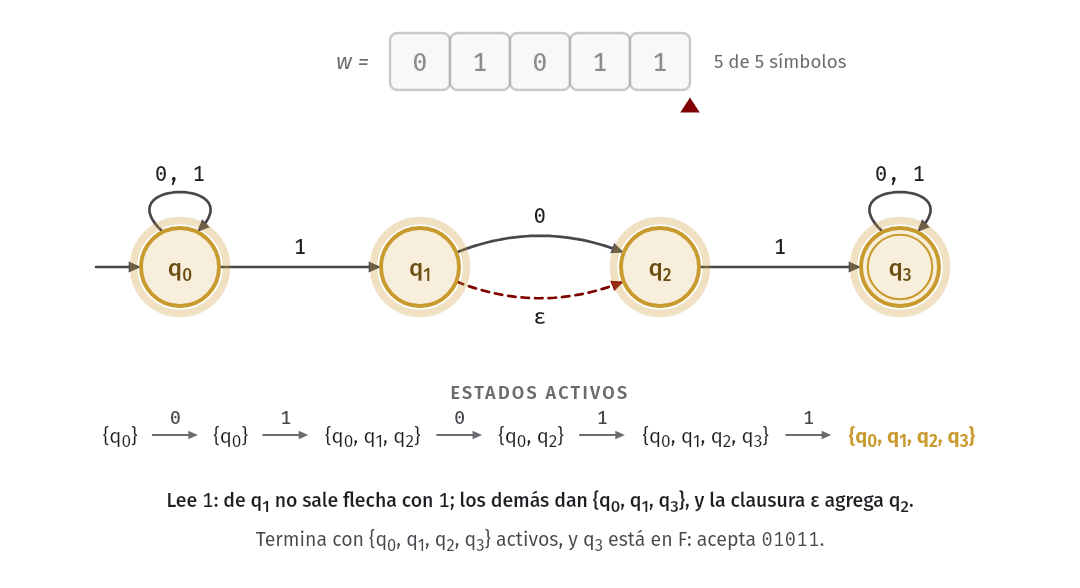
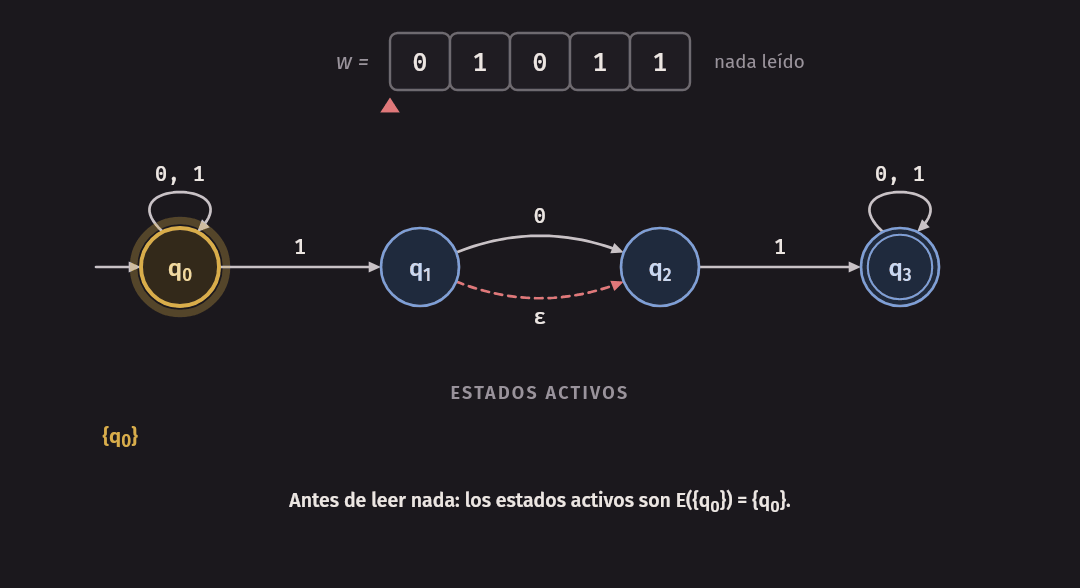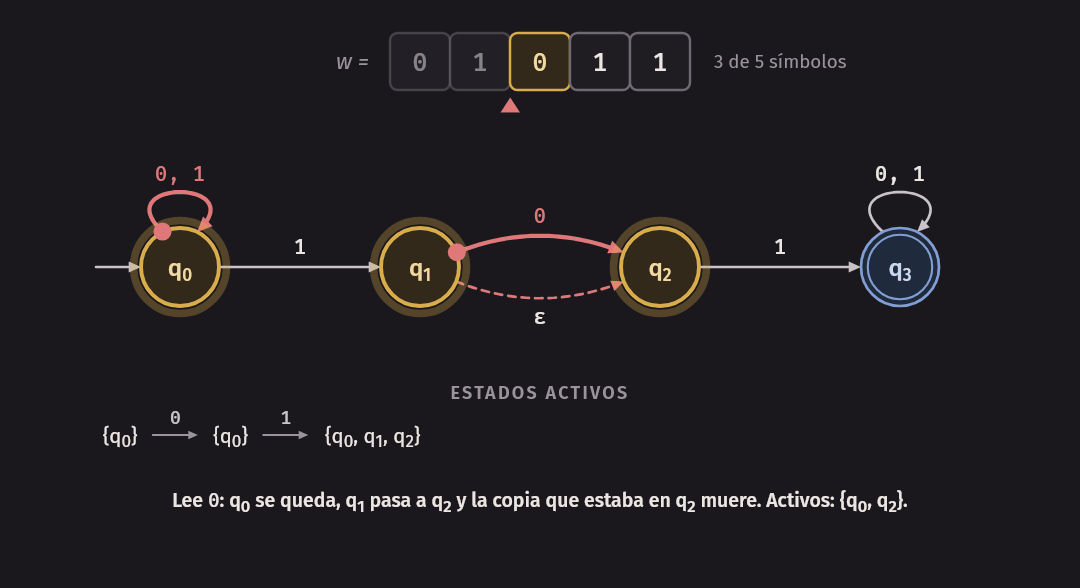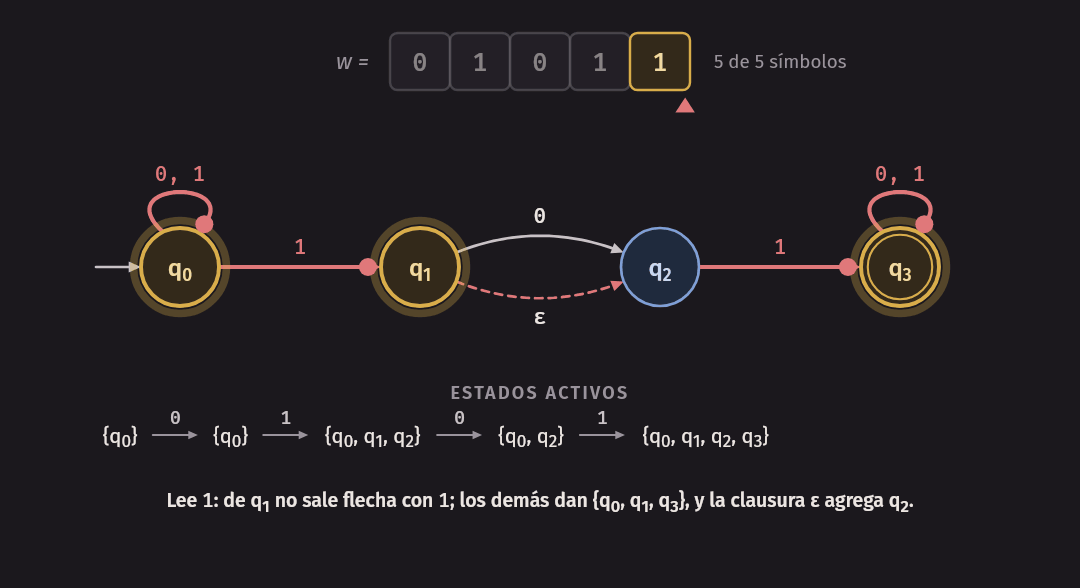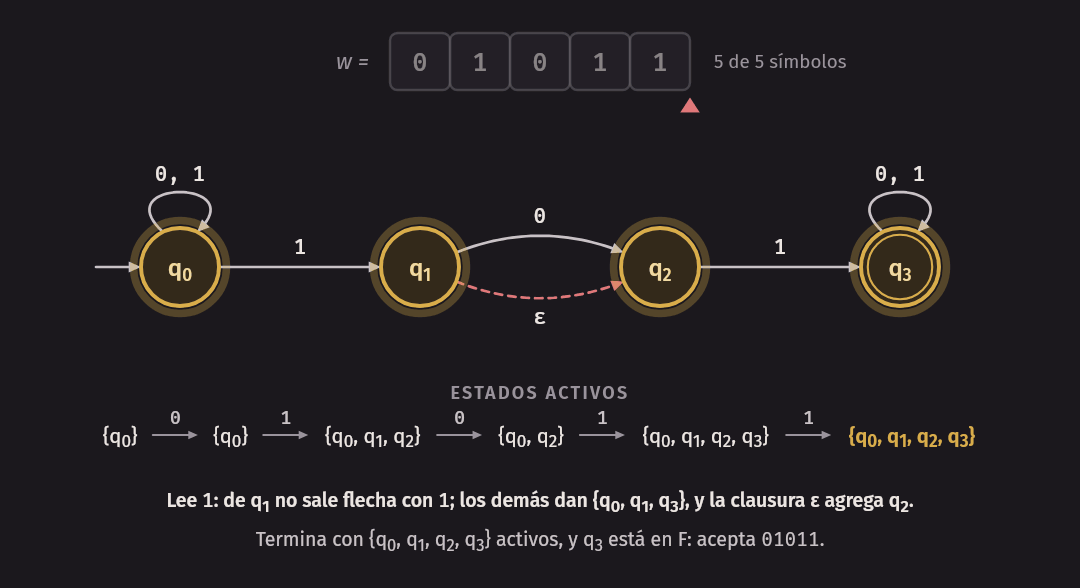
En la tercera fila, la clausura agrega porque entró al conjunto y . En la cuarta,
los tres estados activos aportan , y
: la copia que estaba en murió, y no se nota porque el conjunto
simplemente no recibe nada de ella. Al final, está activo y es de aceptación. El programa run_nfa hace
la misma cuenta:
$ build/run_nfa machines/contains_101_or_11.nfa 01011 0100
w = 01011
  {q0} -0-> {q0} -1-> {q0,q1,q2} -0-> {q0,q2} -1-> {q0,q1,q2,q3} -1-> {q0,q1,q2,q3}
  termina con {q0,q1,q2,q3} activos, y q3 está en F: acepta
w = 0100
  {q0} -0-> {q0} -1-> {q0,q1,q2} -0-> {q0,q2} -0-> {q0}
  termina con {q0} activos, y ninguno está en F: rechaza
Con , el conjunto se achica al final: la copia de esperaba un y llegó un . Queda solo , que no es de aceptación. El conjunto de estados activos puede incluso quedar vacío, cuando mueren todas las copias:
$ build/run_nfa machines/abc_blocks.nfa aacc abca ''
w = aacc
  {qa,qb,qc} -a-> {qa,qb,qc} -a-> {qa,qb,qc} -c-> {qc} -c-> {qc}
  termina con {qc} activos, y qc está en F: acepta
w = abca
  {qa,qb,qc} -a-> {qa,qb,qc} -b-> {qb,qc} -c-> {qc} -a-> {}
  termina con {} activos, y ninguno está en F: rechaza
w = ε
  {qa,qb,qc}
  termina con {qa,qb,qc} activos, y qc está en F: acepta
Con , después de la solo queda , que no tiene flecha con : el conjunto pasa a ser . Desde ya no se sale, porque no hay ningún estado del que seguir flechas. Y con la cadena vacía se ve para qué sirve la primera línea de la definición: los estados activos antes de leer nada son , que ya contiene a .
Lo que hace que este método sea correcto es que el conjunto calculado coincide con la definición por caminos.
Lema (de los estados activos). Para todo conjunto y toda cadena , es exactamente el conjunto de los estados para los que hay un camino con etiqueta desde algún estado de hasta .
La demostración es por inducción sobre y está en la sesión B, en Por qué funciona: la equivalencia, porque es la mitad del teorema principal de la semana. Por ahora tomemos su consecuencia.
Corolario. acepta si y solo si : algún estado activo al final es de aceptación.
En efecto, por definición acepta si hay un camino con etiqueta de a algún , y por el lema esos son los elementos de que están en .
En C++. Un paso con el símbolo
ay la función extendida, ennfa.h. Son las dos líneas de la definición.inline StateSet step(const Nfa& n, const StateSet& s, char a) { StateSet targets; for (const std::string& q : s) { StateSet next = delta_of(n, q, a); targets.insert(next.begin(), next.end()); } return eps_closure(n, targets); } inline StateSet delta_star(const Nfa& n, const StateSet& s, const std::string& w) { StateSet active = eps_closure(n, s); for (char a : w) { active = step(n, active, a); } return active; } inline bool accepts(const Nfa& n, const std::string& w) { return has_accept(n, delta_star(n, {n.start}, w)); }
test_nfacompara esta simulación con una función que busca un camino directamente, siguiendo la definición, en 200 NFA generados al azar con transiciones y ciclos: coinciden en todas las cadenas probadas.
¿Cuánto cuesta simular un NFA así? Si la máquina tiene estados, el conjunto de estados activos tiene a lo sumo elementos. Para cada símbolo de la entrada se recorren los estados activos, a lo sumo , y de cada uno se juntan sus destinos, a lo sumo . Con las clausuras calculadas de antemano, cada símbolo cuesta del orden de operaciones, y la cadena completa . Es más que el paso único de un DFA, pero no es exponencial: aunque haya una cantidad exponencial de caminos, hay a lo sumo estados donde pueden estar.
Idea clave. Para simular un NFA no se siguen los caminos: se sigue el conjunto de estados activos. Se empieza con . Con cada símbolo, se siguen todas las flechas con ese símbolo desde todos los estados activos y se cierra con las transiciones . Se acepta si al final hay algún estado de aceptación activo.
En la práctica. Hay dos familias de programas que buscan patrones en texto. Unos prueban un camino a la vez y retroceden cuando falla, con backtracking: es lo que hacen los motores de expresiones regulares de muchos lenguajes, y con ciertos patrones y ciertas entradas tardan un tiempo exponencial. Otros llevan el conjunto de estados activos, como
run_nfa, y su tiempo crece en proporción a la longitud del texto: es el enfoque degrepy de bibliotecas como RE2. La diferencia entre las dos familias es la diferencia entre la tercera imagen del no determinismo, el árbol, y la segunda. En la semana 3 veremos cómo se pasa de una expresión regular a un NFA, y el laboratorio será ungreppequeño que simula así.
Todo DFA es un NFA
Un DFA es el caso particular de un NFA en el que nunca hay que elegir. Con precisión: si es un DFA, el NFA con
tiene, para cada cadena, un solo camino desde , que es la ejecución de . Luego . En los
archivos ni siquiera hay que convertir nada: todo archivo .dfa es un archivo .nfa válido, en el que cada
línea tiene un solo destino y no falta ninguna.
$ build/run_nfa machines/ends_01.dfa 0101
w = 0101
  {q0} -0-> {q1} -1-> {q2} -0-> {q1} -1-> {q2}
  termina con {q2} activos, y q2 está en F: acepta
El conjunto de estados activos de un DFA tiene siempre un solo estado.
Entonces todo lenguaje regular es reconocido por algún NFA. La pregunta interesante es la contraria. Los NFA parecen más capaces: adivinan, se saltan símbolos, resuelven en 4 estados lo que al DFA le cuesta 8.
¿Hay algún lenguaje que un NFA reconozca y que ningún DFA pueda reconocer?
Piensen qué responderían antes de seguir. La segunda imagen del no determinismo ya contiene la respuesta: lo único que hace falta para simular un NFA es el conjunto de estados activos, y un NFA con estados tiene una cantidad finita de conjuntos de estados.
La construcción de subconjuntos
Miren otra vez la salida de run_nfa. Es una secuencia de conjuntos unidos por flechas con símbolos, un
conjunto después de cada símbolo, y el siguiente depende solo del conjunto actual y del símbolo leído. Eso es la
ejecución de una máquina determinista cuyos estados son conjuntos.
Idea clave. El conjunto de estados activos de un NFA es un solo estado de un DFA. Como un NFA con estados tiene subconjuntos de estados, y es finito, ese DFA existe.
Es la misma jugada que el producto de la semana pasada. Ahí, para correr dos máquinas a la vez, el estado nuevo era un par de estados. Aquí, para correr todas las copias de una máquina a la vez, el estado nuevo es un conjunto de estados.
Un primer ejemplo
El lenguaje Termina en 01 tiene un NFA de tres estados que adivina dónde empieza el final:
$ build/show_nfa machines/ends_01.nfa
Q  = {q0, q1, q2}
Σ  = {0, 1}
q0 = q0
F  = {q2}

     δ   0        1     ε
->   q0  {q0,q1}  {q0}  {}
     q1  {}       {q2}  {}
   * q2  {}       {}    {}

no tiene transiciones ε: E(S) = S para todo conjunto S
Construyamos el DFA a mano. Su estado inicial es el conjunto de estados activos antes de leer nada: . Desde cada conjunto que vaya apareciendo, calculamos a qué conjunto se pasa con cada símbolo, igual que en la tabla de la sección Seguir un NFA: el conjunto de estados activos.
- Desde : con , , un conjunto nuevo. Con , , que ya teníamos.
- Desde : con , . Con , , nuevo.
- Desde : con , . Con , .
No apareció ningún conjunto más: el DFA tiene tres estados. De ellos, el único que contiene a , el estado
de aceptación del NFA, es . El programa subset hace esta cuenta y la muestra como tabla, con una
fila por cada conjunto en el orden en que aparecieron:
$ build/subset machines/ends_01.nfa
E({q0}) = {q0}

     S        0        1
->   {q0}     {q0,q1}  {q0}
     {q0,q1}  {q0,q1}  {q0,q2}
   * {q0,q2}  {q0,q1}  {q0}

el NFA tiene 3 estados: 2^3 = 8 subconjuntos, 3 alcanzables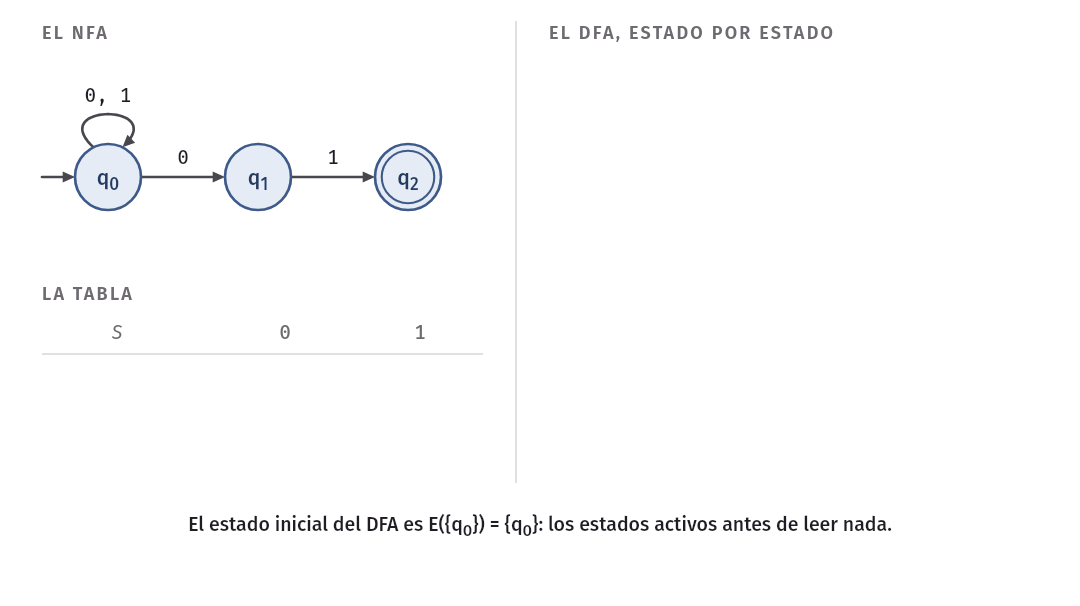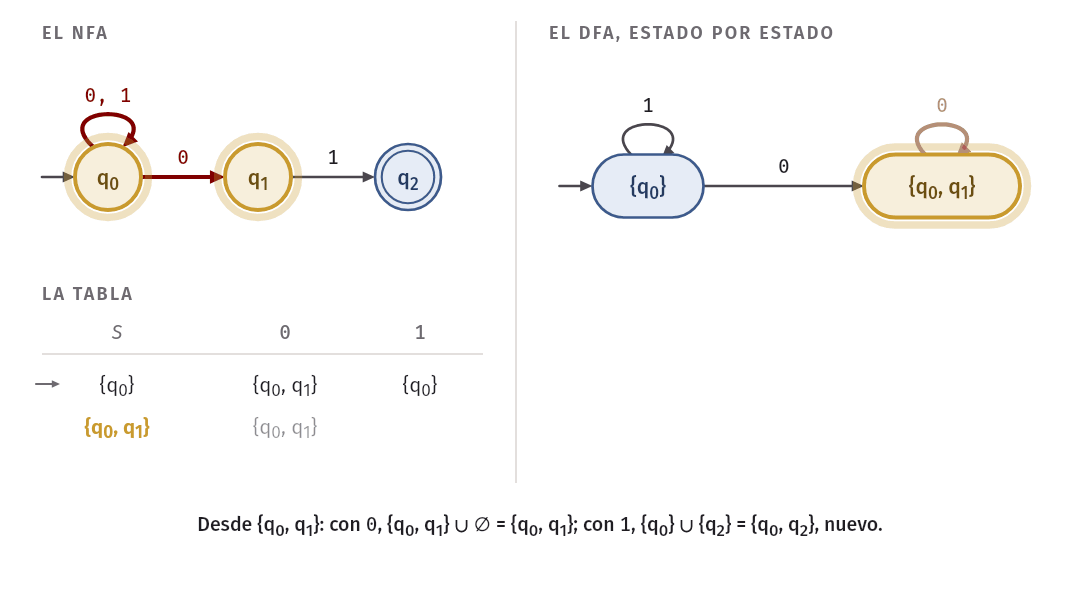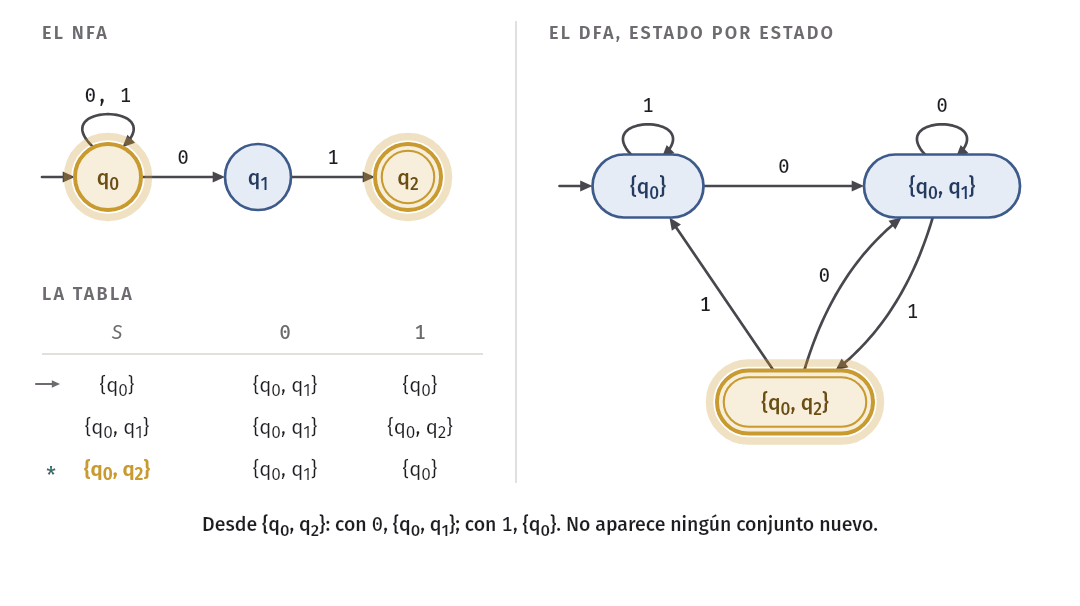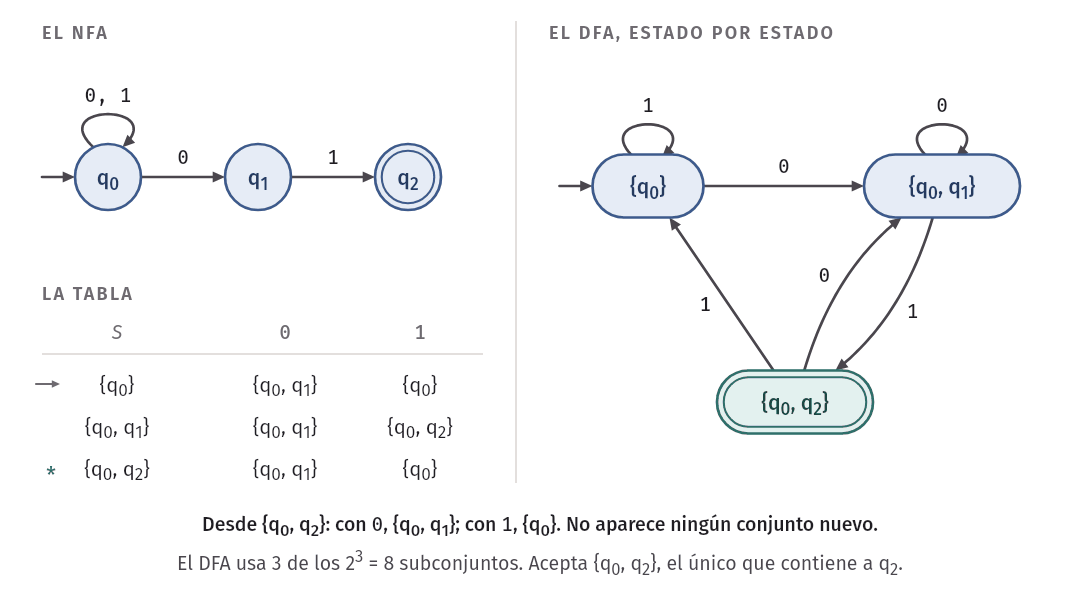
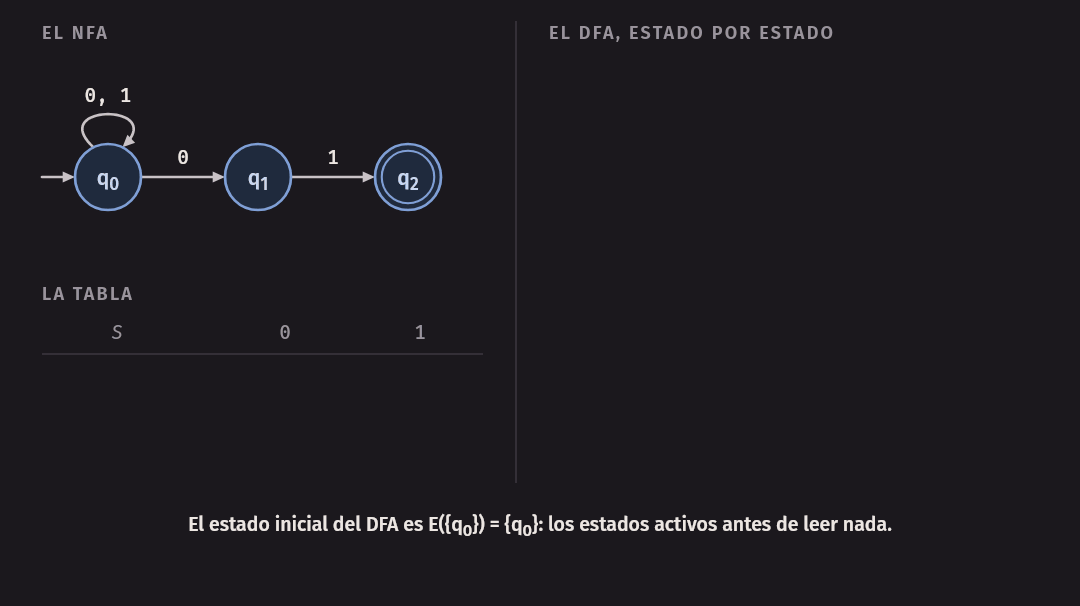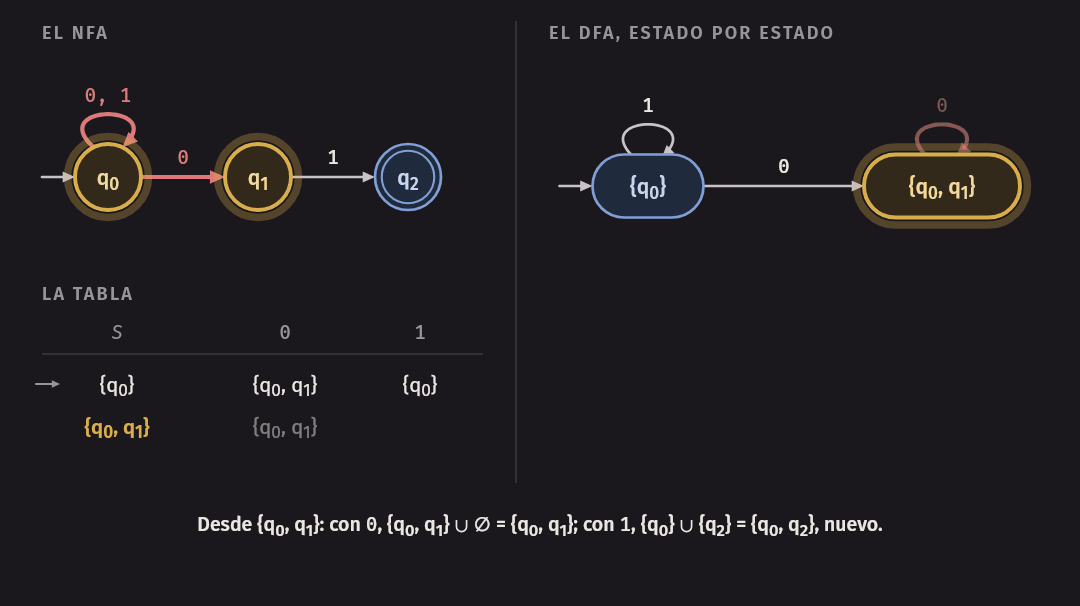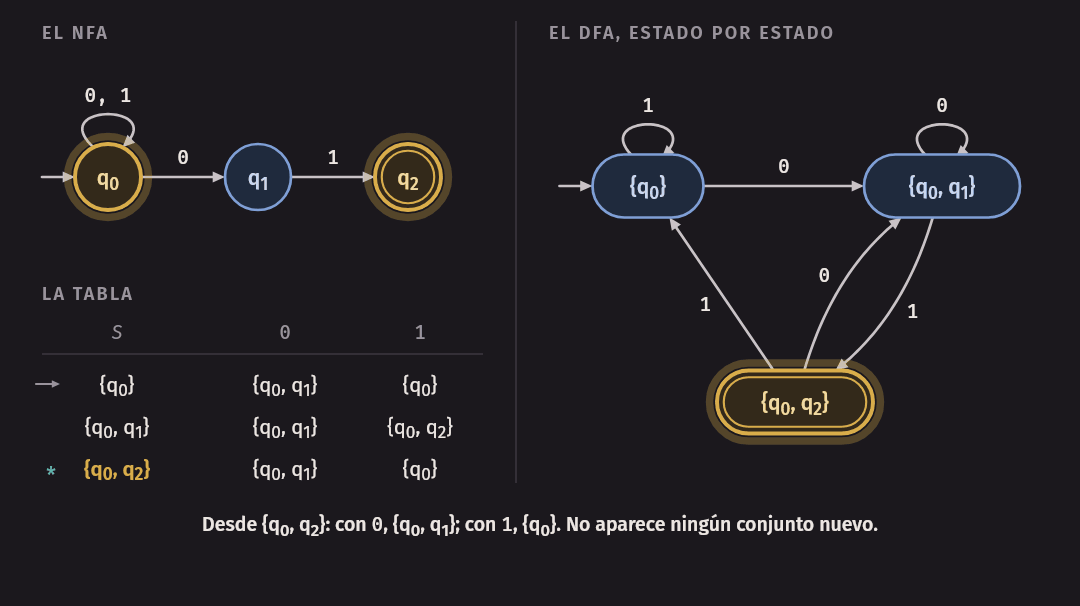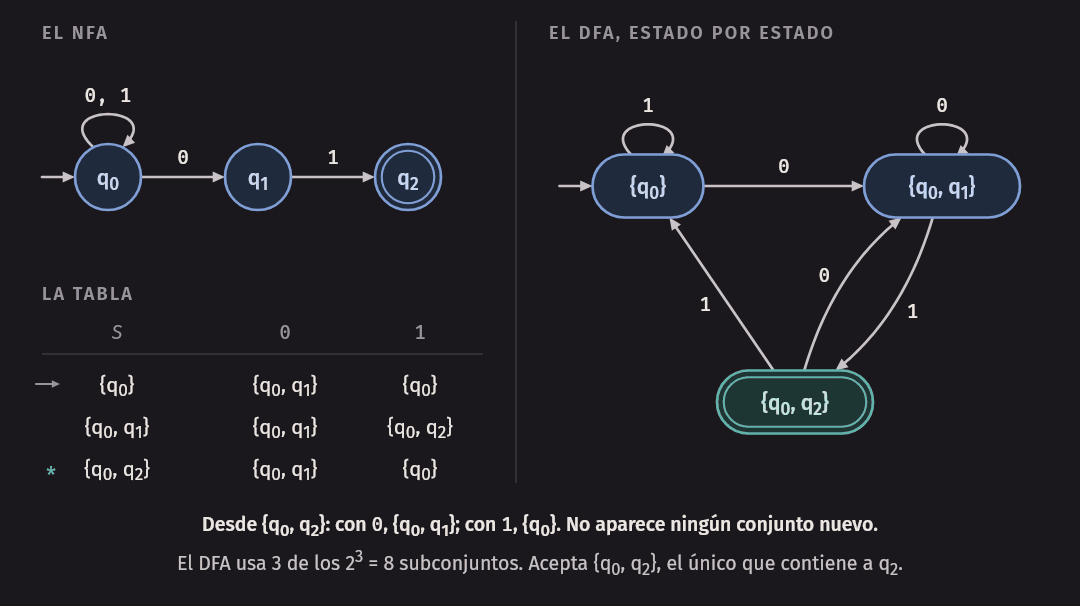
Comparen con el DFA de machines/ends_01.dfa, el que diseñamos la semana pasada pensando qué recordar. Es la
misma máquina, con en el lugar de , en el de y en el de
. La construcción encontró sola el diseño: “termina en ” es “la copia que apostó por ese
sigue viva”.
La construcción
Construcción (de subconjuntos). Sea un NFA. Se define el DFA con:
- : un estado por cada subconjunto de .
- : los estados activos antes de leer nada.
- Para y :
- : los subconjuntos que contienen algún estado de aceptación de .
Es un DFA de verdad. es finito, con elementos. Y está definida para todo subconjunto y todo símbolo, y da un solo subconjunto: es una función total de en . En este DFA no hay transiciones ni elecciones: todo eso quedó absorbido dentro de la definición de .
Cada pieza de la construcción copia una pieza de la simulación con estados activos. El estado inicial es la primera línea de la definición de . La transición es la segunda línea. Y es el corolario del lema: se acepta si algún estado activo es de aceptación.
Error común. Tomar como estados de aceptación del DFA los subconjuntos formados solo por estados de , o exigir que el subconjunto sea igual a . La condición es : basta con que una copia esté en un estado de aceptación, porque el NFA acepta cuando algún camino acepta. En el ejemplo, es de aceptación aunque no lo sea.
El conjunto vacío también es un estado de , y tiene un papel conocido. Como no tiene elementos, para todo símbolo: de no se sale. Y : no es de aceptación. Es el estado trampa. En un NFA los caminos que mueren no necesitan un estado; en el DFA, “ya murieron todos” es el estado .
Solo los subconjuntos alcanzables
La definición usa los subconjuntos, pero la mayoría no aparece nunca. En el primer ejemplo había 8 y se usaron 3. La semana pasada vimos que los estados inalcanzables de un DFA se pueden borrar sin cambiar su lenguaje, porque ninguna ejecución pasa por ellos. Entonces conviene no generarlos: se parte del estado inicial y se agregan solo los subconjuntos que van apareciendo, como hicimos a mano.
algoritmo subconjuntos(N)
    inicial ← E({q0})
    estados ← {inicial}
    cola ← [inicial]
    mientras cola no esté vacía
        S ← sacar el primero de cola
        para cada símbolo a de Σ
            T ← E(unión de δ(q, a) para cada q en S)
            δD(S, a) ← T
            si T no está en estados entonces
                agregar T a estados
                poner T al final de cola
            fin si
        fin para
    fin mientras
    FD ← los S de estados que contienen algún estado de F
    devolver (estados, Σ, δD, inicial, FD)
fin algoritmo
Es un recorrido en anchura de un grafo que no está escrito en ninguna parte: sus vértices son los subconjuntos, y los vecinos de cada uno se calculan cuando se lo visita. Termina porque cada subconjunto entra en la cola a lo sumo una vez y hay una cantidad finita de ellos.
Con el autómata de la sesión A, el tercer símbolo desde el final es 1:
$ build/subset machines/third_from_end.nfa
E({q0}) = {q0}

     S              0              1
->   {q0}           {q0}           {q0,q1}
     {q0,q1}        {q0,q2}        {q0,q1,q2}
     {q0,q2}        {q0,q3}        {q0,q1,q3}
     {q0,q1,q2}     {q0,q2,q3}     {q0,q1,q2,q3}
   * {q0,q3}        {q0}           {q0,q1}
   * {q0,q1,q3}     {q0,q2}        {q0,q1,q2}
   * {q0,q2,q3}     {q0,q3}        {q0,q1,q3}
   * {q0,q1,q2,q3}  {q0,q2,q3}     {q0,q1,q2,q3}

el NFA tiene 4 estados: 2^4 = 16 subconjuntos, 8 alcanzables
Salieron 8 estados: los que anunciamos al principio del capítulo para el DFA que recuerda los tres últimos símbolos. Y son eso mismo. Todos los subconjuntos alcanzables contienen a , porque la copia que nunca apuesta sigue siempre viva. Los otros tres estados dicen cuáles de los tres últimos símbolos fueron : está activo si el último símbolo fue , si lo fue el penúltimo, y si lo fue el antepenúltimo. El subconjunto es “los tres últimos símbolos fueron ”. Los cuatro estados de aceptación son los que tienen a .
Una lectura de la fila de con , para fijar la cuenta: y , y la unión es . No hay transiciones , así que la clausura no agrega nada.
El programa nfa_to_dfa escribe el resultado como archivo .dfa, con el conjunto como nombre del estado, y lo
puede seguir el run_dfa de la semana pasada:
$ build/nfa_to_dfa machines/third_from_end.nfa | build/run_dfa - 0110 100
w = 0110
  {q0} -0-> {q0} -1-> {q0,q1} -1-> {q0,q1,q2} -0-> {q0,q2,q3}
  termina en {q0,q2,q3}, que está en F: acepta
w = 100
  {q0} -1-> {q0,q1} -0-> {q0,q2} -0-> {q0,q3}
  termina en {q0,q3}, que está en F: acepta
La ejecución del DFA con es, conjunto por conjunto, lo que imprime
build/run_nfa machines/third_from_end.nfa 0110. La diferencia está en quién hace el trabajo. run_nfa calcula
cada conjunto mientras lee la cadena. El DFA los tiene calculados de antemano: mientras lee, solo busca una
casilla en su tabla.
Con transiciones ε
Con transiciones el algoritmo es el mismo. La clausura aparece en dos lugares: en el estado inicial y al final de cada transición.
$ build/subset machines/contains_101_or_11.nfa
E({q0}) = {q0}

     S              0              1
->   {q0}           {q0}           {q0,q1,q2}
     {q0,q1,q2}     {q0,q2}        {q0,q1,q2,q3}
     {q0,q2}        {q0}           {q0,q1,q2,q3}
   * {q0,q1,q2,q3}  {q0,q2,q3}     {q0,q1,q2,q3}
   * {q0,q2,q3}     {q0,q3}        {q0,q1,q2,q3}
   * {q0,q3}        {q0,q3}        {q0,q1,q2,q3}

el NFA tiene 4 estados: 2^4 = 16 subconjuntos, 6 alcanzables
Desde con , las flechas llevan a y la clausura agrega : el subconjunto , sin , no aparece nunca en este DFA. Las tres últimas filas son de aceptación y desde ellas solo se llega a ellas: una vez visto el patrón, se acepta termine como termine. Un diseñador las habría juntado en un solo estado “ya ganó”. La construcción no minimiza: da un DFA correcto, y no siempre el más pequeño. De eso se ocupa la semana 4.
En el autómata de los bloques, la clausura actúa ya en el estado inicial, y aparece el conjunto vacío:
$ build/subset machines/abc_blocks.nfa
E({qa}) = {qa,qb,qc}

     S           a           b           c
-> * {qa,qb,qc}  {qa,qb,qc}  {qb,qc}     {qc}
   * {qb,qc}     {}          {qb,qc}     {qc}
   * {qc}        {}          {}          {qc}
     {}          {}          {}          {}

el NFA tiene 3 estados: 2^3 = 8 subconjuntos, 4 alcanzables
El estado inicial del DFA es y es de aceptación, porque contiene a : así queda aceptada la cadena vacía. La última fila es el estado trampa , al que se cae con la primera letra fuera de orden.
Error común. Olvidar la clausura del estado inicial y empezar en . En el autómata de los bloques, el DFA empezaría en , que no es de aceptación, y rechazaría la cadena vacía y también : desde , las flechas con no llevan a ningún lado. Es el error más frecuente en el laboratorio de esta semana.
En C++. La función
subset_constructiondenfa.hes el pseudocódigo, constd::set<StateSet>para saber si un subconjunto ya apareció ystd::queue<StateSet>para los pendientes. El nombre de cada estado del DFA es el conjunto escrito sin espacios,{q0,q1}, para que quepa en un archivo.dfa.while (!pending.empty()) { StateSet s = pending.front(); pending.pop(); std::string name = set_name(n, s); if (has_accept(n, s)) { d.accept.insert(name); } for (char a : n.alphabet) { StateSet t = step(n, s, a); d.delta[{name, a}] = set_name(n, t); if (seen.insert(t).second) { found.push_back(t); d.states.push_back(set_name(n, t)); pending.push(t); } } }Un conjunto de nombres se lee bien y es lento. En el laboratorio conviene numerar los estados del NFA y guardar cada subconjunto como un entero, con un bit por estado.
Por qué funciona: la equivalencia
Teorema. Para todo NFA hay un DFA con .
Demostración. Por construcción.
Qué se construye: el DFA de la construcción de subconjuntos.
Por qué reconoce : hay que ver que acepta una cadena si y solo si la acepta. El argumento tiene dos lemas. El primero dice que la función sobre conjuntos calcula lo que la definición por caminos pide. El segundo, que hace con sus estados lo mismo que con sus conjuntos. Los dos son por inducción sobre la longitud de la cadena.
Lema (de los estados activos). Para todo y toda cadena :
Demostración. Por inducción sobre , con fijo.
Caso base: . Por definición, , y es el conjunto de los estados a los que llega un camino con etiqueta desde algún estado de . Es lo que afirma el lema.
Paso inductivo: , y suponemos el lema para . Llamemos , de modo que . Hay que demostrar dos inclusiones.
Todo estado de tiene un camino. Sea . Por la definición de , hay un estado en y un camino con etiqueta de a . Que esté en la unión quiere decir que para algún . Por la hipótesis de inducción, como , hay un camino con etiqueta desde algún hasta . Pegando las tres partes, el camino de a , el paso de a con , y el camino de a , se obtiene un camino de a cuya etiqueta es .
Todo estado con un camino está en . Supongamos que hay un camino con etiqueta desde algún hasta , con estados y etiquetas . La concatenación de las etiquetas es , que termina en el símbolo . Sea la posición de la última etiqueta que no es . Entonces ; las etiquetas anteriores forman , es decir, ; y las posteriores, , son todas . El camino se parte en tres:
- De a , con etiqueta . Por la hipótesis de inducción, .
- El paso de a con : , así que está en .
- De a , con etiqueta : está en la clausura de cualquier conjunto que contenga a .
Luego . ∎
Lema (de la construcción). Para toda cadena : .
A la izquierda está la función extendida del DFA , la de la semana pasada, que devuelve un estado de . A la derecha, la función extendida del NFA sobre conjuntos. El lema dice que el estado en el que queda después de leer es el conjunto de estados activos de después de leer .
Demostración. Por inducción sobre .
Caso base: . Por la definición de la función extendida de un DFA, , y por construcción. Por la definición de la función extendida del NFA, . Coinciden.
Paso inductivo: , y suponemos el lema para .
∎
Con los dos lemas, el teorema es una cadena de equivalencias. Para toda cadena :
Cada línea es un “si y solo si”, así que valen las dos direcciones: . ∎
El lema de la construcción es casi inmediato, porque se definió copiando la segunda línea de . El trabajo de verdad está en el lema de los estados activos, que es donde se pasa de “existe un camino” a un cálculo con conjuntos. El DFA con solo los estados alcanzables, que es el que construyen los programas, reconoce el mismo lenguaje que : se le quitaron estados por los que no pasa ninguna ejecución.
Corolario. Un lenguaje es regular si y solo si algún NFA lo reconoce.
Demostración. Si es regular, lo reconoce un DFA, y todo DFA es un NFA. Si a lo reconoce un NFA, por el teorema lo reconoce un DFA, y entonces es regular por definición. ∎
Esta es la respuesta a la pregunta de la sesión A: no, los NFA no reconocen nada más. Y el corolario cambia la manera de trabajar. Desde ahora, para demostrar que un lenguaje es regular basta dar un NFA, que casi siempre es más fácil de diseñar y de justificar. El resto del capítulo lo aprovecha.
test_subset comprueba los dos lemas con programas. Para cada autómata del capítulo y para 200 NFA al azar,
recorre todas las cadenas hasta cierta longitud y verifica que el estado en el que queda el DFA es el nombre
del conjunto de estados activos del NFA, y que los dos aceptan lo mismo.
En la práctica. Los generadores de analizadores léxicos, como
lexyflex, reciben las expresiones regulares de los tokens de un lenguaje, arman un NFA y lo convierten en un DFA con esta construcción antes de compilar: el analizador que resulta solo sigue una tabla. Las herramientas de búsqueda, que reciben un patrón distinto cada vez, suelen construir el DFA mientras leen: calculan un subconjunto la primera vez que lo necesitan y lo guardan por si vuelve a aparecer. Así solo pagan por los subconjuntos que el texto hace aparecer.
El costo: hasta 2ⁿ estados
La construcción de subconjuntos convierte un NFA de estados en un DFA de a lo sumo . En los ejemplos salieron muchos menos: 3 de 8, 8 de 16, 6 de 16, 4 de 8. ¿Es el una exageración de la definición, o hay lenguajes en los que de verdad hace falta?
Generalicemos el primer ejemplo. Para cada , sea
El NFA es el de siempre con una cadena más larga: espera y apuesta en algún , y de a
se avanza con cualquier símbolo. Tiene estados. El programa kth_nfa lo escribe para cualquier
, y kth_table le aplica la construcción de subconjuntos para de 1 a 12 y cuenta:
$ build/kth_table
 k   estados del NFA   subconjuntos posibles   estados del DFA (alcanzables)
 1                 2                       4                               2
 2                 3                       8                               4
 3                 4                      16                               8
 4                 5                      32                              16
 5                 6                      64                              32
 6                 7                     128                              64
 7                 8                     256                             128
 8                 9                     512                             256
 9                10                    1024                             512
10                11                    2048                            1024
11                12                    4096                            2048
12                13                    8192                            4096
El NFA crece de uno en uno y el DFA se duplica cada vez: estados. Se alcanzan la mitad de los subconjuntos posibles, y se entiende por qué con lo que vimos para . Todo subconjunto alcanzable contiene a . Y está activo exactamente cuando el -ésimo símbolo desde el final de lo leído es , así que la parte del subconjunto que está en es una foto de los últimos símbolos. Hay fotos posibles y todas aparecen.
Eso explica por qué esta construcción da estados. Queda la pregunta de si otro diseño, más astuto, podría hacerlo con menos. La respuesta es que no: todo DFA que reconoce tiene al menos estados.
La intuición es la del principio del capítulo. Un DFA no sabe cuándo se va a acabar la cadena, así que tiene que recordar los últimos símbolos completos: cualquiera de ellos puede terminar siendo el -ésimo desde el final. Si tuviera menos de estados, habría dos cadenas distintas de longitud , digamos e , que lo dejan en el mismo estado, igual que en el argumento de la semana pasada sobre . Como e son distintas, difieren en alguna posición, y agregando símbolos al final se puede hacer que justo esa posición sea la -ésima desde el final. Con la continuación agregada, una de las dos cadenas está en y la otra no, pero la máquina, que estaba en el mismo estado, termina en el mismo estado con las dos. No puede responder bien en ambas.
Esto es la idea, sin los detalles. La demostración completa necesita decir con precisión qué significa que dos cadenas “tengan que” llevar a estados distintos, y esa es la herramienta de la semana 4, el teorema de Myhill-Nerode: ahí se demuestra la cota de y se ve que el DFA de la tabla es el más pequeño posible.
Idea clave. Quitar el no determinismo no cuesta poder de cómputo, pero puede costar tamaño: hay lenguajes con un NFA de estados cuyo DFA más pequeño tiene . El NFA es la descripción corta. El DFA es la que se ejecuta rápido.
Hay entonces dos maneras de usar un NFA en un programa, y ninguna es siempre la mejor.
| Simular el NFA | Convertir a DFA y simular | |
|---|---|---|
| Trabajo antes de leer | Ninguno | Hasta estados que construir |
| Trabajo por símbolo | Del orden de | Una búsqueda en la tabla |
| Memoria | El NFA y un conjunto | La tabla completa del DFA |
Si el patrón se usa una vez sobre un texto corto, conviene simular. Si se usa millones de veces, como el analizador léxico de un compilador, conviene pagar la conversión una sola vez.
Cierre bajo unión
La semana pasada demostramos con el producto que los lenguajes regulares son cerrados bajo unión. Con NFA hay otra demostración, más simple, que además sirve de modelo para las dos operaciones que faltan. La idea es que la máquina adivine cuál de los dos autómatas va a aceptar, y corra ese.
Teorema. Si y son lenguajes regulares sobre , entonces es regular.
Demostración. Por construcción. Sean y dos NFA con y . Existen porque todo lenguaje regular tiene un DFA, y un DFA es un NFA. Suponemos que y no tienen estados en común: si los tienen, se les cambia el nombre.
Qué se construye: el NFA , donde es un estado nuevo, que no está en ni en , y:
- .
- El estado inicial es .
- .
- y para todo símbolo . En los demás estados no cambia nada: si y si .
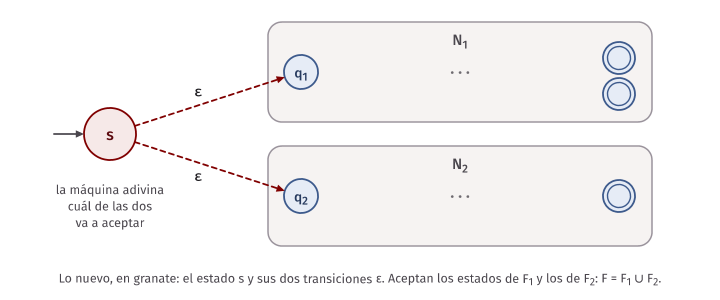
Por qué reconoce : en las dos direcciones.
Si , digamos , entonces hay un camino en de a un estado de con etiqueta . Todas sus flechas están también en . Poniéndole delante el paso de a con , queda un camino en de a un estado de con etiqueta . Luego acepta . Si , lo mismo con .
Si acepta , hay un camino en de a un estado de con etiqueta . Como , el camino tiene al menos un paso, y el primero sale de : solo puede ser una de las dos transiciones . Digamos que va a . Desde un estado de , las flechas de son las de y llevan a estados de : el resto del camino no sale de . Entonces el resto es un camino en de a un estado de , con etiqueta , y . Si el primer paso va a , sale . En los dos casos, . ∎
El programa combine aplica la construcción a dos archivos. Con los dos DFA de la semana pasada, cantidad par
de unos y termina en :
$ build/combine union machines/even_ones.dfa machines/ends_01.dfa
# Unión de machines/even_ones.dfa y machines/ends_01.dfa.
states: s 1.par 1.impar 2.q0 2.q1 2.q2
alphabet: 0 1
start: s
accept: 1.par 2.q2
delta:
s eps 1.par 2.q0
1.par 0 1.par
1.par 1 1.impar
1.impar 0 1.impar
1.impar 1 1.par
2.q0 0 2.q1
2.q0 1 2.q0
2.q1 0 2.q1
2.q1 1 2.q2
2.q2 0 2.q1
2.q2 1 2.q0
Para que los nombres no choquen, el programa antepone 1. a los estados de la primera máquina y 2. a los de
la segunda. Salvo la línea de s, el archivo es la copia de los dos originales.
$ build/combine union machines/even_ones.dfa machines/ends_01.dfa | build/run_nfa - 1101 111
w = 1101
  {s,1.par,2.q0} -1-> {1.impar,2.q0} -1-> {1.par,2.q0} -0-> {1.par,2.q1} -1-> {1.impar,2.q2}
  termina con {1.impar,2.q2} activos, y 2.q2 está en F: acepta
w = 111
  {s,1.par,2.q0} -1-> {1.impar,2.q0} -1-> {1.par,2.q0} -1-> {1.impar,2.q0}
  termina con {1.impar,2.q0} activos, y ninguno está en F: rechaza
Después del primer símbolo, cada conjunto de estados activos tiene un estado de cada máquina. Es el par
del producto de la semana pasada, con otra ropa: comparen con la tabla de la ejecución de
en aquel capítulo. Si a este NFA se le aplica la construcción de subconjuntos, salen 7 estados:
los 6 pares del producto y el inicial , que solo se usa antes de leer
nada. test_closure comprueba que este NFA y el producto de la semana pasada aceptan las mismas cadenas.
La comparación de tamaños es la del resto del capítulo. La unión con NFA suma: estados. El producto multiplica: .
Cierre bajo concatenación
Recuerden la definición: . Para decidir si está en hay que encontrar un corte de en dos partes, la primera en y la segunda en . La dificultad es que puede haber muchos cortes posibles y solo algunos sirven. Un NFA resuelve esto como resuelve todo: adivina dónde está el corte.
Teorema. Si y son lenguajes regulares sobre , entonces es regular.
Demostración. Por construcción. Sean y como en el teorema anterior, con y sin estados en común.
Qué se construye: el NFA . Empieza en el estado inicial de y sus estados de aceptación son solo los de . La función es la de las dos máquinas, con una transición agregada desde cada estado de aceptación de hacia el inicial de :
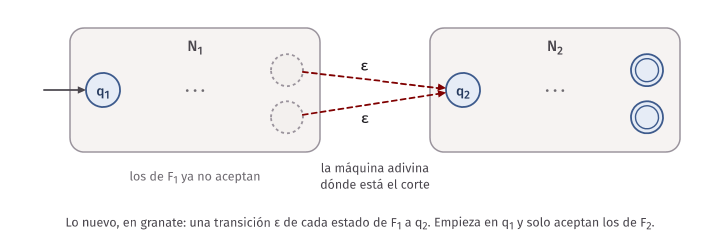
Los estados de dejan de ser de aceptación: llegar al final de un trozo de ya no basta.
Por qué reconoce : en las dos direcciones.
Si , entonces con y . Hay un camino en de a algún con etiqueta , y un camino en de a algún estado de con etiqueta . Uniéndolos con el paso de a con , queda un camino en de a un estado de con etiqueta . Luego acepta .
Si acepta , hay un camino en de a un estado de con etiqueta . Empieza en y termina en . Las únicas flechas de que van de a son las transiciones agregadas, y no hay ninguna flecha de a . Entonces el camino cruza exactamente una vez, con un paso de algún a . Antes del cruce, el camino está dentro de y va de a : si es su etiqueta, . Después del cruce, está dentro de y va de a un estado de : si es su etiqueta, . Y . Luego . ∎
Con Termina en 01 como primera máquina y cantidad par de unos como segunda:
$ build/combine concat machines/ends_01.dfa machines/even_ones.dfa
# Concatenación de machines/ends_01.dfa y machines/even_ones.dfa.
states: 1.q0 1.q1 1.q2 2.par 2.impar
alphabet: 0 1
start: 1.q0
accept: 2.par
delta:
1.q0 0 1.q1
1.q0 1 1.q0
1.q1 0 1.q1
1.q1 1 1.q2
1.q2 0 1.q1
1.q2 1 1.q0
1.q2 eps 2.par
2.par 0 2.par
2.par 1 2.impar
2.impar 0 2.impar
2.impar 1 2.par
La única línea nueva es 1.q2 eps 2.par.
$ build/combine concat machines/ends_01.dfa machines/even_ones.dfa | build/run_nfa - 0111 011
w = 0111
  {1.q0} -0-> {1.q1} -1-> {1.q2,2.par} -1-> {1.q0,2.impar} -1-> {1.q0,2.par}
  termina con {1.q0,2.par} activos, y 2.par está en F: acepta
w = 011
  {1.q0} -0-> {1.q1} -1-> {1.q2,2.par} -1-> {1.q0,2.impar}
  termina con {1.q0,2.impar} activos, y ninguno está en F: rechaza
Después de leer , la primera máquina está en su estado de aceptación y la clausura
activa a 2.par: una copia apuesta a que el corte está ahí, y otra sigue en la primera máquina
por si el corte está más adelante. se acepta con el corte .
no: el único corte con la primera parte terminada en deja , que tiene
una cantidad impar de unos.
Error común. En la concatenación, dejar los estados de como estados de aceptación. Con eso se aceptarían cadenas de que no tienen ninguna continuación en . Solo son de aceptación los de . Si , las cadenas de quedan aceptadas de todos modos, de la manera correcta: por la transición se llega a , que en ese caso está en o alcanza a sin leer nada.
test_closure compara esta construcción con el predicado directo, “existe un corte con y
”, probando todos los cortes de cada cadena.
Cierre bajo estrella
Una cadena está en si se puede partir en cero o más trozos, cada uno de . Es la concatenación repetida, y la construcción repite la idea: al terminar un trozo, una transición permite volver al principio para empezar otro.
Teorema. Si es un lenguaje regular, entonces es regular.
Demostración. Por construcción. Sea un NFA con .
Qué se construye: el NFA , donde es un estado nuevo, y:
Son tres cambios: un estado inicial nuevo , que es de aceptación; una transición de al inicial anterior; y una transición de cada estado de aceptación al inicial anterior.
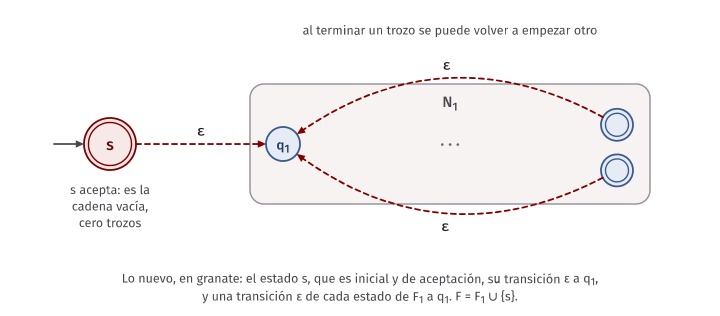
Por qué reconoce : en las dos direcciones.
Si , entonces con y cada . Si , , y la acepta con el camino de cero pasos, porque . Si , para cada hay un camino en de a algún con etiqueta . Se arma un camino en : el paso de a con ; el camino de hasta ; el paso de a con ; el camino de ; y así hasta llegar a . Su etiqueta es y termina en .
Si acepta , hay un camino en de a un estado de con etiqueta . Si tiene cero pasos, . Si tiene alguno, el primero es el paso de a con , porque de no sale otra flecha. Ninguna flecha entra a , así que el camino no vuelve a pasar por él: de ahí en adelante está en y termina en un estado de . Cortemos ese resto en cada paso que no es una flecha de . Esos pasos solo pueden ser las transiciones agregadas, que van de un estado de a con . Cada trozo que queda entre dos cortes empieza en , usa solo flechas de y termina en un estado de : el anterior al corte siguiente o, en el último trozo, el final del camino. Entonces la etiqueta de cada trozo, , está en . Los cortes tienen etiqueta , así que , con cada : . ∎
Con machines/zeros_then_one.nfa, que reconoce las cadenas formadas por algunos ceros y después un solo
: , , …
$ build/show_nfa machines/zeros_then_one.nfa
Q  = {q0, q1}
Σ  = {0, 1}
q0 = q0
F  = {q1}

     δ   0     1     ε
->   q0  {q0}  {q1}  {}
   * q1  {}    {}    {}

no tiene transiciones ε: E(S) = S para todo conjunto S
$ build/combine star machines/zeros_then_one.nfa
# Estrella de machines/zeros_then_one.nfa.
states: s q0 q1
alphabet: 0 1
start: s
accept: s q1
delta:
s eps q0
q0 0 q0
q0 1 q1
q1 eps q0Si es el lenguaje de la máquina original, son las cadenas que se parten en trozos de la forma “ceros y un ”: la cadena vacía y todas las que terminan en .
$ build/combine star machines/zeros_then_one.nfa | build/run_nfa - '' 0101 0
w = ε
  {s,q0}
  termina con {s,q0} activos, y s está en F: acepta
w = 0101
  {s,q0} -0-> {q0} -1-> {q0,q1} -0-> {q0} -1-> {q0,q1}
  termina con {q0,q1} activos, y q1 está en F: acepta
w = 0
  {s,q0} -0-> {q0}
  termina con {q0} activos, y ninguno está en F: rechaza
La cadena vacía se acepta porque está activo antes de leer nada y es de aceptación. Eso pasa con cualquier : siempre, y en la construcción el camino de cero pasos siempre acepta. La cadena se rechaza, como debe: no termina en . Después del primer símbolo, ya no vuelve a estar activo.
Por qué hace falta un estado inicial nuevo
El estado existe para una sola cosa: aceptar . Parece más barato ahorrárselo.
Un intento que parece funcionar. No agregar . Marcar el estado inicial como de aceptación, para que se acepte , y agregar las transiciones de los estados de aceptación a .
Dónde falla. Si alguna flecha de vuelve a , hay cadenas que regresan al estado inicial a
mitad de un trozo, sin haber completado ninguno. Al marcar como de aceptación, esas cadenas quedan
aceptadas. En zeros_then_one.nfa, el estado inicial tiene una flecha hacia sí mismo con . La
cadena deja a la máquina en , que ahora sería de aceptación. Pero .
El programa wrong_star aplica las dos construcciones, la correcta y la del intento, y lista las cadenas en las
que no coinciden:
$ build/wrong_star machines/zeros_then_one.nfa 3
cadena   con estado inicial nuevo   sin estado inicial nuevo
0        rechaza                    acepta
00       rechaza                    acepta
10       rechaza                    acepta
000      rechaza                    acepta
010      rechaza                    acepta
100      rechaza                    acepta
110      rechaza                    acepta
7 cadenas de longitud a lo sumo 3 en las que no coinciden
Son todas las cadenas no vacías que terminan en : con el intento, la máquina acepta todo . El problema no es aceptar , sino que “estar en ” pasó a significar dos cosas a la vez: “todavía no empecé o acabo de terminar un trozo” y “estoy a mitad de un trozo que volvió a pasar por el principio”. El estado nuevo separa los dos significados: es de aceptación y sigue sin serlo.
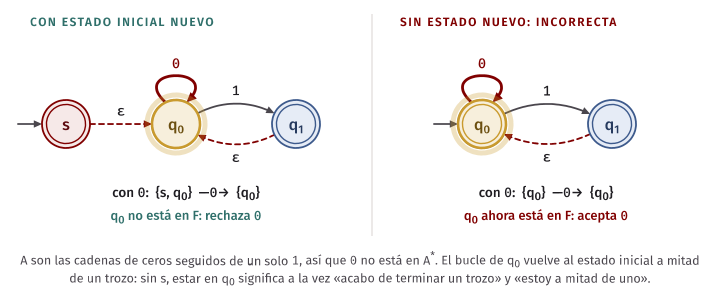
Error común. Construir la estrella marcando el estado inicial como de aceptación en lugar de agregar uno nuevo. Solo es correcto cuando ninguna flecha entra al estado inicial, y es más fácil agregar el estado siempre que revisar esa condición.
Cierre bajo reverso
El reverso de un lenguaje es : las cadenas de leídas de derecha a izquierda. Si es termina en 01, es empieza con 10.
La idea de la construcción es recorrer la máquina hacia atrás: empezar donde terminaba, seguir las flechas en sentido contrario y aceptar al llegar adonde empezaba. Con un DFA eso tropieza enseguida. Al invertir las flechas, de un estado pueden salir varias con el mismo símbolo, o ninguna, y si había varios estados de aceptación habría varios estados iniciales. Todo eso es justo lo que un NFA permite.
Construcción. Sea un NFA con . Se define , con un estado nuevo, y:
- Las flechas, al revés: para y toda etiqueta , si y solo si .
- El inicio: . Desde el estado nuevo se salta, sin leer nada, a cualquiera de los estados que eran de aceptación.
- El final: el único estado de aceptación es , el que era inicial.
Por qué reconoce . La clave es una sola observación: una secuencia de estados con etiquetas es un camino en si y solo si la secuencia invertida, con etiquetas , es un camino por las flechas invertidas de . Y si las etiquetas del primero forman , las del segundo forman . Entonces hay un camino en de a algún con etiqueta exactamente cuando hay un camino en de a con etiqueta , y a ese se le antepone el paso de a . Los detalles, en particular por qué un camino que acepta en no pasa dos veces por , quedan como ejercicio.
$ build/combine reverse machines/ends_01.dfa
# Reverso de machines/ends_01.dfa.
states: s q0 q1 q2
alphabet: 0 1
start: s
accept: q0
delta:
s eps q2
q0 1 q0 q2
q1 0 q0 q1 q2
q2 1 q1
El DFA original tenía tres flechas con que llegaban a , desde , y . Invertidas,
son tres flechas con que salen de : la línea q1 0 q0 q1 q2. Y de ya no sale nada
con . El reverso de un DFA no es un DFA.
$ build/combine reverse machines/ends_01.dfa | build/run_nfa - 100 010
w = 100
  {s,q2} -1-> {q1} -0-> {q0,q1,q2} -0-> {q0,q1,q2}
  termina con {q0,q1,q2} activos, y q0 está en F: acepta
w = 010
  {s,q2} -0-> {} -1-> {} -0-> {}
termina con {} activos, y ninguno está en F: rechaza empieza con : su reverso, , termina en . test_closure
comprueba, con este autómata, con el del tercer símbolo desde el final y con 100 NFA al azar, que el autómata
invertido acepta exactamente cuando el original acepta .
El reverso explica algo del primer ejemplo del capítulo. El reverso de , el tercer símbolo desde el final es 1, es el tercer símbolo es 1, que tiene un DFA de 5 estados: cuenta tres símbolos, mira el tercero y pasa a un estado “sí” o a un estado “no” de los que no sale. Leer de izquierda a derecha un lenguaje que se define desde el final es lo que le cuesta al DFA. Invertir un DFA pequeño puede dar un lenguaje cuyo DFA más pequeño es exponencialmente mayor.
El complemento no se hace en el NFA
Con unión, concatenación, estrella y reverso, parece que cualquier operación sale más fácil con un NFA. Hay una que no. La semana pasada, el complemento fue la construcción más corta: cambiar por .
Un intento que parece funcionar. Hacer lo mismo con un NFA: dejar la máquina igual e intercambiar los estados de aceptación.
Dónde falla. El programa swap_accept lo prueba con el autómata del tercer símbolo desde el final, cuyo
único estado de aceptación es :
$ build/swap_accept machines/third_from_end.nfa 100 000
F = {q3}    Q − F = {q0,q1,q2}
w = 100
  activos al final: {q0,q3}
  el NFA:                        acepta
  el NFA con Q − F:              acepta
  el DFA de subconjuntos, Q − F: rechaza
w = 000
  activos al final: {q0}
  el NFA:                        rechaza
  el NFA con Q − F:              acepta
  el DFA de subconjuntos, Q − F: acepta
La cadena está en , así que no debería estar en el complemento. Pero el NFA con los estados intercambiados también la acepta. Después de leerla hay dos estados activos, y . Antes del intercambio se aceptaba por . Después del intercambio se acepta por . De hecho está activo siempre, así que el NFA intercambiado acepta todas las cadenas: reconoce , que no es el complemento de .
La razón está en la definición de aceptar, y es una cuestión de lógica. acepta si algún camino termina en . Entonces está en el complemento si ningún camino termina en , es decir, si todos los caminos que leen terminan fuera de o mueren. Intercambiar los estados de aceptación da otra cosa: un NFA que acepta si algún camino termina fuera de . Negar “existe” da “para todo”, y un NFA solo sabe decir “existe”.
En un DFA el problema no aparece porque hay un solo camino: “alguno” y “todos” son lo mismo. La demostración de la semana pasada usó exactamente eso, que existe y es un solo estado.
Error común. Complementar un NFA intercambiando sus estados de aceptación. La manera correcta tiene dos pasos: primero la construcción de subconjuntos, y después el intercambio en el DFA. Es la última línea de cada bloque en la salida de
swap_accept. En el DFA, el estado es de aceptación porque contiene a ; al intercambiar deja de serlo, y se rechaza.
El costo es el de la construcción de subconjuntos: el complemento de un lenguaje con un NFA de estados puede necesitar un DFA de hasta . Los lenguajes regulares son cerrados bajo complemento, y lo demostramos la semana pasada. Lo que no hay es una construcción barata sobre NFA. La intersección tampoco necesita pasar por un DFA: el producto funciona con dos NFA, y queda como ejercicio.
Con esto, la lista de propiedades de cierre de los lenguajes regulares queda así:
| Operación | Construcción | Estados |
|---|---|---|
| Unión | Producto de dos DFA, o NFA con un estado inicial nuevo | , o |
| Intersección | Producto | |
| Complemento | Intercambiar en un DFA | |
| Concatenación | NFA con transiciones de a | |
| Estrella | NFA con un estado inicial nuevo | |
| Reverso | NFA con las flechas invertidas |
La unión, la concatenación y la estrella se llaman operaciones regulares. La semana próxima veremos que con ellas tres, partiendo de los lenguajes más simples posibles, se obtienen todos los lenguajes regulares: eso son las expresiones regulares. Las tres construcciones de este capítulo serán entonces las piezas de un algoritmo que convierte una expresión regular en un NFA.
El código de la semana
code/week-02/
├── nfa.h                 struct Nfa, formato .nfa, clausura ε, δ*, subconjuntos y las construcciones de cierre
├── dfa.h                 el struct Dfa de la semana 1, sin cambios
├── kth.h                 el NFA de "el k-ésimo símbolo desde el final es 1"
├── strings.h, print.h    ayudas: todas las cadenas hasta una longitud, tablas alineadas
├── show_nfa.cpp          muestra un .nfa como quíntupla y como tabla, con la clausura ε de cada estado
├── run_nfa.cpp           el conjunto de estados activos después de cada símbolo
├── paths_nfa.cpp         todos los caminos de un NFA con una cadena, uno por línea
├── subset.cpp            la tabla de la construcción de subconjuntos
├── nfa_to_dfa.cpp        la construcción de subconjuntos, con salida en formato .dfa
├── run_dfa.cpp           el programa de la semana 1, para seguir el DFA construido
├── combine.cpp           unión, concatenación, estrella y reverso de archivos .nfa
├── kth_nfa.cpp           escribe el NFA de kth.h para un k
├── kth_table.cpp         la tabla de estados para k de 1 a 12
├── wrong_star.cpp        la estrella sin estado inicial nuevo, comparada con la correcta
├── swap_accept.cpp       intercambiar F en un NFA, comparado con el complemento correcto
├── machines/             los autómatas del capítulo, en formato .nfa y .dfa
├── errors/               las dos construcciones incorrectas y dos archivos que no son un NFA
├── test_helpers.h        predicados, aceptación por caminos y NFA al azar para las pruebas
├── test_nfa.cpp          cada NFA contra un predicado; estados activos contra la definición por caminos
├── test_subset.cpp       el DFA construido contra el NFA; la tabla de k de 1 a 12
├── test_closure.cpp      las cuatro construcciones contra su predicado; las dos incorrectas
└── lab/nfa_to_dfa/       el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Tardan bastante más que las de la semana
pasada, porque recorren muchas cadenas con conjuntos de nombres y con los sanitizers activos.
$ make test
test_nfa: ok (7 autómatas, 15562 cadenas en total; 200 NFA al azar contra la definición)
test_subset: ok (4 autómatas de los apuntes, k de 1 a 12, 200 NFA al azar)
test_closure: ok (unión, concatenación, estrella y reverso; 100 pares de NFA al azar)
Todas las pruebas pasaron.
Las pruebas comprueban con assert lo que este capítulo afirma.
test_nfacompara cada autómata demachines/con una función de C++ que decide el mismo lenguaje mirando la cadena completa. Comprueba los conjuntos de estados activos copiados en estos apuntes, las propiedades de la clausura y el lema de los estados activos: la simulación con conjuntos contra una búsqueda directa de un camino.test_subsetcomprueba el lema de la construcción y el teorema: para cada cadena, el estado del DFA es el conjunto de estados activos del NFA, y aceptan lo mismo. Revisa la cantidad de estados de cada ejemplo, que el NFA de Termina en 01 da el DFA de la semana pasada, y que para de 1 a 12 salen exactamente .test_closurecompara la unión, la concatenación, la estrella y el reverso con el predicado que define cada operación, calculado sin autómatas: “está en alguno de los dos”, “existe un corte”, “se parte en trozos”, “su reverso está”. Y comprueba que las dos construcciones incorrectas fallan con las cadenas de este capítulo: la estrella sin estado nuevo acepta , y el NFA con intercambiado acepta .
Los archivos de machines/ son:
| Archivo | Lenguaje | Estados | Estados del DFA construido |
|---|---|---|---|
third_from_end.nfa |
El tercer símbolo desde el final es | 4 | 8 |
contains_101_or_11.nfa |
Contiene o , con una transición | 4 | 6 |
abc_blocks.nfa |
Algunas , después , después | 3 | 4 |
ends_01.nfa |
Termina en | 3 | 3 |
zeros_then_one.nfa |
Algunos ceros y un | 2 | 3 |
even_ones.dfa, ends_01.dfa |
Los DFA de la semana 1, para combinarlos | 2 y 3 |
En errors/ hay dos archivos que show_nfa no acepta, y un encabezado con las dos construcciones incorrectas:
$ build/show_nfa errors/unknown_state.nfa
error: errors/unknown_state.nfa: no es un NFA: transición hacia q2, que no está en states
Para experimentar, copien un archivo de machines/, agréguenle una transición y vuelvan a correr
run_nfa y subset con las mismas cadenas.
El laboratorio
En lab/nfa_to_dfa está el enunciado, un esqueleto, los casos y un verificador. El problema es la construcción
de subconjuntos: la entrada es un NFA en formato .nfa, con transiciones , y la salida es un DFA
equivalente en formato .dfa.
cd lab/nfa_to_dfa
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Hay muchas respuestas correctas, porque los estados del DFA pueden llamarse como ustedes quieran. Por eso el
juez no compara su salida con un archivo: usa verificador.cpp, que comprueba que lo que entregaron es un DFA
bien formado y que reconoce el mismo lenguaje que el NFA. Para eso recorre las dos máquinas a la vez, como en el
producto, buscando un par alcanzable en el que una acepte y la otra no. Si lo encuentra, les muestra la cadena.
nfa.h ya trae la construcción, y pueden leerla. El laboratorio pide escribirla de nuevo, sin incluir ese
archivo, de modo que aguante un NFA de 60 estados: el enunciado limita el DFA a 10 000 estados, y un programa
que genera los subconjuntos no pasa. La última parte del laboratorio es llenar con su programa la tabla de
de 1 a 12 de la sección El costo: hasta 2ⁿ estados.
Resumen
- Un NFA es con : la función de transición devuelve un conjunto de estados, que puede ser vacío. Puede haber varias flechas con un símbolo, ninguna, y transiciones , que no leen nada.
- acepta si existe un camino de a un estado de cuyas etiquetas forman . Los caminos que mueren o terminan en otro lado no cuentan. No acepta “si todos los caminos aceptan” ni “al azar”.
- Tres imágenes equivalentes: adivinar bien, explorar todos los caminos a la vez, y un árbol de ejecuciones.
- La clausura es el conjunto de estados alcanzables desde con cero o más transiciones . Se calcula con un recorrido del grafo de las flechas .
- Para simular un NFA se sigue el conjunto de estados activos: y . acepta si y solo si contiene algún estado de .
- Todo DFA es un NFA. Y al revés: la construcción de subconjuntos da, para todo NFA, un DFA equivalente. Sus estados son conjuntos de estados del NFA, el inicial es , la transición es , y son de aceptación los conjuntos que contienen algún estado de . El conjunto es el estado trampa.
- La equivalencia se demuestra con dos lemas por inducción sobre la longitud: los estados activos son los estados con un camino, y el DFA queda en el conjunto de estados activos.
- Un lenguaje es regular si y solo si algún NFA lo reconoce. Para demostrar que un lenguaje es regular basta dar un NFA.
- Solo se construyen los subconjuntos alcanzables, con una cola. Aun así pueden ser : el lenguaje “el -ésimo símbolo desde el final es ” tiene un NFA de estados y todo DFA suyo tiene al menos . La demostración de esa cota es de la semana 4.
- Los lenguajes regulares son cerrados bajo unión (estado inicial nuevo con dos transiciones ), concatenación (transiciones de a , y ), estrella (estado inicial nuevo de aceptación, y transiciones de a ) y reverso (flechas invertidas).
- En la estrella, el estado inicial nuevo es necesario: marcar el anterior como de aceptación acepta cadenas de más cuando alguna flecha vuelve a él.
- El complemento no se obtiene intercambiando los estados de aceptación de un NFA. Primero se convierte a DFA.
Ejercicios
- Con el autómata de
machines/third_from_end.nfa, escriban a mano todos los caminos para y digan cuáles terminan en , cuáles terminan fuera y cuáles mueren. Después calculen el conjunto de estados activos después de cada símbolo. Comprueben conpaths_nfay conrun_nfa. ¿Cuántos caminos tiene la cadena ? - Sigan a mano el autómata de
machines/contains_101_or_11.nfacon , con una tabla como la de la sección Seguir un NFA: el conjunto de estados activos: los destinos de las flechas y el conjunto después de la clausura. ¿En qué fila cambia algo si se borra la transición ? ¿Qué lenguaje reconoce la máquina sin ella? - Diseñen un NFA para cada lenguaje sobre , con la cantidad de estados indicada, y
escriban el archivo
.nfa: (a) las cadenas que contienen , con 5 estados; (b) las que terminan en o en , con 5 estados o menos; (c) las que tienen un en la segunda posición o en la penúltima. En cada uno digan qué adivina la máquina. - En el NFA de
machines/abc_blocks.nfa, calculen para los ocho subconjuntos de . ¿Cuántos resultados distintos hay? Demuestren, a partir de la definición, que y que en cualquier NFA. - Apliquen a mano la construcción de subconjuntos al NFA de
machines/zeros_then_one.nfay al resultado debuild/combine star machines/zeros_then_one.nfa. Dibujen solo los estados alcanzables y comprueben consubset. En el segundo, ¿qué dos estados del DFA se podrían juntar en uno sin cambiar el lenguaje? - ¿Por qué los estados de aceptación del DFA construido son los subconjuntos que contienen algún estado de
? Construyan el DFA de
machines/ends_01.nfacon la regla equivocada “el subconjunto está contenido en ” y den una cadena con la que falla. ¿Qué lenguaje reconoce un NFA si se cambia la definición de aceptar por “todos los caminos que leen la cadena completa terminan en , y hay al menos uno”? - Demuestren que para todo NFA hay un NFA equivalente sin transiciones y con los mismos
estados. Sugerencia: definan y decidan
cuáles deben ser los estados de aceptación para que la cadena vacía se siga aceptando cuando corresponde.
Aplíquenlo a
machines/abc_blocks.nfa. - Con
combine, construyan el NFA de la concatenación de cantidad par de unos con termina en 01, en ese orden. ¿Qué lenguaje es, descrito con palabras? Sigan conrun_nfay digan qué corte usa el camino que acepta. Después apliquensubsety cuenten los estados. - Den un NFA, distinto del de estos apuntes, para el que intercambiar los estados de aceptación no dé el complemento, y una cadena que lo muestre. Después den un NFA que no sea un DFA para el que el intercambio sí dé el complemento. ¿Qué propiedad de sus caminos lo explica?
- Completen la demostración del cierre bajo reverso: demuestren por inducción sobre la cantidad de pasos que una secuencia es un camino en con etiqueta si y solo si la secuencia invertida es un camino por las flechas invertidas con etiqueta . Usen que , del ejercicio 4 de la semana pasada. Después demuestren que un camino de que acepta usa el estado una sola vez.
- La construcción del producto también funciona con dos NFA sin transiciones : y . Demuestren que reconoce . ¿Por qué la misma máquina con “alguno acepta” no reconoce siempre la unión? Den un ejemplo. Sugerencia: piensen en un camino que muere en una de las dos máquinas.
- Demuestren que si es regular, también lo son: (a) el lenguaje de los prefijos de las cadenas de ; (b) el de los sufijos; (c) el de las subcadenas. En cada caso modifiquen un NFA de y digan qué cambia. Sugerencia para (a): ¿desde qué estados se puede llegar a un estado de aceptación?
- Para programar. Agreguen a
nfa.huna funciónremove_epsque haga la construcción del ejercicio 7, y una prueba que la compare con el NFA original en todas las cadenas hasta longitud 8, para los autómatas demachines/. ¿Cambia la cantidad de estados del DFA que dasubset_construction? - Para programar. Escriban un programa que reciba y un patrón binario de longitud , construya el
NFA de “contiene ” con estados y le aplique la construcción de subconjuntos. Cuenten los estados
alcanzables para varios patrones de longitud 8. ¿Por qué aquí no aparece el ? Comparen con la tabla de
kth_tabley expliquen la diferencia entre los dos lenguajes en términos de lo que el DFA tiene que recordar.