
Apuntes · Capítulo 6Lenguajes libres de contexto
Autómatas de pila y los límites de las gramáticas
Autómatas de pila y los límites de las gramáticas
La semana pasada apareció una clase de lenguajes más grande que la de los regulares: los que genera una gramática libre de contexto (CFG). Con reglas como describimos , los paréntesis balanceados y las expresiones aritméticas, que ningún autómata finito reconoce. Pero una gramática es una manera de generar cadenas. Para decidir si una cadena dada está en el lenguaje tuvimos que pasar a la forma normal de Chomsky y llenar la tabla de CYK.
Con los lenguajes regulares teníamos las dos caras: la expresión regular, que describe, y el autómata, que lee la cadena y responde. Esta semana construimos la segunda cara de los lenguajes libres de contexto. La máquina es un autómata finito al que se le agrega lo único que le faltaba para contar sin tope, una pila. Se llama autómata de pila (pushdown automaton), o PDA.
La semana tiene dos mitades.
- En la primera definimos el PDA, diseñamos varios y demostramos que es exactamente tan capaz como las gramáticas: un lenguaje tiene una gramática libre de contexto si y solo si algún PDA lo reconoce. Son dos construcciones, una en cada sentido.
- En la segunda buscamos el límite, como hicimos en la semana 4 con los regulares. Hay un lema de bombeo para los lenguajes libres de contexto, y con él demostramos que y no lo son. Después vemos bajo qué operaciones se conserva la clase y bajo cuáles no, y cerramos la parte 2 del curso con el mapa de lo que llevamos.
Al final hay una sección opcional sobre cómo trabaja el parser de un compilador real, que no usa ni CYK ni una búsqueda como la de esta semana.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Un autómata finito con una pila y La definición formal de un PDA. Antes de la sesión B, Un lenguaje que pide comparar tres cantidades. Con eso llegan con la máquina ya vista y con la pregunta de la segunda sesión planteada.
En clase: Sesión A, de Un autómata finito con una pila a El PDA determinista reconoce menos. De la sección De PDA a gramática se ven en clase la idea y el ejemplo; la demostración completa queda para leer. Sesión B, de Un lenguaje que pide comparar tres cantidades a El mapa hasta ahora.
Después de clase: el Resumen y los Ejercicios, para repasar. La demostración, completa dentro de De PDA a gramática, con lápiz y papel. Antes del laboratorio, Simular un PDA: buscar entre configuraciones y El código de la semana. Opcional (✂️): Cómo trabaja un parser real, y las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 2.2 (Pushdown Automata) para la sesión A y sec. 2.3 (Non-Context-Free Languages) para la sesión B. Para la parte opcional, sec. 2.4 (Deterministic Context-Free Languages), solo como consulta. Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-06. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio, que esta semana es opcional, está enlab/pda_sim.
Un autómata finito con una pila
Un autómata finito no reconoce porque no tiene dónde anotar cuántos ceros leyó: su única memoria es el estado, y los estados son una cantidad fija. La solución más simple que se le ocurre a cualquiera que programe es darle una pila (stack).
Una pila es la estructura que conocen de Estructuras de Datos, y aquí se usa con sus dos operaciones de siempre: poner un símbolo encima y sacar el que está encima. Tiene dos propiedades que definen a la máquina.
- No tiene límite de tamaño. Puede guardar tantos símbolos como haga falta. Eso es lo que el autómata finito no tenía.
- Solo se ve la cima. Para mirar un símbolo que está más abajo hay que sacar los que tiene encima, y lo que se saca se pierde. Esto es lo que la máquina no puede hacer, y de ahí saldrá su límite en la sesión B.
Con una pila, reconocer es directo:
1. Mientras lleguen ceros, poner cada uno en la pila.
2. Cuando llegue el primer 1, empezar a sacar: por cada 1 que se lee, sacar un 0.
3. Si se termina la entrada justo cuando la pila queda vacía, aceptar.
   Si sobra un 1 (no hay 0 que sacar), si sobran ceros en la pila, o si aparece un 0
   después de un 1, rechazar.
El paso 3 esconde un problema: la máquina solo ve la cima, y no puede ver que la pila está vacía. Sacar de
una pila vacía no es una operación que “falla y avisa”: simplemente no se puede hacer. La solución es un truco
que usaremos en casi todos los autómatas del capítulo. Antes de leer nada, la máquina pone en la pila un símbolo
especial, que escribiremos $. Cuando ese símbolo vuelve a estar en la cima, la máquina sabe que todo lo que
puso después ya salió.
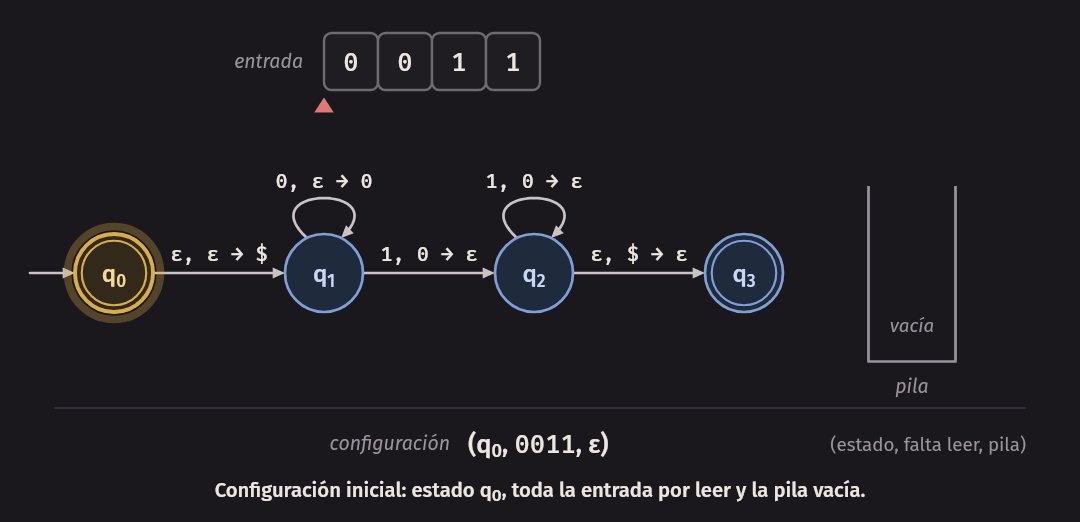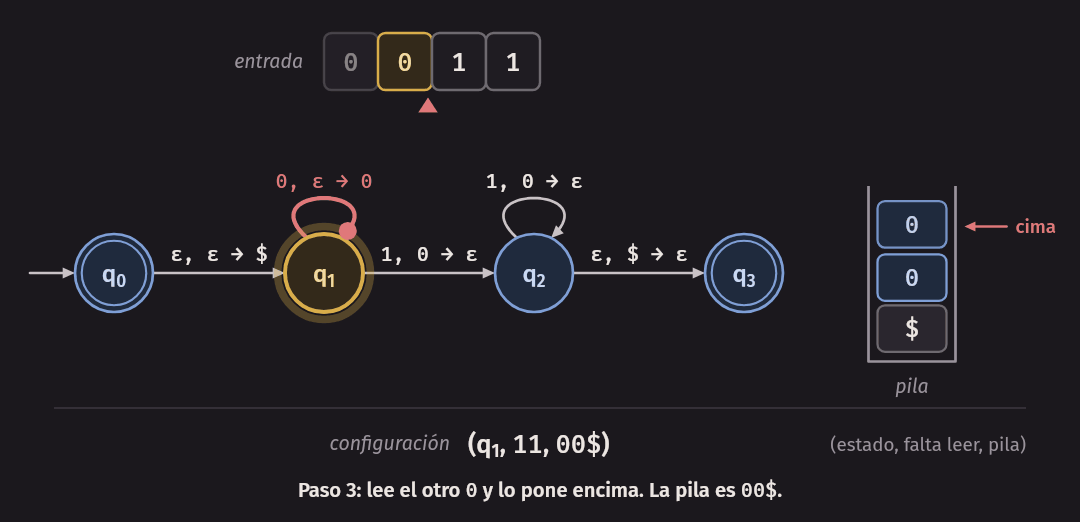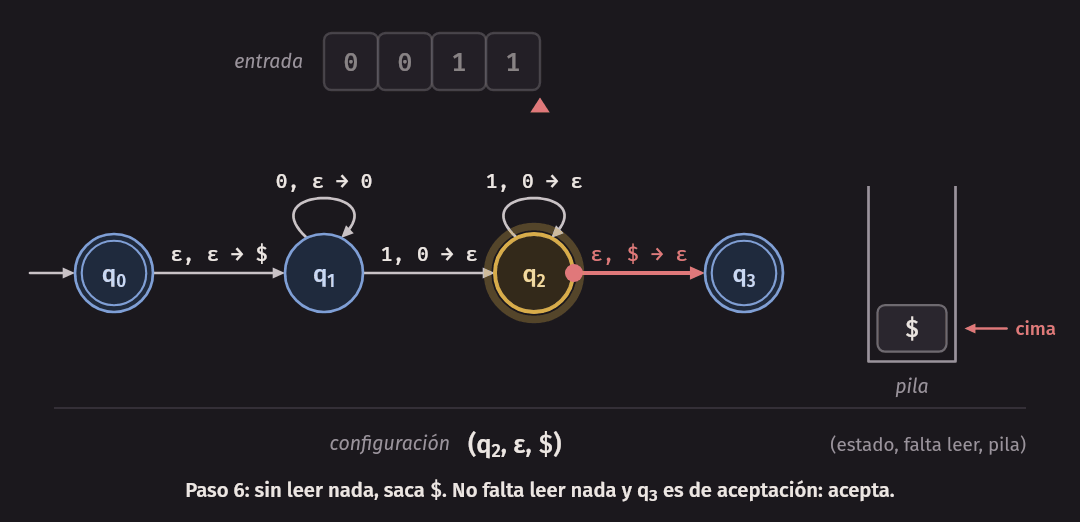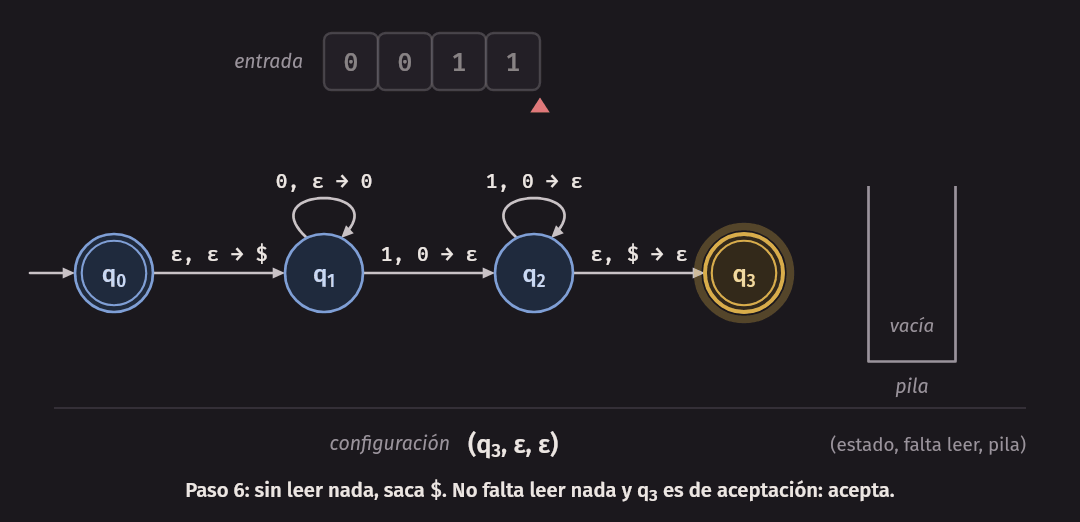
El autómata completo tiene cuatro estados. Cada flecha lleva una etiqueta con tres partes: lo que lee, lo que saca y, después de la flecha, lo que pone.
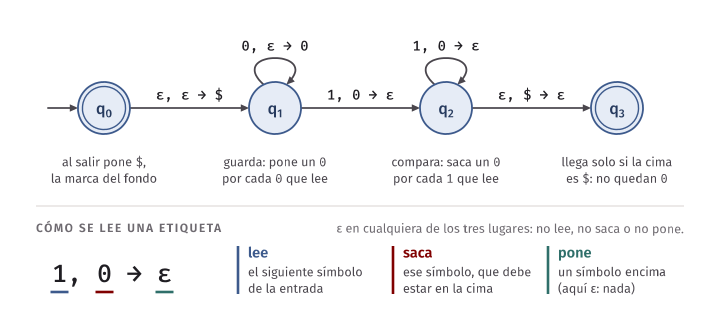
- De a : sin leer nada y sin sacar nada, pone
$. Es la marca del fondo. - En : lee un y lo pone en la pila.
- De a , y en : lee un y saca un .
- De a : sin leer nada, saca
$. Solo puede hacerlo si$está en la cima, es decir, si ya salieron todos los ceros.
Los estados de aceptación son , para aceptar la cadena vacía, y . El autómata está en el archivo
machines/zeros_ones.pda, y el programa run_pda lo sigue con una cadena:
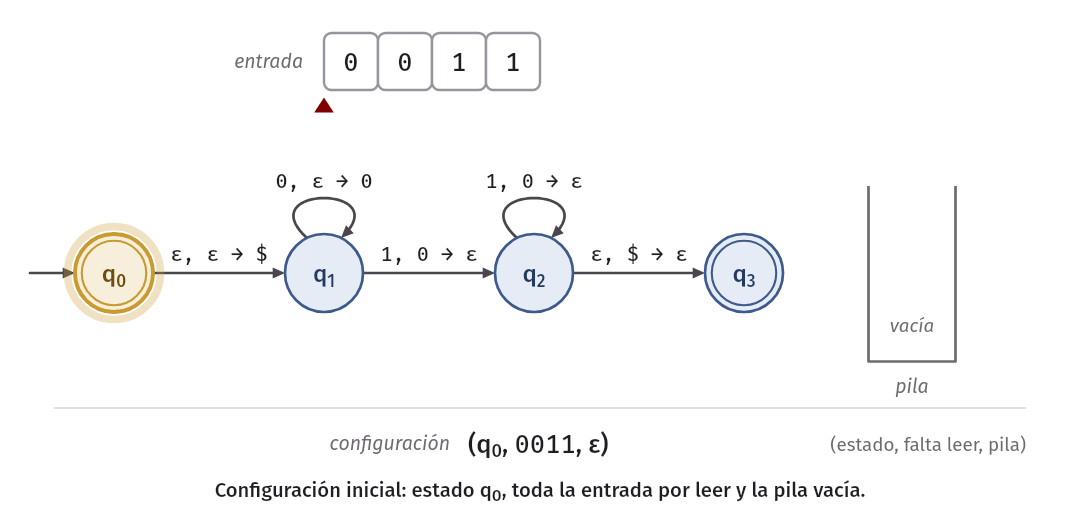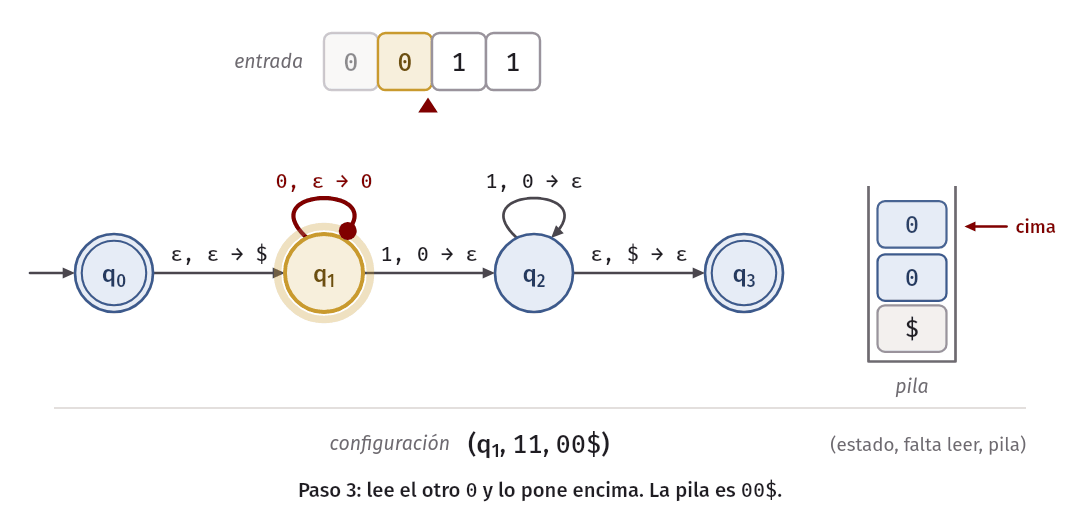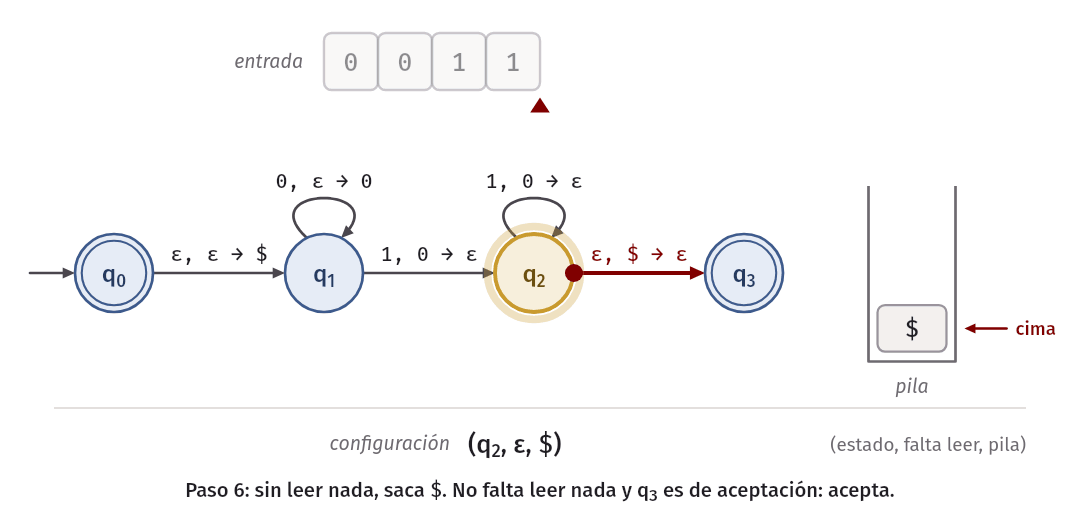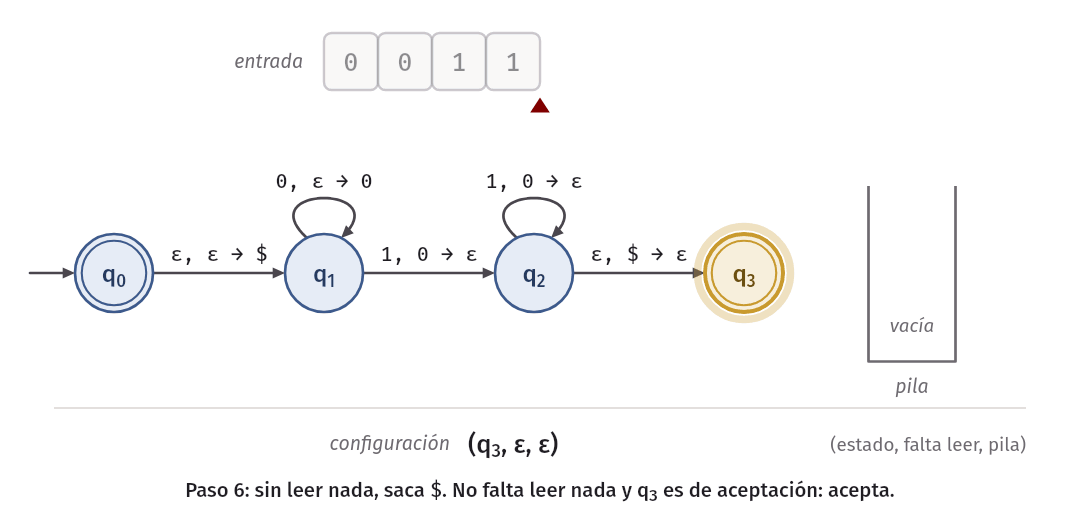
$ build/run_pda machines/zeros_ones.pda 0011 '' 001
w = 0011
  paso  transición  estado  falta leer  pila
     0              q0      0011        ε
     1  ε, ε → $    q1      0011        $
     2  0, ε → 0    q1      011         0$
     3  0, ε → 0    q1      11          00$
     4  1, 0 → ε    q2      1           0$
     5  1, 0 → ε    q2      ε           $
     6  ε, $ → ε    q3      ε           ε
  acepta en q3 (configuraciones exploradas: 7)
w = ε
  paso  transición  estado  falta leer  pila
     0              q0      ε           ε
  acepta en q0 (configuraciones exploradas: 1)
w = 001
  rechaza: 5 configuraciones alcanzables, ninguna acepta
Cada fila es un instante: el estado, lo que falta leer de la entrada y el contenido de la pila, con la cima a
la izquierda. En la fila 3 la pila es 00$: dos ceros encima de la marca. En las filas 4 y 5 cada
se lleva un cero. En la fila 5 la cima es $, y eso permite el último paso.
Con la máquina rechaza. Después de leer todo queda en con la pila 0$: la cima es un
, la transición a pide un $, y no hay otra. Qué quiere decir exactamente “configuraciones
alcanzables” se precisa dos secciones más abajo.
Idea clave. Un autómata de pila es un autómata finito con una pila. Los estados siguen siendo una cantidad fija; la pila no tiene límite, pero solo se puede mirar y cambiar por la cima. En cada paso la máquina decide con tres datos: el estado, el siguiente símbolo de la entrada y la cima de la pila.
El autómata de arriba nunca tuvo que elegir. Los que vienen sí: un PDA es, por definición, no determinista, como un NFA. Puede tener varias transiciones posibles en un mismo instante, y transiciones que no leen nada. La razón no es comodidad, como en la semana 2: veremos que aquí el no determinismo no se puede quitar.
La definición formal de un PDA
Una transición de un PDA mira tres cosas y produce dos. Mira el estado, un símbolo de la entrada y un símbolo de la cima de la pila. Produce un estado nuevo y un símbolo para poner en la pila. Cualquiera de los símbolos puede faltar: la transición puede no leer, no sacar o no poner. Para escribir eso se usa una notación que aparece en toda la definición: si es un alfabeto,
es el conjunto de sus símbolos más la opción “ninguno”.
Definición. Un autómata de pila (pushdown automaton), o PDA, es una séxtupla , donde:
- es un conjunto finito, el de los estados.
- es el alfabeto de entrada.
- es el alfabeto de la pila, un conjunto finito de símbolos.
- es la función de transición.
- es el estado inicial.
- es el conjunto de los estados de aceptación.
Es la definición de un NFA de la semana 2 con dos agregados: el alfabeto , y una coordenada más en la entrada y en la salida de . Conviene leer con cuidado qué dice .
- se lee: en el estado , leyendo y sacando de la cima, la máquina puede pasar al estado poniendo . En los diagramas, es una flecha de a con la etiqueta .
- : la transición no lee nada de la entrada. : no saca nada, y se puede usar con cualquier cosa en la cima, también con la pila vacía. : no pone nada.
- Los cuatro casos de y tienen nombre de operación: pone ; saca ; reemplaza la cima por ; y no toca la pila.
- El resultado es un conjunto, como en un NFA. Puede tener varios elementos, y entonces la máquina elige. Puede ser vacío, y entonces ese camino no sigue.
- y son alfabetos distintos, que pueden compartir símbolos o no. En el ejemplo anterior
y tiene el y la marca
$. La marca no está en : nunca aparece en la entrada. - Una transición pone a lo sumo un símbolo. Para poner dos hacen falta dos transiciones seguidas, con un estado intermedio. Lo necesitaremos en la construcción de la sección De gramática a PDA.
En el formato del curso, descrito en code/formats.md, la séxtupla es un archivo con un campo por componente.
Este es machines/zeros_ones.pda:
# { 0^n 1^n : n >= 0 }
states: q0 q1 q2 q3
alphabet: 0 1
stack: 0 $
start: q0
accept: q0 q3
delta:
q0 eps eps -> q1 $
q1 0 eps -> q1 0
q1 1 0 -> q2 eps
q2 1 0 -> q2 eps
q2 eps $ -> q3 eps
Después de delta: va una transición por línea: estado lee saca -> destino pone, con eps donde va
. La línea q1 1 0 -> q2 eps dice que .
Dos líneas pueden tener el mismo lado izquierdo: así se escribe un conjunto con dos elementos. El programa
show_pda muestra un archivo como séxtupla, listando solo los valores de que no son vacíos. Con el
autómata de los palíndromos, que veremos enseguida:
$ build/show_pda machines/even_palindromes.pda
Q  = {q0, q1, q2, q3}
Σ  = {0, 1}
Γ  = {0, 1, $}
q0 = q0
F  = {q3}

δ(q0, ε, ε) = {(q1, $)}
δ(q1, ε, ε) = {(q2, ε)}
δ(q1, 0, ε) = {(q1, 0)}
δ(q1, 1, ε) = {(q1, 1)}
δ(q2, ε, $) = {(q3, ε)}
δ(q2, 0, 0) = {(q2, ε)}
δ(q2, 1, 1) = {(q2, ε)}

4 estados, 7 transiciones
La función completa tiene valores. Siete son conjuntos de un elemento, y los otros 41 son .
En C++. El
struct Pdadepda.htiene los seis componentes con los nombres del formato:states,alphabet,stack,delta,startyaccept. La función es unstd::mapcuya clave es la terna (estado, lee, saca) y cuyo valor es unstd::vector<Move>, la lista de pares (destino, pone). Una clave que no está en el mapa es un valor de . El símbolo se guarda como el carácter'\0', con el nombreEPS: ningún símbolo de un archivo puede valer eso.
Error común. Escribir una transición que pone dos símbolos, como
q1 a eps -> q1 x x. El formato y la definición permiten uno solo. El archivoerrors/two_symbols.pdatiene esa línea, yrun_pdalo rechaza al leerlo. Para ponerxxse pasa por un estado intermedio:q1 a eps -> m xym eps eps -> q1 x.
Configuraciones y el lenguaje de un PDA
En un DFA bastaba decir en qué estado estaba la máquina. En un PDA, para saber qué puede pasar después hacen
falta tres datos, los tres que mostraba cada fila de run_pda.
Definición. Una configuración (configuration) de es una terna , donde es el estado, es lo que falta leer de la entrada, y es el contenido de la pila, con la cima a la izquierda. La configuración inicial con la entrada es : nada leído, la pila vacía.
Un paso de la máquina lleva de una configuración a otra. Lo escribimos con el símbolo .
Definición. pasa en un paso de a , y se escribe
si , donde , , y . Se escribe si se llega de a en cero o más pasos.
La definición dice con símbolos lo que ya hicimos a mano. Si es un símbolo, es el primero de lo que falta leer, y desaparece. Si es un símbolo, es la cima, y se reemplaza por . El resto de la pila, , no cambia y ni siquiera se mira. Una secuencia se llama una ejecución de .
Definición. acepta la cadena si
El lenguaje de es , y se dice que reconoce .
Una configuración con se llama de aceptación. Hay cuatro cosas en esta definición que conviene dejar claras.
- Basta una ejecución. Como en un NFA, la máquina acepta si alguna secuencia de elecciones termina bien. Que otras se queden sin transiciones o terminen en un estado que no es de aceptación no importa.
- Hay que leer toda la entrada. La segunda coordenada debe ser . Pasar por un estado de aceptación cuando todavía falta leer no cuenta.
- La pila puede quedar con cualquier cosa. Se acepta por estado. Vaciar la pila antes de aceptar es una
costumbre útil, y la marca
$sirve para eso, pero la definición no lo pide. - Un camino puede morir. Si desde una configuración ninguna transición se puede usar, esa ejecución termina ahí. Pasa, por ejemplo, cuando la transición pide sacar un símbolo y la cima es otro, o la pila está vacía.
Con y el autómata de la sección anterior, la ejecución que imprimió run_pda es, en esta
notación (aquí el símbolo $ se ve como ):
La última configuración es de aceptación: no falta leer nada y .
Error común. Decir que el autómata acepta porque “llega a ”. Llega, después de leer , pero en la configuración todavía falta leer un símbolo, y no tiene transiciones. Ese camino muere sin aceptar, y no hay otro.
Sipser define la aceptación con una secuencia de estados y una secuencia de pilas . Es la misma definición: son la primera y la tercera coordenada de nuestras configuraciones, y la segunda se deduce de cuánto se leyó.
De la definición de sale una propiedad que usaremos en las dos demostraciones grandes del capítulo. Un paso solo mira la cima de la pila y el primer símbolo que falta leer. Lo que está más abajo en la pila, y lo que viene después en la entrada, no participa.
Lema (del fondo). Si , entonces para toda y toda :
Demostración. Por inducción sobre la cantidad de pasos. Con cero pasos las dos configuraciones son iguales y no hay nada que probar. Para un paso: si porque , la misma transición da , porque la definición de permite cualquier cadena después de y cualquier pila debajo de . Una ejecución de pasos es una de seguida de un paso, y a cada parte se le agregan y igual. ∎
Dicho de otro modo: toda ejecución se puede repetir “más arriba”, encima de una pila que ya tenía cosas, y con más entrada esperando detrás. El recíproco no vale sin condiciones. Una ejecución que en algún momento saca un símbolo de no se puede repetir sin .
Diseñar un PDA
Diseñar un autómata finito era decidir qué recordar en el estado. Diseñar un PDA es repartir la memoria en dos: qué va en el estado, que es poco y siempre está a la vista, y qué va en la pila, que puede ser mucho pero solo se recupera en orden inverso al que se guardó. Casi todos los diseños siguen el mismo plan:
- marcar el fondo de la pila;
- una fase que guarda, una fase que saca y compara;
- el estado recuerda en qué fase está la máquina;
- al final, comprobar que la pila volvió a la marca.
Marcar el fondo de la pila
La marca $ ya apareció, y vale la pena decir por qué es necesaria. La función recibe un símbolo de
como tercera coordenada. Con un símbolo , la transición exige que esté en la cima.
Con , no exige nada. No existe una tercera coordenada que diga “la pila está vacía”. Una
transición con se puede usar con la pila vacía y también con la pila llena.
La marca convierte “la pila está vacía” en algo que sí se puede preguntar: “la cima es $”. Sin ella, el
autómata de no podría distinguir de . Con la segunda
quedaría en con un cero en la pila, y si la transición a fuera , la tomaría igual.
Hay autómatas que no la necesitan. El del lenguaje pone una por cada , saca una por cada y acepta en cualquier momento, sobre lo que sobre: le alcanza con que una de más no encuentre nada que sacar y ese camino muera. Es uno de los casos del laboratorio.
Paréntesis balanceados
El lenguaje de los paréntesis balanceados, con la gramática de la semana 5, es el ejemplo natural de una pila: es lo que hace cualquier editor de código para emparejar paréntesis. Cada paréntesis que abre se guarda, y cada uno que cierra saca uno guardado.
| Estado | Lee, saca pone | Destino | Para qué |
|---|---|---|---|
| marcar el fondo | |||
| abrir: guardar | |||
| cerrar: tiene que haber uno abierto | |||
| no queda nada abierto |
El único estado de aceptación es . A diferencia del autómata de , aquí hay un solo estado de trabajo: guardar y sacar se alternan, y no hay fases que recordar.
$ build/run_pda machines/balanced.pda '(())()' '())'
w = (())()
  paso  transición  estado  falta leer  pila
     0              q0      (())()      ε
     1  ε, ε → $    q1      (())()      $
     2  (, ε → (    q1      ())()       ($
     3  (, ε → (    q1      ))()        (($
     4  ), ( → ε    q1      )()         ($
     5  ), ( → ε    q1      ()          $
     6  (, ε → (    q1      )           ($
     7  ), ( → ε    q1      ε           $
     8  ε, $ → ε    q2      ε           ε
  acepta en q2 (configuraciones exploradas: 11)
w = ())
  rechaza: 6 configuraciones alcanzables, ninguna acepta
La altura de la pila en cada fila es la cantidad de paréntesis abiertos sin cerrar. En la fila 5 la cima es
$: el prefijo (()) está balanceado. Cada vez que la cima es $, como en las filas 1 y 5, el autómata
puede pasar a , y ahí tiene una elección. Si pasa en la fila 5, queda en con () por leer y sin
transiciones, y ese camino muere. La ejecución que acepta es la que sigue en y deja el salto para el
final. Con ()), el tercer símbolo pide sacar un
( y la cima es $: no hay camino.
Palíndromos de longitud par: adivinar el medio
Sea , los palíndromos de longitud par: , , , . La gramática es .
El plan es el de siempre: guardar la primera mitad, y después sacar comparando con la segunda. Una pila devuelve lo guardado en orden inverso, que es justo lo que hace falta para comparar con . El problema es otro: ¿cuándo termina la primera mitad? En lo avisaba el primer . Aquí no hay ninguna señal en la entrada, y la máquina no sabe cuánto mide la cadena.
La respuesta es la del no determinismo: no lo sabe, así que lo adivina. En guarda. En cualquier momento, sin leer nada, puede pasar a , y desde ahí solo saca y compara.
| Estado | Lee, saca pone | Destino | Para qué |
|---|---|---|---|
| marcar el fondo | |||
| y | primera mitad: guardar lo que se lee | ||
| adivinar que aquí está el medio | |||
| y | segunda mitad: lo leído debe ser igual a la cima | ||
| se comparó todo |
$ build/run_pda machines/even_palindromes.pda 0110 011
w = 0110
  paso  transición  estado  falta leer  pila
     0              q0      0110        ε
     1  ε, ε → $    q1      0110        $
     2  0, ε → 0    q1      110         0$
     3  1, ε → 1    q1      10          10$
     4  ε, ε → ε    q2      10          10$
     5  1, 1 → ε    q2      0           0$
     6  0, 0 → ε    q2      ε           $
     7  ε, $ → ε    q3      ε           ε
  acepta en q3 (configuraciones exploradas: 15)
w = 011
  rechaza: 11 configuraciones alcanzables, ninguna acepta
En el paso 4 la máquina adivina, después de leer exactamente dos símbolos. Esa es la ejecución que run_pda
muestra, pero para encontrarla exploró 15 configuraciones: también probó saltar a en los otros momentos
posibles, antes de leer nada y después de uno, de tres y de cuatro símbolos. Esos intentos mueren. Por ejemplo, si salta después
de un símbolo queda en , lee un con un
en la cima, y no hay transición.
“Adivinar” no es magia ni suerte. Quiere decir, como en la semana 2, que la definición de aceptar pide que exista una ejecución buena. Si la cadena es , la ejecución que salta en el medio existe y acepta. Si la cadena no es de esa forma, ningún punto de salto sirve, y eso es lo que hay que comprobar al demostrar que el autómata es correcto: que una ejecución que acepta solo puede haber saltado en el medio de un palíndromo.
Idea clave. En un PDA, el no determinismo sirve para tomar una decisión que depende de algo que todavía no se leyó: dónde está el medio, cuál de dos comparaciones hacer. La máquina acepta si alguna de las decisiones posibles lleva a aceptar.
Elegir qué comparar
El último ejemplo usa el no determinismo de otra manera. Sea
Una cadena está en por dos razones posibles, y el autómata no sabe cuál hasta haber leído todo. Así que al
empezar, sin leer nada, elige una de dos ramas. La primera compara las con las y
deja pasar las sin mirar. La segunda deja pasar las y compara las con las
. Cada rama es un autómata como el de . El archivo es
machines/ij_or_jk.pda, con nueve estados:
$ build/run_pda machines/ij_or_jk.pda abbcc
w = abbcc
  paso  transición  estado  falta leer  pila
     0              q0      abbcc       ε
     1  ε, ε → $    q1      abbcc       $
     2  ε, ε → ε    q5      abbcc       $
     3  a, ε → ε    q5      bbcc        $
     4  ε, ε → ε    q6      bbcc        $
     5  b, ε → b    q6      bcc         b$
     6  b, ε → b    q6      cc          bb$
     7  ε, ε → ε    q7      cc          bb$
     8  c, b → ε    q7      c           b$
     9  c, b → ε    q7      ε           $
    10  ε, $ → ε    q8      ε           ε
  acepta en q8 (configuraciones exploradas: 24)
En el paso 2 elige la segunda rama, la de . En el paso 3 lee la sin tocar la pila. Con acepta por la primera rama, y con por cualquiera de las dos.
La construcción es general: dados dos PDA, uno nuevo que al empezar salta sin leer nada al inicio de uno o del otro reconoce la unión de sus lenguajes. Es la misma idea que la unión de dos NFA.
Error común. Usar la pila como un contador de dos cosas a la vez. Aquí las dos comparaciones están en ramas separadas, y cada ejecución hace una sola. Un autómata que intentara comprobar y en la misma ejecución tendría que guardar las , sacarlas con las , y al llegar a las ya no tendría con qué comparar: la pila se gastó. Una pila compara una sola pareja de cantidades. La sesión B demuestra que esto no es falta de ingenio, sino un límite de la máquina.
Simular un PDA: buscar entre configuraciones
El programa run_pda no “adivina”: prueba. Vale la pena ver cómo, porque es el problema del laboratorio y
porque muestra en qué se diferencia simular un PDA de simular un NFA.
Para un NFA, en la semana 2, bastaba llevar el conjunto de estados en los que la máquina podía estar después de cada símbolo. Era un conjunto finito, de a lo sumo elementos, y avanzaba un símbolo por vez. Con un PDA eso no alcanza: dos ejecuciones que están en el mismo estado pueden tener pilas distintas, y lo que hagan después depende de la pila. Lo que hay que llevar es el conjunto de configuraciones.
Las configuraciones forman un grafo: hay una arista de a si . El PDA acepta si y solo si desde la configuración inicial se alcanza alguna configuración de aceptación. Simular es recorrer ese grafo, con la búsqueda por niveles o en profundidad que conocen de Algoritmos.
algoritmo simular(P, w, límite)
    inicial ← (q0, 0, pila vacía)
    vistas ← {inicial}
    pendientes ← cola con inicial
    mientras pendientes no esté vacía
        C ← sacar de pendientes
        si C tiene toda la entrada leída y su estado está en F entonces
            devolver ACEPTA
        fin si
        para cada C' tal que C ⊢ C'
            si C' no está en vistas entonces
                agregar C' a vistas y a pendientes
                si vistas tiene más de límite configuraciones entonces
                    devolver LÍMITE
                fin si
            fin si
        fin para
    fin mientras
    devolver RECHAZA
fin algoritmo
En el código, la segunda coordenada de la configuración es la posición en la entrada, cuántos símbolos se
leyeron, en lugar de la cadena que falta. Es la misma información y ocupa menos. La función simulate de
pda.h es este algoritmo, con un detalle: comprueba la aceptación al descubrir una configuración y no al
sacarla de la cola, que da el mismo resultado un poco antes.
El algoritmo tiene tres finales, y cada uno responde a un problema distinto.
El conjunto de vistas hace que la búsqueda termine. Un PDA puede tener un ciclo de transiciones que no cambia la pila: de a y de a , las dos con . Una búsqueda que no recuerde por dónde pasó daría vueltas ahí para siempre. Con el conjunto, la segunda vez que llega a una configuración la descarta. Además evita trabajo repetido: cuando dos caminos distintos llegan a la misma configuración, lo que sigue es igual para los dos, y se explora una sola vez.
Si las configuraciones se acaban, la respuesta es definitiva. Cuando la cola queda vacía se recorrieron
todas las configuraciones alcanzables y ninguna era de aceptación: la máquina rechaza. Eso es lo que decía
run_pda con 001: “5 configuraciones alcanzables, ninguna acepta”.
Pero las configuraciones pueden no acabarse. Los estados son finitos y las posiciones también, pero las
pilas no. Un PDA con la transición q eps eps -> q x, un ciclo de transiciones que hace crecer
la pila, tiene desde infinitas configuraciones alcanzables: una por cada altura. Ninguna búsqueda las
recorre todas. Por eso el algoritmo recibe un límite y tiene una tercera respuesta, que no es “acepta” ni
“rechaza” sino “no lo sé con este presupuesto”.
Ese tercer final no es un caso raro inventado para molestar. Aparece con el autómata más natural de la sección siguiente, y volveremos a él ahí.
En C++. En
pda.h, una configuración es unstruct Configcon el estado, la posición y la pila como unstd::stringcon la cima enstack[0]. Las vistas van en unstd::set<Config>, que necesita comparar configuraciones: la líneaauto operator<=>(const Config&) const = default;le pide al compilador la comparación campo por campo. Para poder mostrar la ejecución que acepta, cada configuración descubierta guarda desde cuál se llegó a ella, y al final se recorre esa cadena hacia atrás.
En la práctica. Buscar en un grafo de configuraciones con un conjunto de vistas es la base de las herramientas que verifican programas y protocolos: cada configuración es un estado posible del sistema, y la pregunta es si se alcanza uno malo. Cuando el programa tiene llamadas a funciones, su pila de llamadas hace que el modelo sea, literalmente, un autómata de pila.
De gramática a PDA
Ahora la primera mitad del teorema central de la semana: todo lo que una gramática libre de contexto genera, algún PDA lo reconoce. Es una construcción, y la hacemos completa.
Teorema. Para toda gramática libre de contexto existe un PDA con .
La idea: la pila guarda lo que falta derivar
Una derivación por la izquierda, como las de la semana 5, reemplaza siempre la variable que está más a la izquierda. Con :
En cada paso la cadena tiene dos partes: un prefijo de terminales, que ya no va a cambiar, y el resto, que empieza con la variable que toca reemplazar. El PDA va a seguir una derivación así, con una división del trabajo muy simple: el prefijo de terminales no lo guarda, lo compara con la entrada y lo olvida. El resto lo guarda en la pila, con su primer símbolo en la cima.
Entonces la máquina repite una de dos acciones, según lo que haya en la cima:
- Si la cima es una variable : elige una regla , saca y pone . Es un paso de la derivación. Aquí está el no determinismo: la máquina adivina qué regla usar.
- Si la cima es un terminal : lo compara con el siguiente símbolo de la entrada. Si son iguales, lee uno y saca el otro. Si no, este camino muere: la derivación que venía adivinando no produce esta cadena.
Empieza con la variable inicial en la pila, encima de la marca $, y acepta cuando la pila vuelve a la marca
con toda la entrada leída: no queda nada por derivar ni nada por leer.
Idea clave. En el PDA de una gramática, la pila contiene en cada instante lo que falta derivar: si ya se leyó y la pila es encima de la marca, entonces . El autómata no construye la cadena: adivina una derivación por la izquierda y comprueba que produce la entrada.
La construcción
Hay un detalle técnico. “Sacar y poner ” pone varios símbolos de una vez, y una transición pone a lo sumo uno. Se resuelve con una fila de estados intermedios que ponen los símbolos de de uno en uno, de derecha a izquierda, para que el primero quede en la cima.
Qué se construye. Sea . El PDA es con , donde
$ es un símbolo que no está en ni en . Sus estados son , ,
y , más los intermedios de cada regla. Las transiciones son:
- Preparar. pone
$y pasa a , que pone y pasa a . Las dos sin leer nada. - Reemplazar. Para cada regla de , donde cada es una variable o un
terminal:
- si , es decir, la regla es : en , la transición a ;
- si : en , la transición a ;
- si : estados nuevos , propios de esta regla, y las transiciones de a ; de a , para ; y de a .
- Comparar. Para cada terminal : en , la transición a .
- Terminar. En , la transición a .
El PDA tiene estados, donde la suma es sobre las reglas con símbolos a la derecha. Todo el trabajo pasa en ; los demás estados solo existen para poner símbolos de uno en uno.
Un ejemplo completo
El programa cfg_to_pda aplica la construcción a un archivo .cfg y escribe el .pda. Con la gramática de
los paréntesis, machines/balanced.cfg, que tiene las reglas y
:
$ build/cfg_to_pda machines/balanced.cfg
# PDA de la gramática machines/balanced.cfg.
states: q_start q_begin q_loop q_accept r1_1 r1_2 r1_3
alphabet: ( )
stack: ( ) S $
start: q_start
accept: q_accept
delta:
q_start eps eps -> q_begin $
q_begin eps eps -> q_loop S
q_loop eps $ -> q_accept eps
q_loop eps S -> r1_1 S
q_loop eps S -> q_loop eps
q_loop ( ( -> q_loop eps
q_loop ) ) -> q_loop eps
r1_1 eps eps -> r1_2 )
r1_2 eps eps -> r1_3 S
r1_3 eps eps -> q_loop (
La regla 1, , tiene símbolos a la derecha, así que usa tres estados
intermedios, r1_1, r1_2 y r1_3. La línea q_loop eps S -> r1_1 S saca y pone el último símbolo
de la regla, que también es una . Las tres siguientes ponen ), S y (, en ese orden: el paréntesis que
abre queda en la cima. La regla 2, , es la línea q_loop eps S -> q_loop eps. En total,
estados y 10 transiciones.
Guardamos esa salida en un archivo y la seguimos con ()():
$ build/cfg_to_pda machines/balanced.cfg > build/balanced_from_cfg.pda
$ build/run_pda build/balanced_from_cfg.pda '()()'
w = ()()
  paso  transición  estado    falta leer  pila
     0              q_start   ()()        ε
     1  ε, ε → $    q_begin   ()()        $
     2  ε, ε → S    q_loop    ()()        S$
     3  ε, S → S    r1_1      ()()        S$
     4  ε, ε → )    r1_2      ()()        )S$
     5  ε, ε → S    r1_3      ()()        S)S$
     6  ε, ε → (    q_loop    ()()        (S)S$
     7  (, ( → ε    q_loop    )()         S)S$
     8  ε, S → ε    q_loop    )()         )S$
     9  ), ) → ε    q_loop    ()          S$
    10  ε, S → S    r1_1      ()          S$
    11  ε, ε → )    r1_2      ()          )S$
    12  ε, ε → S    r1_3      ()          S)S$
    13  ε, ε → (    q_loop    ()          (S)S$
    14  (, ( → ε    q_loop    )           S)S$
    15  ε, S → ε    q_loop    )           )S$
    16  ), ) → ε    q_loop    ε           S$
    17  ε, S → ε    q_loop    ε           $
    18  ε, $ → ε    q_accept  ε           ε
  acepta en q_accept (configuraciones exploradas: 33)
Miren solo las filas donde el estado es q_loop, y en cada una junten lo ya leído con la pila sin la marca:
| Fila | Ya leído | Pila sin $ |
Juntos |
|---|---|---|---|
| 2 | |||
| 6 | |||
| 7 | |||
| 8 | |||
| 9 | |||
| 13 | |||
| 14 | |||
| 15 | |||
| 16 | |||
| 17 |
La última columna, sin repeticiones, es la derivación por la izquierda del principio de la sección: . Cuando la máquina reemplaza, la columna avanza un paso de la derivación. Cuando compara, un terminal pasa de la pila a lo ya leído y la columna no cambia.
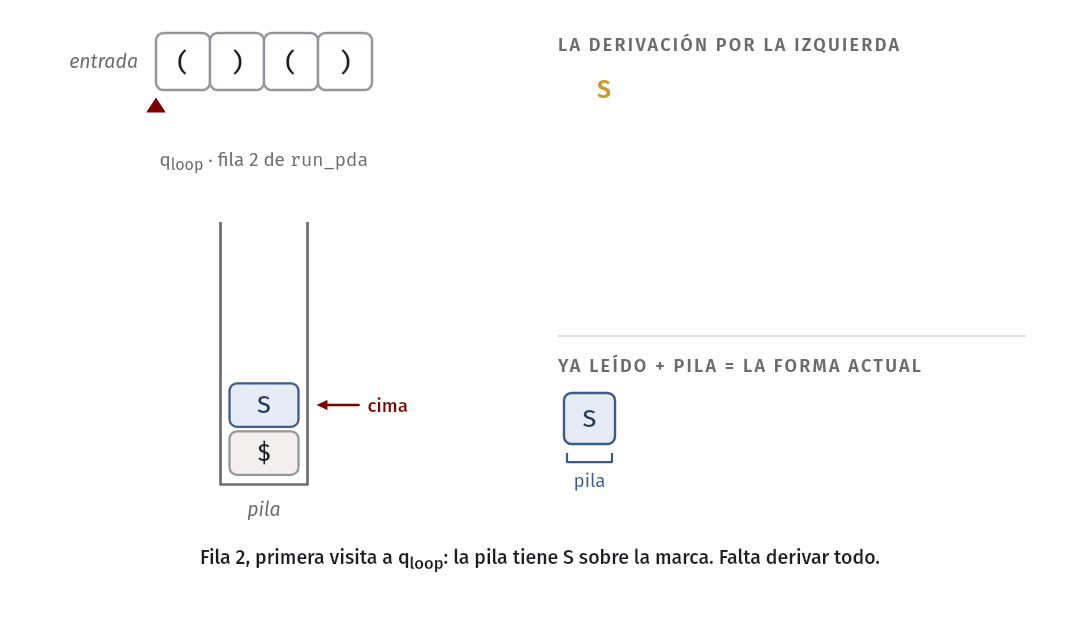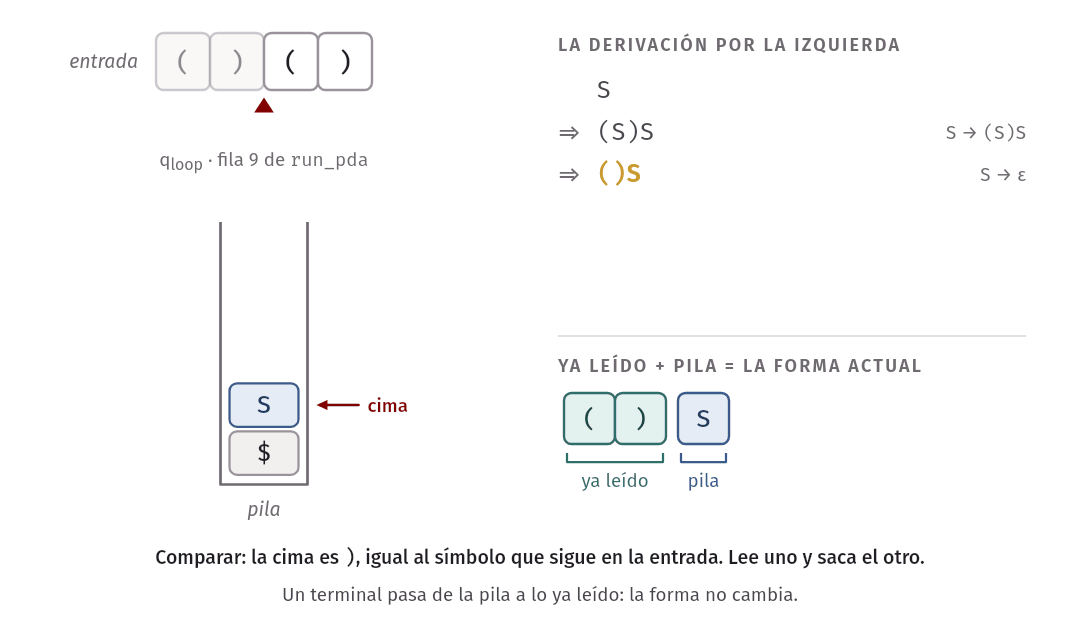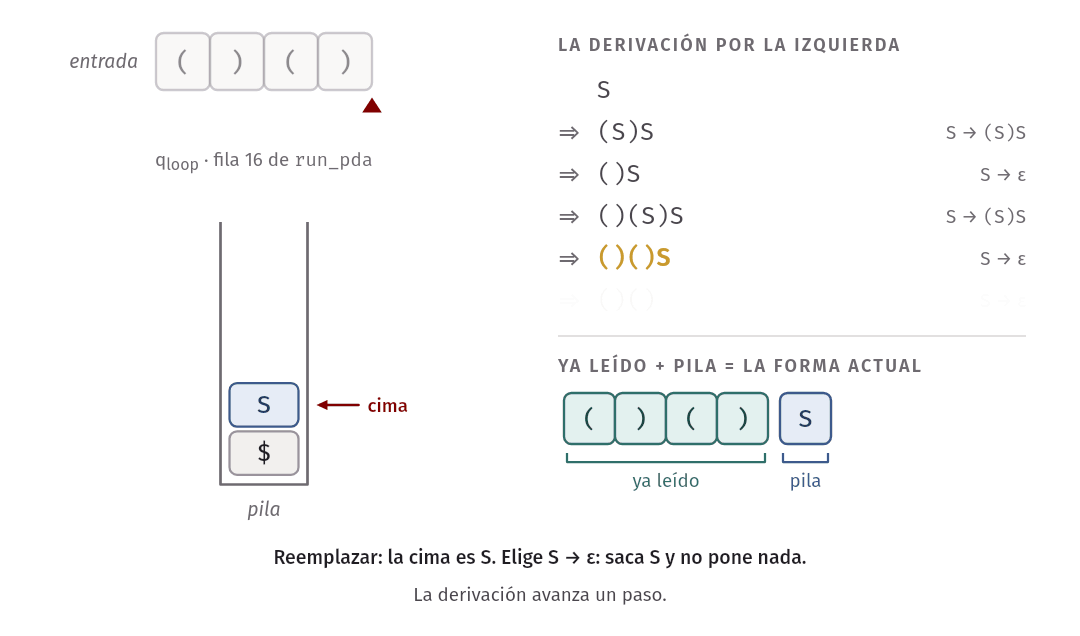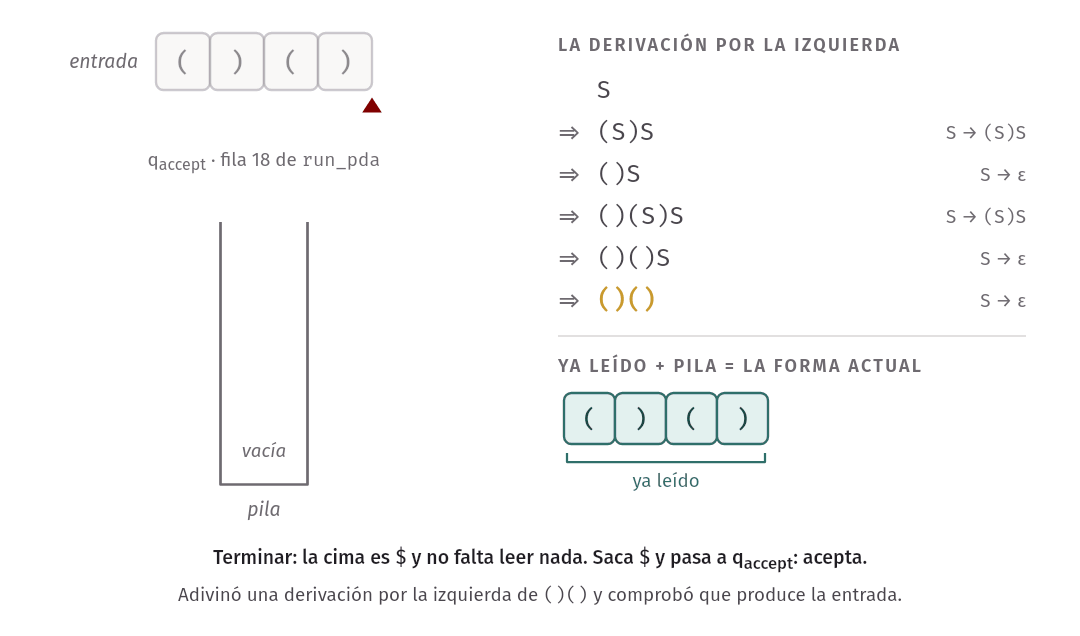
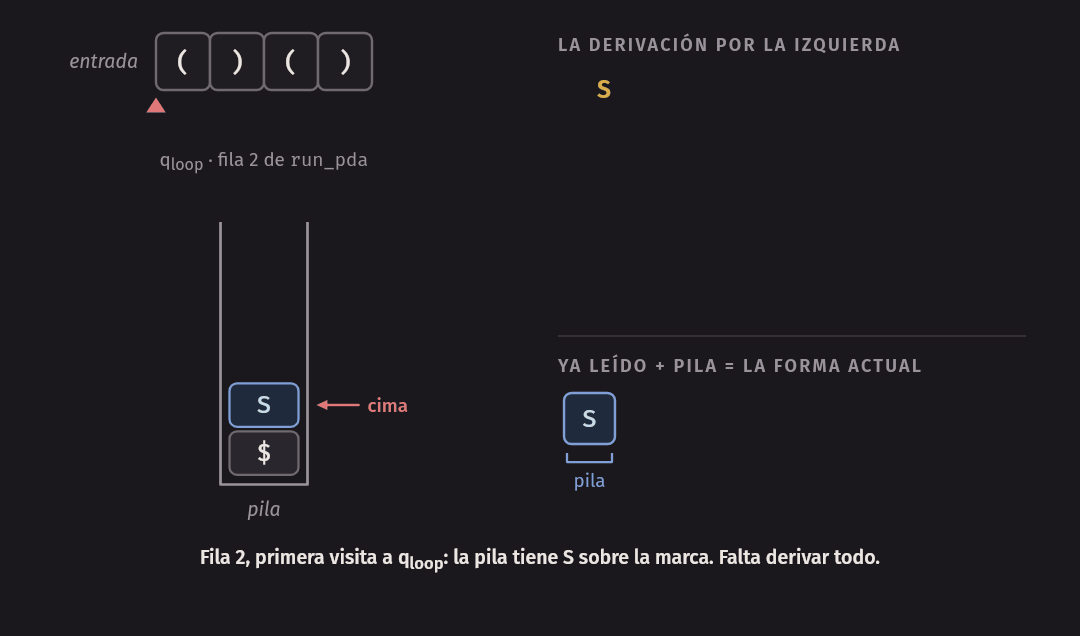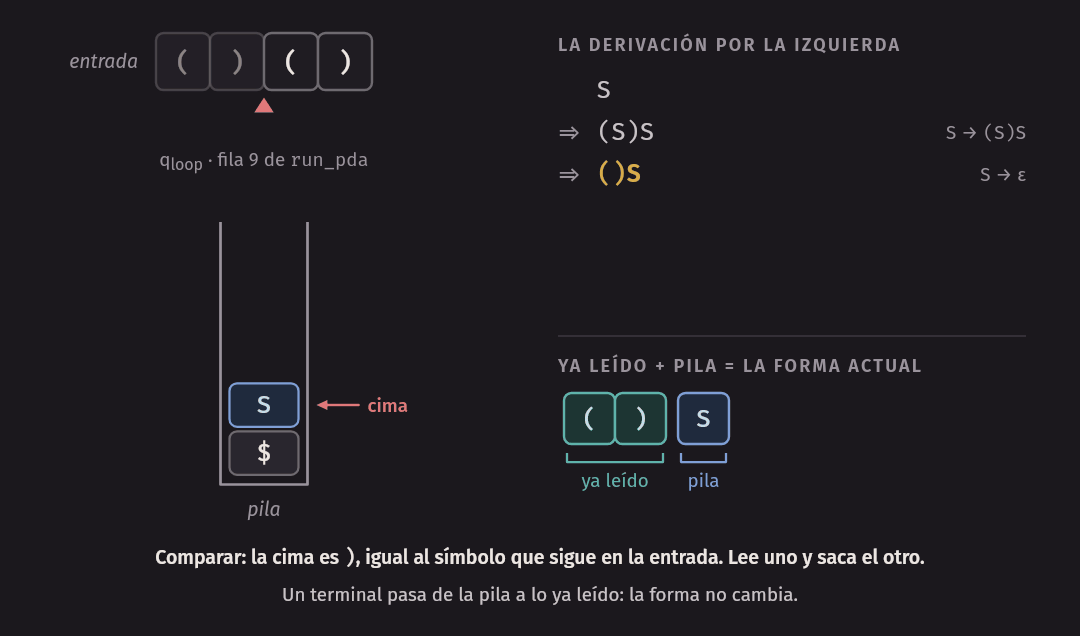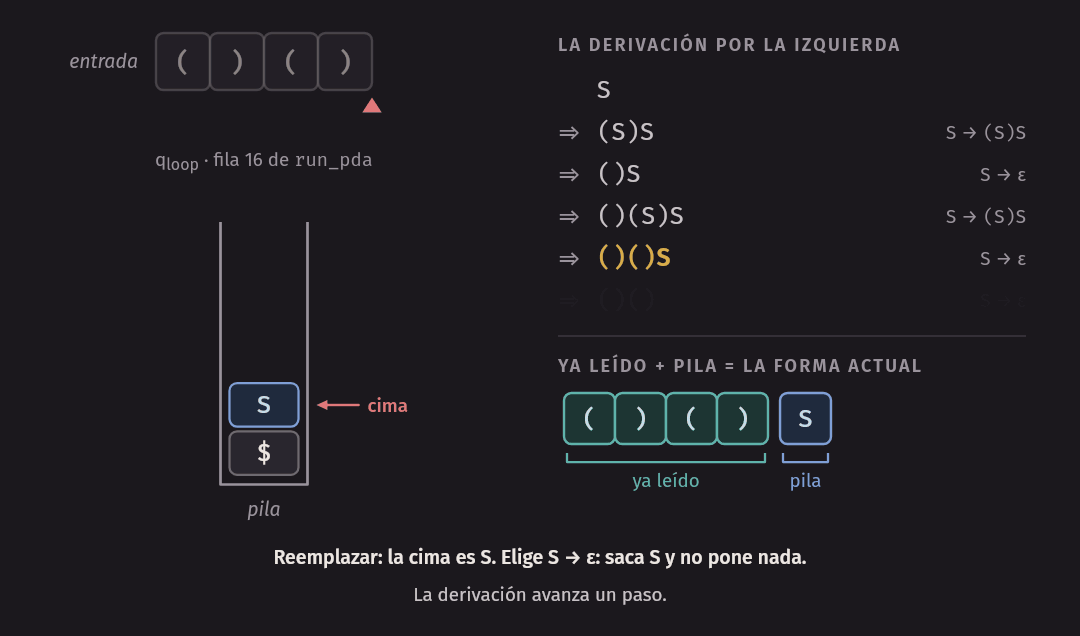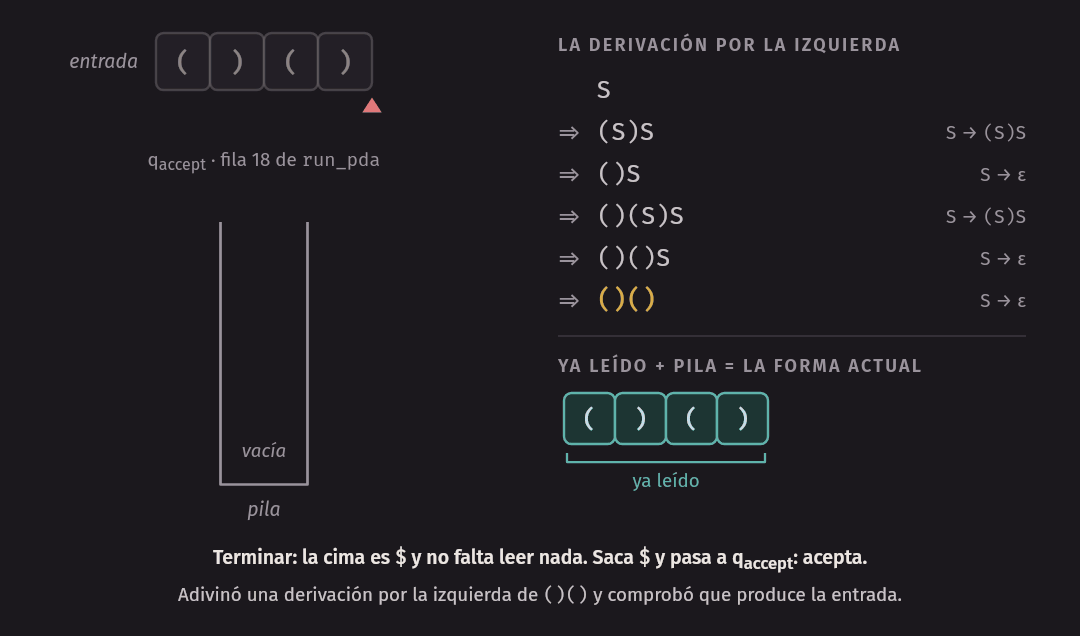
Por qué funciona
Hay que demostrar , en las dos direcciones. Las dos son inducciones, y las dos dicen lo mismo que la tabla: lo leído seguido de la pila es siempre una cadena que la gramática deriva.
Usaremos dos hechos sobre derivaciones que se ven en el árbol de derivación de la semana 5. Primero: si , entonces tiene una derivación por la izquierda. Segundo: los terminales no se reemplazan nunca, así que si con , entonces y con los mismos pasos.
En lo que sigue, , y son cadenas de variables y terminales, es decir, de , y es cualquier contenido de pila.
Afirmación 1 (lo que la gramática deriva, el PDA lo consume). Si tiene una derivación por la izquierda de pasos hasta una cadena de terminales , entonces para toda y toda :
En palabras: con en la cima, el PDA puede leer y dejar la pila como estaba debajo de .
Demostración. Por inducción sobre .
Caso base: . Entonces , que es una cadena de terminales. El PDA usa veces las transiciones de comparar: cada una lee un símbolo de y saca el mismo símbolo de la cima.
Paso inductivo: supongamos la afirmación para , y sea una derivación por la izquierda de pasos. El primer paso reemplaza la variable de más a la izquierda: con , y , donde es una regla. Por el segundo hecho, y deriva por la izquierda en pasos. Entonces el PDA puede hacer esto:
El segundo renglón son las transiciones del punto 2 de la construcción: una sola si tiene cero o un símbolo, y pasando por los estados intermedios de la regla si tiene más. ∎
Afirmación 2 (lo que el PDA consume, la gramática lo deriva). Si
entonces .
Demostración. Primero, qué puede hacer desde . Tiene cuatro tipos de transiciones. Las
de comparar y las de reemplazar con vuelven a en un paso. Las de reemplazar con
pasan a ; cada estado intermedio tiene una sola transición, que no lee ni saca nada y por
eso siempre se puede usar, así que la máquina recorre y vuelve a con
en lugar de . Y la de terminar saca $ y sale a , de donde no hay
vuelta. Llamemos tramo a cada trozo de ejecución que va de a la siguiente vez en
. Un tramo es una comparación o un reemplazo completo. Como $ se pone una sola vez y solo se
saca al salir, en la pila siempre tiene la forma con
.
Ahora, inducción sobre la cantidad de tramos de la ejecución.
Caso base: cero tramos. No se leyó nada y la pila no cambió: y . Y en cero pasos.
Paso inductivo: supongamos la afirmación para ejecuciones de tramos, y tomemos una de . Antes del último tramo se había leído y la pila era , y por hipótesis . El último tramo es de uno de dos tipos.
- Comparación con un terminal : entonces y . Luego , y es la hipótesis.
- Reemplazo con una regla : entonces , y . Luego : un paso más de derivación. ∎
Demostración del teorema. Sea .
Si , entonces acepta . Por el primer hecho, deriva por la izquierda. La afirmación 1, con , y , da el tramo central de esta ejecución:
Si acepta , entonces . Una ejecución que acepta termina en , el único
estado de aceptación, con toda la entrada leída. Sus dos primeros pasos son obligados y la dejan en
. A solo se entra desde
sacando $, y como no tiene transiciones, en ese momento ya no faltaba leer nada. Además,
si $ está en la cima, encima de él no hay nada. Así que la ejecución pasó por
, y la afirmación 2 con , y
da . ∎
test_convert comprueba el teorema con siete gramáticas: para cada una construye el PDA y compara, cadena por
cadena hasta cierta longitud, lo que el PDA acepta con lo que la gramática genera.
Un PDA que no se deja simular
La gramática de expresiones sin ambigüedad de la semana 5 está en machines/expr.cfg:
Su PDA tiene 10 estados. Con una cadena del lenguaje, la búsqueda encuentra la ejecución. Con una que no lo es, pasa otra cosa:
$ build/cfg_to_pda machines/expr.cfg > build/expr.pda
$ build/run_pda --limite 5000 build/expr.pda 'a+a' 'a+'
w = a+a
  paso  transición  estado    falta leer  pila
     0              q_start   a+a         ε
     1  ε, ε → $    q_begin   a+a         $
     2  ε, ε → E    q_loop    a+a         E$
     3  ε, E → T    r1_1      a+a         T$
     4  ε, ε → +    r1_2      a+a         +T$
     5  ε, ε → E    q_loop    a+a         E+T$
     6  ε, E → T    q_loop    a+a         T+T$
     7  ε, T → F    q_loop    a+a         F+T$
     8  ε, F → a    q_loop    a+a         a+T$
     9  a, a → ε    q_loop    +a          +T$
    10  +, + → ε    q_loop    a           T$
    11  ε, T → F    q_loop    a           F$
    12  ε, F → a    q_loop    a           a$
    13  a, a → ε    q_loop    ε           $
    14  ε, $ → ε    q_accept  ε           ε
  acepta en q_accept (configuraciones exploradas: 107)
w = a+
  límite: más de 5000 configuraciones, sin aceptar
La cadena a+ no es una expresión, y aun así el programa no puede decir “rechaza”. La culpa es de la regla
, que es recursiva por la izquierda: su lado derecho empieza con la misma variable. Las filas 2
a 5 muestran lo que eso le hace al PDA: sin leer nada, la pila pasó de E$ a E+T$. La cima vuelve a ser ,
y nada impide repetirlo: E+T+T$, E+T+T+T$, y así sin fin. Es un ciclo de transiciones que
hace crecer la pila, y las configuraciones alcanzables son infinitas.
El teorema no se resiente: habla de si existe una ejecución de aceptación, y para a+ no existe. Lo que
falla es nuestro método para comprobarlo, la búsqueda exhaustiva. La construcción produce un PDA correcto,
pero no un buen algoritmo. Los parsers reales resuelven esto de otra manera, y es el tema de la sección opcional
del final.
De PDA a gramática
La otra mitad del teorema va en sentido contrario.
Teorema. Para todo PDA existe una gramática libre de contexto con .
Esta dirección es más difícil, porque hay que sacar una gramática de una máquina que puede hacer cosas muy desordenadas con su pila. En clase se ve la idea y un ejemplo. La demostración completa está al final de la sección, para leerla con calma.
La idea: las variables A_pq
Miren la altura de la pila durante una ejecución, como un perfil de montaña. En la de sube,
sube, sube, baja, baja, baja. En la de los paréntesis (())() sube y baja dos veces. En todos los casos, si
la ejecución empieza y termina con la pila vacía, el perfil empieza y termina en el suelo.
La gramática va a tener una variable por cada par de estados y , con este significado:
Por el lema del fondo, “con la pila vacía” se puede leer también como “dejando la pila como estaba, sin tocar lo que había debajo”: una ejecución que va de vacía a vacía se puede repetir encima de cualquier pila.
¿Qué reglas necesita ? Tomemos una cadena que lleva de a de pila vacía a pila vacía, y miremos el perfil. Hay solo dos formas posibles.
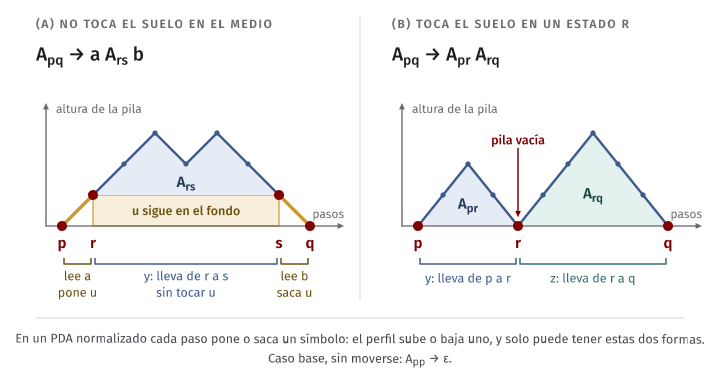
- (a) La pila no se vacía en el medio. Entonces el símbolo que se puso en el primer paso se queda en el fondo todo el tiempo, y es el que se saca en el último paso. Si el primer paso lee y va a un estado , y el último lee y viene de un estado , lo que pasa en el medio lleva de a sin tocar ese símbolo del fondo: es una cadena de . La regla es .
- (b) La pila se vacía en algún momento intermedio, en un estado . Entonces se parte en dos trozos: el primero lleva de a y el segundo de a , los dos de pila vacía a pila vacía. La regla es .
Y un caso base: sin hacer nada, la máquina va de a . La regla es .
Idea clave. La variable resume todo lo que el PDA puede hacer entre y dejando la pila como la encontró. La regla empareja el paso que pone un símbolo con el paso que lo saca: es el mismo emparejamiento que hace entre un cero y su uno.
Primero, ordenar el PDA
El argumento del perfil necesita que la máquina sea ordenada en tres sentidos. Diremos que un PDA está normalizado si:
- tiene un solo estado de aceptación, ;
- vacía la pila antes de aceptar: siempre que está en , la pila está vacía;
- cada transición pone un símbolo o saca un símbolo, pero no las dos cosas ni ninguna de las dos.
Con 1 y 2, aceptar es “ir de con la pila vacía a con la pila vacía”, que es justo lo que describe una variable . Con 3, cada paso sube o baja la altura en exactamente uno, y el perfil es una línea que nunca queda plana ni cambia un símbolo por otro a la misma altura.
Todo PDA se puede normalizar sin cambiar su lenguaje.
- Para 1 y 2. Se agrega un estado inicial nuevo que pone una marca de fondo nueva, , que no está en , y pasa al estado inicial viejo. Se agregan un estado y el nuevo . Desde cada estado de aceptación viejo hay una transición a . En , por cada símbolo de , una transición a sí mismo: vacía la pila. Y de a , la transición . El único estado de aceptación es el nuevo.
- Para 3. Una transición que saca y pone se cambia por dos, con un estado intermedio nuevo: la primera lee lo que leía la original y saca , la segunda pone . Una transición que no saca ni pone se cambia por dos: la primera lee y pone un símbolo de relleno, la segunda lo saca.
Por qué no cambia el lenguaje. La máquina vieja nunca ve la marca , porque no está en su alfabeto: no puede sacarla, y todo lo que hace lo hace encima de ella, igual que antes (lema del fondo). Si la vieja acepta , la nueva hace lo mismo, salta a , vacía y acepta. Al revés, la nueva solo llega a pasando por , al que solo se entra desde un estado de aceptación viejo; y como y no leen, en ese momento la entrada ya estaba leída, así que la vieja también aceptaba. Al llegar a se acaba de sacar , que estaba en el fondo: la pila está vacía. Las transiciones partidas en dos hacen lo mismo que la original, porque al estado intermedio solo se entra por la primera mitad y solo se sale por la segunda.
El programa normalize_pda hace exactamente esto, con @ como marca y % como relleno. El autómata de
machines/zeros_ones.pda, de 4 estados, queda con 9. Para el ejemplo de clase usaremos uno normalizado a
mano, que es más pequeño.
Un ejemplo pequeño
El archivo machines/zeros_ones_norm.pda es el autómata de con dos cambios:
ya no es de aceptación, y hay una transición más, de a , para aceptar la cadena vacía.
| Estado | Lee, saca pone | Destino | Tipo |
|---|---|---|---|
| pone | |||
| pone | |||
| saca | |||
| saca | |||
| saca | |||
| saca |
Está normalizado: un solo estado de aceptación, ; a solo se entra sacando $, que es el fondo; y
cada transición pone o saca. La variable inicial de la gramática será , que escribimos .
Las reglas del tipo salen de emparejar cada transición que pone un símbolo con cada transición que saca ese mismo símbolo.
- El símbolo
$lo pone la transición de a , sin leer. Lo sacan dos: la de a y la de a , sin leer. Con la primera, , , , y : la regla es . Con la segunda, : la regla es . - El símbolo lo pone la transición de a , leyendo . Lo sacan dos: la de a y la de a , las dos leyendo . Dan y .
Son cuatro reglas. A eso se suman las del tipo , una por cada terna de
estados, y las 4 del tipo : 72 en total, con variables. El programa
pda_to_cfg construye la gramática y quita las variables que no generan nada o que no se alcanzan desde la
inicial:
$ build/pda_to_cfg machines/zeros_ones_norm.pda
# Gramática del PDA machines/zeros_ones_norm.pda.
# La construcción da 16 variables y 72 reglas.
# Sirven 6 variables y 16 reglas.
variables: A(q0,q0) A(q0,q3) A(q1,q1) A(q1,q2) A(q2,q2) A(q3,q3)
terminals: 0 1
start: A(q0,q3)
rules:
A(q0,q0) -> A(q0,q0) A(q0,q0) | eps
A(q0,q3) -> A(q1,q1) | A(q1,q2) | A(q0,q0) A(q0,q3) | A(q0,q3) A(q3,q3)
A(q1,q1) -> A(q1,q1) A(q1,q1) | eps
A(q1,q2) -> 0 A(q1,q1) 1 | 0 A(q1,q2) 1 | A(q1,q1) A(q1,q2) | A(q1,q2) A(q2,q2)
A(q2,q2) -> A(q2,q2) A(q2,q2) | eps
A(q3,q3) -> A(q3,q3) A(q3,q3) | eps
Las cuatro reglas que calculamos a mano están ahí. La gramática es fea, pero se puede leer. Las variables , , y solo generan : ir de un estado a sí mismo sin tocar la pila, en este autómata, solo se logra sin moverse. Reemplazándolas por y borrando las reglas que quedan como , queda
que es la gramática de de siempre, con otro nombre. Las reglas dicen lo que el
autómata hace: son las maneras de ir de a dejando la pila igual, y cada una empieza
poniendo un y termina sacándolo con un . Para comprobar que la gramática completa
genera lo que debe, se la damos a cfg_strings:
$ build/pda_to_cfg machines/zeros_ones_norm.pda > build/z.cfg
$ build/cfg_strings build/z.cfg 8
5 cadenas de longitud a lo sumo 8:
  ε 01 0011 000111 00001111
La construcción es correcta pero derrochadora. Para el autómata de los palíndromos, normalizado con
normalize_pda, da 81 variables y 749 reglas, de las que sirven 14 y 35. Nadie escribe gramáticas así: el
valor de la construcción es que existe, y con ella el teorema.
La demostración, completa
Qué se construye. Sea un PDA normalizado. La gramática tiene las variables , los terminales , la variable inicial y estas reglas:
- Para cada , cada y cada : si y , la regla .
- Para cada : la regla .
- Para cada : la regla .
Por qué genera . Diremos que una cadena lleva de a con la pila vacía si . Hay que demostrar que genera si y solo si lleva de a con la pila vacía. Son dos afirmaciones.
Afirmación 1. Si , entonces lleva de a con la pila vacía.
Demostración. Por inducción sobre la cantidad de pasos de la derivación.
Caso base: un paso. La regla usada no tiene variables a la derecha, así que es . Entonces y , y en cero pasos.
Paso inductivo: supongamos la afirmación para las derivaciones de a lo sumo pasos, con , y sea una de . Su primer paso usa una regla del tipo 1 o del tipo 2.
- Tipo 1: . Entonces , donde en pasos. Por hipótesis, . Por el lema del fondo, con y : . Y la regla existe porque tiene las transiciones y . Juntando:
- Tipo 2: . Entonces con y , cada una en a lo sumo pasos, porque lo que deriva cada variable no depende de la otra. Por hipótesis, lleva de a y lleva de a , con la pila vacía. Por el lema del fondo aplicado a la primera, con detrás: . ∎
Afirmación 2. Si lleva de a con la pila vacía, entonces .
Demostración. Por inducción sobre la cantidad de pasos de la ejecución .
Caso base: cero pasos. Entonces y , y tiene la regla .
Paso inductivo: supongamos la afirmación para las ejecuciones de a lo sumo pasos, y sea una de , con y . Hay dos casos, según la pila de las configuraciones intermedias .
Caso (b): alguna configuración intermedia tiene la pila vacía. Sea su estado, lo que se leyó hasta ahí y lo que falta, de modo que y . La segunda parte, , dice que lleva de a con la pila vacía, en a lo sumo pasos. La primera parte es ; como sus pasos no leen nada de , quitando del final de cada configuración queda , también de a lo sumo pasos. Por hipótesis, y . Con la regla del tipo 2: .
Caso (a): todas las configuraciones intermedias tienen la pila no vacía. Aquí se usa la condición 3: cada paso pone un símbolo o saca uno.
- El primer paso sale de la pila vacía, así que no puede sacar: pone un símbolo . Sea lo que lee y el estado al que va: , y tiene la pila .
- Con una sola transición no se va de la pila vacía a la pila vacía, así que y es una configuración intermedia distinta de la última.
- Durante ese símbolo no se mueve del fondo. Un paso solo cambia la cima. Para sacar el símbolo del fondo, tendría que ser el único de la pila, y al sacarlo la pila quedaría vacía en una configuración intermedia, cosa que en este caso no pasa.
- El último paso va de , con la pila no vacía, a , con la pila vacía: saca, y lo que saca es el único símbolo que quedaba, que es . Sea lo que lee y el estado del que sale: , y .
Entonces tiene la regla . Además , donde es lo que se lee entre y , y la parte central de la ejecución es
con pasos y con quieto en el fondo. Quitemos de cada una de sus configuraciones la del final de la entrada y la del fondo de la pila. Lo que queda sigue siendo una ejecución: ningún paso lee la , y ningún paso saca la , así que cada paso usa su transición igual que antes. Es decir, en pasos. Por hipótesis, , y entonces . ∎
Demostración del teorema. Dado un PDA cualquiera, se lo normaliza. Por las condiciones 1 y 2, el PDA normalizado acepta si y solo si : acepta solo en , y ahí la pila está vacía. Por las dos afirmaciones, eso pasa si y solo si , es decir, si y solo si . ∎
Dónde se usó cada condición: la 1 y la 2, en la última línea, para que aceptar sea “de pila vacía a pila vacía”. La 3, en el caso (a), para saber que el primer paso pone, el último saca, y lo que se saca es lo que se puso. Sin la 3 habría transiciones que reemplazan la cima sin cambiar la altura, y el símbolo del fondo podría cambiar por el camino.
test_convert comprueba el teorema con los ocho autómatas de machines/: normaliza cada uno, verifica que el
normalizado acepta lo mismo y con la pila vacía, construye la gramática, y compara lo que genera con lo que el
autómata acepta.
Lo que dice la equivalencia
Juntando las dos construcciones:
Teorema. Un lenguaje es libre de contexto si y solo si algún autómata de pila lo reconoce.
Es el análogo del teorema de Kleene de la semana 3. Allá, las expresiones regulares y los autómatas finitos resultaron dos maneras de describir la misma clase. Aquí, las gramáticas y los autómatas de pila. Y como allá, tener las dos caras sirve para elegir: algunas propiedades se demuestran más fácil con gramáticas y otras con autómatas. En la sesión B usaremos las dos.
Una consecuencia inmediata:
Corolario. Todo lenguaje regular es libre de contexto.
Demostración. Un autómata finito es un PDA que no usa la pila. Dado un DFA , el PDA con los mismos estados, , y para cada estado y cada símbolo , pasa por los mismos estados que el DFA con cada cadena, y acepta las mismas. ∎
El archivo machines/even_ones.pda es el DFA de la paridad de la semana 1 escrito así, con el campo stack:
vacío:
$ build/run_pda machines/even_ones.pda 0110
w = 0110
  paso  transición  estado  falta leer  pila
     0              par     0110        ε
     1  0, ε → ε    par     110         ε
     2  1, ε → ε    impar   10          ε
     3  1, ε → ε    par     0           ε
     4  0, ε → ε    par     ε           ε
  acepta en par (configuraciones exploradas: 5)
La semana 5 dio otra demostración del mismo hecho, con gramáticas: de un DFA sale una gramática con una variable por estado. La inclusión es estricta, porque es libre de contexto y no es regular.
El PDA determinista reconoce menos
En la semana 2, el no determinismo resultó una comodidad: todo NFA tiene un DFA equivalente, aunque sea exponencialmente más grande. Con los autómatas de pila la historia es distinta.
Un PDA es determinista si en ninguna configuración tiene más de una transición que pueda usar. En términos de : cada valor tiene a lo sumo un elemento, y para cada estado , cada símbolo y cada , a lo sumo uno de los cuatro valores
no es vacío. Son las cuatro maneras de moverse cuando el siguiente símbolo es y la cima es .
El autómata de es determinista: en , por ejemplo, con un por leer solo puede poner, y con un solo puede sacar. El de los palíndromos no lo es: en no son vacíos , seguir guardando, y , saltar al medio.
Teorema (sin demostración). Ningún PDA determinista reconoce .
La demostración es larga y no la haremos. La intuición es la que ya vimos: para comparar las dos mitades hay que empezar a sacar justo en el medio, y nada en la entrada dice dónde está. Una máquina determinista tendría que decidirlo mirando solo lo leído hasta el momento. Si después de decide que ahí terminó un palíndromo y vacía la pila para comprobarlo, perdió lo que necesitaba para seguir con , que también es un palíndromo. Si no lo comprueba, no puede aceptar . Esto es solo una intuición: que ninguna máquina determinista encuentra una salida es lo que el teorema afirma.
Con una señal en el medio, el problema desaparece: sí tiene un PDA determinista, que guarda hasta ver el y después saca.
Idea clave. En los autómatas finitos, el no determinismo no agrega poder: NFA y DFA reconocen los mismos lenguajes. En los autómatas de pila, sí: hay lenguajes libres de contexto que ningún PDA determinista reconoce. Por eso la definición de PDA es no determinista desde el principio.
Los lenguajes que sí tienen un PDA determinista se llaman libres de contexto deterministas. Son una clase intermedia, estrictamente entre los regulares y los libres de contexto, y son los que importan en la práctica: la sintaxis de los lenguajes de programación se diseña para caer ahí, porque un lenguaje que tiene un PDA determinista se puede reconocer en tiempo lineal, sin búsqueda. La sección opcional del final muestra uno.
Un lenguaje que pide comparar tres cantidades
Hasta aquí todo fueron construcciones. Ahora toca el límite. El candidato es el lenguaje más simple que compara tres cosas en lugar de dos:
Antes de demostrar que no es libre de contexto, vale la pena intentar un PDA y ver dónde se rompe. El plan
natural: guardar las , sacarlas con las , y después… después la pila está vacía, y
las no tienen con qué compararse. El archivo machines/anbn_cm.pda es ese intento: llega hasta
las y las deja pasar.
$ build/run_pda machines/anbn_cm.pda aabbcc aabbc
w = aabbcc
  paso  transición  estado  falta leer  pila
     0              q0      aabbcc      ε
     1  ε, ε → $    q1      aabbcc      $
     2  a, ε → a    q1      abbcc       a$
     3  a, ε → a    q1      bbcc        aa$
     4  ε, ε → ε    q2      bbcc        aa$
     5  b, a → ε    q2      bcc         a$
     6  b, a → ε    q2      cc          $
     7  ε, $ → ε    q3      cc          ε
     8  c, ε → ε    q3      c           ε
     9  c, ε → ε    q3      ε           ε
  acepta en q3 (configuraciones exploradas: 13)
w = aabbc
  paso  transición  estado  falta leer  pila
     0              q0      aabbc       ε
     1  ε, ε → $    q1      aabbc       $
     2  a, ε → a    q1      abbc        a$
     3  a, ε → a    q1      bbc         aa$
     4  ε, ε → ε    q2      bbc         aa$
     5  b, a → ε    q2      bc          a$
     6  b, a → ε    q2      c           $
     7  ε, $ → ε    q3      c           ε
     8  c, ε → ε    q3      ε           ε
  acepta en q3 (configuraciones exploradas: 12)
Acepta , que está bien, y también , que no está en . En la fila 7 de las dos ejecuciones la pila está vacía y el estado es el mismo: la máquina ya no sabe si hubo dos o doscientas. Lo que este autómata reconoce es , un lenguaje más grande.
Se pueden probar variantes. Guardar dos símbolos por cada , para que alcancen para las y las : pero entonces lo que se comprueba es que , y pasa. Guardar las y, al sacarlas con las , anotar en otro lado cuántas eran: no hay otro lado, el estado es finito. Todas las variantes chocan con lo mismo: para comparar hay que sacar, y lo que se saca se pierde.
Que varios intentos fallen no demuestra nada. Podría existir un PDA ingenioso que no se nos ocurrió, o una gramática. Para descartarlos a todos de una vez hace falta una propiedad que todos los lenguajes libres de contexto tengan y no. Es el mismo plan que en la semana 4.
El lema de bombeo para lenguajes libres de contexto
La idea: un árbol muy alto repite una variable
En la semana 4, el lema de bombeo de los regulares salía de un conteo: una cadena más larga que la cantidad de estados obliga al DFA a repetir un estado, y el tramo entre las dos visitas se puede repetir. Aquí el conteo es sobre el árbol de derivación, y lo que se repite es una variable.
Tomemos una gramática y una cadena muy larga de su lenguaje. Cada nodo del árbol tiene pocos hijos, a lo sumo tantos como símbolos tiene el lado derecho más largo de una regla. Un árbol con pocos hijos por nodo y muchísimas hojas tiene que ser alto. Y en un camino de la raíz a una hoja más largo que la cantidad de variables, alguna variable aparece dos veces.
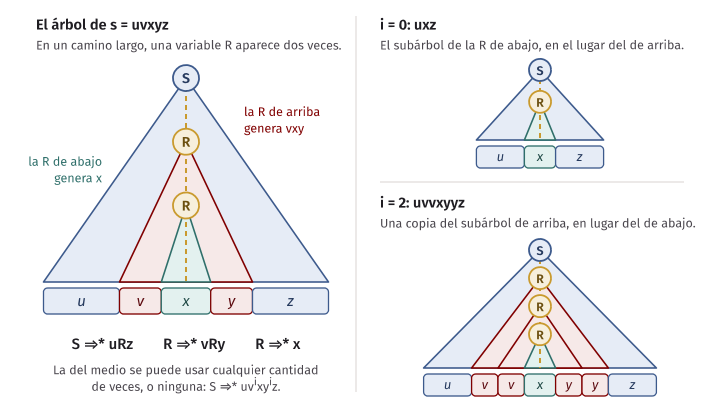
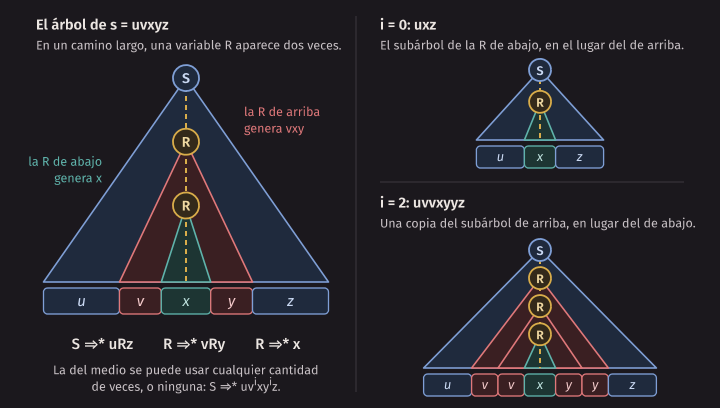
La de arriba genera un trozo de , que llamamos , y dentro de él la de abajo genera . En términos de derivaciones, el árbol dice tres cosas:
La del medio es la importante: de se llega otra vez a , con a la izquierda y a la derecha. Nada obliga a usarla una sola vez. Usándola veces:
En el árbol, es cortar el subárbol de la de abajo y pegar en su lugar una copia del subárbol de la de arriba. Y con : , que es pegar el subárbol de abajo en el lugar del de arriba.
La diferencia con el lema de los regulares es que aquí se repiten dos trozos, e , y a la vez: la misma cantidad de veces cada uno. Es lo que hace una regla como , que crece por los dos lados.
El enunciado
Teorema (lema de bombeo para lenguajes libres de contexto). Si es un lenguaje libre de contexto, existe un número , la longitud de bombeo, tal que toda cadena con se puede dividir en cinco partes, , que cumplen:
- para todo ;
- ;
- .
La condición 2 dice que e no son las dos vacías; una de las dos sí puede serlo. La condición 3 dice que los dos trozos que se repiten están cerca uno del otro: caben, con lo que hay entre ellos, en una ventana de símbolos. No dice dónde está esa ventana dentro de : a diferencia del lema de los regulares, aquí no hay ninguna garantía de que esté al principio.
La demostración
Qué afirma y con qué técnica. Dada una gramática de , se da un valor explícito de y se demuestra que sirve. La técnica es el conteo sobre el árbol que acabamos de ver, más un cuidado: elegir el árbol más pequeño.
Sea una gramática libre de contexto cualquiera con . Sea el máximo entre 2 y la cantidad de símbolos del lado derecho más largo de una regla de . Definimos
Paso 1: un árbol bajo tiene pocas hojas. La altura de un árbol es la cantidad de aristas de su camino más largo de la raíz a una hoja. En un árbol de derivación de , cada nodo tiene a lo sumo hijos. Afirmamos que un árbol de derivación de altura genera una cadena de longitud a lo sumo . Por inducción sobre : con la raíz tiene a lo sumo hijos y todos son hojas. Un árbol de altura tiene una raíz con a lo sumo hijos, cada uno una hoja, que aporta a lo sumo un símbolo, o la raíz de un subárbol de altura a lo sumo , que por hipótesis genera a lo sumo símbolos: en total, a lo sumo .
En consecuencia, si , todo árbol de derivación de tiene altura al menos . Un árbol de altura o menos generaría a lo sumo símbolos, y porque .
Paso 2: elegir el árbol y encontrar la repetición. Sea con . Entre todos los árboles de derivación de , sea uno con la menor cantidad de nodos. Por el paso 1, tiene un camino de la raíz a una hoja con al menos aristas; tomemos el más largo. Ese camino tiene al menos nodos. El último es una hoja, un terminal o , y todos los demás son variables: al menos variables.
Miremos las variables más bajas del camino, las más cercanas a la hoja. Son nodos y solo hay variables distintas, así que dos de esos nodos tienen la misma variable, que llamamos . Como en el dibujo: la de arriba genera , la de abajo genera , y .
Paso 3: las tres condiciones.
Condición 1. Es el argumento de la sección anterior. Del árbol se leen , y , y combinándolas se deriva para todo .
Condición 2. Por contradicción. Si , entonces . Reemplacemos en el subárbol de la de arriba por el de la de abajo. El resultado es un árbol de derivación válido, porque en ese lugar sigue habiendo una con un subárbol de , y genera . Pero tiene menos nodos que , porque el subárbol de arriba contiene al de abajo y además, por lo menos, a la de arriba. Contradice que tenía la menor cantidad de nodos.
Condición 3. La de arriba es una de las variables más bajas del camino, así que desde ella hasta la hoja del camino hay a lo sumo aristas. Ese tramo es el camino más largo dentro del subárbol de la de arriba: si el subárbol tuviera uno más largo, pegándolo a continuación del tramo que va de la raíz a la de arriba saldría un camino en más largo que el que elegimos, que era el más largo. Entonces el subárbol de la de arriba tiene altura a lo sumo y, por el paso 1, genera a lo sumo símbolos. Lo que genera es . ∎
Tres observaciones sobre la demostración.
El valor de sale de la gramática. Para , el lado derecho más largo tiene 3 símbolos y hay una variable: y . Una gramática distinta para el mismo lenguaje da otro . Al usar el lema para demostrar que un lenguaje no es libre de contexto no se conoce ninguna gramática, justamente porque no existe, y por eso los argumentos tienen que servir para cualquier .
Ese no es el más chico que sirve. Es el que la demostración garantiza. Para alcanza con : toda cadena con se divide con el último cero, e el primer uno.
El árbol más pequeño hace falta. Sin esa elección, la condición 2 puede fallar: una gramática con reglas como y tiene árboles con caminos larguísimos que no agregan ningún símbolo, y la repetición encontrada podría tener . El árbol con menos nodos no tiene vueltas inútiles.
Error común. Leer el lema al revés. Dice que si un lenguaje es libre de contexto, entonces sus cadenas largas se pueden bombear. No dice que un lenguaje cuyas cadenas se pueden bombear sea libre de contexto: hay lenguajes que cumplen las tres condiciones y no lo son. El lema solo sirve para demostrar que un lenguaje no es libre de contexto.
Usar el lema: el juego
Para demostrar que un lenguaje no es libre de contexto se razona por contradicción: suponemos que lo es, y entonces el lema vale para con algún que no conocemos. Como en la semana 4, conviene pensarlo como un juego contra un adversario que defiende que sí es libre de contexto.
- El adversario elige . No sabemos cuál: el argumento debe servir para todos.
- Nosotros elegimos la cadena , con y . Puede depender de , y casi siempre depende.
- El adversario elige la división , con y . No sabemos cuál: el argumento debe servir para todas. Aquí está el análisis por casos.
- Nosotros elegimos el exponente , y ganamos si . Puede ser un distinto en cada caso.
Si ganamos siempre, la condición 1 del lema falla para esa , y no es libre de contexto.
Lo difícil es el paso 3. Con los regulares, la condición clavaba la parte repetida al principio de la cadena. Aquí la ventana puede estar en cualquier lugar, y dentro de ella e pueden caer de muchas maneras. La demostración tiene que cubrirlas todas, y la manera de no olvidar ninguna es clasificarlas con un criterio que no deje huecos.
En los tres ejemplos que siguen, las cadenas están formadas por bloques de un mismo símbolo. Un trozo o puede estar dentro de un solo bloque, y entonces es de un solo tipo de símbolo, o puede abarcar el borde entre dos bloques, y entonces tiene dos símbolos distintos. Esos dos casos se comportan muy distinto al bombear, y el segundo es el que se olvida.
El lenguaje aⁿbⁿcⁿ
Afirmación. no es libre de contexto.
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es libre de contexto, y sea su longitud de bombeo.
Nuestra cadena: . Está en y .
La división del adversario: cualquier con y . Elegimos en todos los casos, y mostramos que . Hay dos casos, que entre los dos cubren todas las divisiones.
Caso 1: e tienen, cada una, un solo tipo de símbolo (o son vacías; las dos no). Entonces sigue dentro del bloque de , y lo mismo : tiene todavía la forma , con los bloques en orden. Pero entre e tocan a lo sumo dos de los tres símbolos. Al pasar de a , la cantidad de al menos uno de los tres símbolos crece, porque , y la de al menos uno queda en . Las tres cantidades no pueden ser iguales, y .
Caso 2: o tiene dos símbolos distintos. Digamos que es ; con es igual. Como es un trozo de , sus símbolos están en orden: tiene una antes de una , o una antes de una . En , la segunda copia empieza después de que la primera terminó. Si con , entonces tiene una después de una . En general, tiene dos símbolos fuera de orden, no es de la forma , y .
En los dos casos , contra la condición 1 del lema. Luego no es libre de contexto. ∎
Error común. Olvidar el caso 2. La demostración incompleta dice ” e tocan a lo sumo dos de los tres símbolos, así que al bombear una cantidad queda atrás”, y eso supone sin decirlo que e son de un solo tipo. Si , bombear no “agrega una y una ” a sus bloques: mete una en medio de las . El resultado tampoco está en el lenguaje, pero por otra razón, y hay que decirla. Cada vez que escriban “la cantidad de tal símbolo crece”, pregúntense si antes mostraron que la cadena sigue ordenada.
En este ejemplo no usamos la condición 3, . Con ella, el caso 1 se puede decir de otro modo: entre la última y la primera hay símbolos , así que una ventana de longitud no puede tocar a la vez una y una . En los dos ejemplos siguientes la condición 3 es indispensable.
El lenguaje ww
Sea , las cadenas que son una mitad repetida: , , . Se parece mucho a los palíndromos , que sí son libres de contexto. La diferencia es el orden de la segunda mitad. Una pila devuelve lo guardado al revés, que es lo que piden los palíndromos y justo lo contrario de lo que pide .
Un intento que falla. La cadena más simple de que depende de es . Con ella perdemos el juego. El adversario divide así:
Cumple las condiciones: y si . Y para todo ,
que es con . El adversario puso e a los dos lados del del medio, y al bombear las dos mitades crecen juntas. Esto no dice que sea libre de contexto: dice que esta no sirve. La elección de la cadena es parte de la demostración.
Lo que falló es que los ceros de la primera mitad y los de la segunda estaban pegados, separados por un solo símbolo. Hay que alejarlos más de .
Afirmación. no es libre de contexto.
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es libre de contexto, y sea su longitud de bombeo.
Nuestra cadena: . Está en , con , y . Tiene cuatro bloques de longitud , que numeramos del 1 al 4. Los bloques 1 y 3 son de ceros y los bloques 2 y 4 de unos.
Antes de jugar, un lema que dice cuándo una cadena de cuatro bloques está en .
Lema (de los cuatro bloques). Sea con . Si , entonces y .
Demostración del lema. Sea . Llamemos cambio a una posición de una cadena donde un símbolo es distinto del anterior. La cadena tiene exactamente 3 cambios, uno en cada borde entre bloques. Por otro lado, empieza con el primer símbolo de , que es , y termina con el último, que es . Si tiene cambios, entonces tiene : los de cada copia, más uno en la unión, donde el final de la primera copia se encuentra con el inicial de la segunda. De sale . Una cadena que empieza con , termina con y tiene un solo cambio es con . Entonces , y como una cadena se parte en bloques de una sola manera, y . ∎
La división del adversario: cualquier con y .
Lo que da la condición 3. La ventana mide a lo sumo , y cada bloque mide . Para tocar dos bloques que no son vecinos, la ventana tendría que contener entero el bloque que hay entre ellos, y además un símbolo de cada lado: al menos símbolos. Así que toca un solo bloque, o dos bloques vecinos. Dos bloques del mismo símbolo, el 1 y el 3 o el 2 y el 4, nunca son vecinos. Llamemos pareja de un bloque al otro bloque del mismo símbolo. Entonces: si toca un bloque, no toca a su pareja.
Hay dos casos, que entre los dos cubren todas las divisiones.
Caso 1: e tienen, cada una, un solo tipo de símbolo (o son vacías; las dos no). Elegimos . Cada una está dentro de un bloque, y al duplicarla ese bloque crece. Entonces , donde cada exponente es o más, y al menos uno es mayor que porque . El bloque que creció tiene a su pareja intacta, de longitud , porque la ventana no la toca. Entonces o , y por el lema de los cuatro bloques, .
Caso 2: o tiene dos símbolos distintos, es decir, abarca el borde entre dos bloques vecinos. Aquí desordenaría la cadena, como en el ejemplo anterior. Elegimos : borrar no desordena. Digamos que es la que abarca el borde entre un bloque y el siguiente; con es igual. Entonces tiene al menos un símbolo de cada uno de esos dos bloques, y toda la ventana está dentro de ellos. Al borrar e :
- los dos bloques que la ventana no toca siguen midiendo ;
- cada uno de los dos bloques tocados pierde al menos un símbolo;
- ninguno de los dos queda vacío. Entre e se borran a lo sumo símbolos, repartidos entre los dos bloques con al menos uno de cada uno. Así que de cada bloque se borran a lo sumo .
Entonces con , donde los dos bloques tocados miden menos de y sus parejas miden . Otra vez o , y por el lema, .
En los dos casos hay un exponente que saca la cadena de , contra la condición 1. Luego no es libre de contexto. ∎
Dos comentarios. Primero, la condición 3 fue esencial: sin ella, el adversario podría poner en el bloque 1 e en el bloque 3 y hacer crecer los dos juntos, como hizo con la primera cadena. La cadena de cuatro bloques largos está elegida para que la ventana no llegue de un bloque a su pareja. Segundo, cada caso usó un exponente distinto, y por una razón: en el caso 1, mantiene los cuatro bloques y el lema se aplica directo; en el caso 2, produciría una cadena de seis bloques, de la que el lema no dice nada, y con se queda en cuatro.
El lenguaje aⁱbʲcᵏ con i ≤ j ≤ k
Sea . Está en toda cadena de , y muchas más: , , . Este ejemplo enseña algo que los anteriores no: a veces hay que bombear hacia abajo.
Un intento que falla. Con y siempre, como en el primer ejemplo, el adversario gana: pone e dentro de las . Al bombear hacia arriba hay más , y : la cadena sigue en el lenguaje. Las desigualdades de toleran que crezca lo de la derecha. Lo que no toleran es que disminuya.
Afirmación. no es libre de contexto.
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es libre de contexto, y sea su longitud de bombeo.
Nuestra cadena: . Está en , porque , y .
La división del adversario: cualquier con y . Tres casos, que cubren todas las divisiones: o alguna de las dos abarca un borde (caso 1), o ninguna lo hace, y entonces en no hay ninguna (caso 2) o hay alguna (caso 3).
Caso 1: o tiene dos símbolos distintos. Elegimos . Como en el primer ejemplo, tiene dos símbolos fuera de orden y no es de la forma . No está en .
En los casos 2 y 3, e tienen cada una un solo tipo de símbolo, así que bombear, hacia arriba o hacia abajo, solo cambia las longitudes de los bloques. La cadena que resulta sigue siendo de la forma , y está en solo si no tiene más que ni más que . Entre e tocan a lo sumo dos de los tres símbolos.
Caso 2: en no hay ninguna . Elegimos . En sigue habiendo símbolos , y se borró al menos una o al menos una . Si se borró alguna , quedan menos de : hay más que . Si no se borró ninguna , hay símbolos y menos de símbolos : hay más que . En cualquiera de los dos, .
Caso 3: en hay alguna . Elegimos . En hay más de símbolos . Como e tocan a lo sumo dos símbolos y uno es la , no tocan las o no tocan las . Si no tocan las , hay símbolos y más que . Si no tocan las , hay símbolos y más que , y eso tampoco puede pasar en : si las no son más que las , ni las más que las , las no son más que las . En cualquiera de los dos, .
En los tres casos hay un exponente que saca la cadena de . Luego no es libre de contexto. ∎
Esta demostración, tal como está escrita, no usó la condición 3. Con ella, el caso 3 se simplifica: una ventana de longitud que toca una no llega a ninguna .
El juego, jugado por la computadora
Para una cadena concreta y un concreto, las divisiones que el adversario puede elegir son una cantidad
finita, y un programa puede probarlas todas. El programa pump_demo lo hace para los ejemplos de esta sección,
con de 1 a 6: lista todas las divisiones con y , y cuenta cuántas salen del
lenguaje con , cuántas siguen dentro con pero salen con , y cuántas sobreviven, es
decir, siguen dentro con todos los exponentes de 0 a 4.
$ build/pump_demo
{ 0^n 1^n },  s = 0^p 1^p  (libre de contexto: tiene que haber divisiones que sobreviven)
   p   |s|  divisiones  fuera con i=2  solo con i=0  sobreviven
   1     2           4              4             0           0
   2     4          23             22             0           1
   3     6          73             70             0           3
   4     8         175            168             0           7
   5    10         355            342             0          13
   6    12         644            622             0          22
  una división que sobrevive con p = 6: u = 0, v = 0, x = 0000, y = 1, z = 11111

{ a^n b^n c^n },  s = a^p b^p c^p
   p   |s|  divisiones  fuera con i=2  solo con i=0  sobreviven
   1     3           6              6             0           0
   2     6          37             37             0           0
   3     9         121            121             0           0
   4    12         295            295             0           0
   5    15         605            605             0           0
   6    18        1106           1106             0           0

{ ww },  s = 0^p 1 0^p 1  (una mala elección)
   p   |s|  divisiones  fuera con i=2  solo con i=0  sobreviven
   1     4           8              8             0           0
   2     6          37             37             0           0
   3     8         105            104             0           1
   4    10         235            232             0           3
   5    12         455            448             0           7
   6    14         798            785             0          13
  una división que sobrevive con p = 6: u = 00, v = 0, x = 0001, y = 0, z = 000001

{ ww },  s = 0^p 1^p 0^p 1^p
   p   |s|  divisiones  fuera con i=2  solo con i=0  sobreviven
   1     4           8              8             0           0
   2     8          51             51             0           0
   3    12         169            169             0           0
   4    16         415            415             0           0
   5    20         855            855             0           0
   6    24        1568           1568             0           0

{ a^i b^j c^k : i ≤ j ≤ k },  s = a^p b^p c^p
   p   |s|  divisiones  fuera con i=2  solo con i=0  sobreviven
   1     3           6              4             2           0
   2     6          37             26            11           0
   3     9         121             88            33           0
   4    12         295            219            76           0
   5    15         605            456           149           0
   6    18        1106            843           263           0
La tabla cuenta lo mismo que las demostraciones.
- Con , que sí es libre de contexto, desde hay divisiones que sobreviven, como exige el lema. La que muestra el programa tiene una en los ceros y una en los unos.
- Con contra , las 1106 divisiones de caen con : los dos casos de la demostración usaban ese exponente.
- Con la mala elección para , desde hay divisiones que sobreviven. Una es la que encontramos a mano, con e a los lados del del medio; la que imprime el programa es otra del mismo estilo, con la más lejos.
- Con la buena elección para , no sobrevive ninguna. La tabla dice además que todas caen con : en el caso 2 de la demostración también habría servido bombear hacia arriba. Elegimos porque con cuatro bloques el argumento es más corto, no porque fuera la única opción.
- Con , la columna “solo con i=0” no es cero: 263 de las 1106 divisiones de siguen en el lenguaje al bombear hacia arriba, y solo se las derrota hacia abajo. Son las del caso 2.
El programa no demuestra nada sobre el lenguaje: prueba algunos , y la demostración tiene que valer para
todos. Sirve para lo contrario, para encontrar errores: si un análisis por casos olvida una división, o le
asigna el exponente equivocado, el programa la encuentra. test_pumping recorre así, división por división y
con de 1 a 7, los casos de las tres demostraciones de esta sección, cada uno con el exponente que la
demostración dice.
Propiedades de cierre
Con los regulares, las propiedades de cierre eran todas buenas noticias: unión, intersección, complemento, concatenación y estrella. Con los libres de contexto, tres se conservan y dos se pierden.
Unión, concatenación y estrella: sí
Las tres se demuestran con gramáticas, y son las construcciones para “unir gramáticas” de la semana 5.
Teorema. Si y son libres de contexto, también lo son , y .
Demostración. Por construcción. Sean y gramáticas de y . Primero se cambian los nombres de las variables para que y no tengan ninguna en común. Sea una variable nueva. En los tres casos la gramática nueva tiene todas las variables y todas las reglas de las originales, la variable inicial , y además:
| Lenguaje | Reglas nuevas |
|---|---|
| (aquí solo se usa ) |
Por qué funcionan. La clave es que las variables de solo aparecen en reglas de , y las de en las de : una vez que la derivación entra a , todo lo que salga de ahí es una derivación de .
- Unión. Toda derivación empieza con o con y sigue dentro de una sola gramática. Así que si y solo si o .
- Concatenación. Toda derivación empieza con . Lo que deriva y lo que deriva no se mezclan, así que la cadena final es con y . Y al revés, cualquier así se deriva.
- Estrella. Usando veces la regla y después se obtiene , y de ahí cualquier concatenación de cadenas de . Por inducción sobre la cantidad de usos de , no se obtiene nada más. ∎
Error común. Juntar las reglas de dos gramáticas sin cambiar los nombres. Si es , y es , , cada una genera una sola cadena: y . Mezcladas, la variable tiene las dos reglas, y la “unión” genera también y .
Intersección y complemento: no
Teorema. Los lenguajes libres de contexto no son cerrados bajo intersección ni bajo complemento.
Demostración. Con un contraejemplo. Sean
Los dos son libres de contexto. es lo que reconocía el intento fallido de machines/anbn_cm.pda, y es la
concatenación de con . es la concatenación de
con . Sus gramáticas están en machines/anbn_cm.cfg y machines/am_bncn.cfg:
Una cadena está en si tiene la forma con , por estar en , y con , por estar en . Entonces
que no es libre de contexto. La intersección de dos lenguajes libres de contexto puede no serlo.
Para el complemento, por contradicción. Si la clase fuera cerrada bajo complemento, como lo es bajo unión, también lo sería bajo intersección, por la ley de De Morgan:
Y acabamos de ver que no lo es. ∎
$ build/cfg_strings machines/anbn_cm.cfg 5
12 cadenas de longitud a lo sumo 5:
  ε c ab cc abc ccc aabb abcc cccc aabbc abccc ccccc
$ build/cfg_strings machines/am_bncn.cfg 5
12 cadenas de longitud a lo sumo 5:
  ε a aa bc aaa abc aaaa aabc bbcc aaaaa aaabc abbcc
Las únicas cadenas que están en las dos listas son y .
Vale la pena entender por qué la construcción del producto de la semana 1 no se puede repetir. Con dos DFA, la máquina producto llevaba un par de estados. Con dos PDA habría que llevar un par de estados y dos pilas, y un PDA tiene una sola. Es el mismo error común de la sesión A, visto desde otro lado: necesita la pila para comparar las con las , la necesita para las con las , y no hay manera de hacer las dos cosas con una. Una máquina con dos pilas es otro modelo, mucho más poderoso: es equivalente a la máquina de Turing de la semana próxima.
El argumento del complemento no dice cuál lenguaje libre de contexto tiene un complemento que no lo es. Un ejemplo concreto: el complemento de sí es libre de contexto (es el ejercicio 9), y su complemento es .
Intersección con un lenguaje regular: sí
Hay una versión débil de la intersección que sí se conserva, y es la que más se usa.
Teorema. Si es libre de contexto y es regular, entonces es libre de contexto.
Demostración. Por construcción: el producto de un PDA con un DFA. Ahora hay una sola pila, la del PDA, y el DFA solo agrega un estado.
Qué se construye. Sean un PDA de y un DFA de . El PDA producto tiene los estados , el mismo alfabeto de pila , el estado inicial y los estados de aceptación . Sus transiciones copian las de , y la segunda coordenada sigue al DFA:
- por cada transición de que lee un símbolo , , y cada : de a , con la misma etiqueta ;
- por cada transición de que no lee, , y cada : de a , con la etiqueta . El DFA no se mueve.
Por qué reconoce . Por inducción sobre la cantidad de pasos se comprueba que el producto llega a la configuración habiendo leído si y solo si llega a habiendo leído y además : cada paso del producto es un paso de , y el DFA avanza exactamente cuando se lee un símbolo. Entonces el producto acepta si y solo si alguna ejecución de con termina en y : si y solo si y . ∎
El uso principal de este teorema es simplificar un lenguaje antes de aplicarle el lema de bombeo.
Ejemplo. Sea el lenguaje de las cadenas sobre con la misma cantidad de , de y de , en cualquier orden. Aplicar el lema directamente es incómodo, porque las cadenas de no tienen forma. Pero es regular, y
Si fuera libre de contexto, también lo sería, por el teorema. No lo es, así que tampoco. Comparen
con el lenguaje de las cadenas con la misma cantidad de que de , que sí es libre de
contexto: su PDA está en machines/equal_ab.pda. Otra vez, dos cantidades sí y tres no.
El mapa hasta ahora
Con esto termina la parte 2 del curso. Tenemos dos clases de lenguajes, una dentro de la otra, y para cada frontera un lenguaje concreto que la cruza.
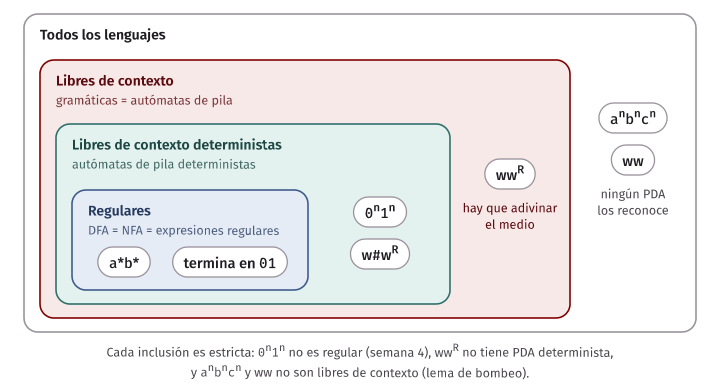
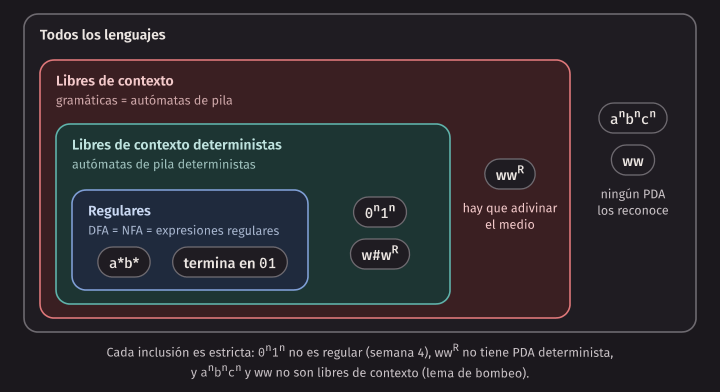
| Clase | Descripción | Máquina | Qué no puede | Lenguaje que lo muestra |
|---|---|---|---|---|
| Regulares | Expresión regular | DFA, NFA | Contar sin tope | |
| Libres de contexto | Gramática | PDA | Comparar tres cantidades; repetir en el mismo orden | , |
| Operación | Regulares | Libres de contexto |
|---|---|---|
| Unión, concatenación, estrella | sí | sí |
| Intersección | sí | no |
| Complemento | sí | no |
| Intersección con un regular | sí | sí |
| El no determinismo agrega poder | no | sí |
| Decidir si una cadena está | tiempo lineal, con el DFA | , con CYK |
Las dos clases tienen su lema de bombeo, y los dos dicen lo mismo en el fondo: una máquina con una cantidad finita de piezas, sean estados o variables, que procesa algo muy largo, tiene que repetir alguna, y lo que pasa entre las dos repeticiones se puede repetir.
Los dos lenguajes que quedaron fuera, y , no son difíciles en ningún sentido práctico: un programa de diez líneas los decide. Lo que les falta a nuestras máquinas es poder volver sobre lo que guardaron sin destruirlo. La semana próxima le damos eso a la máquina, y el modelo que resulta, la máquina de Turing, ya no se queda corto frente a ningún programa.
Cómo trabaja un parser real
Esta sección es opcional (✂️).
Un compilador tiene que resolver todos los días el problema de esta semana: dada una gramática y un texto,
decidir si el texto es del lenguaje y construir su árbol. No usa CYK, que cuesta y sería inaceptable
para un archivo de cien mil tokens. Tampoco usa la búsqueda de run_pda. Usa lo que la sección El PDA
determinista reconoce menos anunció: una gramática elegida para que un autómata de pila determinista la
reconozca, en tiempo lineal. El trabajo se hace en dos etapas, y las dos son temas de este curso.
El lexer: expresiones regulares
La primera etapa convierte los caracteres en tokens: números, nombres, operadores, paréntesis. Cada tipo de token se describe con una expresión regular, y reconocerlos es trabajo de un autómata finito, el de las semanas 1 a 3. Para las expresiones aritméticas alcanzan cinco:
| Token | Expresión regular |
|---|---|
| número | [0-9]+ |
| suma | \+ |
| producto | \* |
| paréntesis | \( y \) |
El lexer de expr.h es ese autómata escrito a mano, con dos estados: fuera de un número y dentro de un número.
Lee cada carácter una vez, salta los espacios y entrega la lista de tokens. La gramática ya no ve caracteres:
su alfabeto son los tokens. Por eso machines/expr.cfg tiene un solo terminal, , para “un
número”.
El parser: una función por variable
La segunda etapa es la gramática. Con la de la semana 5, que no es ambigua:
Un parser descendente recursivo tiene una función por variable. La función de mira el token que viene: si es un número, lo consume; si es un paréntesis que abre, lo consume, llama a la función de y exige un paréntesis que cierra. Nunca tiene que adivinar entre sus dos reglas, porque el siguiente token decide.
Con y hay un obstáculo, que ya conocemos. La regla es recursiva por la izquierda. Escrita
tal cual, la función de empezaría llamándose a sí misma sin haber consumido nada, y no terminaría nunca: es
el mismo ciclo que hacía crecer la pila del PDA con a+. La salida estándar es observar que las reglas de
generan “un , seguido de cero o más veces ”, y escribir eso como un ciclo:
// E → E + T | T, como un ciclo: un T, y después cero o más veces "+ T".
Parsed expression() {
    Parsed left = term();
    while (peek().kind == TokenKind::Plus) {
        next++;
        Parsed right = term();
        left = {left.value + right.value, "(" + left.tree + " + " + right.tree + ")"};
    }
    return left;
}
Es la función expression de expr.h, sin el contador de llamadas ni la comprobación de overflow. Cada vuelta
del ciclo mete lo acumulado como hijo izquierdo de una suma nueva: agrupa hacia la izquierda, igual que el
árbol de la regla . La función de es idéntica, con el producto y con factor.
$ build/parse_expr '2 + 3 * 4' '(2 + 3) * 4' '2 + 3 + 4' '2 + * 3'
2 + 3 * 4
  tokens:  NUM(2) + NUM(3) * NUM(4)
  árbol:   (2 + (3 * 4))
  valor:   14
  5 tokens, 6 llamadas a las funciones del parser
(2 + 3) * 4
  tokens:  ( NUM(2) + NUM(3) ) * NUM(4)
  árbol:   ((2 + 3) * 4)
  valor:   20
  7 tokens, 9 llamadas a las funciones del parser
2 + 3 + 4
  tokens:  NUM(2) + NUM(3) + NUM(4)
  árbol:   ((2 + 3) + 4)
  valor:   9
  5 tokens, 7 llamadas a las funciones del parser
2 + * 3
  tokens:  NUM(2) + * NUM(3)
  error: columna 5: se esperaba un número o ( y llegó *
La precedencia del producto sobre la suma no está programada en ningún if. Sale de la forma de la gramática:
expression llama a term, y term termina de juntar sus factores antes de devolver.
Por qué es lineal
La variable next, la posición del token que toca, solo avanza. No hay búsqueda ni vuelta atrás: cada
token se mira una cantidad acotada de veces y se consume una. Las llamadas también se pueden contar. Para una
expresión correcta son 3 por la expresión completa y por cada paréntesis que abre (una de expression, una de
term y una de factor), más 2 por cada suma y 1 por cada producto. En 2 + 3 * 4 son , y en
(2 + 3) * 4 son , como dice la salida. El total nunca pasa de tres veces la cantidad
de tokens. test_expr comprueba esa cuenta, y también que el parser acepta exactamente las cadenas de tokens
que genera machines/expr.cfg, con todas las de longitud a lo sumo 6.
Este parser es un autómata de pila determinista. Su pila es la pila de llamadas de C++: cada llamada
pendiente a expression, term o factor es un símbolo que dice qué falta reconocer, exactamente como la
pila del PDA de una gramática guardaba lo que faltaba derivar. La diferencia con aquel PDA es que este no
adivina la regla: la elige mirando un token.
En la práctica. En Introducción a la Programación terminaron el semestre escribiendo un intérprete de un lenguaje pequeño. Su primera mitad era esto: un lexer que partía el texto en tokens y un parser que armaba el árbol con una función por cada tipo de construcción. Lo que entonces fue una técnica de programación, ahora tiene nombre y teoría: los tokens son un lenguaje regular, la sintaxis es un lenguaje libre de contexto determinista, y el parser es su autómata de pila. GCC y Clang, y los compiladores de Go y de Rust, tienen parsers escritos así, a mano.
El código de la semana
code/week-06/
├── pda.h                 struct Pda, lectura del formato .pda, configuraciones y la búsqueda
├── cfg.h                 struct Cfg, lectura del formato .cfg, cadenas que genera una gramática
├── convert.h             de gramática a PDA, normalizar un PDA, de PDA a gramática
├── closure.h             unión, concatenación y estrella de gramáticas
├── pumping.h             todas las divisiones s = uvxyz de una cadena, y qué pasa al bombear
├── expr.h                lexer y parser descendente recursivo de expresiones (opcional)
├── predicates.h          los lenguajes del capítulo como funciones, para las pruebas
├── print.h               la tabla de una ejecución
├── show_pda.cpp          muestra un .pda como séxtupla
├── run_pda.cpp           simula un PDA y muestra una ejecución de aceptación
├── cfg_to_pda.cpp        la construcción de gramática a PDA
├── normalize_pda.cpp     normaliza un PDA
├── pda_to_cfg.cpp        la construcción de PDA a gramática
├── cfg_strings.cpp       las cadenas de una gramática hasta una longitud
├── pump_demo.cpp         el juego del lema de bombeo, con p pequeños
├── parse_expr.cpp        analiza y evalúa expresiones (opcional)
├── machines/             los autómatas (.pda) y las gramáticas (.cfg) del capítulo
├── errors/               dos descripciones que no son un PDA
├── test_pda.cpp          cada autómata contra una función; las ejecuciones de los apuntes
├── test_convert.cpp      las dos construcciones, la normalización y el cierre
├── test_pumping.cpp      los análisis por casos, división por división
├── test_expr.cpp         el parser contra la gramática
└── lab/pda_sim/          el laboratorio (opcional)
make compila todo, y make test corre las pruebas con ASan y UBSan. Las pruebas comprueban con assert lo
que este capítulo afirma.
test_pdacompara cada autómata demachines/con una función de C++ que decide el mismo lenguaje mirando la cadena completa, sobre todas las cadenas hasta una longitud: 10 para los alfabetos de dos símbolos y 8 para los de tres. Comprueba además las ejecuciones copiadas en estos apuntes y los tres finales de la búsqueda.test_convertcomprueba, para siete gramáticas, que el PDA construido acepta exactamente lo que la gramática genera; para ocho autómatas, que la forma normalizada acepta lo mismo y con la pila vacía, y que la gramática de las genera exactamente lo que el autómata acepta; y las construcciones de unión, concatenación y estrella. También que la intersección de los lenguajes deanbn_cm.cfgyam_bncn.cfges .test_pumpingytest_exprson las pruebas de las secciones Usar el lema: el juego y Cómo trabaja un parser real.
$ make test
test_pda: ok (8 autómatas, 31964 cadenas en total)
test_convert: ok (7 gramáticas a PDA, 8 autómatas normalizados y pasados a gramática)
test_pumping: ok (13776 divisiones revisadas caso por caso)
test_expr: ok (19531 cadenas de tokens contra la gramática)
Todas las pruebas pasaron.
Las pruebas tardan bastante más que las de otras semanas, porque simulan decenas de miles de cadenas con los sanitizers activados.
Para saber qué cadenas genera una gramática sin depender del PDA, cfg.h las calcula por punto fijo: empieza
con un conjunto vacío por variable y aplica las reglas hasta que ningún conjunto crece, guardando solo las
cadenas de longitud a lo sumo . Es lento, pero vale para cualquier gramática.
Una de las siete gramáticas necesita un cuidado. El PDA de expr.cfg tiene configuraciones sin fin, como
vimos, y la búsqueda no puede rechazar. Para esa gramática la prueba le pone a la búsqueda un tope de altura de
pila: . Es correcto por una razón particular de esa gramática: no tiene reglas , así que
cada símbolo de la pila va a generar al menos un terminal de lo que falta leer. Una configuración en
con más símbolos sobre la marca que símbolos por leer no puede llegar a aceptar, y
descartarla no cambia la respuesta. Con ese tope las configuraciones son finitas.
Los archivos de machines/:
| Archivo | Lenguaje |
|---|---|
zeros_ones.pda, zeros_ones.cfg |
|
zeros_ones_norm.pda |
el mismo, normalizado para pasar a gramática |
balanced.pda, balanced.cfg |
paréntesis balanceados |
even_palindromes.pda, even_palindromes.cfg |
|
equal_ab.pda, equal_ab.cfg |
igual cantidad de que de |
ij_or_jk.pda |
|
anbn_cm.pda, anbn_cm.cfg |
|
am_bncn.cfg |
|
even_ones.pda |
cantidad par de unos: un DFA escrito como PDA |
expr.cfg |
expresiones aritméticas, sin ambigüedad |
El laboratorio
La sesión de laboratorio de esta semana es para la práctica. El problema de lab/pda_sim queda como ejercicio
opcional, con el juez de siempre.
cd lab/pda_sim
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Es un simulador: la entrada es un PDA en formato .pda seguido de una lista de cadenas, y la salida es
acepta, rechaza o limite por cada una. El enunciado fija el límite en 10 000 configuraciones distintas y
dice exactamente cuándo se responde cada cosa. pda.h ya trae una búsqueda, y pueden leerla. Como en la
semana 1, solution.cpp se escribe sin incluirla. Lo que el laboratorio ejercita es lo de la sección Simular
un PDA: buscar entre configuraciones: qué es una configuración, cuándo dos son la misma, y por qué hace falta
recordar las vistas. Hay casos con ciclos de transiciones de los dos tipos, y casos donde una
búsqueda en profundidad que no recuerda las configuraciones vistas tendría que recorrer caminos.
Resumen
- Un autómata de pila (PDA) es un NFA con una pila: memoria sin límite, pero solo se ve y se cambia la cima. Es , con . Una transición “lee , saca , pone ”, y cada uno puede ser .
- Una configuración es : estado, lo que falta leer y la pila. acepta si desde llega a alguna configuración con toda la entrada leída y el estado en . Basta una ejecución, y la pila puede quedar con cualquier cosa.
- La máquina no puede ver que la pila está vacía: se marca el fondo con un símbolo especial.
- El no determinismo sirve para decidir algo que depende de lo que falta leer: dónde está el medio de un palíndromo, cuál de dos comparaciones hacer. Una pila compara una sola pareja de cantidades.
- Simular un PDA es buscar en el grafo de configuraciones, recordando las vistas. La búsqueda puede no terminar si un ciclo de transiciones hace crecer la pila, y por eso lleva un límite.
- De gramática a PDA: la pila guarda lo que falta derivar. Con una variable en la cima se la reemplaza por el lado derecho de una regla; con un terminal, se lo compara con la entrada.
- De PDA a gramática: una variable por cada par de estados, que genera las cadenas que llevan de a de pila vacía a pila vacía. Reglas , y . Antes se normaliza el PDA: un solo estado de aceptación, pila vacía al aceptar, y cada transición pone o saca exactamente un símbolo.
- Un lenguaje es libre de contexto si y solo si algún PDA lo reconoce. Todo lenguaje regular es libre de contexto.
- Los PDA deterministas reconocen menos: es libre de contexto y ninguno lo reconoce. A diferencia de los autómatas finitos, aquí el no determinismo agrega poder.
- Lema de bombeo: si es libre de contexto, hay un tal que toda con se divide en con para todo , y . Sale de un árbol de derivación alto, donde una variable se repite en un camino. Sirve .
- Para usarlo: elegir , y cubrir todas las divisiones, incluidas las que tienen o sobre el borde entre dos bloques. A veces hay que bombear hacia abajo, con .
- No son libres de contexto: , y .
- Los lenguajes libres de contexto son cerrados bajo unión, concatenación y estrella, y bajo intersección con un lenguaje regular. No son cerrados bajo intersección ni bajo complemento.
- ✂️ Un parser real tiene un lexer, que es un autómata finito, y un parser determinista, que lee cada token una vez. Un parser descendente recursivo tiene una función por variable, y su pila es la de llamadas.
Ejercicios
- Sigan a mano el autómata de
machines/zeros_ones.pdacon y con , escribiendo cada configuración. Comprueben conbuild/run_pda. ¿En qué configuración muere la ejecución de , y por qué no hay otra? - Para el autómata de
machines/even_palindromes.pday la cadena , escriban todas las configuraciones alcanzables, agrupadas según después de cuántos símbolos salta la máquina de a . ¿Cuántas son? ¿Cuál es la ejecución que acepta? Comparen conbuild/run_pda: la cantidad que imprime es la de las configuraciones descubiertas hasta encontrar la aceptación, que puede ser menor que el total. - Diseñen un PDA para cada lenguaje, con una tabla de qué hace cada transición, y escríbanlo en formato
.pda: (a) ; (b) los palíndromos sobre de cualquier longitud, par o impar; (c) las cadenas sobre con más que . Pruébenlos conbuild/run_pda. En cada uno, digan dónde usa el no determinismo, o si es determinista. - El autómata de
machines/equal_ab.pdapuede tener en la pila y mezcladas, porque con una por leer y una en la cima puede sacar o puede poner. Demuestren que aun así reconoce el lenguaje correcto: (a) si acepta , entonces tiene tantas como ; (b) si tiene tantas como , la ejecución que saca siempre que puede acepta. Para (a), emparejen cada símbolo que se pone con el momento en que se saca. - Apliquen la construcción de gramática a PDA a . Den los estados y las transiciones, y cuenten los estados con la fórmula del capítulo. Sigan la
ejecución de aceptación de y armen la tabla de “ya leído” y “pila” en las visitas a
. Comprueben con
build/cfg_to_pdaybuild/run_pda. - Consideren este PDA normalizado, con estado inicial y de aceptación : de a con
; en , y
; de a con
. (a) ¿Qué lenguaje reconoce? (b) Den las reglas del tipo
de su gramática. (c) Quiten las variables que no sirven y simplifiquen. ¿Qué gramática
conocida queda? Aquí sí hace falta una regla del tipo : digan cuál y para qué
cadena. Comprueben con
build/pda_to_cfg. - En la demostración de PDA a gramática, den un ejemplo de un PDA que cumple las condiciones 1 y 2 pero no la 3, y de una ejecución suya de pila vacía a pila vacía en la que el símbolo que se saca al final no es el que se puso al principio. ¿Qué paso del caso (a) deja de valer?
- Demuestren con el lema de bombeo que estos lenguajes no son libres de contexto, con el análisis por casos
completo: (a) ; (b)
; (c)
. En (b), ¿qué cadena eligen para que haga
falta la menor cantidad de casos? Adapten
pump_demo.cpppara comprobar su elección con pequeños. - Demuestren que el complemento de es libre de contexto. Sugerencia: una cadena no está en si no es de la forma , o si es con , o con . Escriban cada parte como un lenguaje libre de contexto y usen el cierre bajo unión. ¿Por qué esto no contradice que no sea libre de contexto?
- Usen el cierre bajo intersección con un lenguaje regular para demostrar que no son libres de contexto: (a) las cadenas sobre , en cualquier orden, que no tienen más que ni más que ; (b) , suponiendo ya demostrado que no lo es. En cada caso digan con qué lenguaje regular intersecan, qué lenguaje queda y por qué es ese.
- ¿Verdadero o falso? Justifiquen con una demostración o un contraejemplo. (a) Si es libre de contexto y , entonces es libre de contexto. (b) Si es libre de contexto y es regular, entonces es libre de contexto. (c) Si y son libres de contexto, entonces lo es. (d) Si es libre de contexto, entonces y lo son.
- Para programar. Agreguen a
convert.hla construcción del producto de un PDA con un DFA, y escriban una prueba que la compare con la intersección calculada cadena por cadena. El DFA pueden leerlo con una copia dedfa.hde la semana 1. Úsenla conmachines/equal_ab.pday un DFA de : ¿qué lenguaje reconoce el producto? - Para programar (✂️). Agreguen la resta y la división entera a
expr.h, con la precedencia y la agrupación usuales:8 - 3 - 2vale 3, y no 7. Escriban primero la gramática sin ambigüedad. ¿Qué árbol arma su parser para8 - 3 - 2, y qué pasaría si el ciclo agrupara hacia la derecha?