
Apuntes · Capítulo 5Lenguajes libres de contexto
Gramáticas libres de contexto
Gramáticas libres de contexto
La primera parte del curso terminó con un límite. Un autómata finito tiene una cantidad fija de estados, y con eso no puede contar sin tope: en la semana 4 demostramos que no es regular. Ni un DFA, ni un NFA, ni una expresión regular lo describen.
Ese lenguaje no es una curiosidad. Tiene la forma de casi todo lo que escribimos para una computadora: algo que
se abre y después se cierra, con más cosas del mismo tipo adentro. Un paréntesis que abre exige uno que cierre.
Una llave { de C++ exige su }, y entre las dos hay instrucciones que traen sus propias llaves. Una lista
de JSON contiene valores, y un valor puede ser otra lista. A eso se le llama estructura anidada, y para
reconocerla hay que recordar cuántas cosas quedaron abiertas, sin límite.
Esta semana empieza la segunda parte del curso, con una manera nueva de describir un lenguaje. Un autómata reconoce: recibe una cadena y responde sí o no. Una gramática hace lo contrario: da reglas para generar las cadenas del lenguaje, y la estructura anidada sale sola porque las reglas pueden ser recursivas. Las gramáticas libres de contexto describen todos los lenguajes regulares y además , los paréntesis balanceados, las expresiones aritméticas y la sintaxis de los lenguajes de programación.
La semana tiene dos mitades. En la primera definimos las gramáticas, aprendemos a diseñarlas y a demostrar que generan lo que decimos, y encontramos un problema que los autómatas no tenían: una misma cadena puede tener dos estructuras distintas. En la segunda resolvemos la pregunta que un compilador se hace con cada programa: dada una gramática y una cadena, ¿la gramática genera la cadena? La respuesta pasa por una forma ordenada de escribir las gramáticas, la forma normal de Chomsky, y por un algoritmo de programación dinámica, CYK.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Lo que las expresiones regulares no alcanzan y La definición formal de una gramática. Antes de la sesión B, El problema de la pertenencia. Con eso llegan con la definición y con la pregunta de la segunda sesión ya planteada.
En clase: Sesión A, de Lo que las expresiones regulares no alcanzan a Ambigüedad. Sesión B, de El problema de la pertenencia a El costo de CYK.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, El algoritmo CYK otra vez y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 2.1 (Context-Free Grammars), que incluye la ambigüedad y la parte Chomsky Normal Form, y de la sec. 7.2 el teorema de que todo lenguaje libre de contexto está en P, que es el algoritmo CYK. Erickson, Models of Computation, nota 5 (Context-free languages). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-05. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/cyk_parser.
Lo que las expresiones regulares no alcanzan
Tres lenguajes que aparecen en cualquier programa, y que ningún autómata finito reconoce.
Paréntesis balanceados. Las cadenas sobre en las que cada paréntesis que abre tiene uno que cierra después, como , y no como ni . El argumento de la semana 4 se repite casi igual: después de leer hay que recordar para saber cuántos faltan, y no tiene tope.
Expresiones aritméticas. o , donde representa un número o una variable. Contienen a los paréntesis balanceados, y además tienen algo que los paréntesis solos no muestran: la cadena tiene una estructura que decide qué significa. En el producto se hace primero, aunque esté escrito después.
JSON. Un valor es un número, o una lista de valores entre corchetes, separados por comas. La definición
se nombra a sí misma, y eso es lo que da listas dentro de listas, como [1, [2, 3], []].
Las tres descripciones tienen la misma forma: dicen cómo se arma una cadena del lenguaje a partir de cadenas más cortas del mismo lenguaje. Una expresión es una expresión, un signo más y otra expresión. Una lista es un corchete, valores, y un corchete. Una gramática es esa descripción escrita con precisión. La del valor de JSON, simplificada, donde representa un número, queda así:
Se lee: un valor es un número, o una lista vacía, o un corchete, una lista de valores y un corchete. Una lista de valores es un valor solo, o un valor, una coma y otra lista de valores. La barra separa las alternativas.
En la práctica. La sintaxis de casi todos los lenguajes de programación y de los formatos de datos se publica como una gramática de este tipo. El estándar de C++, la referencia de Python y la especificación de JSON traen sus reglas escritas con una flecha y alternativas. El programa que lee un texto y encuentra su estructura según una gramática se llama parser, y está en todo compilador, en todo intérprete y en toda biblioteca que lee JSON.
La definición formal de una gramática
Una gramática libre de contexto (context-free grammar, CFG) es una cuádrupla , donde:
- es un conjunto finito de variables (variables);
- es un conjunto finito de terminales (terminals), que no comparte elementos con ;
- es un conjunto finito de reglas (rules), cada una de la forma , donde es una variable y es una cadena de variables y terminales, es decir, ;
- es la variable inicial.
Los terminales son los símbolos de las cadenas que la gramática genera: son el alfabeto del lenguaje. Las variables no aparecen en esas cadenas. Son nombres para las partes que todavía falta escribir: “aquí va una expresión”, “aquí va una lista”. Escribimos las variables con mayúsculas, , , , y los terminales como los símbolos de siempre, , , . Las letras , , , nombran cadenas que pueden mezclar variables y terminales, y queda para las cadenas de terminales.
El lado derecho de una regla puede ser la cadena vacía: es una regla válida, y se llama regla . Varias reglas con el mismo lado izquierdo se abrevian con la barra: son las dos reglas y .
El primer ejemplo es la gramática del lenguaje que cerró la semana 4:
Es , con las dos reglas y . Cuando una gramática se da solo con sus reglas, como aquí, se entiende que las variables son los símbolos que aparecen a la izquierda de alguna flecha, que los terminales son los demás símbolos, y que la variable inicial es la de la primera regla.
Las gramáticas como archivos
Las gramáticas del curso se escriben en archivos .cfg, con el formato de code/formats.md. Los campos son
los cuatro componentes de la definición, con su nombre en palabras: variables, terminals, start y
rules. Este es machines/zeros_ones.cfg:
# { 0^n 1^n : n >= 0 }
variables: S
terminals: 0 1
start: S
rules:
S -> 0 S 1 | eps
Cada línea después de rules: tiene una variable, la flecha -> y sus alternativas separadas por |. Los
símbolos de una alternativa van separados por espacios, porque el nombre de una variable puede tener
varias letras. La alternativa vacía se escribe eps. El programa show_cfg lee un archivo, lo muestra como
cuádrupla y lista las cadenas más cortas que genera:
$ build/show_cfg machines/zeros_ones.cfg
G = (V, Σ, R, S)
  V = {S}
  Σ = {0, 1}
  S = S
  R tiene 2 reglas:
    S → 0S1
    S → ε
Cadenas de L(G) con longitud a lo sumo 6 (4):
  ε 01 0011 000111
Todavía no dijimos qué significa que una gramática genere una cadena. Eso es la sección siguiente.
Error común. Escribir
S -> 0S1en el archivo. Sin espacios,0S1es un solo nombre, que no es variable ni terminal. La carpetaerrors/tiene ese caso, y el lector lo rechaza diciendo por qué:$ build/show_cfg errors/glued_symbols.cfg error: errors/glued_symbols.cfg: la gramática no es válida: en una regla de S aparece aSb, que no es variable ni terminal
En C++. El
struct Cfgdecfg.htiene los cuatro componentes con los nombres del formato:variables,terminals,rulesystart. Una regla es unstruct Ruleconhead, la variable de la izquierda, ybody, unstd::vector<std::string>con los símbolos de la derecha. La regla tiene elbodyvacío: un vector con cero elementos, igual que es la cadena con cero símbolos.
Derivaciones y el lenguaje de una gramática
Una gramática se usa así: se escribe la variable inicial y se repite un paso hasta que no queden variables. El paso es elegir una variable de lo que está escrito, elegir una de sus reglas, y reemplazar la variable por el lado derecho de la regla. Con :
Los tres primeros pasos usan la regla , y el último usa : la se reemplaza por nada.
Con precisión. Sean , , cadenas de variables y terminales, y sea una regla de . Decimos que deriva en un paso , y escribimos
Decimos que deriva , y escribimos , si se llega de a con cero o más pasos: , o hay cadenas con
Esa secuencia es una derivación (derivation) de a partir de , y es su número de pasos. Cada cadena que aparece en una derivación que empieza en se llama una forma: puede tener variables y terminales.
El lenguaje de la gramática es el conjunto de las cadenas de terminales que se derivan de la variable inicial:
Si decimos que genera . Un lenguaje es libre de contexto (context-free language) si alguna gramática libre de contexto lo genera.
Dos cosas de la definición que conviene mirar despacio.
Solo cuentan las cadenas sin variables. se deriva de , pero no está en : es una forma, un trabajo a medio hacer. Una derivación que nunca logra deshacerse de sus variables no genera nada.
En cada paso hay elecciones. Qué variable reemplazar y con cuál de sus reglas. Una gramática no es un procedimiento con un solo camino: es un conjunto de reglas, y junta lo que sale por todos los caminos. En eso se parece a un NFA, que acepta si algún camino acepta.
Por qué se llaman libres de contexto
La regla se puede aplicar a una esté donde esté. En la definición del paso, y son cualesquiera: lo que rodea a la variable, su contexto, no importa. De ahí salen dos propiedades que usaremos en casi todas las demostraciones del capítulo.
Lema (del contexto). Si , entonces para todas las cadenas , .
Demostración. Cada paso de reemplaza una variable por el lado derecho de una regla. El mismo reemplazo se puede hacer con escrita a la izquierda y a la derecha, porque la definición del paso permite cualquier cosa alrededor. Haciendo los mismos pasos en el mismo orden se va de a . ∎
Lema (de separación). Sean símbolos, variables o terminales, y una cadena de terminales. Si con pasos, entonces se parte en de modo que con pasos para cada , y .
Con palabras: lo que sale de cada símbolo es un trozo de la cadena final, los trozos quedan en el mismo orden que los símbolos, y cada símbolo trabaja por su cuenta.
Demostración. Por inducción sobre .
Caso base: . Entonces , todos los son terminales, y sirve con .
Paso inductivo: el primer paso de la derivación reemplaza alguna variable con una regla . Queda la cadena
que deriva con pasos. Por la hipótesis de inducción, se parte en un trozo por cada símbolo de esa cadena. Los trozos de y de sirven tal cual. Sea la concatenación de los trozos de . Entonces : el primer paso es la regla, y el resto se arma derivando cada en su trozo, uno después de otro, lo que el lema del contexto permite. Esa derivación tiene un paso más que la suma de los pasos de los , así que los números de pasos de todos los suman . Si , la regla es , y con un paso. ∎
Idea clave. En una gramática libre de contexto, lo que una variable genera no depende de lo que tiene alrededor. Por eso una derivación se puede partir en derivaciones independientes, una por símbolo, y por eso tiene sentido preguntar “¿qué cadenas genera la variable ?” para cada variable por separado.
Derivaciones por la izquierda
Cuando una forma tiene varias variables, el orden en que se reemplazan no cambia lo que se puede generar: por el lema de separación, cada una trabaja por su cuenta. Para no contar como distintas dos derivaciones que solo difieren en ese orden, se fija uno.
Una derivación por la izquierda (leftmost derivation) es una derivación en la que cada paso reemplaza la variable que está más a la izquierda en la forma. Con la gramática , , , la cadena tiene dos derivaciones:
Solo la primera es por la izquierda. La segunda reemplaza cuando todavía hay una antes.
Toda cadena de tiene al menos una derivación por la izquierda. Sale del lema de separación: si , se deriva primero todo el trozo de , después todo el de , y así, y dentro de cada trozo se hace lo mismo.
El programa derive busca todas las derivaciones por la izquierda de una cadena, probando reglas con
backtracking:
$ build/derive machines/zeros_ones.cfg 000111
w = 000111
derivaciones por la izquierda: 1

1. S ⇒ 0S1 ⇒ 00S11 ⇒ 000S111 ⇒ 000111
   4 pasos
   S
   ├── 0
   ├── S
   │   ├── 0
   │   ├── S
   │   │   ├── 0
   │   │   ├── S
   │   │   │   └── ε
   │   │   └── 1
   │   └── 1
   └── 1
Debajo de la derivación, el programa dibuja un árbol. Es el tema de la sección siguiente.
Árboles de derivación
Una derivación dice qué reglas se usaron y en qué orden. El orden es un accidente: lo que importa es qué regla se le aplicó a cada variable. Un árbol guarda eso y nada más.
Un árbol de derivación (parse tree) de una gramática es un árbol ordenado en el que:
- cada nodo interno lleva una variable, y cada hoja lleva un terminal o ;
- si un nodo lleva la variable y sus hijos, de izquierda a derecha, llevan , entonces es una regla de ;
- una hoja lleva solo si es el único hijo de su padre, y entonces la regla es .
La cadena que el árbol deriva se lee en sus hojas, de izquierda a derecha, saltando las . El árbol de arriba tiene raíz y deriva . El programa lo dibuja acostado: los hijos de un nodo son las líneas que cuelgan de él, de arriba hacia abajo en lugar de izquierda a derecha.
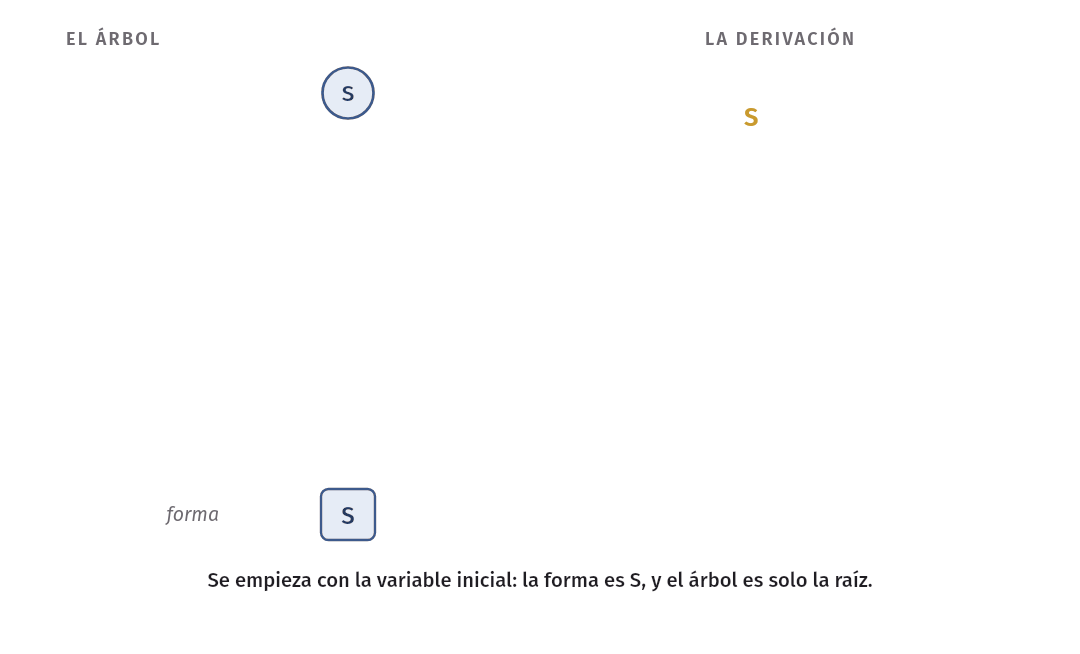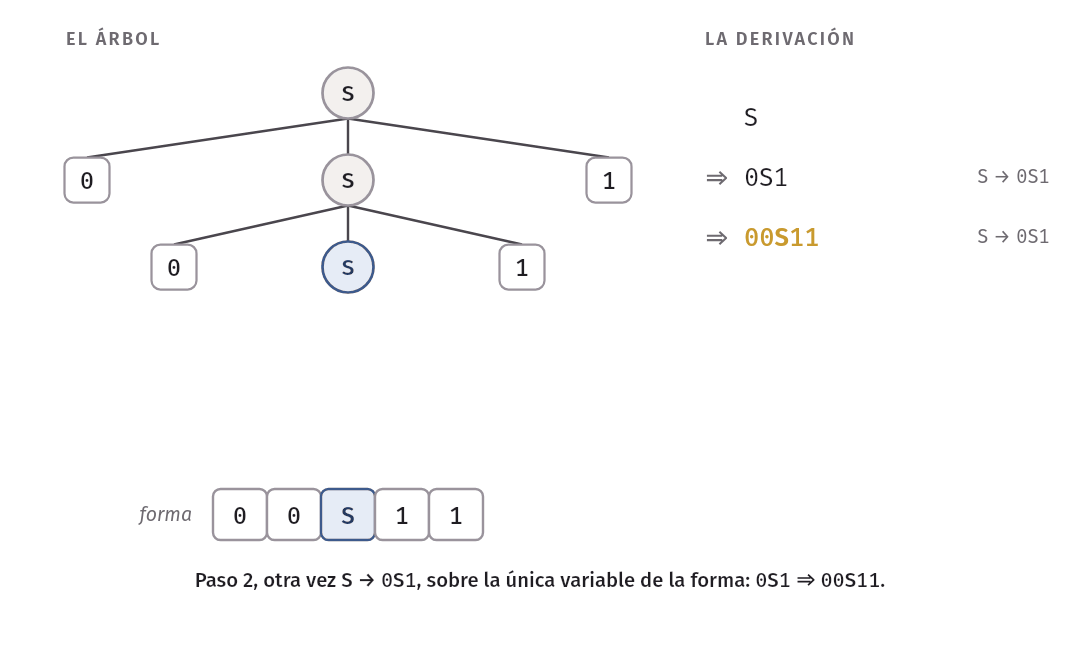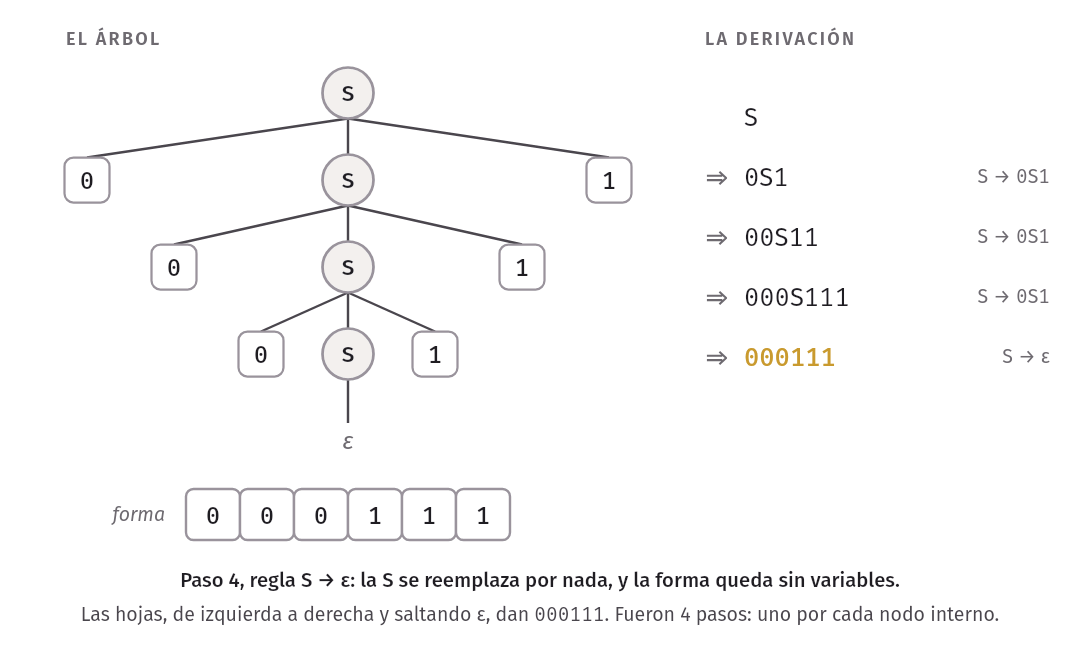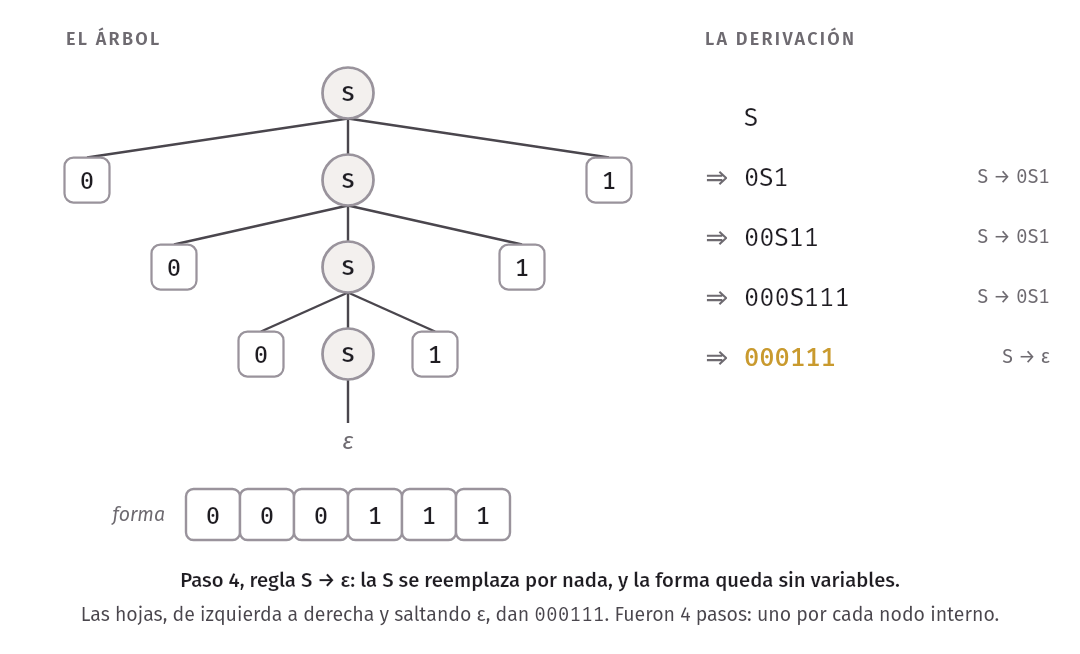
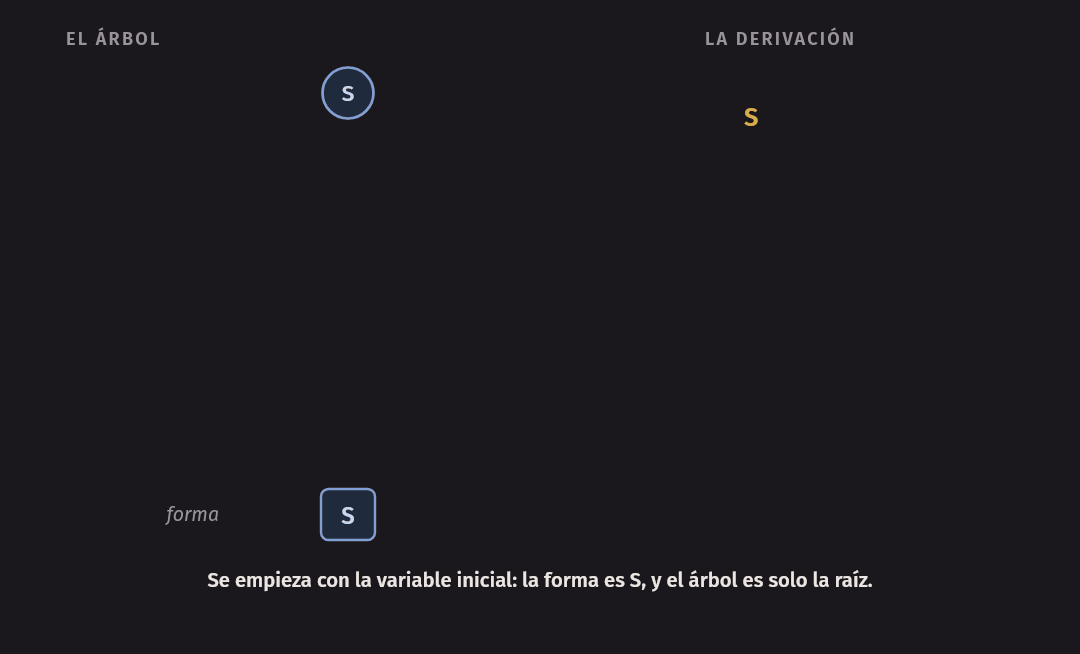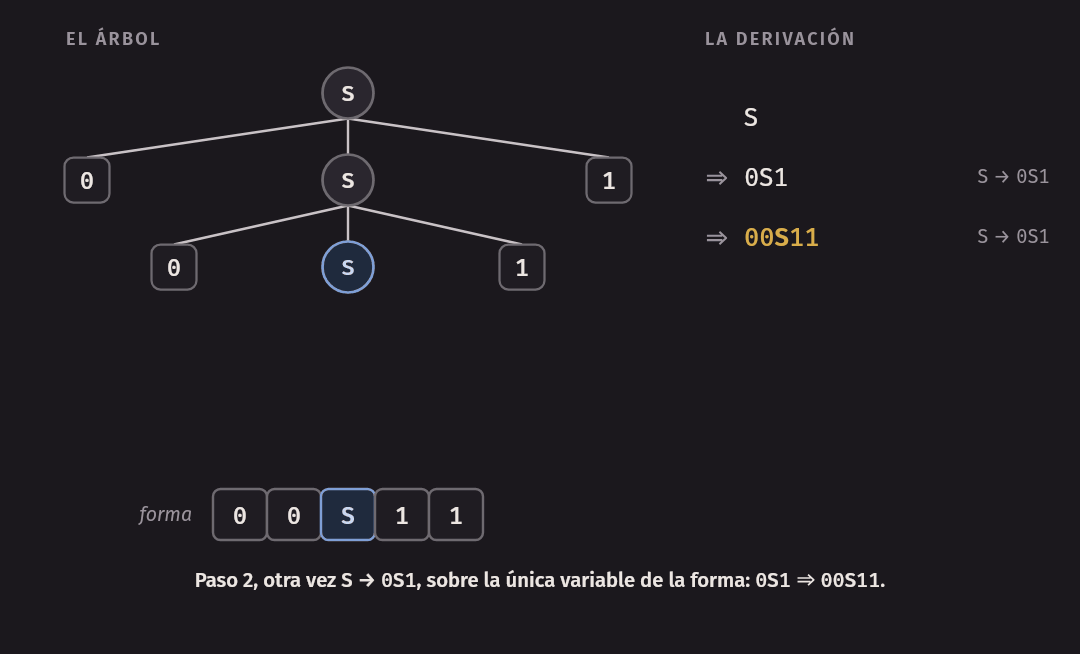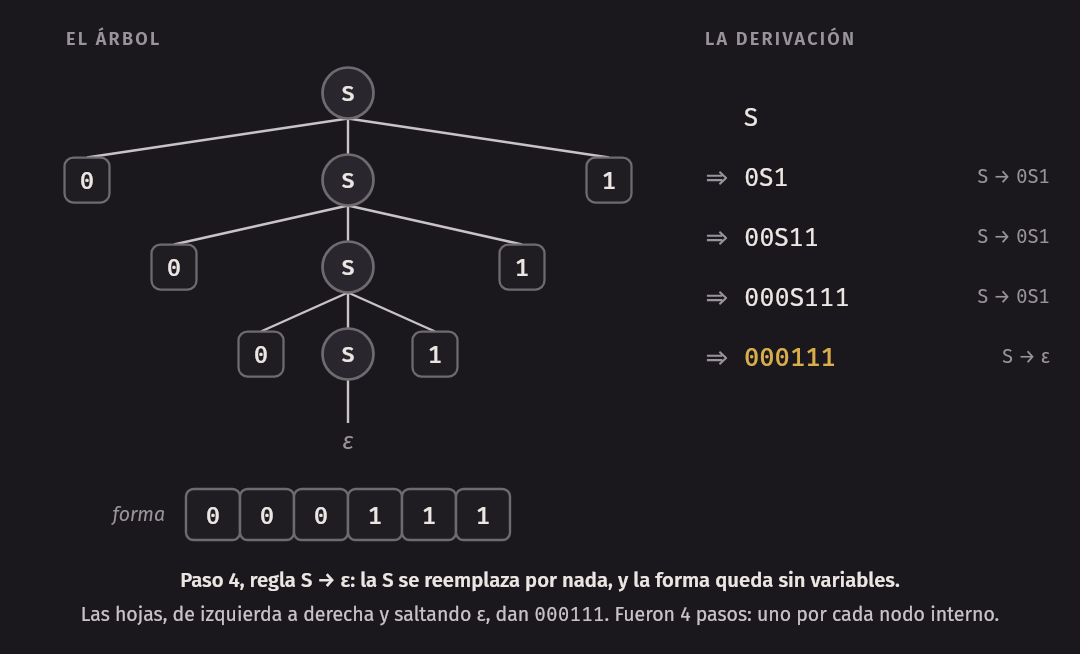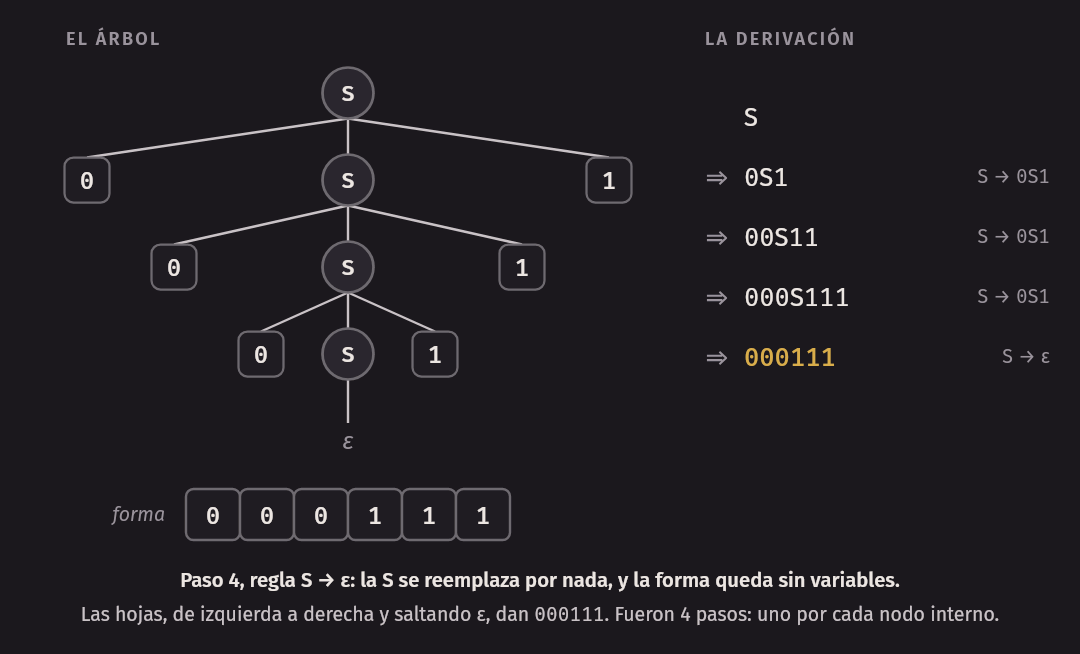
Los árboles y las derivaciones cuentan la misma historia:
- De una derivación sale un árbol. La raíz es la variable inicial, y cada paso le cuelga a esa un hijo por cada símbolo de .
- De un árbol salen derivaciones, en general varias: una por cada orden en que se pueden recorrer los nodos internos de modo que cada uno venga después de su padre. Todas tienen el mismo número de pasos, porque cada nodo interno es exactamente un paso.
- De un árbol sale una sola derivación por la izquierda. Es la que recorre los nodos internos en preorden: primero el nodo, después sus hijos de izquierda a derecha. Y dos árboles distintos dan derivaciones por la izquierda distintas, porque de la lista de reglas en preorden se reconstruye el árbol.
Por eso un árbol y una derivación por la izquierda son dos maneras de escribir lo mismo. Las dos derivaciones de de la sección anterior tienen el mismo árbol:
$ build/derive machines/two_derivations.cfg ab
w = ab
derivaciones por la izquierda: 1

1. S ⇒ AB ⇒ aB ⇒ ab
   3 pasos
   S
   ├── A
   │   └── a
   └── B
       └── b
En adelante usaremos una forma equivalente de decir que una variable genera una cadena: si y solo si hay un árbol de derivación con raíz que deriva .
Idea clave. El árbol de derivación es la estructura de la cadena según la gramática: qué trozo salió de qué variable. Un compilador no quiere saber solo que el programa está bien escrito. Quiere el árbol, porque el árbol dice qué operación se aplica a qué.
En C++. En
cfg.h, un árbol es unstruct Treeconsymbolychildren, unstd::vector<Tree>. Unstructpuede tener un vector de sí mismo, y así el árbol se arma y se destruye sin punteros, sinnewy sindelete. La funcióntree_ofconstruye el árbol de una derivación por la izquierda, yyield_oflee sus hojas.
Cómo diseñar una gramática
Diseñar un DFA era decidir qué recordar. Diseñar una gramática es describir cómo se arma una cadena del lenguaje a partir de otras más cortas. Tres preguntas ayudan:
- ¿Cuáles son las cadenas más cortas del lenguaje? Son los casos base: reglas sin variables a la derecha.
- ¿Cómo se obtiene una cadena más larga a partir de una o dos más cortas? Son las reglas recursivas.
- ¿Toda cadena del lenguaje se arma así? Si quedan cadenas afuera, faltan reglas.
Cuatro ejemplos, del más simple al menos obvio.
Ceros y después la misma cantidad de unos
. La más corta es . Una cadena más larga es , una cadena del lenguaje, y : la recursión agrega un símbolo en cada extremo a la vez, y así las dos cantidades crecen juntas.
Esa es la idea que un DFA no puede imitar: la regla deja la variable en medio, y lo que se escribe a su izquierda queda emparejado con lo que se escribe a su derecha.
Palíndromos
Un palíndromo es una cadena igual a su reverso: . Sobre , los más cortos son , y . Uno más largo empieza y termina con el mismo símbolo, y lo que queda en medio es otro palíndromo.
$ build/show_cfg machines/palindromes.cfg 4
G = (V, Σ, R, S)
  V = {S}
  Σ = {a, b}
  S = S
  R tiene 5 reglas:
    S → aSa
    S → bSb
    S → a
    S → b
    S → ε
Cadenas de L(G) con longitud a lo sumo 4 (13):
  ε a b aa bb aaa aba bab bbb aaaa abba baab bbbb
Los casos base y dan los palíndromos de longitud impar, y los de longitud par.
Paréntesis balanceados
Una cadena de paréntesis está balanceada si ningún prefijo tiene más que , y la cadena completa tiene tantos de uno como de otro. La más corta es . Para una más larga, miren su primer símbolo: es un , que se cierra en algún . Lo que hay entre los dos está balanceado, y lo que sigue después también.
$ build/show_cfg machines/parens.cfg 6
G = (V, Σ, R, S)
  V = {S}
  Σ = {(, )}
  S = S
  R tiene 2 reglas:
    S → (S)S
    S → ε
Cadenas de L(G) con longitud a lo sumo 6 (9):
  ε () (()) ()() ((())) (()()) (())() ()(()) ()()()
Hay otra gramática para el mismo lenguaje, quizá más natural: una cadena balanceada es dos balanceadas seguidas, o una balanceada entre paréntesis, o nada.
Está en machines/parens_ss.cfg, y genera lo mismo. Las dos gramáticas se comportan muy distinto, como
veremos en El problema de la pertenencia y en los ejercicios.
Igual número de a y de b
. Aquí las y las van en cualquier orden: y están en . La gramática es
$ build/show_cfg machines/equal_ab.cfg 4
G = (V, Σ, R, S)
  V = {S}
  Σ = {a, b}
  S = S
  R tiene 4 reglas:
    S → aSb
    S → bSa
    S → SS
    S → ε
Cadenas de L(G) con longitud a lo sumo 4 (9):
  ε ab ba aabb abab abba baab baba bbaa
Que todo lo que genera tiene igual número de y de se ve en las reglas: cada una agrega una de cada o ninguna. Lo que no es obvio es la pregunta 3: ¿se obtienen todas? La cadena no empieza con y termina con , ni al revés. Sale de la regla , como seguida de . Que siempre se pueda partir así hay que demostrarlo, y lo hacemos en la sección siguiente.
Error común. Olvidar el caso base. Con solo , toda forma tiene una y ninguna derivación termina: la gramática genera , no . Y al revés, una gramática cuya única regla es genera , que tiene una cadena. Es la diferencia entre y de la semana 1, ahora con gramáticas.
Unir gramáticas
Los lenguajes libres de contexto son cerrados bajo unión, y la construcción es de una línea. Si y generan y , con variables iniciales y , se renombran las variables para que las dos gramáticas no compartan ninguna, se juntan todas las reglas y se agrega una variable inicial nueva con
Una derivación desde elige en su primer paso con cuál de las dos gramáticas sigue. Como las variables no se comparten, desde solo se usan reglas de y se genera exactamente , y lo mismo con .
Sirve para diseñar: si el lenguaje es “esto o aquello”, se hace una gramática para cada parte. El lenguaje
es la unión de dos lenguajes parecidos
a : en uno se emparejan las con las y las
van libres, y en el otro al revés. En machines/abc_union.cfg las dos partes ya están pegadas a la inicial:
genera las cadenas con , y las cadenas con . La misma idea con da la concatenación, y con da la estrella.
De un DFA a una gramática
Todo lenguaje regular es libre de contexto. Dado un DFA , se construye una gramática con una variable por estado: la variable va a generar las cadenas que llevan de a un estado de aceptación.
- Por cada transición , la regla .
- Por cada estado de aceptación , la regla .
- La variable inicial es .
Con el DFA de la paridad de unos de la semana 1, de estados e , y llamando e
a las dos variables, queda machines/even_ones.cfg:
Una derivación copia la ejecución del autómata. La forma siempre es lo leído hasta ahora seguido de la variable del estado actual:
$ build/derive machines/even_ones.cfg 1001 --sin-arboles
w = 1001
derivaciones por la izquierda: 1

1. P ⇒ 1I ⇒ 10I ⇒ 100I ⇒ 1001P ⇒ 1001
   5 pasos
Los estados por los que pasa el DFA con son , , , , : las mismas variables, en el mismo orden. El último paso, , solo se puede dar porque es de aceptación. Lo que hay que demostrar es que exactamente cuando , por inducción sobre , y queda como ejercicio.
En estas gramáticas la variable siempre queda al final de la forma. Por eso no pueden emparejar nada: no hay nada a la derecha de la variable. Lo que las gramáticas libres de contexto agregan a los lenguajes regulares es poder dejar la variable en medio.
Demostrar que una gramática genera un lenguaje
Afirmar que es afirmar la igualdad de dos conjuntos, y se demuestra con dos inclusiones:
- : toda cadena del lenguaje se puede derivar. La gramática no se queda corta.
- : toda cadena que se deriva está en el lenguaje. La gramática no genera de más.
Cada una es una inducción, y suelen ser sobre cosas distintas. Para se toma una cadena de y se hace inducción sobre algo de la cadena, como su longitud, para construirle una derivación. Para se toma una derivación y se hace inducción sobre su número de pasos.
La demostración para 0ⁿ1ⁿ
Teorema. La gramática , con reglas , genera exactamente .
Demostración. Por dos inclusiones.
Primera inclusión, . Demostramos por inducción sobre que para todo .
Caso base: . , y con cero pasos.
Paso inductivo: supongamos . Aplicando la regla a la única variable de esa forma:
Con eso, para cualquier se tiene , donde el último paso usa . Luego .
Segunda inclusión, . Demostramos por inducción sobre la siguiente afirmación: si con exactamente pasos, entonces
Caso base: . La única forma que se deriva con cero pasos es .
Paso inductivo: supongamos la afirmación para , y sea , donde la primera parte tiene pasos. Para dar un paso más, tiene que tener una variable. Por la hipótesis, es o es una cadena sin variables, así que . Su única variable es esa , y hay dos reglas para ella:
- con queda ;
- con queda .
Las dos son las formas que la afirmación permite para .
Ahora, si , entonces con algún número de pasos, y no tiene variables. Por la afirmación, y , que está en . ∎
La segunda inclusión demostró más de lo que se pedía: describió todas las formas que la gramática puede
producir, y no solo las cadenas finales. Es lo mismo que pasaba con los DFA en la semana 1, donde para demostrar
algo sobre los estados de aceptación había que decir qué significaba cada estado. Aquí, para demostrar algo
sobre las cadenas terminadas hay que decir cómo es cada forma a medio terminar. La afirmación también dice que
la derivación de es una sola y tiene pasos, como la de que
imprimió derive, de 4 pasos. La misma demostración, cambiando por y por
, sirve para y .
La demostración para igual número de a y de b
Esta es más interesante, porque la inclusión difícil es la otra.
Teorema. La gramática , con reglas , genera exactamente el lenguaje de las cadenas sobre con tantas como .
Demostración. Por dos inclusiones.
Primera inclusión, . Demostramos que toda forma con tiene tantas como , por inducción sobre el número de pasos. Con cero pasos, tiene cero de cada una. Y cada regla reemplaza una por algo que tiene una y una ( y ) o ninguna de las dos ( y ): si las cantidades eran iguales antes del paso, lo son después. En particular, las formas sin variables, que son las cadenas de , están en .
Segunda inclusión, . Demostramos por inducción sobre que toda cumple . La inducción es fuerte: se supone el resultado para todas las cadenas de más cortas que .
Caso base: . por la regla .
Paso inductivo: sea con . Como tiene tantas como , su longitud es par y . Hay tres casos, según su primer y su último símbolo.
Caso 1: empieza con y termina con . Entonces , y tiene una menos y una menos que : está en y es más corta. Por la hipótesis, , y por el lema del contexto,
Caso 2: empieza con y termina con . Igual, con la regla .
Caso 3: empieza y termina con el mismo símbolo. Digamos que es ; con el argumento es el mismo cambiando los signos. Para cada de a , sea el número de menos el número de en el prefijo de de longitud . Sabemos que:
- y , porque ;
- , porque el primer símbolo es ;
- , porque el último símbolo es y con él se llega a ;
- de a el valor cambia en exactamente , hacia arriba o hacia abajo.
Una cantidad que va de a con pasos de tamaño pasa por : hay un con y . Partimos con . El prefijo tiene tantas como porque , y entonces también, porque las tiene. Las dos cadenas están en , no son vacías y son más cortas que . Por la hipótesis, y , y por el lema del contexto, usado dos veces,
En los tres casos . ∎
El caso 3 es el que justifica la regla , y muestra una técnica que vuelve mucho: seguir una cantidad a lo largo de los prefijos de la cadena. Con , los valores de son : el cero del medio parte la cadena en y .
Error común. Demostrar una sola inclusión. “Toda cadena que la gramática genera tiene igual número de y de ” también es cierto para la gramática , que no genera . Y “toda cadena del lenguaje se genera” también es cierto para una gramática de . Hacen falta las dos.
Las pruebas de la semana comprueban las dos inclusiones de otra manera: para cada gramática de machines/
calculan todas las cadenas que genera hasta cierta longitud, y las comparan una por una con una función de C++
que decide el lenguaje mirando la cadena. Eso no reemplaza la demostración, que vale para todas las longitudes,
pero encuentra enseguida una regla que falta o que sobra.
Ambigüedad
Las expresiones aritméticas con suma, producto y paréntesis tienen una gramática de una línea. La llamamos :
En los archivos el producto se escribe *, porque un terminal es un solo carácter del teclado. La gramática
está en machines/expr_ambiguous.cfg, y genera las expresiones correctas. El problema aparece al pedirle la
estructura de una:
$ build/derive machines/expr_ambiguous.cfg 'a+a*a'
w = a+a*a
derivaciones por la izquierda: 2

1. E ⇒ E+E ⇒ a+E ⇒ a+E*E ⇒ a+a*E ⇒ a+a*a
   5 pasos
   E
   ├── E
   │   └── a
   ├── +
   └── E
       ├── E
       │   └── a
       ├── *
       └── E
           └── a

2. E ⇒ E*E ⇒ E+E*E ⇒ a+E*E ⇒ a+a*E ⇒ a+a*a
   5 pasos
   E
   ├── E
   │   ├── E
   │   │   └── a
   │   ├── +
   │   └── E
   │       └── a
   ├── *
   └── E
       └── a
Son dos árboles distintos para la misma cadena. En el primero la raíz es una suma, y su operando derecho es el producto: es . En el segundo la raíz es un producto, y su operando izquierdo es la suma: es . Con , el primer árbol vale 14 y el segundo vale 20. Un compilador que usara esta gramática no sabría cuál calcular.
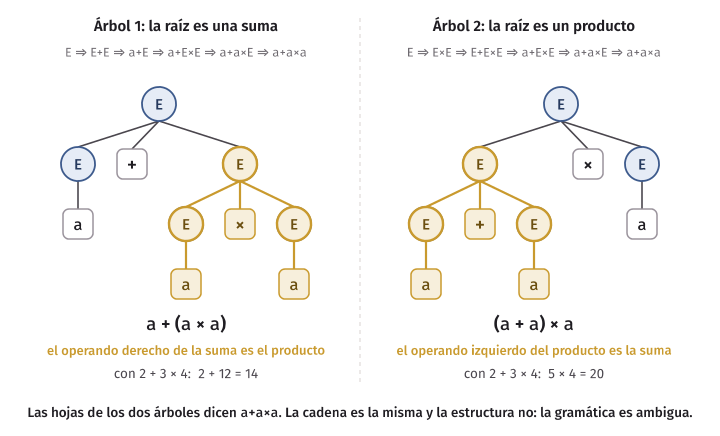
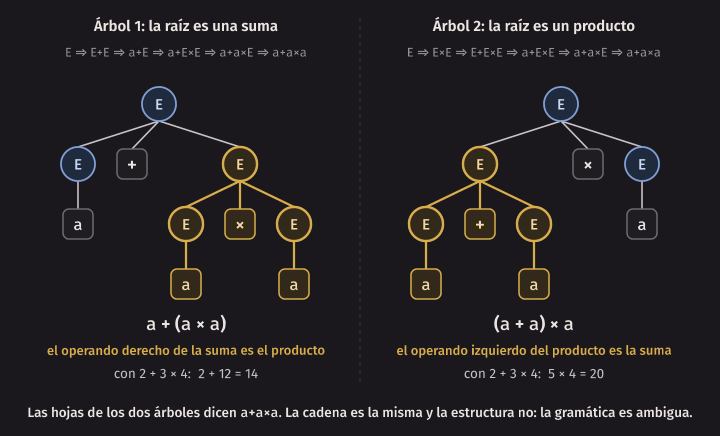
Una cadena tiene una derivación ambigua si tiene dos o más árboles de derivación distintos. Una gramática es ambigua (ambiguous) si genera alguna cadena con dos o más árboles de derivación distintos. Como cada árbol corresponde a una sola derivación por la izquierda, es lo mismo decir: alguna cadena tiene dos o más derivaciones por la izquierda distintas.
La ambigüedad de no viene solo de mezclar operadores. Con un solo operador ya aparece:
$ build/derive machines/expr_ambiguous.cfg 'a+a+a' --sin-arboles
w = a+a+a
derivaciones por la izquierda: 2

1. E ⇒ E+E ⇒ E+E+E ⇒ a+E+E ⇒ a+a+E ⇒ a+a+a
   5 pasos

2. E ⇒ E+E ⇒ a+E ⇒ a+E+E ⇒ a+a+E ⇒ a+a+a
   5 pasos
Una agrupa y la otra . Para la suma el resultado es el mismo, pero para la resta no lo sería. La regla no dice de qué lado se agrupa.
Error común. Llamar ambigua a una gramática porque una cadena tiene dos derivaciones. Casi toda cadena tiene muchas derivaciones: con , , , la cadena tiene dos, según se reemplace primero o , y esa gramática no es ambigua, porque las dos tienen el mismo árbol. Lo que cuenta son dos árboles distintos o, lo que es igual, dos derivaciones por la izquierda distintas. Para mostrar que una gramática es ambigua se exhibe una cadena y sus dos árboles.
La gramática de expresiones con niveles de precedencia
Para el mismo lenguaje hay una gramática que no es ambigua. La idea es darle un nivel a cada operador, con una variable por nivel:
- Una expresión es una suma de términos.
- Un término es un producto de factores.
- Un factor es una o una expresión entre paréntesis.
Dos decisiones de diseño quitan las dos fuentes de ambigüedad.
Los niveles dan la precedencia. Un producto solo puede tener factores como operandos, y una suma no es un factor, salvo que vaya entre paréntesis. Así, en el producto no puede tener a la suma como operando: la única manera de leerla es como la suma de y de .
La recursión de un solo lado da la asociatividad. La regla es , y no : a la derecha de un va un término, que no puede contener otra suma sin paréntesis. Entonces solo se puede agrupar como , por la izquierda, que es como se calculan la suma y la resta.
$ build/derive machines/expr_precedence.cfg 'a+a*a'
w = a+a*a
derivaciones por la izquierda: 1

1. E ⇒ E+T ⇒ T+T ⇒ F+T ⇒ a+T ⇒ a+T*F ⇒ a+F*F ⇒ a+a*F ⇒ a+a*a
   8 pasos
   E
   ├── E
   │   └── T
   │       └── F
   │           └── a
   ├── +
   └── T
       ├── T
       │   └── F
       │       └── a
       ├── *
       └── F
           └── a
Un solo árbol, con el producto debajo de la suma. El precio es que el árbol es más alto: para llegar de a una hay que bajar por y por , con las reglas y , que no agregan ningún símbolo. Esas reglas, de una variable a otra variable, se llaman reglas unitarias, y vuelven en la sesión B.
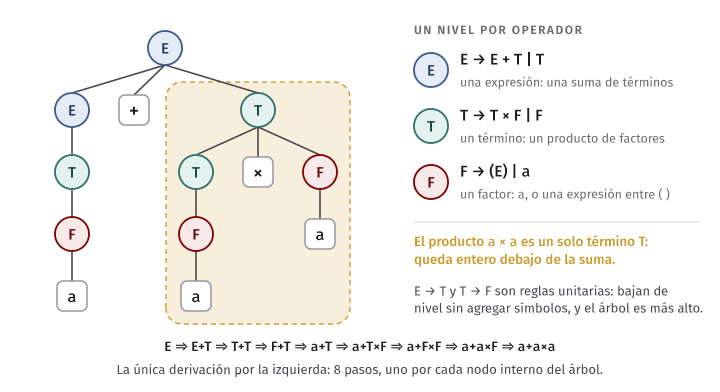
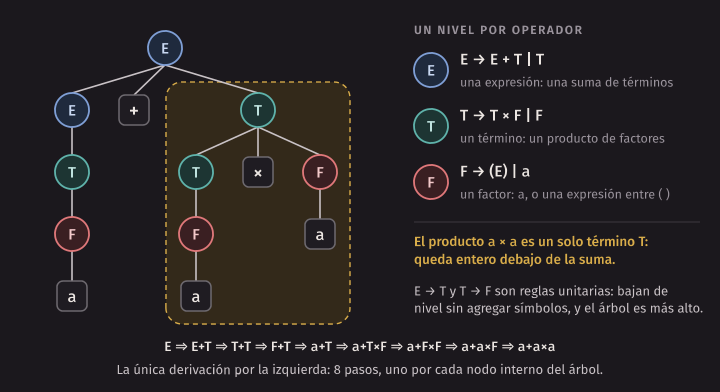
Las dos gramáticas generan el mismo lenguaje. Son equivalentes: es igual al lenguaje de la gramática con niveles. Lo que cambia es cuántos árboles tiene cada cadena. Que la gramática con niveles no es ambigua se puede demostrar, mostrando que en cada nodo la cadena deja una sola regla posible, y no lo haremos aquí. Las pruebas de la semana comprueban las dos cosas hasta donde alcanzan: que las dos gramáticas generan las mismas cadenas de hasta 7 símbolos, y que cada una de esas cadenas tiene exactamente una derivación por la izquierda en la gramática con niveles.
Idea clave. La ambigüedad es una propiedad de la gramática, no del lenguaje. El mismo lenguaje puede tener una gramática ambigua y otra que no lo es. Y la gramática no solo decide qué cadenas son correctas: decide qué árbol tiene cada una, y con el árbol, qué significa.
En la práctica. Los generadores de parsers, como yacc y bison, aceptan la gramática ambigua de una línea si se les declara aparte la precedencia y la asociatividad de cada operador. Por dentro hacen lo mismo que la gramática con niveles. La tabla de precedencia de operadores de C++, con sus más de quince niveles, es esa declaración.
El else colgante
El ejemplo más conocido de ambigüedad en un lenguaje de programación. Una instrucción puede ser un if sin
else, un if con else, o cualquier otra cosa. Abreviando if (condición) como , else como
y cualquier otra instrucción como :
La cadena es este fragmento de C++:
if (c1) if (c2) f(); else g();¿De cuál de los dos if es el else?
$ build/derive machines/dangling_else.cfg iiaea
w = iiaea
derivaciones por la izquierda: 2

1. S ⇒ iS ⇒ iiSeS ⇒ iiaeS ⇒ iiaea
   4 pasos
   S
   ├── i
   └── S
       ├── i
       ├── S
       │   └── a
       ├── e
       └── S
           └── a

2. S ⇒ iSeS ⇒ iiSeS ⇒ iiaeS ⇒ iiaea
   4 pasos
   S
   ├── i
   ├── S
   │   ├── i
   │   └── S
   │       └── a
   ├── e
   └── S
       └── a
En el primer árbol el else es del if de adentro: si c1 es falso no se ejecuta nada. En el segundo es del
if de afuera: si c1 es falso se ejecuta g(). Son dos programas distintos.
C, C++, Java y casi todos los lenguajes eligen el primero: el else va con el if más cercano que todavía
no tiene uno. Esa convención se puede escribir en la gramática, separando las instrucciones en las que todo
if tiene su else, que llamamos , de las que tienen algún if sin else, que llamamos :
La regla exige que lo que está entre un if y su else sea una instrucción
completa, sin ningún if suelto que pudiera reclamar ese else. Con esta gramática, que está en
machines/dangling_else_fixed.cfg, tiene una sola derivación por la izquierda,
que es la salida de build/derive machines/dangling_else_fixed.cfg iiaea: el if de afuera no tiene else, y
el de adentro sí.
En la práctica. Los lenguajes reales casi nunca escriben la gramática corregida, que es más difícil de leer. Dejan la ambigua y agregan la regla en palabras, y el parser la aplica: cuando puede elegir entre seguir leyendo un
elseo dar por terminado elif, sigue leyendo. Otros lenguajes evitan el problema desde la sintaxis: Python con la indentación, y Go y Rust exigiendo llaves en cada rama.
Lenguajes inherentemente ambiguos
En los dos ejemplos, una gramática ambigua se cambió por otra equivalente que no lo es. No siempre se puede. Un lenguaje libre de contexto es inherentemente ambiguo si todas las gramáticas que lo generan son ambiguas. Existen, y un ejemplo es el lenguaje de la sección Unir gramáticas:
Lo enunciamos sin demostrarlo: la demostración es larga y no la necesitaremos. La intuición sí se ve en la
gramática machines/abc_union.cfg. Una cadena con , como , está en las dos mitades de
la unión, y tiene un árbol por cada una:
$ build/derive machines/abc_union.cfg abc --sin-arboles
w = abc
derivaciones por la izquierda: 2

1. S ⇒ XC ⇒ aXbC ⇒ abC ⇒ abcC ⇒ abc
   5 pasos

2. S ⇒ AY ⇒ aAY ⇒ aY ⇒ abYc ⇒ abc
   5 pasos
Lo que el teorema dice es que ninguna otra gramática lo arregla: cualquier gramática de este lenguaje tiene alguna cadena con dos árboles.
Tampoco hay un algoritmo general que reciba una gramática y decida si es ambigua. Es un problema indecidible,
una palabra que tendrá un sentido preciso desde la semana 9; este resultado llega en la semana 10. Para una
gramática concreta se puede buscar
una cadena con dos árboles, como hace derive, y si aparece, la gramática es ambigua. Si no aparece entre las
cadenas cortas, eso no demuestra nada.
El problema de la pertenencia
La sesión B responde una sola pregunta, que se llama el problema de la pertenencia:
Con un DFA la pregunta equivalente no tenía dificultad: se sigue la única ejecución, un paso por símbolo, y se mira el estado final. Una gramática no trae un procedimiento así. La definición dice que si existe una derivación, y no dice cómo encontrarla.
El primer intento es buscarla: probar derivaciones, todas, hasta que alguna termine en . Es lo que hace
derive, que además descarta un camino en cuanto los terminales ya escritos a la izquierda no coinciden con
. Con las gramáticas de la sesión A funcionó. Con la segunda gramática de los paréntesis,
, pasa esto:
$ build/derive machines/parens_ss.cfg '()' --pasos 5 --sin-arboles
w = ()
derivaciones por la izquierda: 4 (la búsqueda se cortó: derivaciones de hasta 5 pasos, 20 como máximo)

1. S ⇒ SS ⇒ (S)S ⇒ ()S ⇒ ()
   4 pasos

2. S ⇒ SS ⇒ S ⇒ (S) ⇒ ()
   4 pasos

3. S ⇒ (S) ⇒ (SS) ⇒ (S) ⇒ ()
   4 pasos

4. S ⇒ (S) ⇒ ()
   2 pasos
La opción --pasos 5 le pone un tope a la búsqueda: solo mira derivaciones de hasta 5 pasos. Sin tope no
terminaría. La derivación 2 muestra por qué: usa y después
, y vuelve a donde empezó. Ese rodeo se puede repetir cuantas veces se quiera, así que la
cadena tiene infinitas derivaciones por la izquierda. Con el tope en 7 pasos el programa ya
encuentra 14.
Tener infinitas derivaciones de una cadena que sí se genera es incómodo. Lo grave es el otro caso: con una cadena que no se genera, como , la búsqueda sigue probando rodeos sin fin, y nunca puede responder “no”. Hay dos tipos de regla que permiten dar pasos sin avanzar:
- las reglas , , que acortan la forma: después de crecer con , la forma vuelve a encogerse;
- las reglas unitarias, , que cambian una variable por otra sin agregar nada. Con y se puede dar vueltas sin fin.
Sin esas reglas, cada paso de una derivación alarga la forma o convierte una variable en terminales, y eso no se puede hacer para siempre si la cadena final tiene símbolos. El plan de la sesión es ese:
- Mostrar que toda gramática se puede reescribir sin reglas y sin reglas unitarias, en una forma muy rígida, la forma normal de Chomsky. Con ella las derivaciones tienen una longitud conocida, y la búsqueda termina siempre.
- Ver que aun así la búsqueda tarda un tiempo exponencial.
- Cambiar la búsqueda por una tabla: el algoritmo CYK, que responde en tiempo polinomial.
La forma normal de Chomsky
Una gramática está en forma normal de Chomsky (Chomsky normal form) si cada una de sus reglas tiene una de estas formas:
A la derecha de una regla hay exactamente dos variables o exactamente un terminal. La única excepción es la regla , que hace falta cuando está en el lenguaje, porque ninguna de las otras dos formas puede generarla. Y como la variable inicial no aparece a la derecha de ninguna regla, esa regla solo se puede usar como el único paso de la derivación : nunca en medio de otra derivación.
Ninguna gramática de la sesión A está en esta forma. tiene tres símbolos a la derecha y mezcla terminales con variables, es unitaria, y en la variable inicial aparece a la derecha y tiene una regla . Una gramática en forma normal de Chomsky para es esta:
Es menos legible que , y no se pretende que una persona escriba así. La forma normal es para los algoritmos y para las demostraciones, que solo tienen que considerar dos formas de regla. La primera consecuencia es esta.
Teorema (longitud de las derivaciones). Sea una gramática en forma normal de Chomsky y sea con . Toda derivación de tiene exactamente pasos.
Demostración. Contando. Tomemos una derivación . Como , no usa la regla : esa regla solo se le puede aplicar a la variable inicial, que solo aparece en la primera forma, y aplicarla ahí da . Entonces cada paso usa una regla o una regla . Sean y cuántas veces se usa cada tipo.
- Un paso con alarga la forma en exactamente un símbolo, y un paso con no cambia su longitud. La forma empieza con longitud 1 y termina con longitud . Luego .
- Un paso con escribe exactamente un terminal, los pasos con no escriben ninguno, y un terminal ya escrito no se borra ni se cambia. La cadena final tiene terminales. Luego .
En total son pasos. ∎
Dicho con el árbol: es un árbol binario con hojas, que tiene nodos con dos hijos, más un nodo encima de cada hoja. La cadena vacía, cuando está en el lenguaje, tiene la derivación de un paso .
El teorema arregla el primer problema de la búsqueda. Para saber si genera alcanza con probar las
derivaciones de pasos, que son una cantidad finita: la búsqueda termina siempre, y puede responder
“no”. Queda el segundo problema, que es cuántas son. El programa search_cost busca así, con una gramática en
forma normal de Chomsky de los paréntesis balanceados, y cuenta cuántos pasos de derivación llega a probar. La
primera línea prepara esa gramática con el programa de la sección siguiente.
$ build/to_chomsky machines/parens_ss.cfg > build/parens_ss_cnf.cfg
$ build/search_cost build/parens_ss_cnf.cfg '()((' '()()((' '()()()((' '()()()()((' '()()()()()((' '()()()()()()((' '()()()()()()()((' '()()()()()()()()'
  n   respuesta    pasos probados   comprobaciones de CYK   cadena
  4   no genera                22                      80   ()((
  6   no genera                64                     280   ()()((
  8   no genera               179                     672   ()()()((
 10   no genera               513                    1320   ()()()()((
 12   no genera              1535                    2288   ()()()()()((
 14   no genera              4792                    3640   ()()()()()()((
 16   no genera             15496                    5440   ()()()()()()()((
 16   genera                   62                    5440   ()()()()()()()()
Las siete primeras cadenas son pares seguidos de : no están balanceadas, y la búsqueda solo lo descubre al final, después de agotar todas las maneras de derivar el comienzo. Cada vez que la cadena crece en dos símbolos, los pasos probados se multiplican por cerca de 3: es un crecimiento exponencial. A ese ritmo, la cadena de 100 símbolos del laboratorio pediría más de pasos. La última fila muestra que con una cadena que sí se genera la búsqueda puede tener suerte y encontrar pronto una derivación. El costo está en responder “no”.
La columna de CYK crece mucho más despacio, y no depende de la respuesta. Ese algoritmo es el final del capítulo. Antes hay que saber llevar cualquier gramática a la forma normal.
La conversión en cuatro pasos
Teorema. Todo lenguaje libre de contexto es generado por una gramática en forma normal de Chomsky.
Demostración. Por construcción. Dada una gramática cualquiera, se le aplican cuatro transformaciones, en este orden:
- agregar una variable inicial nueva;
- quitar las reglas ;
- quitar las reglas unitarias;
- partir las reglas largas y sacar los terminales de las reglas de dos símbolos.
De cada paso hay que decir qué se construye, por qué el lenguaje no cambia, y qué queda garantizado para los
pasos siguientes. Lo hacemos en las cuatro subsecciones que siguen, con un mismo ejemplo: la gramática
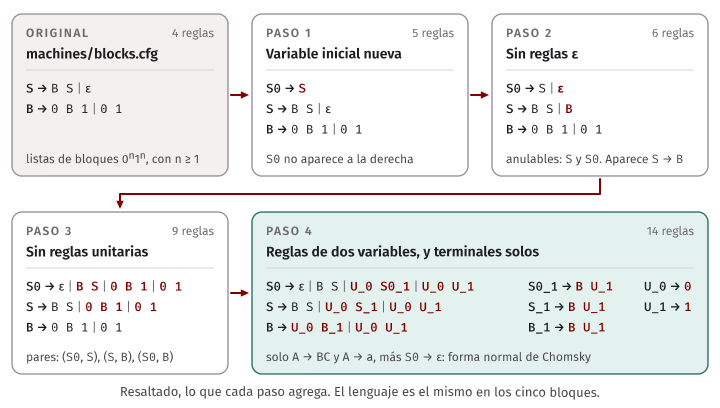
machines/blocks.cfg, que genera listas de bloques con , como
o .
El programa to_chomsky --pasos imprime la gramática después de cada paso. Su salida está repartida en las
subsecciones.
$ build/to_chomsky machines/blocks.cfg --pasos
La gramática original (4 reglas)
  S -> B S | eps
  B -> 0 B 1 | 0 1
Paso 1: una variable inicial nueva
Qué se construye. Se agrega una variable nueva , con la única regla , y pasa a ser la variable inicial.
Paso 1: variable inicial nueva (5 reglas)
  S0 -> S
  S -> B S | eps
  B -> 0 B 1 | 0 1
Por qué el lenguaje no cambia. Toda derivación desde empieza con , el único paso posible, y sigue como una derivación de la gramática original. Y toda derivación original se convierte en una nueva poniéndole ese paso delante.
Qué queda garantizado. La variable inicial no aparece a la derecha de ninguna regla. es nueva, así que ninguna regla anterior la menciona, y los pasos siguientes no la van a poner a la derecha. En el ejemplo se ve por qué importa: la original aparece en y tiene una regla , las dos cosas que la forma normal prohíbe juntas.
Paso 2: quitar las reglas ε
Una variable es anulable si . Las variables anulables se calculan marcando, como los estados alcanzables de un autómata:
- se marca si tiene la regla ;
- se marca si tiene una regla en la que todos los son variables ya marcadas;
- se repite hasta que no se pueda marcar ninguna más.
Las marcadas son exactamente las anulables. Una variable marcada deriva : lo hace con la regla que la marcó, seguida de las derivaciones de las variables que estaban marcadas antes. Y una variable que deriva termina marcada, por inducción sobre el número de pasos de esa derivación: su primer paso es una regla donde, por el lema de separación, cada deriva con menos pasos, así que cada es una variable que se marca, y entonces también.
En el ejemplo, es anulable por , y lo es por . no lo es.
Qué se construye. Por cada regla se ponen todas las reglas que se obtienen borrando algunas apariciones de variables anulables del lado derecho: ninguna, una, varias o todas, de todas las maneras posibles. La única que no se pone es la que queda con el lado derecho vacío. Así desaparecen todas las reglas . Al final, si la variable inicial es anulable, se le agrega la regla .
Paso 2: sin reglas ε (6 reglas)
  S0 -> S | eps
  S -> B S | B
  B -> 0 B 1 | 0 1
La regla tiene una aparición de una variable anulable, la de la derecha. Sin borrarla queda , y borrándola queda . La regla queda igual sin borrar, y borrando quedaría vacía, así que no se pone. La regla desaparece, y recibe la suya.
La idea es adelantar la decisión. En la gramática original, una derivación usaba y más tarde decidía que esa segunda desaparecía. En la nueva, lo decide en el momento de elegir la regla: usa y la nunca llega a escribirse.
Por qué el lenguaje no cambia. Llamemos a la gramática antes del paso y a la de después. Escribimos y para distinguir con cuál se deriva. Demostramos que para toda variable y toda cadena de terminales :
De derecha a izquierda. Cada regla de distinta de sale de una regla de borrando apariciones de variables anulables. En se puede hacer lo mismo con más pasos: , y después cada variable borrada se deriva en , lo que el lema del contexto permite. Entonces , y cada paso de una derivación de se reemplaza por varios de .
De izquierda a derecha. Por inducción sobre el número de pasos de . La derivación tiene al menos un paso, porque es una variable y no. Sea la regla de su primer paso. Por el lema de separación, con , cada una con menos pasos que la derivación completa. Miramos cada :
- si , entonces es una variable anulable, y la borramos;
- si y es un terminal, entonces , y lo dejamos;
- si y es una variable, la dejamos, y por la hipótesis de inducción sin usar .
Como , algún no es vacío y no se borró todo: lo que queda de es el lado derecho de una regla de . Con esa regla como primer paso, y derivando después cada símbolo que quedó en su , se obtiene .
Con , la equivalencia dice que y generan las mismas cadenas no vacías: la regla no agrega ninguna, porque no aparece a la derecha de ninguna regla, y entonces esa regla solo sirve para la derivación . Y sobre la cadena vacía: las demás reglas de tienen el lado derecho no vacío, así que sin una forma nunca se queda sin símbolos. Luego exactamente cuando se agregó esa regla, que es cuando es anulable, que es cuando .
Qué queda garantizado. No hay reglas , salvo quizá , y la variable inicial sigue sin aparecer a la derecha.
Este paso puede crear reglas unitarias. En el ejemplo apareció , que antes no estaba. Por eso el paso siguiente va después, y no antes.
Paso 3: quitar las reglas unitarias
Una regla unitaria dice que todo lo que puede hacer, también puede. La idea es darle a directamente las reglas de .
Decimos que es un par unitario si usando solo reglas unitarias. Todo es un par unitario, con cero pasos. Los pares se calculan marcando, igual que las variables anulables: se empieza con los , y si está marcado y es una regla unitaria, se marca .
En el ejemplo, las reglas unitarias son y . Los pares, además de los , son , y .
Qué se construye. Por cada par unitario y cada regla que no es unitaria, se pone la regla . Las reglas unitarias no se ponen.
Paso 3: sin reglas unitarias (9 reglas)
  S0 -> eps | B S | 0 B 1 | 0 1
  S -> B S | 0 B 1 | 0 1
B -> 0 B 1 | 0 1recibe sus propias reglas no unitarias, que es solo ; las de , por el par , que es ; y las de , por el par . recibe la suya y las de .
Por qué el lenguaje no cambia. Sean la gramática antes del paso y la de después. Demostramos que para toda variable y toda cadena de terminales : si y solo si .
De derecha a izquierda. Cada regla de viene de un par unitario y de una regla de . Entonces en se tiene , y cada paso de se reemplaza por varios de .
De izquierda a derecha. Por inducción sobre el número de pasos de , que es al menos 1. Miramos la regla del primer paso.
- No es unitaria: es . Como es un par unitario, la misma regla está en . Por el lema de separación, con en menos pasos, y por la hipótesis de inducción para cada variable . Juntando, .
- Es unitaria: es , y entonces con un paso menos. Por la hipótesis de inducción, . Esa derivación tiene un primer paso, con una regla de , que por construcción viene de un par unitario y una regla no unitaria de . Como es unitaria y es un par, también es un par unitario, y entonces está en . Cambiando el primer paso por y dejando el resto igual, queda .
Qué queda garantizado. No hay reglas unitarias. Tampoco aparecieron reglas nuevas: las reglas de son copias de lados derechos que ya estaban, y la única regla que había, , solo se le puede copiar a una variable con par unitario. Como no aparece a la derecha de ninguna regla, el único par así es . Y sigue sin aparecer a la derecha.
Después de este paso, cada regla es , o tiene a la derecha un solo terminal, o tiene dos o más símbolos.
Paso 4: partir las reglas largas
Quedan dos defectos: lados derechos con tres o más símbolos, y terminales mezclados en lados derechos de dos o más símbolos.
Qué se construye. Primero, cada regla con se cambia por una cadena de reglas de dos símbolos, con variables nuevas que no se usan en ningún otro lugar:
La variable significa “lo que falta de la regla”: . Después, en cada regla de dos símbolos, cada terminal se cambia por una variable nueva , y se agrega la regla . Hay una sola por terminal.
Paso 4: reglas de a lo sumo dos símbolos, y terminales solos (14 reglas)
  S0 -> eps | B S | U_0 S0_1 | U_0 U_1
  S -> B S | U_0 S_1 | U_0 U_1
  B -> U_0 B_1 | U_0 U_1
  S0_1 -> B U_1
  S_1 -> B U_1
  B_1 -> B U_1
  U_0 -> 0
  U_1 -> 1

Está en forma normal de Chomsky.
La regla se partió en y , y con los
terminales cambiados quedó y . El programa nombra B_1 a la primera variable nueva
de las reglas de B. Como y recibieron en el paso 3 una copia de esa regla, cada una tiene su propia
variable nueva, S0_1 y S_1, con el mismo lado derecho.
Por qué el lenguaje no cambia. Sean la gramática antes del paso y la de después.
Todo lo que deriva, lo deriva: un paso de con la regla se reemplaza por los pasos de la cadena de reglas nuevas, seguidos de un paso por cada terminal que se cambió.
Para el otro sentido, a cada variable de se le asigna lo que representa en : una variable original se representa a sí misma, representa la cadena de su regla, y representa el terminal . Escribimos para lo que representa , y de un terminal es él mismo. Mirando las reglas de una por una (salvo , que está igual en las dos gramáticas) se comprueba que, para cada regla o , se tiene o , con un paso si es una variable original (es su regla de ) y con cero si es nueva (los dos lados son la misma cadena). De ahí, por inducción sobre el número de pasos y con el lema de separación, igual que en los pasos anteriores: si , entonces . Con , que se representa a sí misma, todo lo que genera lo genera .
Qué queda garantizado. Cada regla tiene ahora a la derecha un solo terminal, o exactamente dos símbolos que son variables, o es . La variable inicial no aparece a la derecha. Eso es la forma normal de Chomsky, y como ningún paso cambió el lenguaje, la gramática final genera . ∎
El resultado y lo que cuesta
Sin opciones, to_chomsky escribe el resultado como un archivo .cfg, que se puede guardar o pasar a otro
programa:
$ build/to_chomsky machines/blocks.cfg
# machines/blocks.cfg en forma normal de Chomsky.
variables: S0 S B S0_1 S_1 B_1 U_0 U_1
terminals: 0 1
start: S0
rules:
S0 -> eps | B S | U_0 S0_1 | U_0 U_1
S -> B S | U_0 S_1 | U_0 U_1
B -> U_0 B_1 | U_0 U_1
S0_1 -> B U_1
S_1 -> B U_1
B_1 -> B U_1
U_0 -> 0
U_1 -> 1
La gramática pasó de 2 variables y 4 reglas a 8 variables y 14 reglas. Es el precio normal de la conversión. Las
pruebas de la semana convierten las catorce gramáticas de machines/ que no están ya convertidas y comprueban,
después de cada paso,
que la gramática sigue generando las mismas cadenas hasta cierta longitud, y que cumple lo que el paso
garantiza.
Error común. Quitar las reglas unitarias antes que las reglas . Quitar reglas crea reglas unitarias: de con anulable sale . Si las unitarias ya se quitaron, esas quedan en el resultado. Con la gramática , , , y los pasos 2 y 3 intercambiados:
$ build/to_chomsky machines/unit_order.cfg --unitarias-primero
La gramática original (5 reglas)
  S -> A B | a
  A -> a | eps
  B -> b

Paso 1: variable inicial nueva (6 reglas)
  S0 -> S
  S -> A B | a
  A -> a | eps
  B -> b

Paso 3 antes de tiempo: sin reglas unitarias (7 reglas)
  S0 -> A B | a
  S -> A B | a
  A -> a | eps
  B -> b

Paso 2, tarde: sin reglas ε (8 reglas)
  S0 -> A B | B | a
  S -> A B | B | a
  A -> a
  B -> b

Paso 4: reglas de a lo sumo dos símbolos, y terminales solos (8 reglas)
  S0 -> A B | B | a
  S -> A B | B | a
  A -> a
  B -> b

No está en forma normal de Chomsky. S0 -> B: es una regla unitaria.
El lenguaje sigue siendo el mismo, porque cada paso por separado es correcto. Lo que se pierde es la forma. En el otro sentido no hay problema: quitar reglas unitarias no crea reglas , como se vio en el paso 3.
El orden de los demás pasos también tiene su razón. El paso 1 va primero porque el paso 2 necesita una variable inicial que no aparezca a la derecha, para poder dejarle su regla sin que nadie más la use. El paso 4 se puede dejar para el final porque no crea reglas ni unitarias: lo que los pasos 2 y 3 limpiaron sigue limpio.
En la práctica. El paso 2 puede multiplicar las reglas. Una regla con apariciones de variables anulables a la derecha tiene maneras de borrar, y puede dejar casi reglas. Con reglas cortas no importa. Un programa que convierte gramáticas grandes parte primero las reglas largas y después quita las reglas : con lados derechos de a lo sumo dos símbolos, cada regla deja a lo sumo tres. Los ejercicios piden comprobar que ese otro orden también termina en la forma normal.
El algoritmo CYK
El algoritmo se llama CYK por Cocke, Younger y Kasami, que lo encontraron cada uno por su cuenta. Recibe una gramática en forma normal de Chomsky y una cadena de longitud , y decide si genera .
La idea es la programación dinámica sobre intervalos que vieron en Algoritmos: en lugar de preguntar solo por la cadena completa, se pregunta por todas sus subcadenas, de las más cortas a las más largas, y cada respuesta se guarda en una tabla para no calcularla dos veces. La búsqueda de la sección anterior tardaba tanto porque volvía a derivar el mismo trozo de la cadena una y otra vez, dentro de derivaciones distintas.
La tabla y su recurrencia
Numeramos los símbolos de la cadena desde 0: . Para , la subcadena de a es , con los dos extremos incluidos. La tabla tiene una celda por cada subcadena, y la celda guarda un conjunto de variables:
Esa es la definición de la tabla: lo que queremos que contenga. La respuesta al problema está en una sola celda: genera si y solo si , donde es la variable inicial. Lo que hace falta es una manera de calcular cada celda a partir de otras, y la forma normal de Chomsky la da.
Teorema (la recurrencia de CYK). Sea una gramática en forma normal de Chomsky. Para toda cadena de longitud y todos los :
y, si ,
La segunda igualdad dice: genera la subcadena de a si se la puede cortar en dos trozos no vacíos, de a y de a , de modo que alguna regla tenga una que genera el primero y una que genera el segundo. El número es el punto de corte: la última posición del primer trozo.
Demostración. Antes, una observación. En forma normal de Chomsky, si no es la variable inicial y con una cadena de terminales, entonces . La razón: la única regla que acorta una forma es , y solo se le aplica a la variable inicial, que no aparece en ninguna forma derivada de , porque no está a la derecha de ninguna regla. Las demás reglas no acortan, así que una forma que empieza con un símbolo nunca queda vacía.
Primera igualdad. Si es una regla, entonces y . Al revés, si , miramos la regla del primer paso. No es , que daría la cadena vacía. No es una regla : por el lema de separación, se partiría en un trozo de y otro de , los dos no vacíos por la observación, y tiene un solo símbolo. Entonces es una regla , la derivación termina ahí, y .
Segunda igualdad, de derecha a izquierda. Si hay una regla y un con y , entonces, por el lema del contexto,
y .
Segunda igualdad, de izquierda a derecha. Sea con : deriva una cadena de al menos dos símbolos. La regla del primer paso no es , ni es , que daría un solo símbolo. Es una regla , y . Por el lema de separación, esa subcadena se parte en con y . Como y no son la variable inicial, la observación dice que e no son vacías. Entonces para algún con , e . Eso es y . ∎
La demostración usó las tres condiciones de la forma normal. Que no haya reglas garantiza que los dos trozos no son vacíos, y por eso son más cortos que la subcadena completa. Que no haya reglas unitarias garantiza que una celda no depende de sí misma. Que cada regla tenga dos variables a la derecha garantiza que alcanza con un punto de corte.
Para la cadena vacía no hay tabla, porque no hay ninguna celda. Se responde aparte: genera si y solo si es una de sus reglas.
El algoritmo
La recurrencia calcula una celda de una subcadena de longitud a partir de celdas de subcadenas más cortas. Entonces la tabla se llena por longitudes crecientes: primero todas las celdas de longitud 1, después las de longitud 2, y así hasta la única celda de longitud .
algoritmo CYK(G, w)
    n ← longitud de w
    si n = 0 entonces
        devolver (S → ε es una regla de G)
    fin si
    para i desde 0 hasta n - 1
        T[i][i] ← { A : A → w[i] es una regla de G }
    fin para
    para largo desde 2 hasta n
        para i desde 0 hasta n - largo
            j ← i + largo - 1
            T[i][j] ← ∅
            para k desde i hasta j - 1
                para cada regla A → B C de G
                    si B está en T[i][k] y C está en T[k+1][j] entonces
                        agregar A a T[i][j]
                    fin si
                fin para
            fin para
        fin para
    fin para
    devolver (S está en T[0][n-1])
fin algoritmo
El algoritmo es correcto porque calcula exactamente los conjuntos del teorema: por inducción sobre el largo, cuando llega a la celda ya están calculadas las celdas y que consulta, que son de subcadenas más cortas.
Error común. Llenar la tabla por filas, , y dentro de cada fila por columnas. La celda consulta , , y , que están en filas de abajo y todavía estarían vacías. El orden es por longitud de la subcadena. Si se prefiere recorrer por filas, hay que hacerlo de abajo hacia arriba, con de a .
La tabla, llena a mano
El ejemplo es la cadena , de cinco símbolos, con la gramática ambigua de expresiones
convertida a forma normal de Chomsky. La conversión la hace to_chomsky, y el resultado está guardado en
machines/expr_ambiguous_chomsky.cfg:
$ build/to_chomsky machines/expr_ambiguous.cfg
# machines/expr_ambiguous.cfg en forma normal de Chomsky.
variables: E0 E E0_1 E0_2 E0_3 E_1 E_2 E_3 U_+ U_* U_( U_)
terminals: a + * ( )
start: E0
rules:
E0 -> E E0_1 | E E0_2 | U_( E0_3 | a
E -> E E_1 | E E_2 | U_( E_3 | a
E0_1 -> U_+ E
E0_2 -> U_* E
E0_3 -> E U_)
E_1 -> U_+ E
E_2 -> U_* E
E_3 -> E U_)
U_+ -> +
U_* -> *
U_( -> (
U_) -> )
Para leerla: E_1 es “un y una expresión”, lo que falta de la regla después de su primera
. E_2 es “un y una expresión”, y E_3 es “una expresión y un paréntesis que cierra”. La variable
inicial E0 tiene una copia de las reglas de E, con sus propias variables E0_1, E0_2, E0_3.
Los símbolos de la cadena son , , , , .
Longitud 1. Cada celda tiene las variables con la regla . Para son E0 y
E. Para es U_+, y para es U_*.
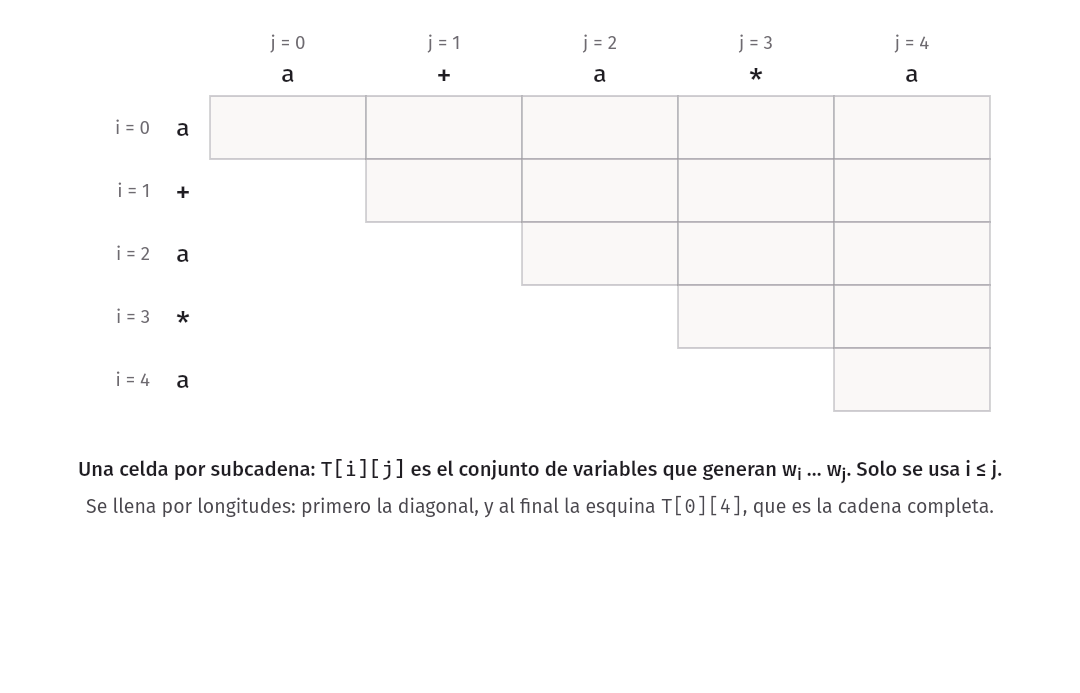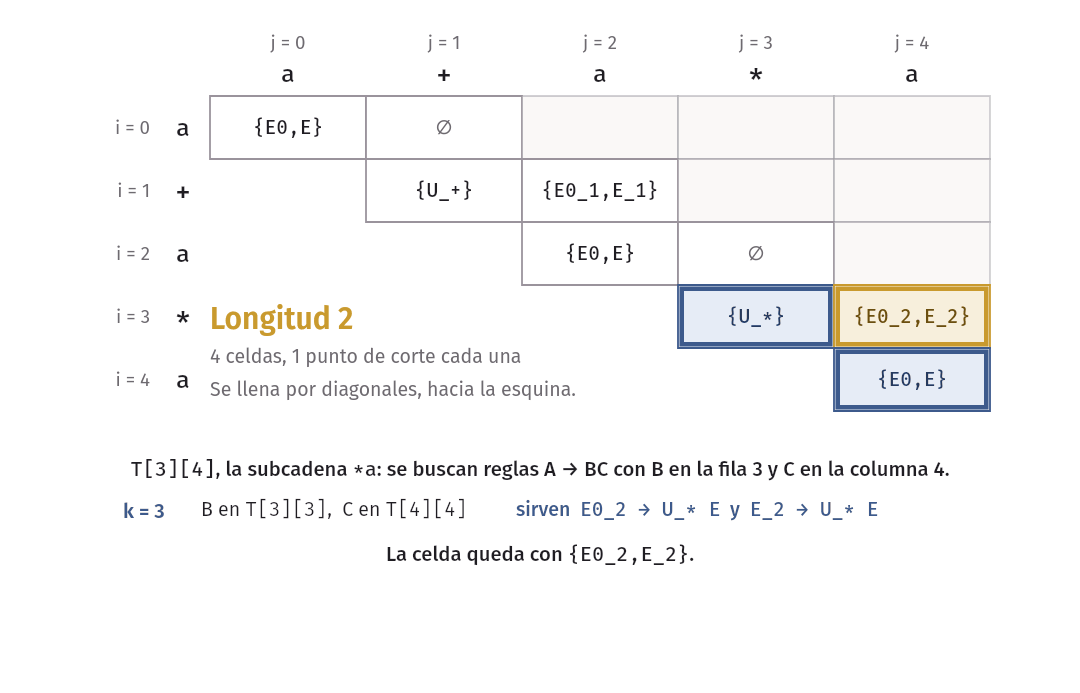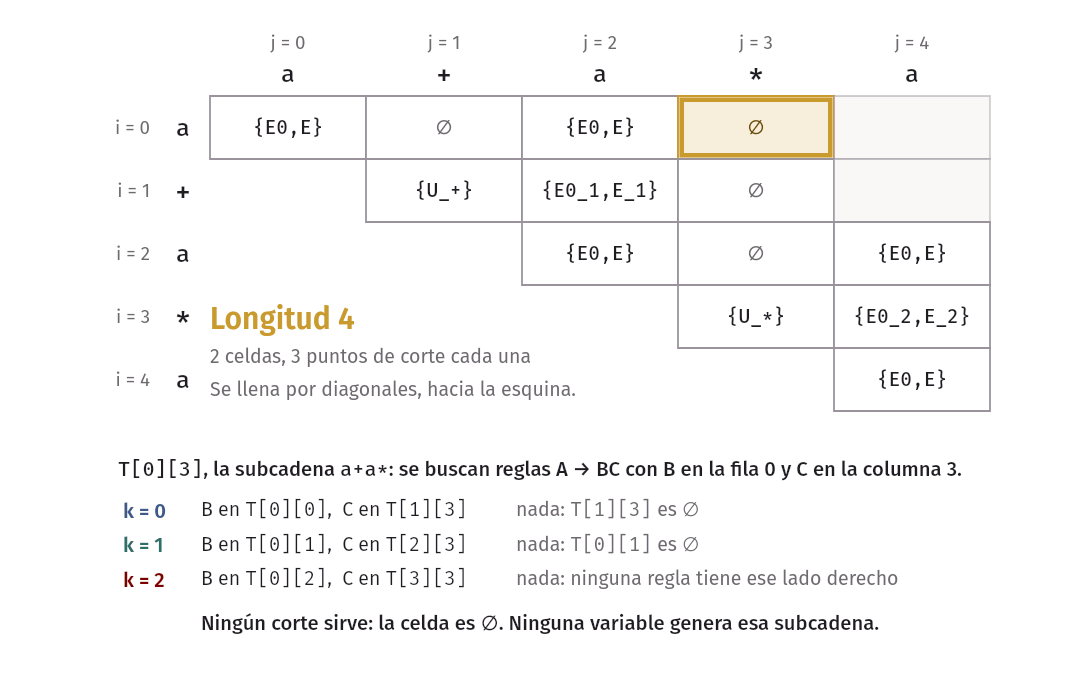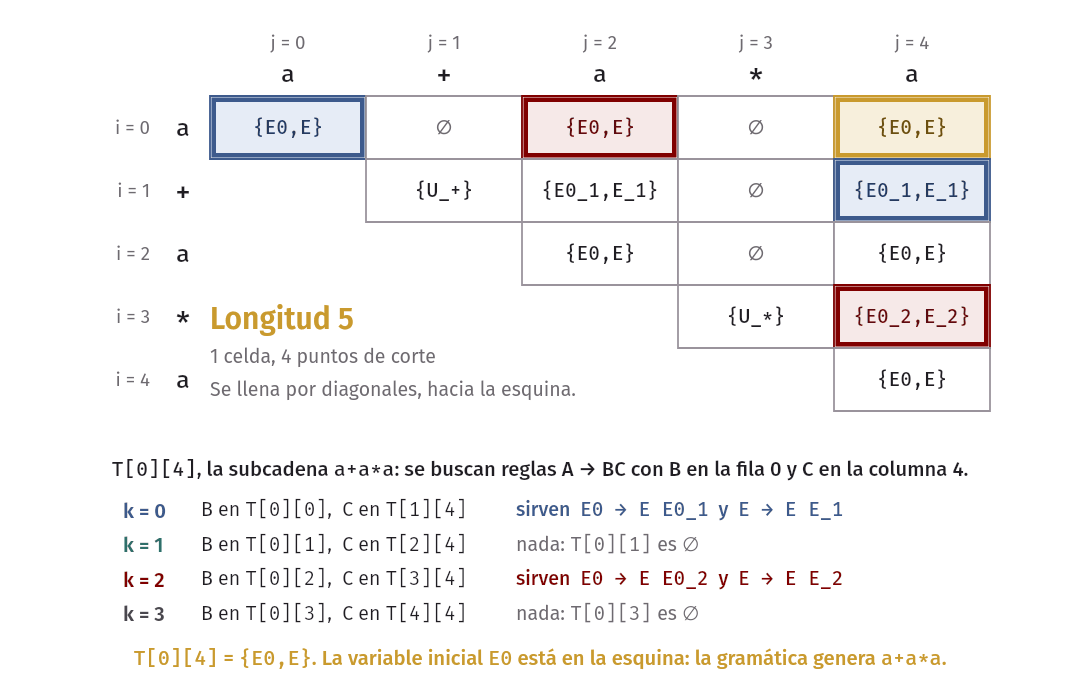
Longitud 2. Cada celda tiene un solo punto de corte.
- , la subcadena : se buscan reglas con en , que tiene
E0yE, y en , que tieneU_+. No hay ninguna regla conE U_+ni conE0 U_+a la derecha: la celda es . Ninguna variable genera , que no es una expresión ni un trozo con nombre. - , la subcadena : con igual a
U_+y igual aEestán las reglasE0_1 -> U_+ EyE_1 -> U_+ E. La celda tieneE0_1yE_1. - , la subcadena : , como .
- , la subcadena : tiene
E0_2yE_2, por las reglas conU_* Ea la derecha.
Longitud 3. Dos puntos de corte por celda.
- , la subcadena . Con : en , que tiene
E0yE, y en , que tieneE0_1yE_1. Las reglasE0 -> E E0_1yE -> E E_1sirven. Con : , nada. La celda tieneE0yE: es una expresión. - , la subcadena . Con hace falta en , que es . Con
, sería
E0_1oE_1y seríaU_*, y ninguna regla tiene ese lado derecho. La celda es . - , la subcadena : con sirven las reglas
E0 -> E E0_2yE -> E E_2, y con no hay nada porque . La celda tieneE0yE.
Longitud 4. Tres puntos de corte por celda.
- , la subcadena : con hace falta , que es ; con
, ; con , sería
E0oEy seríaU_*, sin regla. La celda es . - , la subcadena : con , es
U_+y en estáE. Las reglasE0_1 -> U_+ EyE_1 -> U_+ Esirven. Con no hay regla conE_1oE0_1seguida deE_2oE0_2, y con , . La celda tieneE0_1yE_1.
Longitud 5. La celda , con cuatro puntos de corte.
- : en , que tiene
E0yE, y en , que tieneE0_1yE_1. SirvenE0 -> E E0_1yE -> E E_1. Es la lectura más . - : .
- : en , que tiene
E0yE, y en , que tieneE0_2yE_2. SirvenE0 -> E E0_2yE -> E E_2. Es la lectura por . - : .
La celda tiene E0 y E. La variable inicial E0 está en : la gramática genera la cadena. El
programa cyk llena la misma tabla:
$ build/cyk machines/expr_ambiguous_chomsky.cfg 'a+a*a'
w = a+a*a, n = 5
       j=0 a       j=1 +       j=2 a       j=3 *       j=4 a
i=0  a {E0,E}      ∅           {E0,E}      ∅           {E0,E}
i=1  +             {U_+}       {E0_1,E_1}  ∅           {E0_1,E_1}
i=2  a                         {E0,E}      ∅           {E0,E}
i=3  *                                     {U_*}       {E0_2,E_2}
i=4  a                                                 {E0,E}
E0 está en T[0][4]: genera
comprobaciones de reglas A → BC: 240
árboles de derivación: 2. Uno de ellos:
E0
├── E
│   └── a
└── E0_1
    ├── U_+
    │   └── +
    └── E
        ├── E
        │   └── a
        └── E_2
            ├── U_*
            │   └── *
            └── E
                └── a
[E0 [E a] [E0_1 [U_+ +] [E [E a] [E_2 [U_* *] [E a]]]]]
La fila y la columna tienen la celda . Solo se usa la mitad de arriba de la diagonal, porque . La diagonal son las subcadenas de un símbolo, y la esquina de arriba a la derecha es la cadena completa. Llenar por longitudes es llenar por diagonales, desde la principal hacia esa esquina.
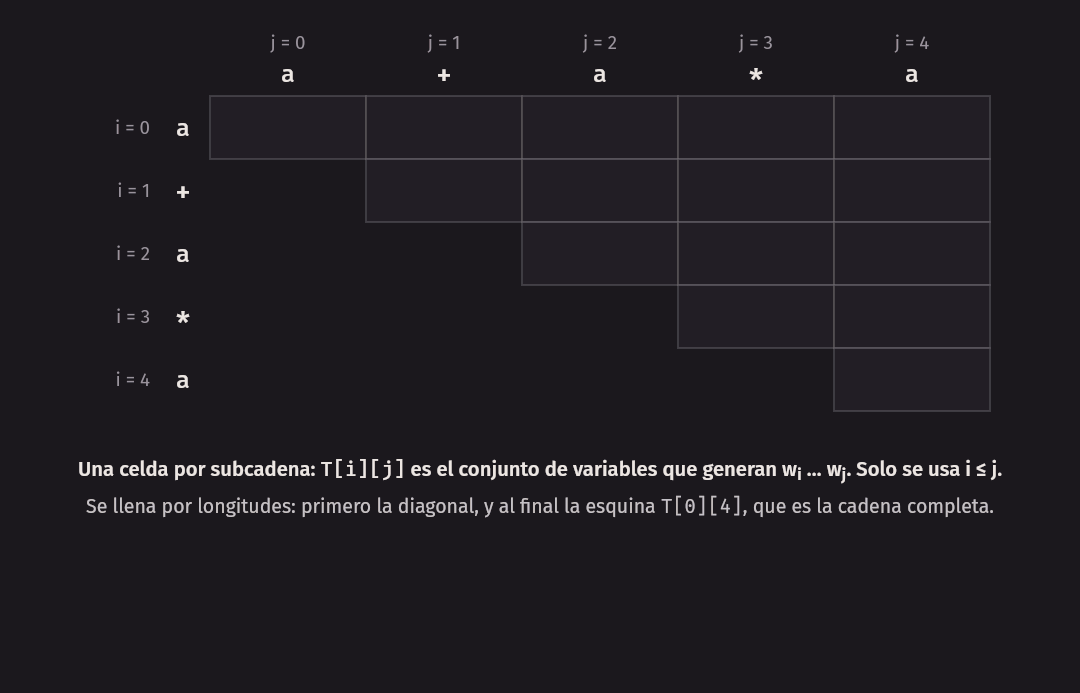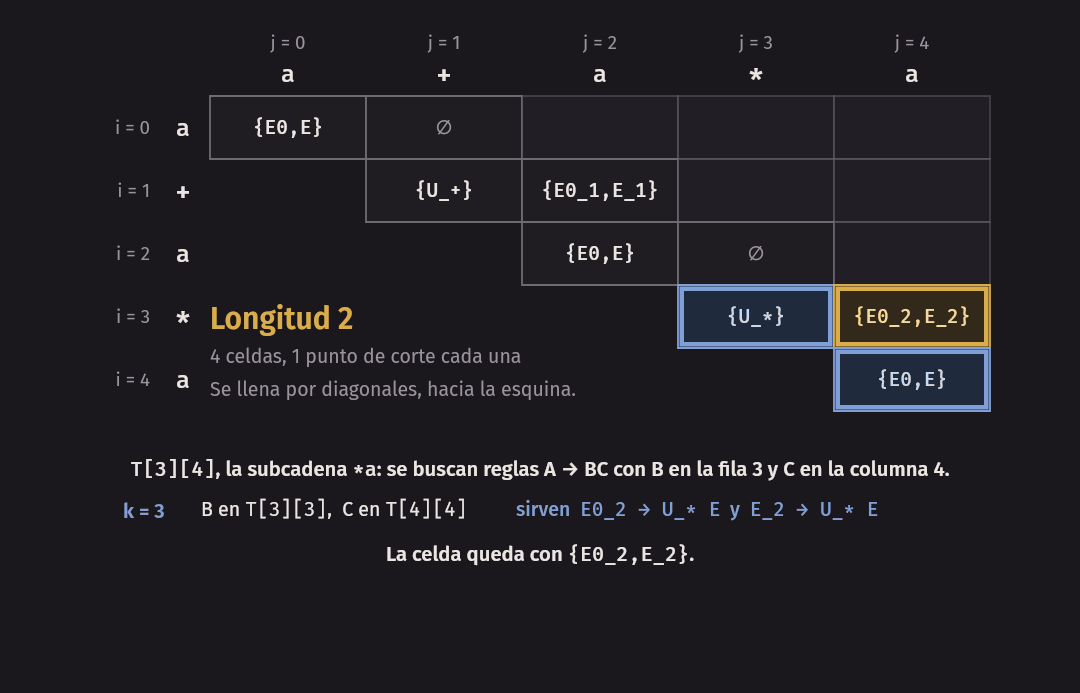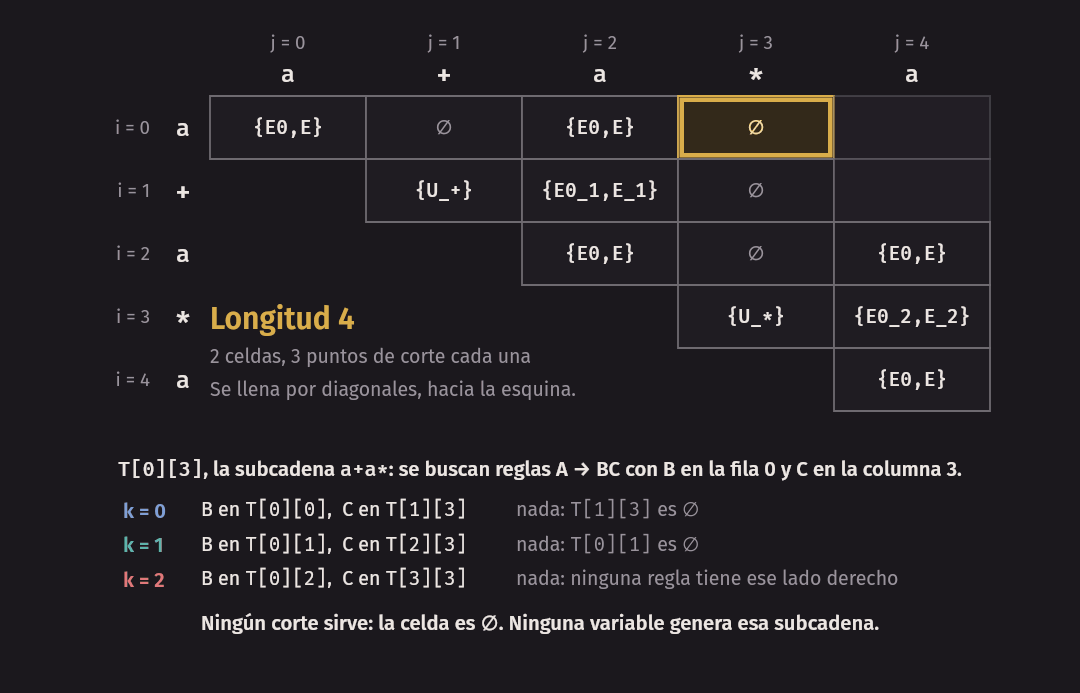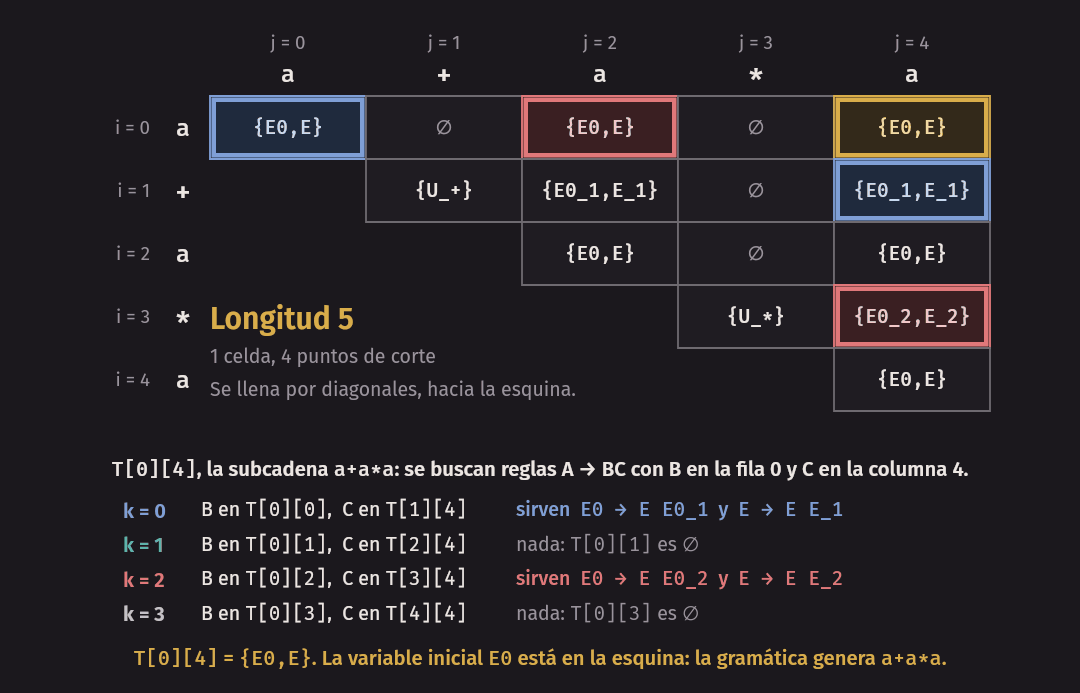
Idea clave. CYK no busca una derivación de la cadena. Calcula, para cada subcadena, todas las variables que la generan, de las subcadenas más cortas a las más largas. Cada celda se calcula una vez, y todas las derivaciones que pasan por esa subcadena la comparten.
Recuperar el árbol
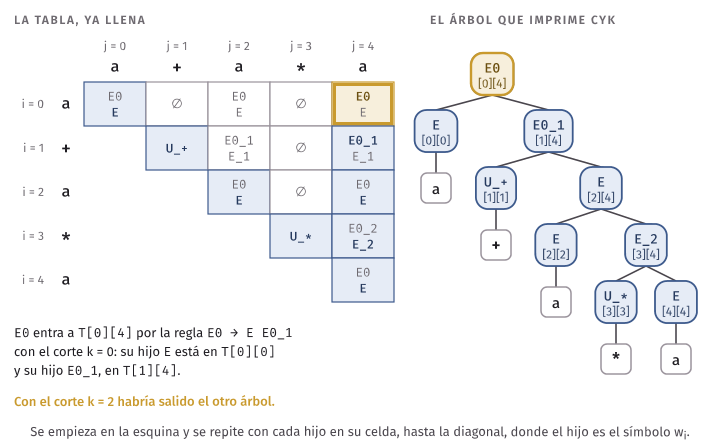
La tabla dice que la cadena se genera, y con un poco más de trabajo dice cómo. Cada vez que una variable entra a la celda es por una regla y un punto de corte . Esos tres datos son un nodo del árbol: arriba, con un hijo para la subcadena de a y un hijo para la de a .
Para armar el árbol se empieza en la variable inicial y la celda , se busca una regla y un corte
que justifiquen esa entrada, y se repite con cada hijo en su celda, hasta llegar a las celdas de la diagonal,
donde el nodo es con un solo hijo, el terminal . La regla y el corte se pueden guardar al llenar la
tabla o, como hace chomsky.h, se vuelven a buscar al armar el árbol: para cada nodo hay que revisar a lo sumo
todos los cortes y todas las reglas una vez.
El árbol que imprimió cyk salió del corte de la celda , el primero que encuentra. Es la
lectura . Con el corte habría salido el otro. La celda
tiene a E0 por dos caminos, y cada camino es un árbol: la ambigüedad de la gramática se ve en
la tabla como una variable que entra a una celda de más de una manera. El programa cuenta los árboles con la
misma tabla, guardando en cada celda cuántos árboles tiene cada variable en lugar de un sí o un no, y por eso
informa árboles de derivación: 2, los mismos dos que encontró derive en la sesión A.
El árbol es de la gramática convertida, con sus variables auxiliares. Para tener el árbol de la gramática
original se deshacen los pasos: un nodo E0_1 con hijos U_+ y E vuelve a ser parte de la regla
de su padre.
En C++. En
chomsky.hla tabla es unstd::vector<std::vector<std::set<std::string>>>:cell[i][j]es el conjunto de nombres de variables de , tal como en la definición. Preguntar si una variable está en una celda escell[i][k].count(B) > 0, que compara nombres. Para los ejemplos del capítulo sobra. En el laboratorio, donde importa el tiempo, conviene numerar las variables y guardar cada celda como unstd::vector<bool>o como los bits de un entero.
El costo de CYK
Sea la longitud de la cadena y el número de reglas de la gramática.
Las celdas. Hay una por cada par : son .
El trabajo por celda. Una celda de una subcadena de longitud tiene puntos de corte, y por cada uno se revisan las reglas. Hay subcadenas de longitud , una por cada posición donde puede empezar. El número total de pares de celda y punto de corte es
La suma se comprueba por inducción, o contando de otra manera: elegir una celda y un punto de corte es elegir
tres posiciones , es decir, tres números distintos entre y , y hay
maneras. Para son pares. La gramática del ejemplo tiene
reglas de dos variables, y , el número de comprobaciones que informó cyk.
El total. Cada comprobación pregunta si está en una celda y en otra. Si esa pregunta cuesta tiempo constante, CYK hace
pasos, donde es el número de reglas , que se revisan una vez por cada celda de la diagonal. Si es el tamaño de la gramática, que en forma normal de Chomsky es proporcional a su número de reglas, el costo es
Para una gramática fija es : polinomial en la longitud de la cadena. Recuperar un árbol agrega menos que eso: tiene nodos internos, y en cada uno se revisan a lo sumo cortes y reglas. La memoria es la tabla: celdas con a lo sumo variables cada una.
Comparen con la tabla de search_cost: para , la búsqueda probó 15 496 pasos de derivación y CYK hizo
5440 comprobaciones. Para , CYK con esa gramática de 8 reglas de dos variables hace
comprobaciones. La búsqueda, multiplicando por 3 cada dos símbolos, ya
no termina en un tiempo razonable.
Si la gramática no viene en forma normal, primero se convierte. Eso se hace una sola vez por gramática, no una vez por cadena, y entonces el problema de la pertenencia se resuelve en tiempo polinomial para todo lenguaje libre de contexto. En el vocabulario de la última parte del curso: todo lenguaje libre de contexto está en la clase P.
Por qué hace falta la forma normal
CYK no es un algoritmo para gramáticas cualesquiera, y cada condición de la forma normal sostiene una parte.
- Con una regla haría falta partir la subcadena en tres trozos: dos puntos de corte. Cada celda revisaría del orden de pares de cortes en lugar de , y el costo subiría a . Con reglas más largas, más todavía. El paso 4 de la conversión hace ese trabajo una vez, en la gramática, y deja el algoritmo en .
- Con reglas , uno de los trozos podría ser vacío y el otro sería la subcadena entera: la celda dependería de sí misma.
- Con una regla unitaria , la variable entra a una celda porque está en la misma celda. Otra vez una celda que depende de sí misma, y habría que repetir el cálculo de cada celda hasta que deje de cambiar.
Por qué los compiladores no usan CYK
es polinomial, y para un compilador sigue siendo demasiado. Un archivo de código tiene decenas de miles de tokens, que son los símbolos que ve el parser. Con , es , por cada archivo y en cada compilación.
Los compiladores no lo necesitan, porque no reciben una gramática cualquiera. Las gramáticas de los lenguajes
de programación se diseñan para que el parser pueda leer la entrada una sola vez, de izquierda a derecha, y
decidir qué regla aplicar mirando solo el siguiente token o unos pocos. Para esas gramáticas hay parsers que
trabajan en tiempo lineal, . Los niveles de precedencia de la sesión A y la regla del else son
parte de ese diseño: una gramática sin ambigüedad y con una sola regla posible en cada momento. La semana
próxima aparece la máquina que hay detrás, el autómata de pila.
CYK y los algoritmos de su familia quedan para cuando la gramática no se puede elegir: gramáticas ambiguas por naturaleza, como las de los idiomas, donde una oración puede tener varios árboles y se quieren todos, y herramientas que deben aceptar cualquier gramática que el usuario escriba.
El código de la semana
code/week-05/
├── cfg.h                 struct Cfg, lectura del formato .cfg, L(G) hasta una longitud,
│                         derivaciones por la izquierda y árboles
├── chomsky.h             los cuatro pasos de la conversión, CYK, el árbol y el conteo de árboles
├── predicates.h          cada lenguaje del capítulo como una función que mira la cadena
├── show_cfg.cpp          muestra un .cfg como cuádrupla y lista sus cadenas más cortas
├── derive.cpp            las derivaciones por la izquierda de una cadena, con sus árboles
├── to_chomsky.cpp            la conversión a forma normal de Chomsky, paso por paso
├── cyk.cpp               la tabla de CYK, la respuesta y un árbol
├── search_cost.cpp       pasos de la búsqueda de derivaciones contra comprobaciones de CYK
├── machines/             las gramáticas del capítulo, en formato .cfg
├── errors/               tres descripciones que no son una gramática
├── test_cfg.cpp          el formato, y cada gramática contra su predicado
├── test_ambiguity.cpp    derivaciones, árboles y cuántos árboles tiene cada ejemplo
├── test_chomsky.cpp      cada paso de la conversión conserva el lenguaje; los 2n − 1 pasos
├── test_cyk.cpp          CYK contra las otras dos maneras de decidir; la tabla del ejemplo
└── lab/cyk_parser/       el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Tardan más que las de otras semanas,
porque revisan muchas cadenas.
$ make test
test_cfg: ok (12 gramáticas, 328933 cadenas comparadas con su predicado)
test_ambiguity: ok
test_chomsky: ok (14 gramáticas convertidas, 280 derivaciones de 2n − 1 pasos)
test_cyk: ok (12 gramáticas, 13079 cadenas)
Todas las pruebas pasaron.
Las pruebas comprueban con assert lo que este capítulo afirma. test_cfg compara cada gramática con una
función de C++ que decide el mismo lenguaje sin usar la gramática, sobre todas las cadenas hasta una longitud
(entre 7 y 12 símbolos, según el tamaño del alfabeto), y revisa la forma
de la demostración. test_ambiguity comprueba que tiene dos derivaciones por la
izquierda con la gramática ambigua y una con la de niveles, lo mismo para el else colgante, y que las
gramáticas que llamamos no ambiguas tienen una sola derivación por la izquierda para cada cadena corta.
test_chomsky convierte todas las gramáticas, comprueba que cada paso conserva el lenguaje y deja lo que
promete, que el orden equivocado deja una regla unitaria, y que las derivaciones en forma normal tienen
pasos. test_cyk comprueba que CYK responde lo mismo que el predicado y que el cálculo directo de
, que el número de comprobaciones es , que el árbol recuperado es un árbol de derivación de
la cadena con nodos internos, y la tabla del ejemplo celda por celda.
Para saber qué cadenas genera una gramática, cfg.h no busca derivaciones, que como vimos puede no terminar.
Calcula, para cada variable, el conjunto de las cadenas de hasta cierta longitud que genera: empieza con
conjuntos vacíos y aplica las reglas hasta que ningún conjunto crece. Es la misma idea de CYK, de abajo hacia
arriba, y termina siempre porque hay una cantidad finita de cadenas de esa longitud.
Los archivos de machines/ son:
| Archivo | Lenguaje | Para qué se usa |
|---|---|---|
zeros_ones.cfg |
Primer ejemplo y primera demostración | |
palindromes.cfg |
Palíndromos sobre | Diseño |
parens.cfg |
Paréntesis balanceados, | Diseño; laboratorio |
parens_ss.cfg |
Paréntesis balanceados, con | Búsqueda que no termina |
equal_ab.cfg |
Igual número de y de | Segunda demostración |
abc_union.cfg |
Unión; lenguaje inherentemente ambiguo | |
even_ones.cfg |
Cantidad par de unos | De un DFA a una gramática |
two_derivations.cfg |
Dos derivaciones, un árbol | |
expr_ambiguous.cfg |
Expresiones aritméticas | Ambigüedad |
expr_precedence.cfg |
Expresiones aritméticas | Niveles de precedencia |
dangling_else.cfg |
Instrucciones con if y else |
El else colgante |
dangling_else_fixed.cfg |
Instrucciones con if y else |
El else colgante, resuelto |
blocks.cfg |
Listas de bloques | Ejemplo de la conversión |
unit_order.cfg |
El orden de los pasos 2 y 3 | |
expr_ambiguous_chomsky.cfg |
Expresiones aritméticas | Ejemplo de CYK, ya en forma normal |
Los programas se encadenan. Para probar CYK con cualquier gramática, se convierte y se le pasa el resultado por
la entrada estándar, con - en lugar del nombre del archivo:
$ build/to_chomsky machines/blocks.cfg | build/cyk - 0101
w = 0101, n = 4
       j=0 0     j=1 1     j=2 0     j=3 1
i=0  0 {U_0}     {S0,S,B}  ∅         {S0,S}
i=1  1           {U_1}     ∅         ∅
i=2  0                     {U_0}     {S0,S,B}
i=3  1                               {U_1}
S0 está en T[0][3]: genera
comprobaciones de reglas A → BC: 110
árboles de derivación: 1. Uno de ellos:
S0
├── B
│   ├── U_0
│   │   └── 0
│   └── U_1
│       └── 1
└── S
    ├── U_0
    │   └── 0
    └── U_1
        └── 1
[S0 [B [U_0 0] [U_1 1]] [S [U_0 0] [U_1 1]]]
La última línea es el mismo árbol escrito en una línea, con un par de corchetes por nodo. Es el formato que pide el laboratorio.
El laboratorio
En lab/cyk_parser está el enunciado, un esqueleto y los casos. El problema es escribir un parser con CYK: la
entrada es una gramática en forma normal de Chomsky, en formato .cfg, seguida de una lista de cadenas, y la
salida dice por cada cadena genera o no genera, con un árbol de derivación para las que se generan.
cd lab/cyk_parser
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Como una cadena puede tener varios árboles, el juez no compara el árbol con uno fijo. Usa un verificador que
comprueba que el árbol entregado es un árbol de derivación de la cadena: que la raíz es la variable inicial,
que cada nodo con sus hijos es una regla, y que las hojas forman la cadena. Los casos incluyen la cadena vacía
con y sin la regla , una gramática que no genera nada, variables sin reglas, y cadenas de
100 símbolos con las que una búsqueda de derivaciones da TLE. solution.cpp se escribe sin incluir cfg.h
ni chomsky.h: pueden leerlos, pero el CYK del laboratorio es el suyo, y tiene que ser más rápido que el de
los ejemplos.
Resumen
- Una gramática libre de contexto es : variables, terminales, reglas y una variable inicial. Describe un lenguaje diciendo cómo generar sus cadenas.
- Un paso de derivación reemplaza una variable por el lado derecho de una de sus reglas: . es el conjunto de las cadenas de terminales con .
- Lo que una variable genera no depende de lo que la rodea. Una derivación se separa en derivaciones independientes, una por símbolo: el lema de separación.
- Un árbol de derivación guarda qué regla se aplicó a cada variable, sin el orden. Cada árbol corresponde a una sola derivación por la izquierda.
- Diseñar una gramática es decir cómo se arma una cadena del lenguaje con otras más cortas. Dejar la variable en medio, como en , empareja lo de la izquierda con lo de la derecha.
- Todo lenguaje regular es libre de contexto: de un DFA sale una gramática con una variable por estado. Los lenguajes libres de contexto son cerrados bajo unión, concatenación y estrella.
- se demuestra con dos inclusiones: toda cadena de se deriva, por inducción sobre la cadena, y toda cadena derivada está en , por inducción sobre el número de pasos, describiendo las formas.
- Una gramática es ambigua si alguna cadena tiene dos árboles distintos, o dos derivaciones por la izquierda. Tener dos derivaciones cualesquiera no es ser ambigua.
- La ambigüedad es de la gramática. La de las expresiones se quita con un nivel por operador, que da la
precedencia, y recursión de un solo lado, que da la asociatividad. El
elsecolgante se resuelve con la convención delifmás cercano. Hay lenguajes inherentemente ambiguos. - El problema de la pertenencia: dadas y , ¿ genera ? Buscar derivaciones puede no terminar, por las reglas y las unitarias.
- Forma normal de Chomsky: solo reglas y , más si hace falta, y la variable inicial no aparece a la derecha. Una derivación de una cadena de longitud tiene exactamente pasos.
- Toda gramática se convierte en cuatro pasos, en orden: variable inicial nueva, quitar reglas , quitar reglas unitarias, partir las reglas largas. Quitar reglas crea unitarias, y por eso va antes.
- CYK llena una tabla: es el conjunto de variables que generan la subcadena de a . Las celdas de un símbolo salen de las reglas , y las demás de las reglas con un punto de corte. Se llena por longitudes crecientes, y genera si .
- De la tabla se recupera un árbol, y una variable que entra a una celda de dos maneras son dos árboles.
- El costo es . Todo lenguaje libre de contexto se decide en tiempo polinomial. Los compiladores usan parsers lineales, porque diseñan sus gramáticas para eso.
Ejercicios
- Con la gramática de los palíndromos, escriban una derivación de y dibujen su árbol. ¿Cuántos
pasos tiene? ¿Cuántas derivaciones distintas tiene esa cadena, y por qué? Comprueben con
build/derive machines/palindromes.cfg abbba. Después den la fórmula del número de pasos de la derivación de un palíndromo de longitud . - Diseñen una gramática para cada lenguaje, y escríbanla como archivo
.cfgpara listar sus cadenas conshow_cfg: (a) ; (b) ; (c) ; (d) las cadenas sobre que no son palíndromos. Para (c), piensen en una unión. - Den una gramática para sin mirar la
del capítulo, y después compárenla con
machines/abc_union.cfg. Con la del capítulo: ¿qué cadenas tienen dos árboles? Demuestren que son exactamente las que tienen , y que ninguna cadena tiene tres. - Demuestren, con las dos inclusiones, que la gramática de los palíndromos genera exactamente . Para la segunda inclusión, describan todas las formas que se derivan de .
- Demuestren la afirmación que quedó pendiente en De un DFA a una gramática: si y solo
si . Concluyan que la gramática genera . Después construyan la gramática del DFA de
la semana 1 que reconoce las cadenas que terminan en , y pruébenla con
show_cfg. - Demuestren que genera exactamente los paréntesis balanceados. Para la inclusión difícil usen la cantidad de la demostración del capítulo, ahora como paréntesis abiertos menos cerrados, y el primer con .
- La gramática es ambigua. (a) Den dos árboles para
que no usen la regla más que debajo de un paréntesis. (b) Muestren que
tiene infinitos árboles. ¿Qué dos reglas lo permiten? (c) Corran
deriveconmachines/parens.cfgy varias cadenas: ¿cuántos árboles tiene cada una? Expliquen por qué no deja elegir. - Amplíen la gramática de expresiones con niveles para que tenga resta y división, con la precedencia y la
asociatividad usuales, y un operador de potencia
^que tenga más precedencia que el producto y asocie por la derecha:a^a^aesa^(a^a). Escríbanla como archivo y comprueben conderivequea-a-aya^a^atienen un solo árbol cada una, y que es el correcto. - Conviertan a forma normal de Chomsky, a mano, mostrando
los cuatro pasos. Digan cuáles son las variables anulables y los pares unitarios. Comprueben con
to_chomsky --pasos: su resultado puede tener otros nombres, pero las mismas reglas. - Con la gramática del ejercicio anterior ya convertida, llenen a mano la tabla de CYK para y
para . Recuperen un árbol de la primera. ¿Cuántos árboles tiene? Comprueben con
cyk. - ¿Por qué CYK necesita la forma normal de Chomsky? Escriban la recurrencia que haría falta para una regla y calculen cuánto costaría llenar la tabla. Después expliquen qué celda dependería de sí misma con una regla unitaria, y con una regla .
- El paso 2 puede multiplicar las reglas. (a) ¿Cuántas reglas deja la regla si , y
son anulables? Cuenten los lados derechos distintos y comprueben con
to_chomsky --pasos. (b) Muestren que si los pasos se hacen en el orden 1, 4, 2, 3, el paso 2 a lo sumo triplica el número de reglas. (c) Demuestren que ese orden también termina en una gramática en forma normal de Chomsky: revisen qué garantiza cada paso y qué podría romper el siguiente. - Para programar. Una variable es productiva si genera alguna cadena de terminales. Agreguen a
cfg.huna función que calcule las variables productivas marcando, como las anulables, y con ella una que decida si sin probar cadenas. Compárenla conshortest_lengths, que ya está encfg.h. Úsenla con la gramática delab/cyk_parser/casos/03.in. Este problema vuelve en la semana 9. - Para programar. Modifiquen
count_treesdechomsky.h, o su solución del laboratorio, para imprimir cuántos árboles tiene con sumas en la gramática ambigua convertida, para de 1 a 15. Busquen la secuencia que sale. ¿Crece de forma polinomial o exponencial? ¿Cuánto tarda CYK en contarlos, y por qué no es una contradicción?