
Apuntes · Capítulo 10Computabilidad
Reducciones
Reducciones
La semana 9 terminó con un resultado y con un método que no se puede repetir. El resultado: el lenguaje es indecidible. El método fue la diagonalización: suponer un decididor , construir con él una máquina que hace lo contrario de lo que predice, y darle a su propia descripción. Funciona una vez. Si para cada problema nuevo hubiera que inventar una diagonal a medida, la lista de problemas indecidibles sería corta.
Esta semana la lista crece con una sola herramienta, que ya conocen de Algoritmos: la reducción. Allá servía para mostrar que un problema es NP-difícil. Aquí sirve para mostrar que un problema es indecidible, y el argumento tiene la misma forma: si se pudiera decidir, con ese decididor se decidiría , y eso ya sabemos que es imposible. Ninguna demostración de hoy vuelve a diagonalizar. Todas se apoyan en la de la semana 9.
La sesión A trata de problemas sobre máquinas de Turing: si una máquina se detiene, si su lenguaje es vacío, si es regular, si dos máquinas son equivalentes. Todos caen, y el teorema de Rice explica por qué: cualquier pregunta interesante sobre el lenguaje de una máquina es indecidible. En el camino hay que precisar qué es una reducción, porque con la definición precisa se obtienen también lenguajes que no son ni siquiera reconocibles.
La sesión B sale del mundo de las máquinas. El problema de correspondencia de Post habla de fichas con cadenas, y la pregunta de si una gramática genera todas las cadenas habla de gramáticas. Ninguno menciona una máquina de Turing y los dos son indecidibles. El puente es la historia de cómputo: la ejecución completa de una máquina, escrita como una cadena. Con ella se paga la deuda de la semana 9: decidir si dos gramáticas son equivalentes es imposible.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Reducir: la idea y la dirección y El problema de la parada, por reducción. Antes de la sesión B, Problemas que no hablan de máquinas e Historias de cómputo.
En clase: Sesión A, de Reducir: la idea y la dirección a Lo que Rice no dice. Sesión B, de Problemas que no hablan de máquinas a El contraste con los autómatas finitos.
Después de clase: el Resumen y los Ejercicios. Antes del laboratorio, El problema de correspondencia de Post, PCP es reconocible y El código de la semana. La sección PCP es indecidible es la más larga del capítulo: léanla con el programa
tm_to_pcpal lado.
Lectura. Sipser, sec. 5.1 (Undecidable Problems from Language Theory), con su parte sobre computation histories, sec. 5.2 (A Simple Undecidable Problem) y sec. 5.3 (Mapping Reducibility). Erickson, Models of Computation, nota 7 (Undecidability). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-10. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/pcp_search.
Reducir: la idea y la dirección
Una reducción (reduction) de un problema a un problema es una manera de resolver usando una solución de . En Algoritmos lo hicieron muchas veces sin llamarlo así: para encontrar la mediana se puede ordenar, así que la mediana se reduce al ordenamiento. Y lo hicieron con nombre al final del curso, para mostrar que un problema es NP-difícil.
De una reducción de a se sacan dos conclusiones, que son la misma leída en los dos sentidos:
- Si se puede resolver, entonces se puede resolver. Es el uso de todos los días: tengo una biblioteca que resuelve y la aprovecho.
- Si no se puede resolver, entonces tampoco. Es el uso de esta semana.
“Resolver” quiere decir hoy decidir: tener una máquina de Turing que se detiene con toda entrada y responde bien. El punto de partida es el problema indecidible del que salen todos los demás, . Para demostrar que un problema es indecidible, el plan es siempre el mismo:
- Suponer que existe una máquina que decide .
- Construir, usando como subrutina, una máquina que decide .
- Como es indecidible, no puede existir. Entonces tampoco.
Más adelante el punto de partida podrá ser cualquier otro problema que ya se haya demostrado indecidible.
Idea clave. Para demostrar que es indecidible se reduce desde un problema indecidible conocido hacia . La reducción dice ” es al menos tan difícil como el conocido”. El problema conocido es el que se resuelve; el problema nuevo es el que se usa como subrutina.
La dirección es el error más frecuente del curso, así que vale la pena ver qué pasa cuando se invierte. Tomen un problema fácil: , decidir si un DFA acepta una cadena . Se reduce a sin esfuerzo: un DFA se convierte en una máquina de Turing que lee la entrada de izquierda a derecha siguiendo las transiciones de , y acepta si y solo si acepta . Si alguien nos diera un decididor de , decidiríamos con él. Todo eso es cierto, y no dice nada malo de , que es decidible: lo decidimos la semana pasada simulando.
Error común. Reducir en la dirección contraria. Reducir a solo muestra que no es más difícil que , y eso lo cumplen también los problemas más fáciles del curso. Para comprobar la dirección, pregúntense: ¿qué máquina estoy suponiendo que existe, y qué máquina construyo con ella? La que se supone es la del problema nuevo. La que se construye es la del problema que ya se sabe imposible.
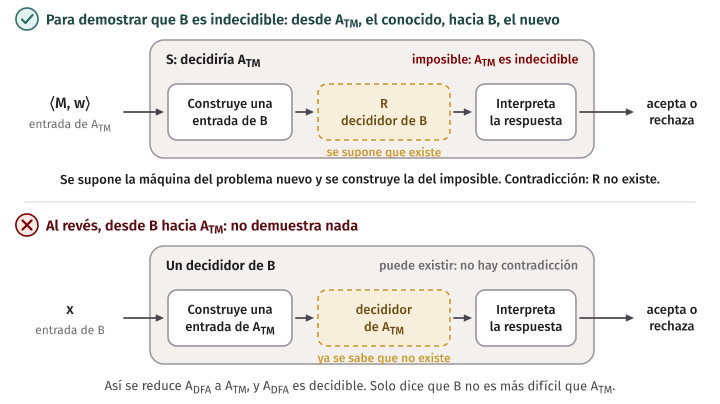
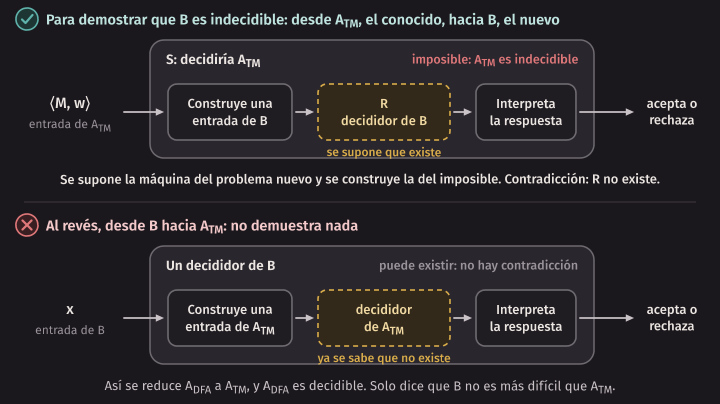
Tres avisos sobre la forma de estas demostraciones, antes de la primera.
- Son por contradicción. La máquina no existe, y aun así la usamos como si existiera, para llegar al absurdo. No hay que explicar cómo trabaja por dentro: solo se usa que se detiene siempre y que responde bien.
- Las máquinas se describen en alto nivel, con el formato de la semana 9: pasos numerados, entre comillas. La primera línea dice la forma de la entrada, y una entrada que no tiene esa forma se rechaza.
- Las máquinas construyen máquinas. Varios pasos dirán “construir la máquina ”. Eso es escribir un texto: la descripción de , hecha a partir de la descripción de . Es lo que hace un programa que genera código. Construir una máquina no es ejecutarla, y esa diferencia va a ser la clave de casi todo.
El problema de la parada, por reducción
El problema de la parada (halting problem) es el lenguaje
“Se detiene” incluye las dos formas: aceptando o rechazando. En la semana 9 lo demostramos como adelanto. Aquí la demostración se repite como primer ejemplo del plan de arriba.
Primero, el intento que no funciona, porque muestra qué es exactamente lo que falta. Para decidir uno quiere simular con y responder lo que responda. El intento falla en un solo caso: cuando no se detiene, la simulación tampoco, y nuestra máquina se queda sin responder. Si alguien nos avisara de antemano que no se va a detener, ese caso desaparece: respondemos “rechazar” sin simular. Un decididor de es justo ese aviso.
Teorema. es indecidible.
Demostración. Por reducción desde hacia . Esa es la dirección que sirve porque es el problema que ya sabemos indecidible: vamos a mostrar que un decididor de permitiría decidirlo.
Supongamos, para llegar a una contradicción, que una máquina decide . Construimos :
S = "Con la entrada ⟨M, w⟩, donde M es una máquina de Turing y w una cadena:
  1. Correr R con la entrada ⟨M, w⟩.
  2. Si R rechaza, rechazar.
  3. Si R acepta, simular M con la entrada w hasta que se detenga.
4. Si M aceptó, aceptar. Si M rechazó, rechazar."se detiene siempre. El paso 1 termina porque es un decididor. El paso 3 solo se ejecuta cuando aceptó, es decir, cuando se detiene con : la simulación termina.
responde bien, en las dos direcciones. Si acepta , entonces se detiene con , acepta, la simulación del paso 3 termina con aceptando, y acepta. Si no acepta , hay dos casos. Si no se detiene con , rechaza y rechaza en el paso 2. Si se detiene rechazando, acepta, la simulación termina con rechazando, y rechaza en el paso 4.
Entonces decide , que es indecidible. La contradicción viene de suponer que existe. ∎
Hay que mirar dónde está el cuidado. simula a , y simular es peligroso. Lo hace solo después de que garantizó que la simulación termina. Si los pasos 1 y 3 se cambiaran de orden, no sería un decididor.
En la práctica. Por eso ningún compilador avisa “este programa nunca termina” con certeza en todos los casos. Las herramientas que buscan ciclos infinitos existen y son útiles, pero responden con tres valores: “termina”, “no termina” y “no sé”. La tercera respuesta no es un defecto de la herramienta que se arregle con más trabajo.
Fijar la entrada dentro de la máquina: E_TM
El segundo problema pregunta por el lenguaje completo de una máquina, y ya no por una sola entrada:
Para los DFA la pregunta era fácil: se decide viendo si algún estado de aceptación es alcanzable en el diagrama. Para las gramáticas también. Para las máquinas de Turing, el diagrama no alcanza: que un estado se pueda alcanzar depende de lo que haya en la cinta, y la cinta no tiene límite.
La reducción tiene que salir de , y aquí aparece una dificultad nueva. Una instancia de es un par : una máquina y una entrada. Una instancia de es solo una máquina. Hay que meter en algún sitio, y el único sitio es dentro de la máquina.
La máquina M_w
Dados y , se construye una máquina nueva, que llamamos :
M_w = "Con la entrada x:
  1. Si x ≠ w, rechazar.
  2. Si x = w, correr M con la entrada w. Si M acepta, aceptar."
La cadena no es una entrada de : está escrita en su tabla de transiciones, como una constante en un programa. La única cadena que puede llegar a aceptar es , y la acepta exactamente cuando la acepta:
Si no se detiene con , entonces tampoco se detiene con . No importa: una cadena con la que la máquina no se detiene no está en su lenguaje, y igual.
La pregunta “¿acepta a ?” quedó convertida en “¿es vacío el lenguaje de ?”.
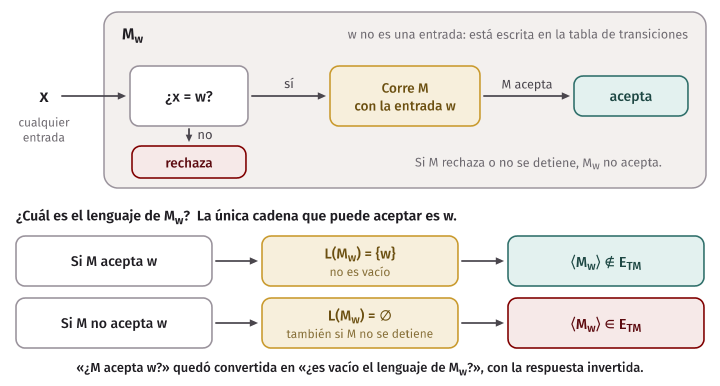
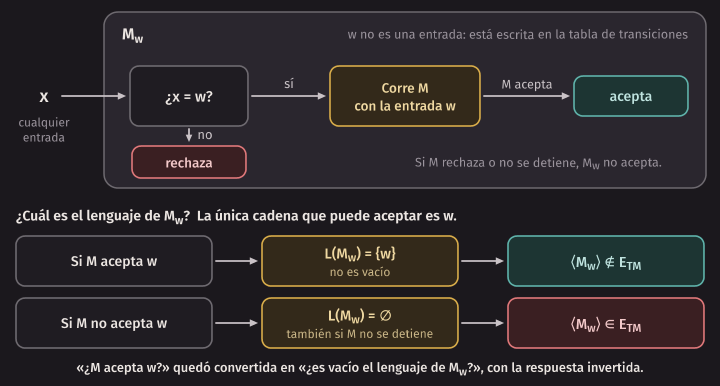
La construcción es un programa
Pasar de a es un trabajo mecánico sobre texto, y el programa
fix_input lo hace con los archivos .tm del curso. La máquina machines/starts_01.tm acepta las cadenas
binarias que empiezan con :
# Acepta las cadenas que empiezan con 01. Mira el segundo símbolo y vuelve al primero,
# para tener un movimiento a la izquierda en una historia corta.
states: q0 q1 q2 q_accept q_reject
alphabet: 0 1
tape: 0 1 _
start: q0
accept: q_accept
reject: q_reject
delta:
q0 0 -> q1 0 R
q1 1 -> q2 1 L
q2 0 -> q_accept 0 R
Con , esta es :
$ build/fix_input machines/starts_01.tm 01
# M_w para M = machines/starts_01.tm y w = 01.
# Con la entrada x: si x no es w, rechaza; si lo es, corre M con w.
states: c0 c1 c2 back m.q0 m.q1 m.q2 m.q_accept m.q_reject
alphabet: 0 1
tape: 0 1 _ @
start: c0
accept: m.q_accept
reject: m.q_reject
delta:
c0 0 -> c1 @ R
c1 1 -> c2 1 R
c2 _ -> back _ L
back 0 -> back 0 L
back 1 -> back 1 L
back @ -> m.q0 0 L
m.q0 0 -> m.q1 0 R
m.q1 1 -> m.q2 1 L
m.q2 0 -> m.q_accept 0 R
Los estados c0, c1, c2 comparan la entrada con símbolo por símbolo: la cadena está en
esas tres líneas. El primer símbolo se cambia por la marca @ para poder encontrar después el principio de la
cinta. El estado back vuelve hasta la marca, restaura el símbolo y entrega el control al estado inicial de
, cuyos estados aparecen con el prefijo m.. La última transición de back se mueve a la izquierda desde
la primera celda, y por la convención del formato el cabezal se queda ahí. Cualquier diferencia entre y
cae en un par sin transición, que lleva a rechazar.
test_fix_input comprueba la fórmula de con cuatro máquinas y las 31 cadenas de longitud a lo
sumo 4: corre cada con las 63 cadenas de longitud a lo sumo 5, y rechaza toda y hace
con lo mismo que .
Idea clave. El programa
fix_inputno ejecuta a . Lee su descripción y escribe otra. Termina siempre, también cuando es una máquina que no se detiene nunca. Las reducciones de esta semana trabajan así: transforman descripciones de máquinas sin correrlas.
La demostración
Teorema. es indecidible.
Demostración. Por reducción desde hacia : mostramos que un decididor de permitiría decidir , que es el problema que ya sabemos indecidible.
Supongamos que decide . Construimos :
S = "Con la entrada ⟨M, w⟩, donde M es una máquina de Turing y w una cadena:
  1. Construir la descripción de la máquina M_w de arriba.
  2. Correr R con la entrada ⟨M_w⟩.
3. Si R acepta, rechazar. Si R rechaza, aceptar."se detiene siempre. El paso 1 es escribir un texto y termina. El paso 2 termina porque es un decididor. nunca corre ni .
responde bien. Si acepta , entonces , así que rechaza y acepta. Si no acepta , entonces , así que acepta y rechaza.
decide : contradicción. ∎
Noten el paso 3: responde lo contrario de . No hay problema en eso. Si un lenguaje es decidible, su complemento también, porque basta intercambiar las respuestas. Para hablar de lo decidible, un problema y su complemento valen lo mismo. Para hablar de lo reconocible no, y por eso dentro de tres secciones habrá que mirar esa inversión con más cuidado.
Error común. Escribir en el paso “correr con todas las cadenas y ver si acepta alguna”. Eso no termina: hay infinitas cadenas, y con alguna puede no detenerse. Lo único que hace con es pasarle su descripción a .
REGULAR_TM y EQ_TM
La misma técnica, fijar dentro de una máquina construida a medida, resuelve dos problemas más. Lo que cambia es qué hace la máquina nueva con su propia entrada.
¿Es regular el lenguaje de una máquina?
La pregunta tiene sentido práctico: si el lenguaje de un programa es regular, se podría reemplazar el programa por un autómata finito, que usa memoria constante.
Queremos una máquina , construida a partir de y , cuyo lenguaje sea regular exactamente cuando acepta . La idea es darle a dos lenguajes posibles, uno regular y otro no, y dejar que con elija cuál. El lenguaje no regular más conocido del curso es , de la semana 4. El regular más simple es .
M_2 = "Con la entrada x:
  1. Si x tiene la forma 0ⁿ1ⁿ, aceptar.
2. Si no, correr M con la entrada w. Si M acepta, aceptar."acepta siempre las cadenas de la forma , sin mirar a . Con las demás, hace lo que haga con , que es lo mismo para todas porque no depende de :
Teorema. es indecidible.
Demostración. Por reducción desde hacia , porque es el que ya sabemos indecidible. Supongamos que decide , y sea :
S = "Con la entrada ⟨M, w⟩, donde M es una máquina de Turing y w una cadena:
  1. Construir la descripción de la máquina M_2 de arriba.
  2. Correr R con la entrada ⟨M_2⟩.
3. Si R acepta, aceptar. Si R rechaza, rechazar."se detiene siempre: escribe una descripción y corre un decididor. Si acepta , entonces , que es regular, acepta y acepta. Si no acepta , entonces , que no es regular, rechaza y rechaza. Así decide : contradicción. ∎
Dos detalles de que suelen confundir.
- sí se detiene en el paso 1: comprobar la forma es decidible, lo hace la máquina de la semana 7. Pero aunque no se detuviera en algún paso, daría igual: no se ejecuta en ningún momento de la demostración. Solo importa cuál es su lenguaje.
- El caso en que no se detiene con está cubierto. Entonces no se detiene con ninguna que no tenga la forma , no las acepta, y su lenguaje es .
El mismo esquema, cambiando los dos lenguajes, demuestra que es indecidible si es libre de contexto, si es finito, si es decidible. El teorema de Rice, más abajo, los resuelve todos de una vez.
¿Son equivalentes dos máquinas?
Aquí conviene no partir de . Ya tenemos otro problema indecidible que se parece mucho más: pregunta si el lenguaje de una máquina es vacío, y eso es preguntar si la máquina es equivalente a una que no acepta nada.
Teorema. es indecidible.
Demostración. Por reducción desde hacia . La dirección sirve porque ya está demostrado indecidible: un decididor de permitiría decidirlo.
Sea una máquina fija que rechaza toda entrada, de modo que . Supongamos que decide , y sea :
S = "Con la entrada ⟨M⟩, donde M es una máquina de Turing:
  1. Correr R con la entrada ⟨M, M_∅⟩.
2. Si R acepta, aceptar. Si R rechaza, rechazar."se detiene siempre. Si , entonces , acepta y acepta. Si , entonces , rechaza y rechaza. decide : contradicción. ∎
Las reducciones se encadenan. se redujo a , y a . Cada problema que se demuestra indecidible es un punto de partida nuevo, y se elige el que más se parezca al que se quiere atacar.
En la práctica. es el problema de quien refactoriza: ¿el programa nuevo hace lo mismo que el viejo? Ningún algoritmo lo responde para todos los pares de programas. Por eso existen las pruebas, que comparan los dos programas en algunas entradas, y por eso un optimizador de compilador solo aplica transformaciones que se demostraron correctas una por una.
Reducción por función
Hasta aquí “reducir” fue una idea: usar un decididor como subrutina. En las cuatro demostraciones, la subrutina se usó de la manera más simple posible: transformó su entrada en otra, llamó a una sola vez con ella, y respondió lo mismo que o lo contrario. Esa forma tiene nombre y definición, y vale la pena aislarla porque dice más que la idea general.
Definición. Una función es computable (computable function) si alguna máquina de Turing, con cada entrada , se detiene dejando en la cinta exactamente .
Una función computable es un programa que siempre termina y que transforma texto en texto. Las operaciones
aritméticas lo son. Lo que nos interesa: transformar la descripción de una máquina en la de otra es computable.
fix_input calcula la función .
Definición. Un lenguaje es reducible por función (mapping reducible) a un lenguaje , y se escribe , si existe una función computable tal que, para toda cadena ,
La función es la reducción de a .
        A                    B
  ┌───────────┐   f    ┌───────────┐
  │   w ∈ A   │ ─────► │ f(w) ∈ B  │
  ├───────────┤        ├───────────┤
  │   w ∉ A   │ ─────► │ f(w) ∉ B  │
  └───────────┘        └───────────┘
Tres observaciones sobre la definición.
- El “si y solo si” son dos condiciones. Las cadenas de van a parar dentro de , y las que no están en van a parar fuera de . Una función que cumple solo la primera no sirve: la función constante que manda todo a una cadena fija de la cumple.
- no tiene que ser inyectiva ni sobreyectiva. Puede mandar muchas cadenas a la misma, y puede no tocar casi nada de .
- tiene que estar definida para toda cadena, también para las que no son la codificación de nada. Si es un lenguaje de pares y la entrada no tiene esa forma, la entrada no está en , y la manda a alguna cadena fija que no esté en . En adelante no lo repetimos.
La notación se lee como una comparación de dificultad: dice que no es más difícil que . Igual que con los números, sirve en los dos sentidos.
Qué conserva
Teorema. Si y es decidible, entonces es decidible.
Demostración. Por construcción. Sea un decididor de y la reducción. La máquina
N = "Con la entrada w:
  1. Calcular f(w).
  2. Correr M con la entrada f(w). Responder lo mismo que M."
se detiene siempre, porque es computable y es un decididor. Y acepta si y solo si acepta , si y solo si , si y solo si . ∎
Corolario. Si y es indecidible, entonces es indecidible.
Demostración. Es el contrarrecíproco del teorema: si fuera decidible, lo sería. ∎
Teorema. Si y es reconocible, entonces es reconocible.
Demostración. La misma máquina , con ahora un reconocedor de . Si , entonces , acepta y acepta . Si , entonces y no acepta : rechaza o no se detiene, y hace lo mismo. En los dos casos acepta exactamente las cadenas de . ∎
Corolario. Si y no es reconocible, entonces no es reconocible.
Demostración. El contrarrecíproco del teorema anterior. ∎
| Si y… | entonces… | Se usa para |
|---|---|---|
| es decidible | es decidible | resolver |
| es indecidible | es indecidible | las demostraciones de esta semana |
| es reconocible | es reconocible | reconocer |
| no es reconocible | no es reconocible | la sección siguiente |
En la tabla, lo bueno baja de hacia y lo malo sube de hacia . Si la conclusión que están escribiendo va en otro sentido, la reducción está al revés.
Dos propiedades más, que se usan todo el tiempo.
Los complementos. si y solo si , con la misma función. La condición dice lo mismo que , que es .
La transitividad. Si con y con , entonces con la composición , que es computable: .
Las reducciones anteriores, vistas como funciones
-
. La función manda a , donde es con un cambio: cuando rechazaría, entra en un ciclo sin fin.
M' = "Con la entrada x:
  1. Correr M con la entrada x.
  2. Si M acepta, aceptar. Si M rechaza, moverse a la derecha para siempre."
Si acepta , se detiene con . Si no acepta , sea porque rechaza o porque no se detiene, no se detiene con . Entonces .
-
, con . La máquina de esa demostración respondía lo mismo que .
-
, con .
-
, con . Aquí está la inversión del paso 3: acepta si y solo si no es vacío. La función lleva al complemento de , y no a .
El último caso merece una pausa. ¿Existirá otra función, más ingeniosa, que dé ? No existe ninguna, y se puede demostrar.
- es reconocible. Una máquina con la entrada busca una cadena que acepte. No puede probar las cadenas una tras otra, porque puede no detenerse con la primera. Las prueba en paralelo: para , corre durante pasos con cada una de las primeras cadenas de , y acepta si alguna de esas ejecuciones acepta. Si , alguna cadena se acepta en algún número de pasos, y la búsqueda llega hasta ahí.
- Si fuera , por la propiedad de los complementos sería , y como es reconocible, lo sería. En la semana 9 vimos que no lo es.
Así que la reducción general, la de “usar un decididor como subrutina”, permite invertir la respuesta, y la reducción por función no. Para demostrar que algo es indecidible, la diferencia no importa. Para demostrar que algo no es reconocible, es todo lo que importa.
De paso salió un resultado nuevo. De se obtiene , y como no es reconocible:
Corolario. no es reconocible.
Tiene sentido: para convencerse de que una máquina sí acepta algo basta encontrar una cadena, y para convencerse de que no acepta nada no hay una búsqueda finita que alcance.
Error común. Leer como “se puede pasar de a y de a ”. La reducción no es simétrica. es cierto, y es falso: si fuera cierto, sería decidible.
EQ_TM no es reconocible, y su complemento tampoco
En la semana 9 el mapa tenía tres regiones: los lenguajes decidibles; los reconocibles que no son decidibles, como ; y los que no son reconocibles pero tienen complemento reconocible, como . Queda una cuarta región: lenguajes en los que ni las respuestas “sí” ni las respuestas “no” se pueden confirmar con una búsqueda. está ahí.
La herramienta es el último corolario: si no es reconocible y , entonces no es reconocible. El lenguaje no reconocible que tenemos es . Hay que reducirlo dos veces: una hacia y otra hacia .
Teorema. no es reconocible, y tampoco.
Demostración. Dos reducciones por función desde . Es la dirección que sirve porque es el lenguaje que ya sabemos que no es reconocible, y lo no reconocible sube de hacia .
Las dos usan la misma máquina auxiliar, que ignora su entrada y corre con :
M_2 = "Con cualquier entrada x:
  1. Correr M con la entrada w. Si M acepta, aceptar."
Su lenguaje es si acepta , y si no.
Primera parte: no es reconocible. Queremos . Por la propiedad de los complementos, es lo mismo que , que es más cómodo de escribir: hay que mandar a un par de máquinas que sean distintas exactamente cuando acepta . La función es
siempre. Si acepta , entonces , y el par no está en . Si no acepta , entonces , y el par está en . Es decir,
que es , y por lo tanto . Como no es reconocible, no es reconocible.
Segunda parte: no es reconocible. Queremos , que es lo mismo que : ahora las dos máquinas tienen que ser equivalentes exactamente cuando acepta . Se cambia solo :
Ahora siempre. Si acepta , entonces y el par está en . Si no acepta , entonces y el par no está. Es decir,
que es , y por lo tanto . Como no es reconocible, no es reconocible. ∎
Para no perderse con las barras, esta tabla resume las dos partes:
| Parte | Si acepta | Lo que se obtiene | Conclusión | |
|---|---|---|---|---|
| Primera | rechaza todo | las máquinas difieren | no es reconocible | |
| Segunda | acepta todo | las máquinas coinciden | no es reconocible |
La regla para leerla: si , entonces , y el lenguaje que queda sin reconocedor es , el complemento del que aparece a la derecha de .
El mapa de la semana 9, con lo que se agregó hoy:
| Región | Ejemplos |
|---|---|
| Decidibles | , , , , |
| Reconocibles, no decidibles | , , |
| No reconocibles, con complemento reconocible | , , |
| Ni reconocibles ni con complemento reconocible | , |
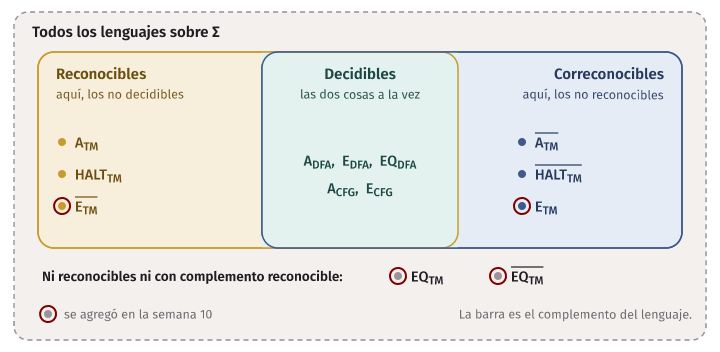
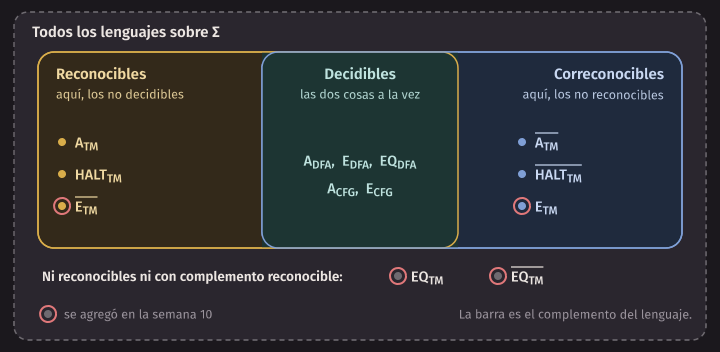
Que es reconocible se ve igual que con : se simula con y se acepta cuando la simulación se detiene.
El teorema de Rice
Las demostraciones de y de tienen el mismo esqueleto: se construye una máquina cuyo lenguaje es uno de dos, según acepte o no , y los dos lenguajes se eligen para que uno tenga la propiedad que se pregunta y el otro no. Nada en ese esqueleto depende de que la propiedad sea “ser vacío” o “ser regular”. El teorema de Rice lo dice de una vez para todas las propiedades.
Hay que precisar qué es una propiedad. Una pregunta de sí o no sobre máquinas de Turing es un lenguaje : el conjunto de las descripciones de las máquinas para las que la respuesta es sí.
Definición. Sea un lenguaje formado por descripciones de máquinas de Turing.
- es una propiedad del lenguaje si depende solo del lenguaje que la máquina reconoce: siempre que , se tiene si y solo si .
- es no trivial (nontrivial property) si alguna máquina la tiene y alguna no: existen y con y .
Teorema de Rice. Toda propiedad no trivial del lenguaje de una máquina de Turing es indecidible.
La primera condición dice que no distingue entre dos máquinas que reconocen lo mismo: no ve los estados, ni la cantidad de pasos, ni cómo está escrita la tabla. La segunda descarta las dos preguntas que se responden sin mirar: la que todas las máquinas cumplen y la que no cumple ninguna.
Demostración. Por reducción desde hacia : mostramos que un decididor de permitiría decidir , que es indecidible.
Sea una propiedad no trivial del lenguaje, y supongamos que una máquina la decide.
Paso 1: se puede suponer que las máquinas con lenguaje vacío no tienen la propiedad. Sea una máquina que rechaza toda entrada, con . Si , cambiamos por su complemento , el conjunto de las máquinas que no tienen la propiedad. también es una propiedad del lenguaje y también es no trivial, porque las dos condiciones son simétricas entre “tenerla” y “no tenerla”. Y es decidible si lo es: basta invertir las respuestas de . Así que, si hace falta, hacemos toda la demostración con y llegamos a la misma contradicción. En adelante, .
Paso 2: una máquina que sí la tiene. Como es no trivial, existe una máquina con . Es una máquina fija, que no depende de la entrada de la reducción.
Paso 3: la construcción. Dados y , sea
M_w = "Con la entrada x:
  1. Correr M con la entrada w. Si M rechaza, rechazar.
  2. Si M acepta, correr T con la entrada x. Si T acepta, aceptar."
Esta hace de filtro. Si acepta , el paso 1 termina y se comporta con exactamente como : acepta si y solo si acepta . Si no acepta , sea porque rechaza o porque no se detiene, no llega nunca a aceptar. Entonces
Paso 4: la máquina que decide .
S = "Con la entrada ⟨M, w⟩, donde M es una máquina de Turing y w una cadena:
  1. Construir la descripción de la máquina M_w de arriba.
  2. Correr R_P con la entrada ⟨M_w⟩.
3. Si R_P acepta, aceptar. Si R_P rechaza, rechazar."se detiene siempre: escribe una descripción y corre un decididor.
Si acepta , entonces . Como y solo depende del lenguaje, . acepta y acepta.
Si no acepta , entonces . Como y solo depende del lenguaje, . rechaza y rechaza.
decide , lo cual es imposible. Entonces no existe. ∎
Las dos hipótesis se usan en lugares que se pueden señalar. Que sea no trivial da las dos máquinas, y , una a cada lado. Que sea una propiedad del lenguaje es lo que permite pasar de ” reconoce lo mismo que ” a ” tiene la propiedad”: y son máquinas muy distintas por dentro, y solo coinciden en el lenguaje.
Cómo se usa
Para aplicar el teorema a un lenguaje hay que comprobar tres cosas, y escribirlas:
- Que es una propiedad del lenguaje: su definición se puede escribir mencionando solo .
- Que alguna máquina la tiene. Se da una.
- Que alguna máquina no la tiene. Se da una.
Algunos ejemplos, con las tres comprobaciones.
| Propiedad | Solo depende de | Una máquina que la tiene | Una que no |
|---|---|---|---|
| sí | la que rechaza todo | la que acepta todo | |
| es regular | sí | la que acepta todo | la que decide |
| es finito | sí | la que rechaza todo | la que acepta todo |
| sí | la que acepta todo | la que rechaza todo | |
| sí | la que acepta todo | la que rechaza todo | |
| sí | la que acepta todo | la que rechaza todo | |
| es libre de contexto | sí | la que rechaza todo | la que decide |
Todas son indecidibles. Las dos primeras filas son y , que ya habíamos demostrado a mano.
La cuarta fila es la pregunta 1 de la guía: el lenguaje . ” acepta ” parece hablar de lo que hace la máquina, pero es lo mismo que "", que solo menciona el lenguaje. Dos máquinas con el mismo lenguaje aceptan las dos o ninguna.
En la práctica. El teorema de Rice es la razón por la que las herramientas que analizan programas sin ejecutarlos no pueden ser exactas. “¿Este programa puede dividir entre cero?”, “¿imprime alguna vez una contraseña?”, “¿esta función devuelve siempre un número positivo?”: todas son propiedades no triviales de lo que el programa hace. Un verificador de tipos o un analizador estático responde de forma aproximada: rechaza algunos programas correctos, o deja pasar algunos incorrectos, o a veces dice “no sé”. Cuál de las tres cosas elige es una decisión de diseño. No hay una cuarta opción.
Lo que Rice no dice
El teorema tiene dos hipótesis, y fuera de ellas no afirma nada. No dice que toda pregunta sobre máquinas de Turing sea indecidible.
Propiedades de la máquina, que sí se deciden
” tiene 5 estados.” No es una propiedad del lenguaje. Tomen una máquina de 5 estados y agréguenle un estado al que no llega ninguna transición: reconoce el mismo lenguaje y tiene 6. Una está en el conjunto y la otra no. Rice no se aplica. Y la pregunta es decidible: se lee la descripción y se cuenta.
” se detiene con la entrada en a lo sumo 100 pasos.” Tampoco es una propiedad del lenguaje: dos máquinas pueden reconocer lo mismo, una en 10 pasos y otra en 1000. Y es decidible, por una razón que conviene tener clara: simular con un tope de pasos siempre termina.
D = "Con la entrada ⟨M, w⟩:
  1. Simular M con la entrada w durante 100 pasos, o hasta que se detenga.
  2. Si se detuvo, aceptar. Si no, rechazar."
Es lo que hace la opción --pasos del programa history. La máquina machines/loop_on_0.tm avanza a la
derecha para siempre cuando la entrada es :
$ build/history machines/loop_on_0.tm 00 --pasos 5
C1   q0 0 0
C2   0 q1 0
C3   0 0 q1 _
C4   0 0 _ q1 _
C5   0 0 _ _ q1 _
C6   0 0 _ _ _ q1 _
sin detenerse después de 5 pasos: no hay historia que mostrar
El programa respondió, y la respuesta es exacta: en 5 pasos no se detuvo. Lo que no puede responder ningún programa es si se detendrá alguna vez.
” se detiene con toda entrada en a lo sumo 100 pasos.” Parece peor, porque hay infinitas entradas. Pero en 100 pasos el cabezal, que empieza en la primera celda y avanza a lo sumo una por paso, solo alcanza a leer las primeras 100 celdas. Lo que la máquina hace en sus primeros 100 pasos depende solo de los primeros 100 símbolos de la entrada. Basta probar las entradas de longitud a lo sumo 100, que son una cantidad finita, cada una con tope de 100 pasos. Es decidible. Lento, pero decidible.
Idea clave. Antes de usar Rice, pregunten: si dos máquinas reconocen el mismo lenguaje, ¿las dos respuestas son iguales por fuerza? Si se puede cambiar la respuesta sin cambiar el lenguaje, agregando un estado o haciendo la máquina más lenta, la propiedad es de la máquina y el teorema no se aplica.
Que Rice no se aplique no quiere decir que sea decidible
Cuando la propiedad es de la máquina, el teorema calla. La pregunta puede ser decidible, como las tres de arriba, o indecidible por otra razón.
” se detiene con la entrada .” No es una propiedad del lenguaje: una máquina que rechaza y otra que no se detiene con pueden reconocer el mismo lenguaje, y solo la primera está en el conjunto. Rice no se aplica. Aun así es indecidible, y se demuestra con una reducción directa desde , fijando la entrada dentro de la máquina. Es el ejercicio 4.
” tiene un estado inútil”, es decir, un estado al que no entra con ninguna entrada. Es una propiedad de la tabla de la máquina, y Rice no se aplica. También resulta indecidible, con su propia reducción. El ejercicio 8 demuestra una variante, en la que el estado viene dado.
La pregunta 2 de la guía queda así:
| Propiedad | ¿Cae bajo Rice? | ¿Es decidible? |
|---|---|---|
| es finito | sí: es del lenguaje y no trivial | no, por Rice |
| tiene un estado inútil | no: es de la máquina | no, pero por otra demostración |
| contiene a | sí: es del lenguaje y no trivial | no, por Rice |
| se detiene con toda entrada en menos de 10 pasos | no: es de la máquina | sí: se prueban las entradas cortas con tope |
Propiedades triviales
La otra hipótesis también hace falta. ” es reconocible” es una propiedad del lenguaje que todas las máquinas tienen, por definición de reconocible. Es trivial, y se decide aceptando siempre. ” no es reconocible” no la tiene ninguna, y se decide rechazando siempre.
Error común. Aplicar Rice porque el enunciado menciona una máquina de Turing. El teorema pide escribir la propiedad en términos de y dar dos máquinas, una que la tiene y una que no. Si no pueden escribir esas tres líneas, no lo están aplicando.
Error común. Reducir en la dirección contraria, otra vez, ahora que hay muchos problemas con nombre. Para demostrar que es indecidible no sirve mostrar . Eso es cierto de cualquier lenguaje reconocible, también de los decidibles, y solo dice que no es más difícil que . La reducción útil es , o desde cualquier otro indecidible hacia .
Problemas que no hablan de máquinas
Todos los problemas indecidibles de la sesión A tienen una máquina de Turing en la entrada. Eso deja abierta una salida cómoda: pensar que la indecidibilidad es una rareza de las preguntas sobre programas, y que los problemas “normales”, los de cadenas, grafos o gramáticas, están a salvo.
No lo están. En esta sesión hay tres problemas cuyas entradas no mencionan ninguna máquina:
- un rompecabezas de fichas con cadenas, el problema de correspondencia de Post;
- decidir si una gramática libre de contexto genera todas las cadenas;
- decidir si dos gramáticas generan el mismo lenguaje, la deuda de la semana 9.
Para demostrar que son indecidibles hay que reducir hacia ellos, como siempre. La dificultad es nueva: con un problema sobre máquinas, la reducción construía otra máquina. Ahora la reducción tiene que construir fichas o una gramática a partir de , de modo que la respuesta sobre las fichas o la gramática diga si acepta . Las fichas y las gramáticas no ejecutan nada. Hace falta un puente entre ” acepta ” y un objeto que se pueda describir con cadenas.
El puente es escribir la ejecución entera como una cadena.
Historias de cómputo
En la semana 7 definimos la configuración de una máquina de Turing: el estado, el contenido de la cinta y la posición del cabezal, escritos como . La cinta contiene seguido de blancos, el estado es y el cabezal está sobre el primer símbolo de . Una configuración produce otra si la máquina pasa de a en un paso.
Definición. Una historia de cómputo de aceptación (accepting computation history) de con la entrada es una secuencia de configuraciones tal que
- es la configuración inicial de con , es decir, ;
- cada produce ;
- es una configuración de aceptación: su estado es .
Se escribe como una sola cadena, con las configuraciones separadas por :
Una historia es finita: tiene configuraciones, y cada una es una cadena finita. Si no se detiene con , no hay historia. Si rechaza , hay una secuencia que termina en , y no es de aceptación. Así:
Como las máquinas del curso son deterministas, cuando la historia existe es una sola: está fijada por y cada configuración fija la siguiente. La única libertad es de escritura, si se anotan o no blancos al final de cada configuración.
El programa history la escribe. La máquina machines/zeros_ones.tm es la de code/formats.md, que decide
tachando un con X y un con Y en
cada vuelta:
$ build/history machines/zeros_ones.tm 01
C1   q0 0 1
C2   X q1 1
C3   q2 X Y
C4   X q0 Y
C5   X Y q3 _
C6   X Y _ q_accept _
acepta después de 5 pasos
historia: q0 0 1 # X q1 1 # q2 X Y # X q0 Y # X Y q3 _ # X Y _ q_accept _
Los nombres de los estados tienen varios caracteres, así que el programa separa los símbolos con espacios:
q_accept es un símbolo de la historia, igual que X. El estado siempre lleva a su derecha el símbolo que
está leyendo; si es un blanco de más allá de lo escrito, se anota como _.
El alfabeto de una historia es entonces : los símbolos de la cinta, los estados y el separador. Una historia es una cadena como cualquier otra, y se puede preguntar si una cadena dada es o no una historia.
Comprobar una historia es fácil y es local
Comparen las configuraciones seguidas de esa historia, cada una puesta sobre la que le sigue:
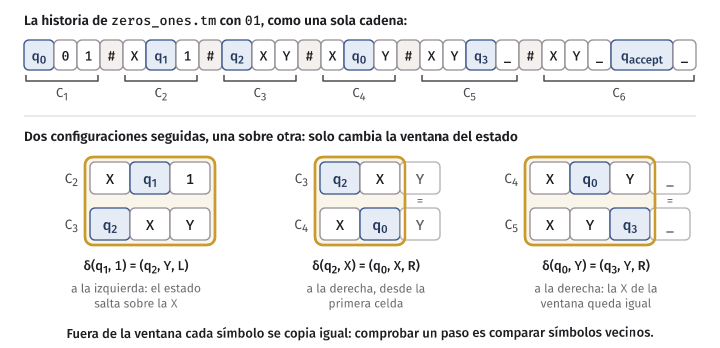
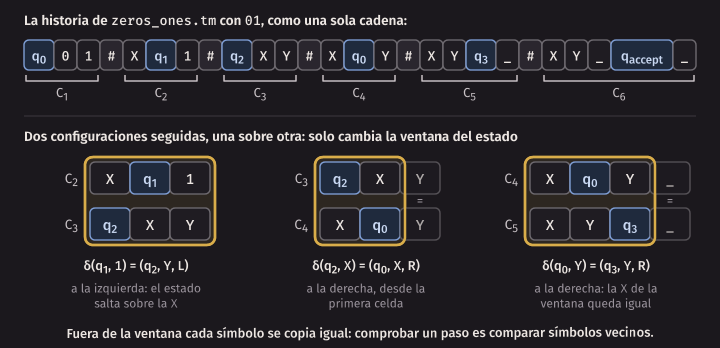
En un paso la máquina cambia el estado, escribe una celda y mueve el cabezal una posición. Entonces dos configuraciones seguidas son iguales en casi todas partes. Solo pueden cambiar tres símbolos: el estado, el que está a su derecha (la celda que se lee y se escribe) y el que está a su izquierda (porque el estado, al moverse a la izquierda, se intercambia con él). Si o , el cambio es
y todo lo que está fuera de esos tres símbolos se copia igual. En la primera celda no hay nada a la izquierda; ahí el movimiento deja el estado en su sitio, y pasa a ser .
Por eso comprobar que produce no pide simular nada ni recordar la cinta completa. Se recorren las dos configuraciones a la vez, mirando una ventana de tres símbolos de arriba y los tres de abajo:
- si en la ventana de arriba no hay ningún estado, el símbolo del centro tiene que estar igual abajo;
- si el estado está en el centro de la ventana de arriba, los tres símbolos de abajo tienen que ser los que manda .
Cada comprobación mira una cantidad fija de símbolos y consulta la tabla de . Entre las dos reglas queda determinada cada posición de la configuración de abajo, así que si todas las ventanas pasan, es de verdad la que sigue a . Eso es lo que quiere decir que la comprobación es local.
Una historia completa se comprueba con cuatro revisiones, todas de este tipo:
- cada tramo entre separadores es una configuración: símbolos de y exactamente un estado;
- es ;
- cada par de configuraciones seguidas pasa la revisión por ventanas;
- la última tiene a .
El programa check_history hace esas cuatro revisiones. No simula la máquina: la función check_step de
tm.h solo compara ventanas.
$ build/check_history machines/zeros_ones.tm 01 "q0 0 1 # X q1 1 # q2 X Y # X q0 Y # X Y q3 _ # X Y _ q_accept _"
es una historia de aceptación
Si se cambia un solo símbolo, por ejemplo la Y de por una X, alguna ventana lo nota:
$ build/check_history machines/zeros_ones.tm 01 "q0 0 1 # X q1 1 # q2 X Y # X q0 X # X Y q3 _ # X Y _ q_accept _"
no es una historia de aceptación
  de C3 a C4: ventana lejos del cabezal en la posición 3: arriba [X Y _], abajo [q0 X _], y el centro debía copiarse
Y si alguien intenta acortar el camino escribiendo una configuración de aceptación antes de tiempo, falla la ventana del cabezal:
$ build/check_history machines/zeros_ones.tm 01 "q0 0 1 # X q1 1 # X q_accept 1"
no es una historia de aceptación
  de C2 a C3: ventana del cabezal en la posición 2: arriba [X q1 1], abajo [X q_accept 1], y δ pide [q2 X Y]
test_history lo comprueba de forma exhaustiva con las cinco cadenas de longitud a
lo sumo 8: toma la historia de cada una y cambia cada símbolo por cada uno de los otros símbolos posibles. Son
8250 cadenas alteradas, y el comprobador las rechaza todas.
Idea clave. ”¿ acepta ?” es una pregunta difícil: indecidible. “¿Es esta cadena una historia de aceptación de con ?” es una pregunta fácil: se responde comparando símbolos vecinos. La dificultad de está toda en encontrar la historia, que puede no existir, y no en revisarla. Los dos resultados que siguen aprovechan eso: se construyen unas fichas, o una gramática, que solo saben comparar símbolos vecinos, y con eso basta para que la pregunta sobre ellas sea tan difícil como .
La pregunta 5 de la guía se responde con esta sección: comprobar una historia es local porque entre dos configuraciones seguidas solo pueden cambiar el estado y los dos símbolos que lo rodean, y lo demás se copia. La misma idea vuelve en la semana 13, con otro nombre, en la demostración del teorema de Cook-Levin.
El problema de correspondencia de Post
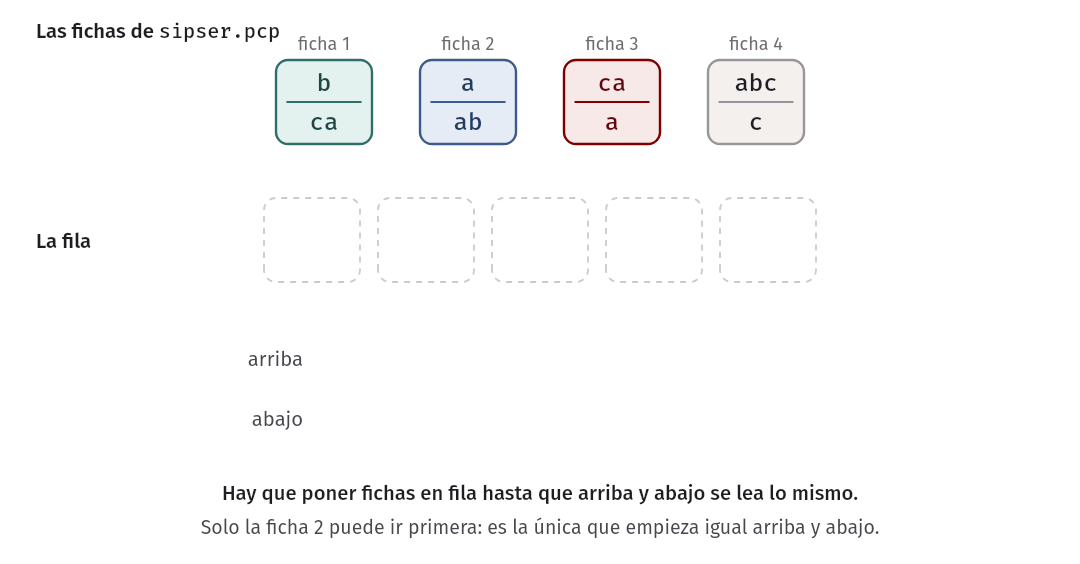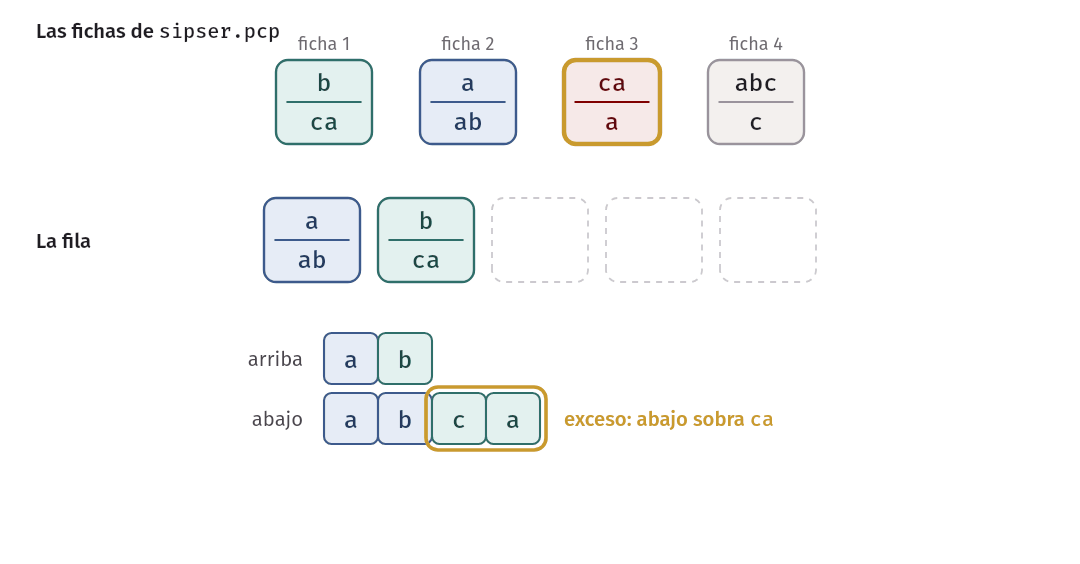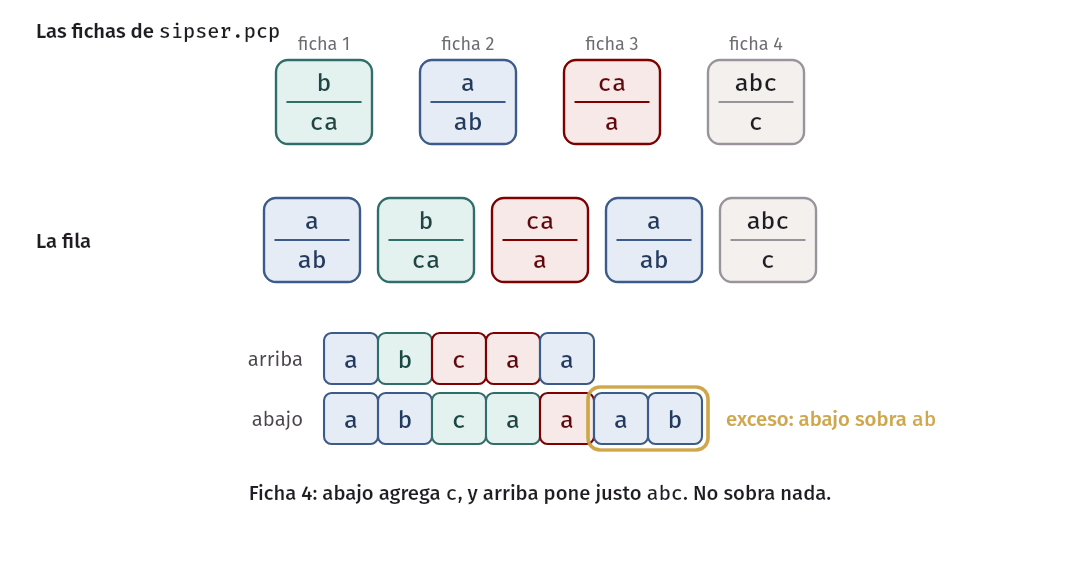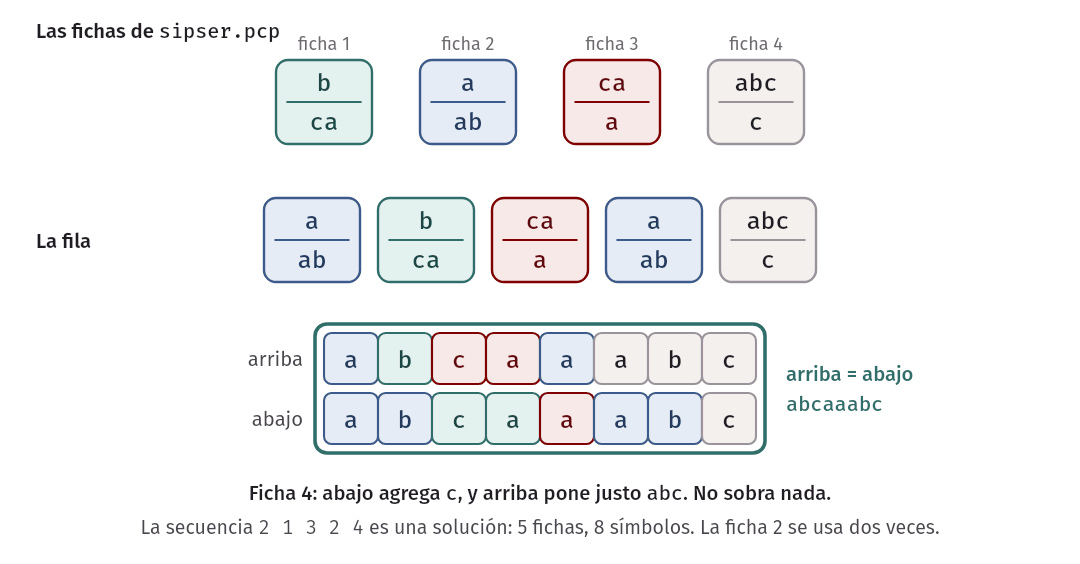
Emil Post propuso en 1946 un rompecabezas que cabe en una línea. Se tiene un conjunto finito de fichas, como las de dominó. Cada ficha tiene una cadena arriba y otra abajo:
Hay que poner fichas en fila, repitiendo las que se quiera, de modo que la cadena que se lee arriba, juntando las de todas las fichas, sea la misma que se lee abajo.
Definición. Una instancia del problema de correspondencia de Post (PCP) es una lista de fichas
donde y son cadenas sobre un alfabeto . Una solución es una secuencia de índices , con , tal que
El lenguaje es .
Las fichas no se pueden voltear ni partir, y las de arriba y las de abajo van en el mismo orden: es una sola fila de fichas. La condición descarta la fila vacía, que daría arriba y abajo.
Un ejemplo con solución
Las cuatro fichas de arriba están en instances/sipser.pcp, numeradas del 1 al 4 en ese orden:
# Cuatro fichas sobre {a, b, c}. Tiene solución: 2 1 3 2 4.
dominoes: 4
b ca
a ab
ca a
abc c
El programa pcp_check pone una secuencia de fichas y compara:
$ build/pcp_check instances/sipser.pcp 2 1 3 2 4
arriba: a b ca a abc  =  abcaaabc
abajo:  ab ca a ab c  =  abcaaabc
es una solución (5 fichas, 8 símbolos)
Arriba y abajo se lee , cortada en pedazos distintos. La ficha 2 se usa dos veces.
Vale la pena ver cómo se llega. La primera ficha tiene que tener arriba y abajo cadenas que empiecen igual, y solo la ficha 2 lo cumple: y . Después de ponerla, abajo va adelantado: sobra una .
$ build/pcp_check instances/sipser.pcp 2 1 3
arriba: a b ca  =  abca
abajo:  ab ca a  =  abcaa
no es una solución: abajo sobra a
Lo que sobra es lo único que importa para seguir: la próxima ficha tiene que empezar a cubrirlo. Esa cadena que sobra, junto con el lado al que le sobra, se llama aquí el exceso. Vuelve en la sección siguiente.
Una instancia con solución tiene infinitas: 2 1 3 2 4 2 1 3 2 4 también lo es.
Ejemplos sin solución
A veces se ve enseguida que no hay solución.
Ninguna ficha puede ir primera. En instances/no_start.pcp las fichas son
En las tres, la cadena de arriba y la de abajo empiezan con símbolos distintos. La primera ficha de una solución tendría que empezar igual arriba y abajo.
Arriba siempre es más largo. En instances/longer_top.pcp,
cada ficha tiene arriba más símbolos que abajo. Cualquier fila de fichas tiene arriba una cadena más larga que la de abajo, y no pueden ser iguales.
Se puede seguir para siempre sin terminar. En instances/cycle.pcp,
solo la ficha 1 puede ir primera, y deja abajo adelantado con el exceso . Con ese exceso, la única ficha que se puede poner es la 3: arriba agrega , que cubre el que sobraba más los dos primeros símbolos del de abajo, y abajo vuelve a sobrar . Se puede poner la ficha 3 cuantas veces se quiera, y el exceso nunca queda vacío. No hay solución.
En los tres casos hubo un argumento, y cada uno fue distinto. Eso es lo esperable en un problema indecidible: no hay un argumento que sirva para todas las instancias.
PCP es reconocible
Antes de demostrar que PCP es indecidible conviene ver qué sí se puede hacer.
Teorema. PCP es reconocible.
Demostración. Por construcción: una máquina que busca.
B = "Con la entrada ⟨P⟩, donde P es una lista de k fichas:
  1. Para n = 1, 2, 3, …:
  2.     Para cada una de las kⁿ secuencias de n fichas:
  3.         Si arriba y abajo se lee la misma cadena, aceptar."
Cada vuelta del paso 1 termina, porque revisa una cantidad finita de secuencias y cada revisión es comparar dos cadenas. Si tiene una solución de fichas, llega a la vuelta y acepta. Si no tiene solución, no acepta nunca. Entonces . ∎
Con una instancia sin solución, no se detiene. Reconoce y no decide: es la misma situación que la máquina universal con .
Buscar mejor: el exceso
La máquina es correcta y muy lenta: secuencias de longitud . Casi todas son absurdas, porque se estropean en la segunda ficha. La búsqueda razonable construye la fila ficha por ficha y abandona un intento en cuanto arriba y abajo dejan de coincidir.
Mientras coinciden, una de las dos cadenas es prefijo de la otra. La parte común ya no importa. Lo que hay que recordar es:
- qué lado va adelantado, arriba o abajo;
- con qué cadena: el exceso.
Poner una ficha lleva de un exceso a otro, o no se puede. Si abajo sobra y se pone la ficha
, arriba se cubre la y abajo se agrega :
ahora abajo sobra . Una solución es un camino que sale del exceso vacío y vuelve a él después de
al menos una ficha. Para 2 1 3 2 4:
| Ficha | Arriba se lee | Abajo se lee | Exceso |
|---|---|---|---|
| 2 | abajo, | ||
| 1 | abajo, | ||
| 3 | abajo, | ||
| 2 | abajo, | ||
| 4 | vacío |
En el último paso abajo sobra . La ficha 4 agrega abajo, y lo pendiente pasa a ser ; arriba agrega justo . No sobra nada.
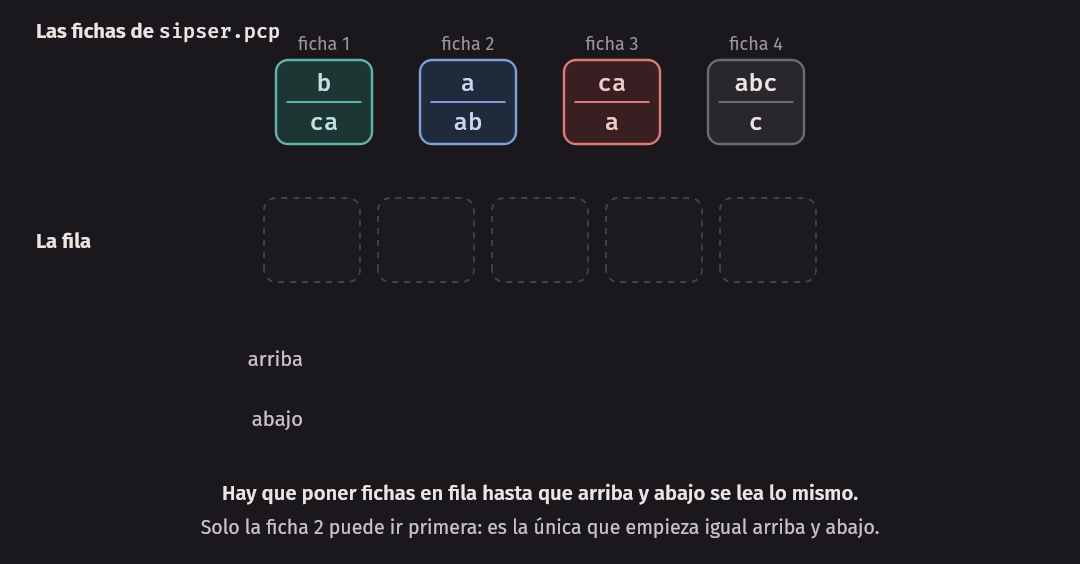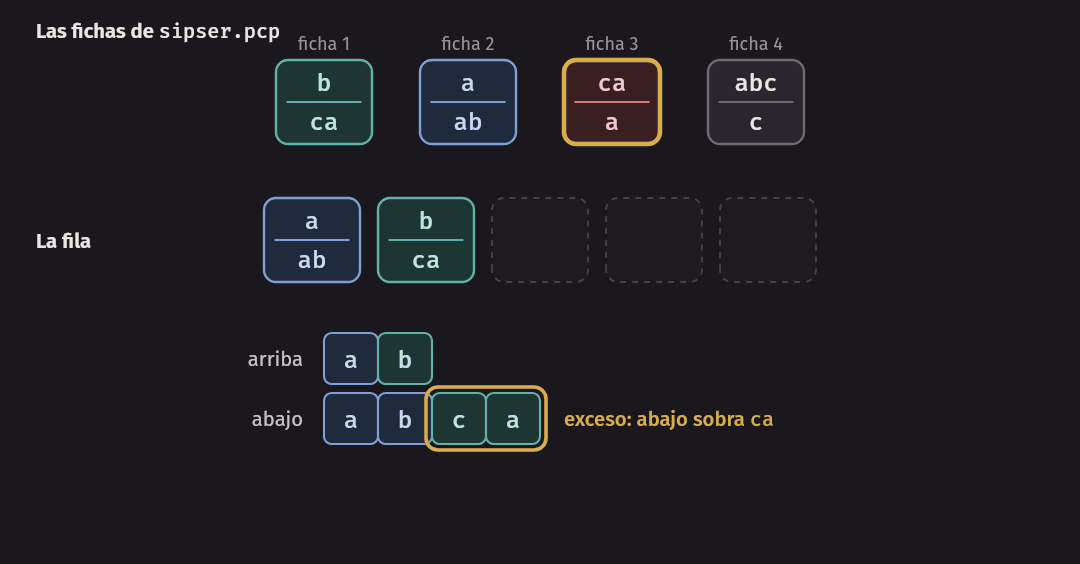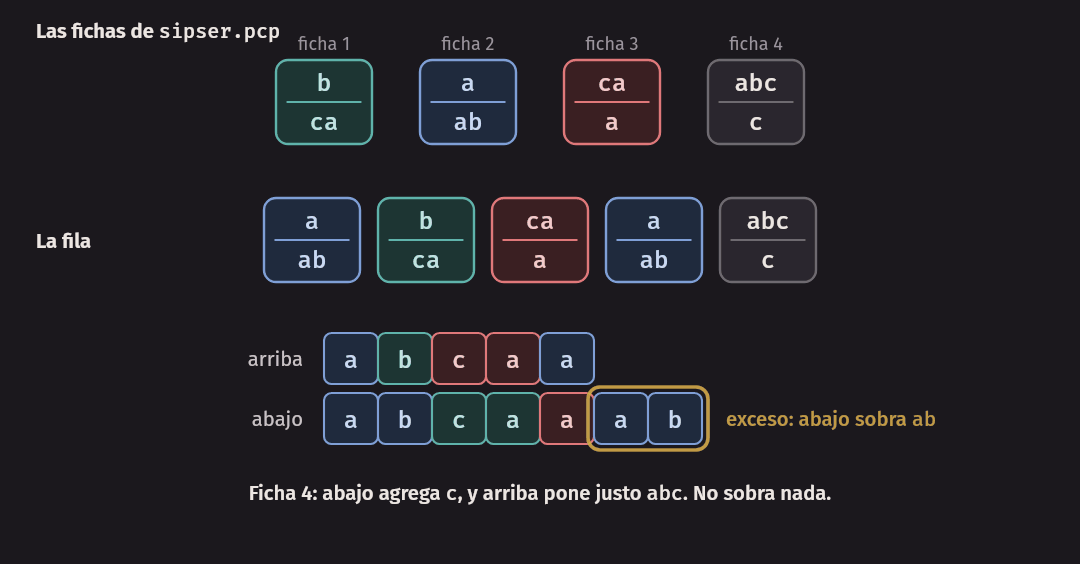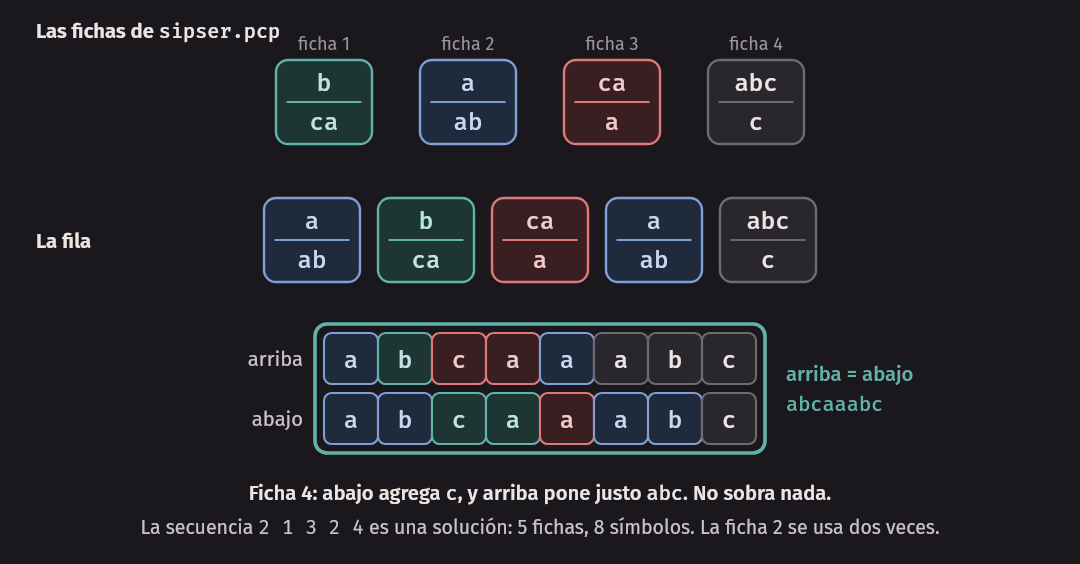
Los excesos son los vértices de un grafo, y las fichas, sus aristas. Buscar una solución es buscar un camino en ese grafo, y la herramienta es la búsqueda en anchura de Algoritmos, con dos cuidados:
- No repetir excesos. Si dos filas distintas dejan el mismo lado adelantado con la misma cadena, lo que se puede hacer después es idéntico. Basta seguir con la primera que llegó.
- Poner una cota. El grafo puede ser infinito: los excesos pueden crecer sin límite. La búsqueda recibe un número y no pasa de fichas.
pcp_solve hace eso, y dice cuántos excesos distintos visitó:
$ build/pcp_solve instances/sipser.pcp 10
4 fichas, hasta 10 por solución
solución con 5 fichas: 2 1 3 2 4
cadena: abcaaabc
excesos visitados: 5
Como busca por niveles, la solución que encuentra es una de las más cortas. Con una cota menor que 5 no la encuentra:
$ build/pcp_solve instances/sipser.pcp 4
4 fichas, hasta 4 por solución
sin solución hasta 4
excesos visitados: 4
La respuesta dice hasta 4, y es lo único que el programa sabe. La instancia tiene solución.
Tres finales distintos
Con las instancias sin solución de la sección anterior pasa algo que parece contradecir lo dicho:
$ build/pcp_solve instances/cycle.pcp 1000
3 fichas, hasta 1000 por solución
sin solución: la búsqueda se quedó sin excesos nuevos
excesos visitados: 1
El programa afirma que no hay solución, de ninguna longitud, y tiene razón. El grafo de excesos de esta instancia tiene un solo vértice alcanzable, el exceso con abajo adelantado, y desde él no se llega al exceso vacío. Cuando el grafo alcanzable es finito, la búsqueda en anchura lo recorre entero y puede responder que no.
Lo que la búsqueda no puede hacer es responder siempre. Hay instancias en las que los excesos crecen sin
parar. En instances/hard_75.pcp las fichas son
y esto es lo que pasa:
$ build/pcp_solve instances/hard_75.pcp 45
3 fichas, hasta 45 por solución
sin solución hasta 45
excesos visitados: 70718
$ build/pcp_solve instances/hard_75.pcp 400
3 fichas, hasta 400 por solución
búsqueda abandonada: demasiados excesos distintos
excesos visitados: 2000000
Con cota 45 visitó 70 718 excesos sin encontrar nada. Con cota 400 llegó al tope de dos millones que tiene el programa para no agotar la memoria, y abandonó. Ninguna de las dos respuestas dice si la instancia tiene solución.
La tiene. Una búsqueda más astuta, que avanza a la vez desde el principio y desde el final de la fila y junta las dos mitades, la encuentra:
$ build/pcp_meet instances/hard_75.pcp 40
3 fichas, hasta 40 desde cada extremo
solución con 75 fichas: 1 1 2 1 1 2 1 3 3 1 3 2 2 1 1 2 2 1 1 1 1 2 3 1 1 3 3 1 1 2 3 1 2 3 3 2 2 3 3 1 2 3 1 2 2 3 2 3 1 2 3 3 1 2 3 1 2 2 3 1 2 3 3 3 1 2 2 2 3 1 3 3 2 2 3
comprobada: arriba y abajo se leen 125 símbolos
excesos visitados: 28473
Tres fichas, ninguna cadena de más de tres símbolos, y la solución más corta tiene 75 fichas. Que es la más
corta también lo dice una ejecución: pcp_meet con 37 fichas por extremo cubre todas las soluciones de hasta
74 y responde sin solución hasta 74.
Error común. Creer que un problema es decidible porque todas las instancias que uno probó tenían respuesta. Cada instancia de PCP tiene respuesta: o existe una solución o no existe. Y para muchas instancias la respuesta se encuentra, con una búsqueda o con un argumento a medida, como en los tres ejemplos sin solución. Decidible quiere decir otra cosa: que un solo algoritmo responda bien en todas. Que el programa de uno haya respondido en las cien instancias que probó no dice nada sobre la que lo hará abandonar, y después de
hard_75.pcpya vieron una. Cambiar el programa por uno mejor mueve la frontera. No la elimina.
En C++. El estado de la búsqueda cabe en una cadena: un carácter para el lado,
ToB, seguido del exceso. Así sirve directamente como clave de unstd::unordered_map, que guarda para cada exceso visitado de dónde se llegó y con qué ficha. La funciónextenddepcp.hcalcula el exceso nuevo con dos comparaciones de prefijos, y es el corazón del laboratorio.
PCP es indecidible
Teorema. PCP es indecidible.
La demostración es una reducción desde hacia PCP, que es la dirección que sirve porque es el problema que ya sabemos indecidible. Hay que dar una función computable que convierta cada par en un conjunto de fichas tal que
La idea: diseñar las fichas para que la única manera de armar una fila que coincida sea escribir una historia de cómputo de aceptación de con , arriba y abajo. Las dos cadenas dicen lo mismo, pero abajo va siempre una configuración adelantado. Cada ficha que se pone arriba copia un pedazo de la configuración que abajo ya está escrita, y al mismo tiempo escribe abajo el pedazo correspondiente de . Las fichas hacen, con cadenas, la revisión por ventanas de la sección anterior.
Aquí no se construye la demostración para una máquina general con todos sus subíndices. Se muestra la
construcción con un ejemplo, se enumeran los tipos de ficha y se explica por qué funciona. El programa
tm_to_pcp la hace para cualquier máquina del formato .tm.
Dos simplificaciones
Primera: la solución empieza con una ficha fija. En el PCP modificado la instancia es la misma, una lista de fichas, pero una solución tiene que empezar con la ficha 1. Reducimos al PCP modificado, y al final se quita la condición con un paso aparte.
Segunda: nunca intenta moverse a la izquierda desde la primera celda. No se pierde generalidad. Toda máquina se puede cambiar por otra que acepta las mismas cadenas y lo cumple: la nueva empieza corriendo su entrada una celda a la derecha y dejando una marca en la primera celda, y cada vez que lee la marca vuelve a la derecha sin cambiar de estado. Las máquinas de los ejemplos ya lo cumplen.
Las fichas, con un ejemplo
La máquina es machines/starts_01.tm, la de la sesión A, y la entrada es . Su historia tiene
cuatro configuraciones, con un movimiento a la derecha, uno a la izquierda y otro a la derecha:
$ build/history machines/starts_01.tm 01
C1   q0 0 1
C2   0 q1 1
C3   q2 0 1
C4   0 q_accept 1
acepta después de 3 pasos
historia: q0 0 1 # 0 q1 1 # q2 0 1 # 0 q_accept 1
En una ficha cada símbolo es un carácter, así que el programa le da una letra a cada estado. Estas son todas las fichas:
$ build/tm_to_pcp machines/starts_01.tm 01
estados: A = q0, B = q1, C = q2, D = q_accept, E = q_reject
 n.º  tipo        arriba  abajo
   1  inicio      #       #A01#
   2  derecha     A0      0B
   3  derecha     C0      0D
   4  izquierda   0B1     C01
   5  izquierda   1B1     C11
   6  izquierda   _B1     C_1
   7  copia       0       0
   8  copia       1       1
   9  copia       _       _
  10  separador   #       #
  11  separador   #       _#
  12  comer       0D      D
  13  comer       1D      D
  14  comer       _D      D
  15  comer       D0      D
  16  comer       D1      D
  17  comer       D_      D
  18  final       D##     #
Son siete tipos. Para una máquina y una entrada cualesquiera:
1. La ficha de inicio.
Es la ficha 1, la obligatoria. Deja abajo escrita la configuración inicial , y arriba solo el separador. Desde aquí abajo va adelantado en una configuración entera. Si , se escribe , para que el estado tenga a su derecha el blanco que lee.
2. Una ficha por cada transición a la derecha. Si :
Arriba lee el estado y el símbolo bajo el cabezal; abajo escribe lo que queda después del paso: el símbolo nuevo y, a su derecha, el estado nuevo. En el ejemplo, la ficha 2 es .
3. Fichas por cada transición a la izquierda. Si , una ficha por cada símbolo :
El estado tiene que saltar por encima del símbolo que está a su izquierda, y la ficha no sabe cuál es: por eso hay una por cada posible. Las fichas 4, 5 y 6 son , con igual a , y .
4. Fichas de copia. Para cada :
Copian a la configuración siguiente los símbolos de la cinta que están lejos del cabezal.
5. Las fichas del separador.
La primera copia el separador. La segunda, además, agrega un blanco al final de la configuración que se está escribiendo abajo. Hace falta cuando el cabezal avanza más allá de lo escrito: la cinta es infinita y la configuración solo anota una parte, así que hay que poder alargarla.
6. Las fichas que comen. Para cada :
Hasta aquí todas las fichas, salvo la de inicio, tienen arriba a lo sumo tantos símbolos como abajo: con ellas arriba nunca alcanza a abajo. Estas son las primeras que acortan. Solo se pueden usar cuando abajo aparece , y en cada “configuración” siguiente el estado de aceptación se come un símbolo vecino.
7. La ficha final.
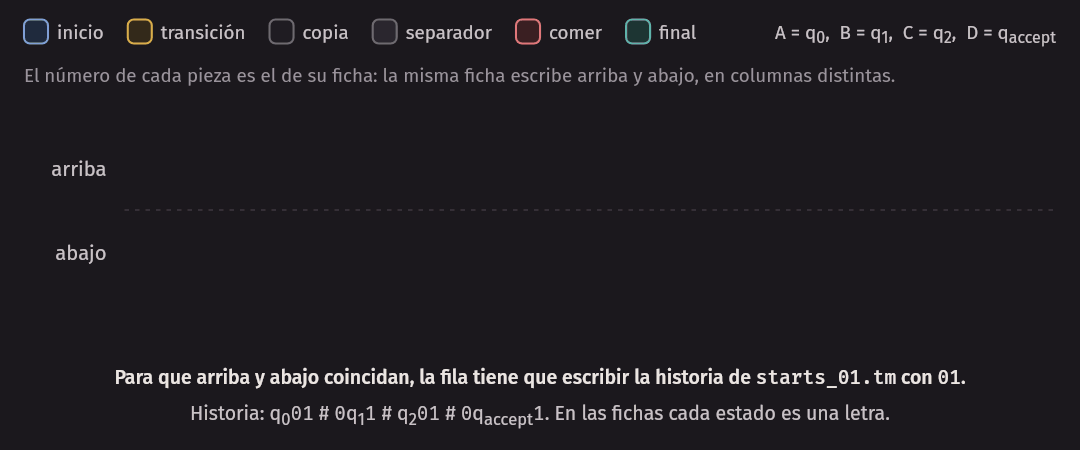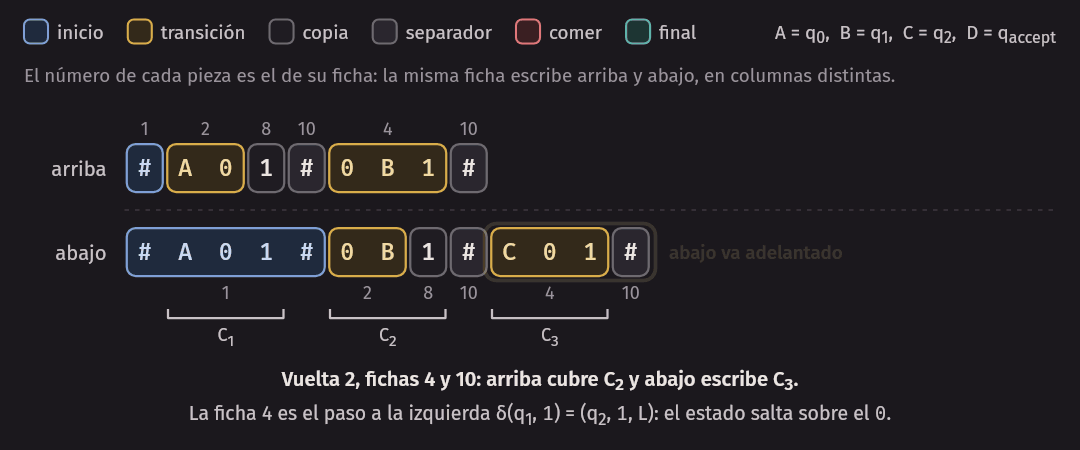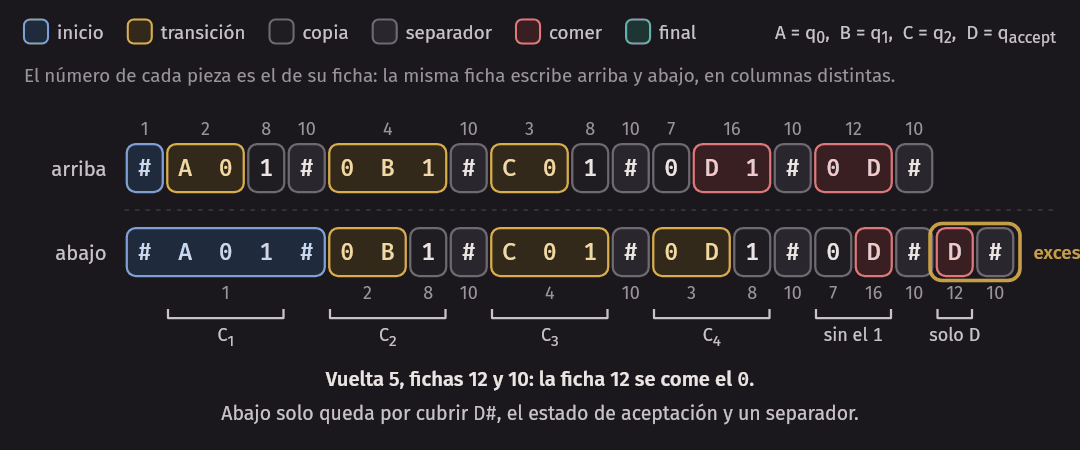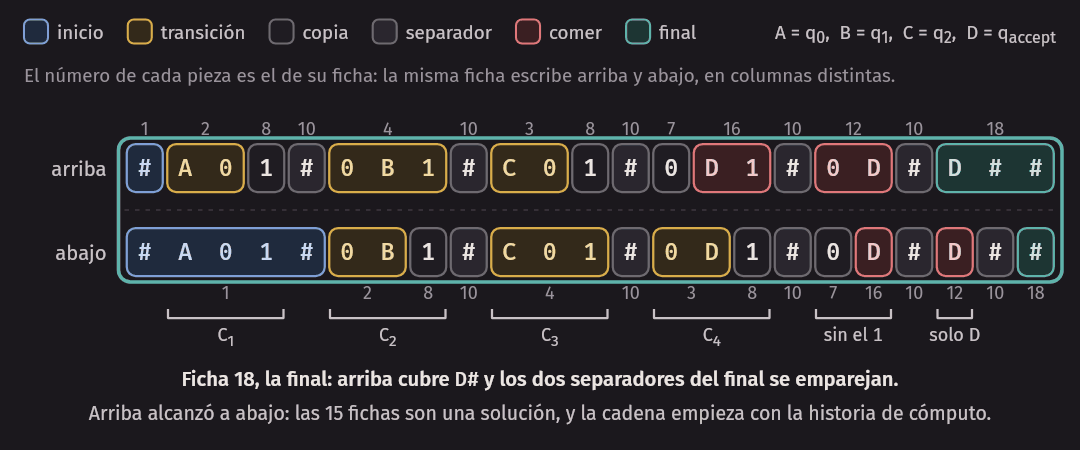
Cuando abajo solo queda por cubrir, esta ficha lo cubre y empareja los dos separadores finales.
No hay fichas para , ni para un par sin transición. Si la máquina llega ahí, no hay ninguna ficha que tenga ese estado arriba, y la fila no se puede continuar.
La cantidad de fichas es finita y se calcula leyendo la tabla de . En el ejemplo, con : una de inicio, 2 de transiciones a la derecha, de la transición a la izquierda, 3 de copia, 2 de separador, que comen y una final. Son 18.
La solución del ejemplo
Se guarda la instancia en un archivo y se busca, pidiendo que la solución empiece con la ficha 1:
$ build/tm_to_pcp machines/starts_01.tm 01 --mpcp > build/starts_01.pcp
$ build/pcp_solve build/starts_01.pcp 30 --primera
18 fichas, hasta 30 por solución, empezando con la ficha 1
solución con 15 fichas: 1 2 8 10 4 10 3 8 10 7 16 10 12 10 18
cadena: #A01#0B1#C01#0D1#0D#D##
excesos visitados: 459
La cadena que se lee es la historia de cómputo: , seguida de la
limpieza. pcp_check muestra cómo la cortan las fichas arriba y abajo:
$ build/pcp_check build/starts_01.pcp 1 2 8 10 4 10 3 8 10 7 16 10 12 10 18
arriba: # A0 1 # 0B1 # C0 1 # 0 D1 # 0D # D##  =  #A01#0B1#C01#0D1#0D#D##
abajo:  #A01# 0B 1 # C01 # 0D 1 # 0 D # D # #  =  #A01#0B1#C01#0D1#0D#D##
es una solución (15 fichas, 23 símbolos)
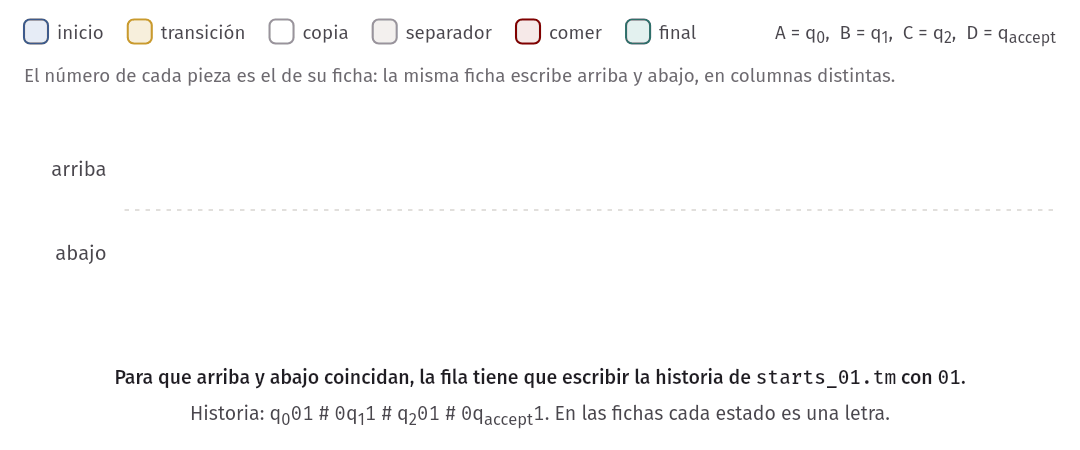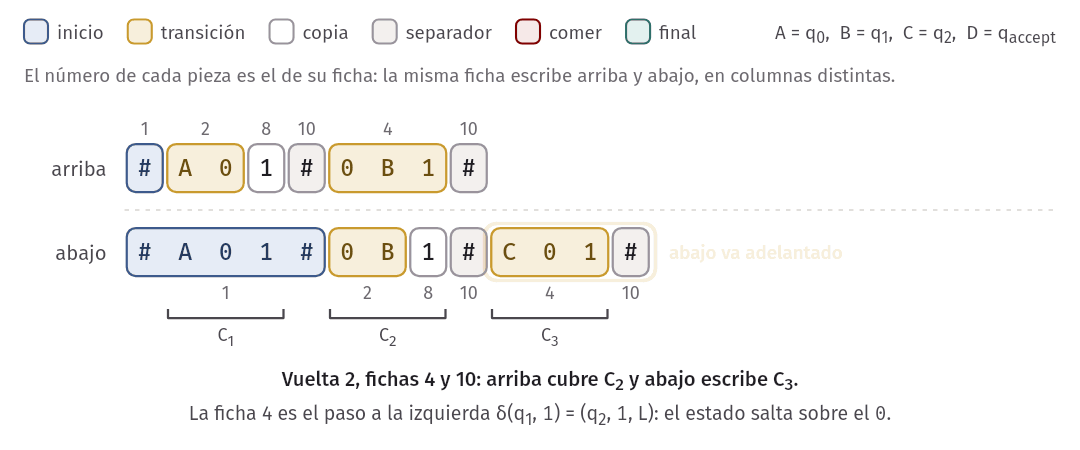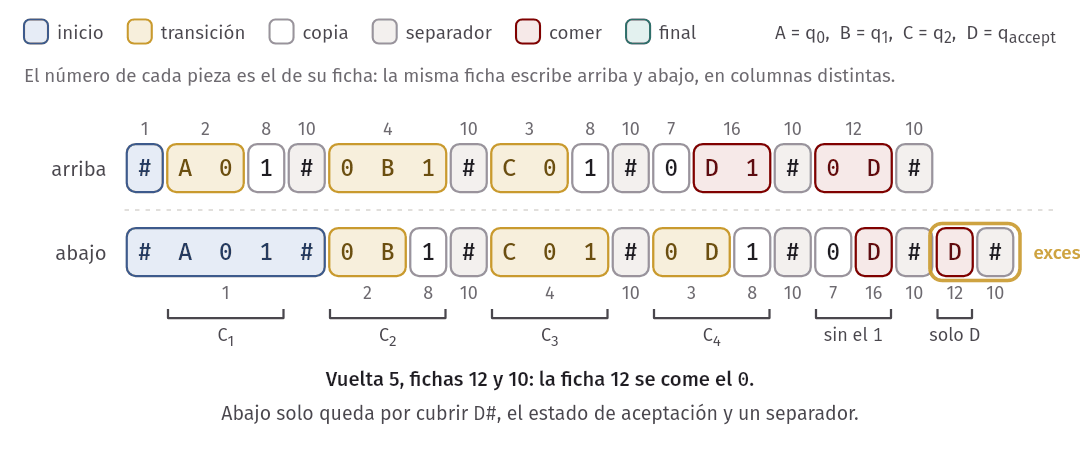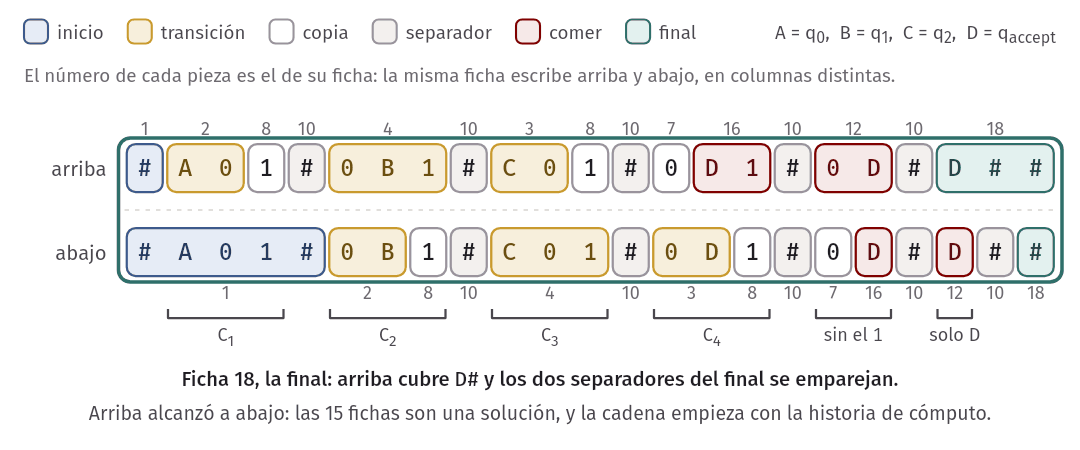
Por vueltas, con lo que arriba cubre y lo que abajo escribe en cada una:
| Vuelta | Fichas | Arriba cubre | Abajo escribe | Qué pasó |
|---|---|---|---|---|
| inicio | 1 | queda escrita | ||
| 1 | 2, 8, 10 | , , | , , | de sale , paso a la derecha |
| 2 | 4, 10 | , | , | de sale , paso a la izquierda |
| 3 | 3, 8, 10 | , , | , , | de sale : acepta |
| 4 | 7, 16, 10 | , , | , , | se come el |
| 5 | 12, 10 | , | , | se come el |
| final | 18 | arriba alcanza a abajo |
En cada vuelta, lo que arriba cubre es exactamente lo que abajo se escribió en la vuelta anterior. En las vueltas 1 a 3 las fichas simulan a : una ficha de transición donde está el estado, fichas de copia en lo demás, y el separador. En las vueltas 4 y 5 ya no se simula nada: abajo se escribe la misma configuración con un símbolo menos, hasta que solo queda el estado.
Por qué funciona
Hay que demostrar las dos direcciones, para el PCP modificado: las fichas tienen una solución que empieza con la ficha 1 si y solo si acepta .
Si acepta , hay solución. Sea la historia de aceptación. Se construye la fila como en el ejemplo, manteniendo esta situación al empezar cada vuelta :
La ficha de inicio la establece para . En la vuelta , con , se cubre con la ficha de la transición que aplica en , puesta donde está el estado, fichas de copia para el resto y una ficha de separador. Abajo queda escrita , porque esas fichas hacen justo lo que dice la revisión por ventanas: copian lo que está lejos del cabezal y cambian los tres símbolos de alrededor según . Si en el estado quedó al final, se usa el separador que agrega un blanco. Cuando se llega a , que tiene a , cada vuelta siguiente usa una ficha que come y copia el resto: abajo se escribe una configuración un símbolo más corta. Cuando abajo queda , la ficha final cierra. Arriba y abajo se lee la misma cadena.
Si hay solución, acepta . Supongamos una solución que empieza con la ficha 1.
- Tiene que aparecer . La ficha de inicio tiene abajo más símbolos que arriba. Las de los tipos 2 a 5 tienen arriba a lo sumo tantos como abajo. Con esas solas, abajo siempre es más largo y no hay coincidencia. La solución usa entonces alguna ficha de los tipos 6 o 7, y todas tienen a arriba. Como arriba y abajo se lee lo mismo, aparece en la cadena.
- Todo lo que se escribe antes es simulación. Miren la cadena hasta la primera aparición de . Empieza con , por la ficha de inicio. Lo que arriba va cubriendo es lo que abajo ya está escrito, y las fichas no dejan elegir: un símbolo de la cinta lejos de un estado solo se cubre con su ficha de copia; un separador, con una ficha de separador (o con la de inicio, que escribe abajo otra copia de ); y un estado que lee solo se cubre con la ficha de , que es una sola porque es determinista. Entonces, cada vez que arriba se termina de cubrir una configuración , abajo quedó escrita la configuración que produce desde , quizá con un blanco más al final. Todas las configuraciones que aparecen en la cadena son, por lo tanto, la inicial o una que alcanza desde ella.
- Conclusión. La primera configuración con la escribió abajo una ficha de transición, así que es una configuración que alcanza desde . acepta .
Con las dos direcciones, se reduce al PCP modificado.
El segundo punto es el delicado de la demostración, y aquí está contado y no desarrollado símbolo por símbolo.
Lo acompaña una comprobación: test_tm_pcp genera las fichas de 27 pares de máquina y entrada, las resuelve
con la búsqueda en anchura, y verifica que hay solución en los 9 pares en que la máquina acepta y que en ellos
la cadena de la solución empieza con la historia de aceptación, revisada con check_history. En los otros 18
no aparece ninguna solución de hasta 40 fichas.
Lo que hace la búsqueda cuando no acepta es instructivo. Con la entrada , la máquina
starts_01.tm rechaza en el segundo paso, porque no hay transición para :
$ build/tm_to_pcp machines/starts_01.tm 00 --mpcp > build/starts_00.pcp
$ build/pcp_solve build/starts_00.pcp 30 --primera
18 fichas, hasta 30 por solución, empezando con la ficha 1
sin solución: la búsqueda se quedó sin excesos nuevos
excesos visitados: 9
La fila se atasca donde se atasca la máquina, y la búsqueda termina. En cambio loop_on_0.tm con
no se detiene nunca, y las fichas tampoco:
$ build/tm_to_pcp machines/loop_on_0.tm 00 --mpcp > build/loop_00.pcp
$ build/pcp_solve build/loop_00.pcp 30 --primera
17 fichas, hasta 30 por solución, empezando con la ficha 1
sin solución hasta 30
excesos visitados: 1201
$ build/pcp_solve build/loop_00.pcp 60 --primera
17 fichas, hasta 60 por solución, empezando con la ficha 1
sin solución hasta 60
excesos visitados: 20359
Con cualquier cota la respuesta será la misma, y la búsqueda no tiene cómo saberlo. Buscar una solución de estas fichas es simular a con , con otro formato. Un algoritmo que decidiera PCP estaría decidiendo si esa simulación llega a aceptar.
Quitar la condición de la primera ficha
Falta pasar del PCP modificado al PCP sin condiciones. Que la condición importa se ve con las mismas fichas:
$ build/pcp_solve build/starts_01.pcp 30
18 fichas, hasta 30 por solución
solución con 1 ficha: 7
cadena: 0
excesos visitados: 1
Sin la obligación de empezar por la ficha 1, cualquier ficha de copia es una solución por sí sola, y la respuesta ya no dice nada sobre .
El arreglo es cambiar las fichas para que solo la de inicio pueda ir primera. Se usan dos símbolos nuevos,
y (en los archivos, * y $). Para una cadena se definen tres
versiones con asteriscos intercalados:
Si las fichas del PCP modificado son , las del PCP son
Son fichas: una copia especial de la primera, todas las originales transformadas (también la primera) y una de cierre.
- Solo la primera puede empezar. En todas las demás, arriba empieza con y abajo con un símbolo que no es . La copia especial de la ficha 1 es la única que empieza con en los dos lados.
- Después, los asteriscos se intercalan solos. Arriba cada símbolo lleva su asterisco antes, y abajo después. Tras la primera ficha, que abajo puso un asterisco inicial de más, las dos cadenas tienen asteriscos en las mismas posiciones, y coinciden exactamente cuando coinciden las originales.
- El cierre. Arriba termina sin asterisco final y abajo con uno. La ficha pone el que falta arriba, y solo puede ir al final.
Entonces una solución de las fichas nuevas es una solución de las originales que empieza con la ficha 1, con asteriscos y el cierre, y al revés. La transformación es computable. Con el ejemplo:
$ build/tm_to_pcp machines/starts_01.tm 01 --pcp
# Fichas de machines/starts_01.tm con la entrada 01.
# Estados: A = q0, B = q1, C = q2, D = q_accept, E = q_reject.
dominoes: 20
*# *#*A*0*1*#*
*# #*A*0*1*#*
*A*0 0*B*
*C*0 0*D*
*0*B*1 C*0*1*
*1*B*1 C*1*1*
*_*B*1 C*_*1*
*0 0*
*1 1*
*_ _*
*# #*
*# _*#*
*0*D D*
*1*D D*
*_*D D*
*D*0 D*
*D*1 D*
*D*_ D*
*D*#*# #*
*$ $
$ build/tm_to_pcp machines/starts_01.tm 01 --pcp > build/starts_01_free.pcp
$ build/pcp_solve build/starts_01_free.pcp 30
20 fichas, hasta 30 por solución
solución con 16 fichas: 1 3 9 11 5 11 4 9 11 8 17 11 13 11 19 20
cadena: *#*A*0*1*#*0*B*1*#*C*0*1*#*0*D*1*#*0*D*#*D*#*#*$
excesos visitados: 1226
Ahora la búsqueda no recibe ninguna condición, y la solución es la misma de antes, con una ficha más: cada
número subió en uno, salvo el primero, y al final está la ficha 20. Quitando los asteriscos y el $ se lee
la misma historia.
Demostración del teorema. La composición de las dos transformaciones es una función computable que manda a un conjunto de fichas que tiene solución si y solo si acepta . Es decir, . Como es indecidible, PCP es indecidible. ∎
De paso: PCP es reconocible e indecidible, así que su complemento no es reconocible. No hay un procedimiento que, para toda instancia sin solución, termine diciendo “no tiene”.
Idea clave. Las fichas no calculan. Cada una solo dice “si aquí arriba va esto, aquí abajo va esto otro”. Pero como comprobar un paso de una máquina de Turing es local, esas reglas locales alcanzan para obligar a que la fila entera sea una ejecución correcta. Un problema no necesita hablar de máquinas para contenerlas: le basta poder expresar restricciones entre símbolos vecinos.
¿Genera una gramática todas las cadenas?
En la semana 9 se decidieron dos problemas sobre gramáticas libres de contexto: , si una gramática genera una cadena, y , si no genera ninguna. La pregunta opuesta a la segunda es
Para los DFA las dos preguntas son la misma: si y solo si el complemento de es vacío, y el complemento se obtiene intercambiando estados de aceptación. Con las gramáticas ese camino está cerrado, porque los lenguajes libres de contexto no son cerrados bajo complemento. Podría haber otro camino. No lo hay.
Teorema. es indecidible.
La reducción sale de , y usa las historias de cómputo de una manera que al principio parece al revés. De se construye una gramática que genera todas las cadenas que no son una historia de aceptación de con . Entonces:
- si acepta , existe la historia de aceptación, que es una cadena que no genera, y ;
- si no acepta , ninguna cadena es una historia de aceptación, las genera todas, y .
Es decir, acepta si y solo si .
Por qué las cadenas que no son historias sí se pueden generar
Una gramática no puede generar las historias de aceptación. Para eso habría que comprobar que todas las configuraciones seguidas encajan, y con una pila no se comparan más de dos cosas. Pero ser una historia es una conjunción de condiciones, y no serlo es una disyunción: basta que falle una. Una cadena no es una historia de aceptación de con si pasa al menos una de estas cosas:
- no tiene la forma de configuraciones separadas por ;
- la primera configuración no es ;
- la última no tiene a ;
- para algún , la configuración no produce .
Es más cómodo describir un autómata de pila que una gramática, y en la semana 6 vimos que de un autómata de pila se obtiene una gramática equivalente con un algoritmo. El autómata es no determinista y empieza adivinando cuál de las cuatro condiciones va a encontrar violada.
- Las condiciones 1, 2 y 3 no necesitan la pila. La forma es un lenguaje regular; comparar el principio con la cadena fija lo hace un autómata finito, porque está fijada en la construcción; buscar después del último separador, también.
- La condición 4 es la que usa la pila. adivina el : avanza hasta algún separador, mete en la pila símbolo por símbolo, y al llegar al separador siguiente saca de la pila mientras lee , comparando. Como en la revisión por ventanas, las dos deben ser iguales salvo alrededor del estado, donde deben cambiar según ; eso se controla con una cantidad fija de memoria en los estados de . Si encuentra una posición que no encaja, acepta.
El truco de escribir al revés
Hay un problema con la condición 4. La pila devuelve las cosas en el orden contrario: si se mete de izquierda a derecha, sale de derecha a izquierda. Pero se lee de izquierda a derecha. estaría comparando el final de una con el principio de la otra.
La solución es cambiar la manera de escribir las historias: las configuraciones pares van al revés.
(la última va al derecho o al revés según sea impar o par). Así, de cada dos configuraciones seguidas una está al derecho y la otra al revés. Lo que sale de la pila es la primera invertida, y la segunda está escrita invertida respecto de la primera: los símbolos se enfrentan posición por posición. Es la misma razón por la que un autómata de pila reconoce sin esfuerzo.
El programa history escribe esta forma con --alterna:
$ build/history machines/zeros_ones.tm 01 --alterna
C1   q0 0 1
C2   X q1 1
C3   q2 X Y
C4   X q0 Y
C5   X Y q3 _
C6   X Y _ q_accept _
acepta después de 5 pasos
historia: q0 0 1 # 1 q1 X # q2 X Y # Y q0 X # X Y q3 _ # _ q_accept _ Y X, y aparecen invertidas. Cambiar la escritura no cambia nada de lo anterior: acepta si y solo si existe una historia de aceptación escrita así, y sigue siendo única salvo los blancos.
Escribir al revés no es la única manera de resolverlo, pero es la más directa: deja que la pila haga lo que hace bien.
La demostración
Demostración. Por reducción desde . Supongamos que decide , y sea :
S = "Con la entrada ⟨M, w⟩, donde M es una máquina de Turing y w una cadena:
  1. Construir el autómata de pila D que acepta las cadenas que no son una historia de
     aceptación de M con w, escrita con las configuraciones pares al revés.
  2. Convertir D en una gramática G equivalente.
  3. Correr R con la entrada ⟨G⟩.
4. Si R acepta, rechazar. Si R rechaza, aceptar."se detiene siempre: los pasos 1 y 2 escriben descripciones a partir de la tabla de y de , y es un decididor. Si acepta , la historia de aceptación es una cadena que no acepta, , rechaza y acepta. Si no acepta , no existe ninguna historia de aceptación, acepta todas las cadenas, , acepta y rechaza. decide : contradicción. ∎
Como reducción por función, lo que se construyó es , por la inversión del paso 4. Con la propiedad de los complementos, : el lenguaje no es ni siquiera reconocible. Su complemento sí lo es: se prueban las cadenas una por una con el decididor de de la semana 9, que siempre termina, y se acepta al encontrar una que la gramática no genera.
Aquí no hay programa que acompañe: el autómata para una máquina concreta es demasiado grande para leerlo
y no enseña más que su descripción. Lo que sí está en el código es la otra mitad del argumento: check_history
decide el lenguaje de las historias de aceptación, y el lenguaje de es su complemento.
Idea clave. Una gramática no puede verificar una ejecución completa, pero sí puede señalar un error en una ejecución mal hecha, porque un error es una sola posición que no encaja. “Generar todo lo que no es una historia válida” está al alcance de una pila. Preguntar si eso es todo es preguntar si existe una historia válida.
Consecuencias: equivalencia y ambigüedad
La deuda de la semana 9
En la semana 9 vimos por qué el método de los DFA no se podía copiar, y quedó dicho que eso no demostraba nada. Ahora sí se demuestra.
Teorema. es indecidible.
Demostración. Por reducción desde hacia . La dirección sirve porque ya se demostró indecidible.
Sea la gramática con una variable y las reglas para cada símbolo , más . Genera . La función es computable, y
Entonces , y como el primero es indecidible, el segundo también. ∎
Es el mismo movimiento que llevó de a : preguntar por una propiedad del lenguaje es un caso particular de comparar con una gramática fija que la tiene.
En la práctica. Dos gramáticas para el mismo lenguaje de programación, la del manual y la que se reescribió para el parser, no se pueden comparar con un algoritmo general. Lo que se hace es probar: generar muchos programas con una y analizarlos con la otra. El complemento de es reconocible, por la misma búsqueda de antes, así que si las gramáticas difieren hay una cadena que lo muestra, y probando por longitud creciente se la encuentra. Lo que no se puede obtener es la confirmación de que son iguales.
Decidir si una gramática es ambigua
En la semana 5 quedó otra promesa: no hay un algoritmo que diga si una gramática es ambigua, es decir, si alguna cadena tiene dos árboles de derivación.
Teorema. El lenguaje es indecidible.
Se enuncia, con la idea de la demostración. Es una reducción desde PCP: de un conjunto de fichas se construye una gramática que es ambigua exactamente cuando las fichas tienen solución.
Sean las fichas . Se agregan terminales nuevos, , uno por ficha, que sirven de etiquetas. La gramática es
Desde se generan las cadenas : lo que se lee arriba en una fila de fichas, seguido de la lista de las fichas usadas, al revés. Desde , lo mismo con las cadenas de abajo.
- Las etiquetas del final dicen qué reglas se usaron y en qué orden. Por eso cada cadena tiene un solo árbol desde , y uno solo desde .
- Una cadena tiene dos árboles solo si se genera desde y desde . Eso pide las mismas etiquetas, o sea la misma fila de fichas, y la misma cadena antes de las etiquetas: lo de arriba igual a lo de abajo. Es una solución de PCP.
- Al revés, una solución da una cadena con dos árboles, uno que empieza con y otro con .
Entonces las fichas tienen solución si y solo si la gramática es ambigua, y la reducción es . Aquí se ve para qué sirve tener un problema indecidible sin máquinas: reducir desde PCP hacia un problema de gramáticas es mucho más corto que reducir desde .
El contraste con los autómatas finitos
La misma lista de preguntas, hecha a los tres modelos del curso:
| Pregunta | DFA | Gramática libre de contexto | Máquina de Turing |
|---|---|---|---|
| ¿Acepta (genera) ? | decidible | decidible () | indecidible () |
| ¿El lenguaje es vacío? | decidible | decidible () | indecidible () |
| ¿El lenguaje es ? | decidible | indecidible () | indecidible |
| ¿Dos son equivalentes? | decidible | indecidible () | indecidible () |
| ¿El lenguaje es regular? | siempre sí | indecidible (se enuncia) | indecidible () |
La columna de los DFA es toda decidible, y por una razón común: los lenguajes regulares son cerrados bajo todas las operaciones booleanas, con construcciones explícitas, y un DFA tiene una cantidad finita de configuraciones. Preguntar si es preguntar si el complemento es vacío. Preguntar si dos son equivalentes es preguntar si la diferencia simétrica es vacía.
En la columna de las gramáticas aparece la frontera. Las preguntas que se responden mirando hacia adentro del lenguaje, si una cadena está o si hay alguna, siguen siendo decidibles. Las que piden mirar hacia afuera, lo que la gramática no genera, dejan de serlo. El motivo es el de esta semana: lo que una gramática no genera puede ser el conjunto de las ejecuciones correctas de una máquina de Turing.
En la columna de las máquinas de Turing no queda nada, y el teorema de Rice dice que no es casualidad.
Hay un precio que se paga por el poder de expresión. Cada modelo más capaz reconoce más lenguajes, y de cada modelo más capaz se puede averiguar menos. Quien diseña un lenguaje de configuración, un formato de reglas o un lenguaje de consultas elige en qué columna quiere estar: si las reglas son expresiones regulares, se puede comprobar automáticamente que dos conjuntos de reglas hacen lo mismo. Si son programas, no.
El código de la semana
code/week-10/
├── tm.h                  struct Tm, lectura del formato .tm, simulación, historias y check_history
├── history.cpp           escribe la historia de cómputo de una máquina con una entrada
├── check_history.cpp     comprueba una historia ventana por ventana
├── fix_input.h           la construcción de M_w: fijar la entrada dentro de la máquina
├── fix_input.cpp         escribe M_w en formato .tm
├── pcp.h                 fichas, comprobación de una solución y las dos búsquedas
├── pcp_check.cpp         ¿es esta secuencia de fichas una solución?
├── pcp_solve.cpp         búsqueda en anchura sobre el exceso, con cota
├── pcp_meet.cpp          búsqueda desde los dos extremos
├── tm_pcp.h              de una máquina y una entrada a un conjunto de fichas
├── tm_to_pcp.cpp         muestra o escribe esas fichas
├── machines/             cuatro máquinas pequeñas, en formato .tm
├── instances/            las instancias de PCP del capítulo
├── errors/               una descripción no determinista, que los programas rechazan
├── test_fix_input.cpp    L(M_w) es {w} o ∅, según M acepte w
├── test_history.cpp      las historias del capítulo y el comprobador
├── test_pcp.cpp          las instancias del capítulo; la búsqueda contra la fuerza bruta
├── test_tm_pcp.cpp       las fichas tienen solución exactamente cuando la máquina acepta
└── lab/pcp_search/       el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Tarda más que en otras semanas, casi
todo en las búsquedas de test_tm_pcp.
$ make test
test_fix_input: ok (124 pares de máquina y w, 63 entradas cada uno)
test_history: ok (5 historias, 8250 cambios de un símbolo, todos detectados)
test_pcp: ok (3000 instancias al azar, 780 con solución)
test_tm_pcp: ok (27 pares de máquina y entrada, 9 con aceptación; sin solución hasta 40 fichas en los demás)
Todas las pruebas pasaron.
Qué comprueba cada una:
test_fix_inputconstruye para cuatro máquinas y cada de longitud a lo sumo 4, y la corre con cada de longitud a lo sumo 5, con un tope de pasos. rechaza toda , y con hace lo que : acepta, rechaza o sigue corriendo.test_historycomprueba las historias copiadas en este capítulo, que la máquina dezeros_ones.tmacepta exactamente las cadenas entre las 511 de longitud a lo sumo 8, y quecheck_historyrechaza cualquier historia con un símbolo cambiado.test_pcpcomprueba cada instancia deinstances/con lo que el capítulo dice de ella, y compara la búsqueda en anchura y la búsqueda desde los dos extremos con la fuerza bruta, que prueba todas las secuencias, en 3000 instancias pequeñas al azar.test_tm_pcpes la comprobación de la reducción, descrita en Por qué funciona.
Las máquinas de machines/:
| Archivo | Qué hace | Para qué se usa |
|---|---|---|
starts_01.tm |
acepta las cadenas que empiezan con | ; las fichas del ejemplo |
zeros_ones.tm |
decide | las historias de cómputo |
loop_on_0.tm |
no se detiene si la entrada es seguido de ceros | simular con tope; fichas sin final |
empty_ok.tm |
acepta solo | el caso de las fichas |
Dos decisiones del código que conviene conocer antes de leerlo.
- En
tm.huna historia es una lista de símbolos (std::vector<std::string>), porque el nombre de un estado tiene varios caracteres. Entm_pcp.hcada estado se cambia por una letra mayúscula, porque en una ficha cada símbolo tiene que ser un carácter.tm_to_pcpimprime la correspondencia. - Un archivo de fichas empieza con
dominoes: ky sigue con líneasarriba abajo. Después de esa línea no hay comentarios: las fichas de una máquina usan#como símbolo.
tm_to_pcp supone, como la demostración, que la máquina no intenta moverse a la izquierda desde la primera
celda. Con una máquina que sí lo hace, las fichas que escribe no corresponden a su ejecución.
El laboratorio
En lab/pcp_search está el enunciado, un esqueleto, el verificador y los casos. La entrada es un conjunto de
fichas y una cota ; la salida, los números de las fichas de una solución de a lo sumo fichas, o
sin solución hasta N.
cd lab/pcp_search
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Una instancia puede tener muchas soluciones, así que el juez no compara texto: usa verificador.cpp, que pone
las fichas de la respuesta y compara las dos cadenas. El trabajo es la búsqueda en anchura sobre el exceso,
con el conjunto de visitados. Probar todas las secuencias da TLE en cuanto la solución pasa de unas quince
fichas, y el caso 09 pide 45. pcp.h trae una búsqueda que pueden leer; la del laboratorio se escribe en un
solo archivo, sin incluirla, y tiene que reconstruir la secuencia.
El enunciado termina con tres preguntas para responder por escrito. La primera es la del paso 5 de la guía: por qué el programa, sin la cota, reconoce PCP y no lo decide.
Resumen
- Una reducción de a resuelve usando una solución de . Si es indecidible, también. Para demostrar que es indecidible se reduce desde un indecidible conocido hacia . La dirección contraria no demuestra nada.
- es indecidible: con un decididor suyo, se sabría cuándo es seguro simular, y se decidiría .
- Fijar la entrada dentro de la máquina: de se construye una máquina cuyo lenguaje es uno de dos según acepte o no . Con y sale ; con y , . La construcción escribe una descripción y no ejecuta nada.
- es indecidible, reduciendo desde : se compara con una máquina que rechaza todo.
- Reducción por función: si hay una función computable con . Lo decidible y lo reconocible bajan de a ; lo indecidible y lo no reconocible suben de a . equivale a .
- no es reconocible. no es reconocible y su complemento tampoco: se reduce a cada uno de los dos.
- Teorema de Rice: toda propiedad no trivial del lenguaje de una máquina es indecidible. Hay que comprobar que depende solo de y dar una máquina que la tiene y otra que no.
- Rice no habla de las propiedades de la máquina: la cantidad de estados o detenerse en 100 pasos son decidibles. Otras, como detenerse con una entrada, son indecidibles por una reducción propia.
- Una historia de cómputo es la secuencia de configuraciones de una ejecución que acepta. Existe si y solo si acepta . Comprobarla es local: entre dos configuraciones seguidas solo cambian el estado y sus dos vecinos.
- PCP: fichas con una cadena arriba y otra abajo; ¿alguna fila da la misma cadena en los dos lados? Es reconocible, buscando por longitud creciente, y es indecidible: las fichas se pueden diseñar para que la única fila que coincide sea una historia de aceptación, con abajo una configuración adelantado.
- La búsqueda solo necesita recordar el exceso. Puede terminar con una solución, con “sin solución” si
el grafo de excesos es finito, o no terminar. Por eso responde
sin solución hasta N. - es indecidible: una gramática puede generar todo lo que no es una historia de aceptación, porque para eso basta señalar un error. De ahí, es indecidible. Decidir si una gramática es ambigua también, reduciendo desde PCP.
- Con los DFA todas esas preguntas eran decidibles. Más poder de expresión es menos posibilidad de análisis.
Ejercicios
- Para cada afirmación, digan qué se puede concluir sobre , o si no se puede concluir nada: (a) ; (b) ; (c) ; (d) ; (e) ; (f) y . Después respondan la pregunta 3 de la guía: si y es reconocible, ¿qué se sabe de ? ¿Y si no es reconocible, qué se sabe de ?
- Demuestren que es indecidible con una reducción desde , escribiendo la máquina que se construye, la máquina y las dos direcciones. Después demuéstrenlo otra vez con el teorema de Rice, comprobando las dos condiciones. ¿Es reconocible ese lenguaje?
- Para cada propiedad, digan si el teorema de Rice se aplica. Si se aplica, den las dos máquinas. Si no, digan cuál hipótesis falla y, si pueden, si la propiedad es decidible: (a) tiene exactamente 10 cadenas; (b) tiene más de 10 transiciones; (c) ; (d) escribe alguna vez un blanco sobre un símbolo que no lo es, con alguna entrada; (e) es decidible; (f) es reconocible; (g) nunca mueve el cabezal a la izquierda en sus primeros 50 pasos, con ninguna entrada; (h) acepta alguna cadena de longitud par.
- Demuestren que es indecidible, reduciendo desde . Expliquen por qué el teorema de Rice no sirve aquí, con dos máquinas que reconozcan el mismo lenguaje y den respuestas distintas.
- Demuestren: (a) si y , entonces ; (b) si es decidible y es cualquier lenguaje distinto de y de , entonces ; (c) si es reconocible y , entonces es decidible. ¿Por qué (b) excluye a y a ?
- Sea . (a) Demuestren que es indecidible con Rice. (b) Demuestren que y concluyan que su complemento no es reconocible. (c) Más difícil: demuestren que tampoco es reconocible, con una reducción . Sugerencia: una máquina que, con la entrada , corre con durante pasos y acepta si en ese tiempo no aceptó.
- Escriban a mano las primeras seis configuraciones de
machines/zeros_ones.tmcon la entrada y comprueben conbuild/history. Marquen, entre cada par de configuraciones seguidas, los tres símbolos que podían cambiar. Después escriban una cadena que pase tres de las cuatro revisiones decheck_historyy falle la otra, una por cada revisión, y comprueben con el programa qué mensaje da. - Un estado de una máquina es inútil si la máquina no entra en él con ninguna entrada. Demuestren que es indecidible, reduciendo desde . Sugerencia: ¿cuándo es inútil ? ¿Por qué no se puede resolver buscando caminos en el diagrama de estados, como con un DFA?
- Encuentren una solución de cada conjunto de fichas, o argumenten por qué no existe. Háganlo primero a mano,
siguiendo el exceso, y comprueben con
pcp_checkopcp_solve. (a) ; (b) ; (c) las cuatro fichas deinstances/four_66.pcp. Para (c) no lo intenten a mano: ¿cuántas fichas tiene la solución más corta, y cuántos excesos visita la búsqueda? - Demuestren que PCP con un alfabeto de un solo símbolo es decidible. Sugerencia: solo importan las longitudes. ¿Qué pasa si hay una ficha con arriba más largo y otra con abajo más largo? ¿Dónde falla el argumento con dos símbolos?
- Escriban a mano las fichas de la demostración para
machines/empty_ok.tmcon la entrada , y una solución que empiece con la ficha de inicio. Comprueben conbuild/tm_to_pcp machines/empty_ok.tm epsy conpcp_solve --primera. Después expliquen qué fichas habría que agregar para no tener que suponer que la máquina nunca se mueve a la izquierda desde la primera celda, con la convención del curso de que en ese caso el cabezal se queda donde está, y qué dificultad aparece con la ficha de inicio. - Demuestren que son indecidibles: (a) , para gramáticas libres de contexto; (b) , con una gramática y una expresión regular. Y demuestren que este sí es decidible: (c) . Sugerencia para (c): la intersección de un lenguaje libre de contexto con uno regular es libre de contexto, y la construcción es un algoritmo.
- Para programar. Escriban un programa que lea un conjunto de fichas en el formato de
instances/y escriba, en el formato.cfgdecode/formats.md, la gramática de la sección Decidir si una gramática es ambigua, usando como etiquetas símbolos que no aparezcan en las fichas. Con las fichas deinstances/sipser.pcp, escriban la cadena que corresponde a la solución2 1 3 2 4y sus dos derivaciones por la izquierda. - Para programar. Modifiquen
pcp_solve.cpppara que imprima cuántos excesos nuevos aparecen en cada nivel de la búsqueda. Córranlo coninstances/long.pcpy coninstances/hard_75.pcp. ¿En cuál crece la cantidad de un nivel al siguiente, y más o menos por cuánto se multiplica? Estimen cuántos excesos tendría que guardar la búsqueda para llegar al nivel 75.