
Apuntes · Capítulo 11Computabilidad
Autorreferencia
Autorreferencia
En la semana 9 demostramos que es indecidible con una máquina que recibía la descripción de una máquina y hacía lo contrario de lo que esa máquina hace con su propia descripción. La contradicción aparecía al darle a la entrada . En la semana 10 usamos ese resultado como punto de partida y lo llevamos, con reducciones, a una docena de problemas más.
Toda esa construcción descansa en un paso que la primera vez deja una incomodidad: una máquina que trabaja con su propia descripción. En la semana 9 la descripción llegaba de afuera, como entrada, y nadie tuvo que fabricarla. Pero la pregunta queda: ¿puede una máquina tener su propia descripción, sin que nadie se la entregue? Suena a un círculo. Para contener su descripción, la máquina tendría que contener algo tan grande como ella misma, y además el resto.
Esta semana responde que sí puede, y muestra cómo. La respuesta tiene nombre de programa: un quine es un programa que imprime su propio código fuente. Vamos a escribir uno en C++ y a leerlo línea por línea. La misma idea, dicha para máquinas de Turing, es el teorema de recursión: toda máquina se puede escribir de modo que empiece obteniendo su propia descripción y después siga calculando con ella. Con el teorema, la demostración de la semana 9 cabe en cuatro líneas, y sale un resultado nuevo: no hay algoritmo que diga si una máquina es la más pequeña para su lenguaje.
En la segunda sesión la autorreferencia sale de las máquinas y entra en la matemática. Una demostración es una cadena que una máquina puede comprobar, así que todo lo que sabemos sobre máquinas dice algo sobre demostraciones. Lo que dice es el primer teorema de incompletitud de Gödel: en todo sistema formal correcto que pueda hablar de la aritmética hay afirmaciones verdaderas que no tienen demostración. Lo vamos a demostrar a partir del problema de la parada, en media página. Es un teorema del que se dicen muchas cosas que no dice, así que dedicaremos una sección a eso. La semana cierra, como tema opcional, con la complejidad de Kolmogorov: una definición de cuánta información tiene una cadena, y la demostración de que esa cantidad no se puede calcular.
Con esta semana termina la parte de computabilidad. Desde la semana 12 todos los problemas serán decidibles y la pregunta será cuánto cuestan.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, La objeción: una máquina que se tiene a sí misma, El intento ingenuo y La frase que se describe a sí misma. Antes de la sesión B, El programa de Hilbert y Sistemas formales. Con eso llegan con el problema planteado y con el vocabulario de la lógica.
En clase: Sesión A, de La objeción: una máquina que se tiene a sí misma a Virus: un quine con algo más. Sesión B, de El programa de Hilbert a Lo que el teorema no dice.
Después de clase: el Resumen y los Ejercicios, para repasar. El código de la semana si van a hacer el ejercicio opcional del quine: la sesión de laboratorio de esta semana es la Práctica 3. ✂️ Complejidad de Kolmogorov es opcional: léanla si quieren ver otra consecuencia de la misma idea, con sus dos demostraciones cortas. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 6.1 (The Recursion Theorem), 6.2 (Decidability of Logical Theories) y 6.4 (A Definition of Information). Barak, capítulo 11 (Is every theorem provable?). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-11. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El ejercicio opcional está enlab/quine.
La objeción: una máquina que se tiene a sí misma
Recordemos la demostración de la semana 9. Suponíamos una máquina que decide y construíamos:
D = "Con la entrada ⟨M⟩, donde M es una máquina de Turing:
  1. Correr H con la entrada ⟨M, ⟨M⟩⟩.
  2. Si H acepta, rechazar. Si H rechaza, aceptar."
Después se le daba a la entrada , y aceptaba si y solo si no la aceptaba.
La demostración es correcta. es una cadena como cualquier otra, y tiene que hacer algo con cada cadena. Pero es razonable sentir que hay un truco. La máquina no sabe que la entrada es su propia descripción: alguien de afuera la escribió en la cinta. La objeción se puede decir así.
¿Tiene sentido hablar de una máquina que usa su propia descripción? Si la máquina quisiera consultarla en medio de un cálculo, sin que nadie se la dé, ¿de dónde la saca?
Hay dos respuestas malas y una buena.
La primera respuesta mala es “la lee de su archivo”. Una máquina de Turing no tiene archivo. Tiene estados, una función de transición y una cinta, y en la cinta solo está la entrada. Un programa compilado tampoco tiene por qué tener cerca su código fuente.
La segunda respuesta mala es “la lleva escrita dentro”. Parece natural: que la máquina tenga, entre sus estados, los necesarios para escribir su descripción en la cinta. El problema es que esos estados son parte de la máquina, así que la descripción que escriben tiene que incluirlos a ellos. Lo veremos fallar en la sección siguiente, con un programa de verdad.
La respuesta buena es que la máquina no lleva escrita su descripción completa. Lleva escrita una parte, y calcula el resto. Eso alcanza, y es el contenido de esta sesión.
Para no cargar con máquinas de Turing desde el principio, empezamos con programas. Por la tesis de Church-Turing de la semana 7, lo que se pueda hacer con un programa de C++ se puede hacer con una máquina de Turing, y la construcción será la misma.
Definición. Un quine es un programa que no lee nada (ni entrada, ni archivos) y cuya salida es exactamente su propio código fuente.
El nombre se lo puso Douglas Hofstadter en 1979, por el filósofo Willard Van Orman Quine, que estudió las frases que hablan de sí mismas. La pregunta de la objeción queda entonces así: ¿existe un quine?
El intento ingenuo
El primer intento es directo: un programa que imprime un texto, y ese texto es el programa. Empecemos por
el programa más corto que hace algo parecido. Está en errors/prints_other.cpp:
// El intento ingenuo. Imprime un programa, pero no es el suyo: lo que imprime no tiene la
// línea que imprime. Para arreglarlo habría que meter esa línea dentro de las comillas, y
// entonces la línea cambia y hay que volver a meterla.
#include <iostream>

int main() {
    std::cout << "#include <iostream>\n\nint main() {\n}\n";
}
Imprime un programa, pero no el suyo:
$ g++ -Wall -Wextra -std=c++20 errors/prints_other.cpp -o build/prints_other
$ build/prints_other
#include <iostream>

int main() {
}
$ build/prints_other | cmp - errors/prints_other.cpp
- errors/prints_other.cpp differ: byte 1, line 1
El comando cmp compara dos archivos byte por byte y avisa en el primero que difiere. Con - como nombre
compara lo que le llega por la entrada estándar. Lo usaremos toda la semana: un quine es un programa cuya
salida cmp no distingue de su fuente.
A la salida le faltan los comentarios y, sobre todo, la línea del std::cout. La corrección parece obvia:
agregar esa línea al texto entre comillas. Pero al agregarla, la línea del std::cout cambió, porque ahora
tiene más texto entre comillas, y lo que el programa imprime es la versión anterior. Hay que agregar la
línea nueva. Y entonces vuelve a cambiar.
Podemos seguir el proceso con un programa. Sea un programa cualquiera, y para cada sea el
programa que imprime el código de . El ejemplo naive_growth los construye con la función printer_of
de self.h, que recibe un texto y devuelve el código de un programa que lo imprime. Estos son y ,
tomando como el programa vacío int main() {}:
$ build/naive_growth --emit 1
#include <iostream>
int main() { std::cout << "int main() {}\n"; }
$ build/naive_growth --emit 2
#include <iostream>
int main() { std::cout << "#include <iostream>\nint main() { std::cout << \"int main() {}\\n\"; }\n"; }
Cada programa lleva al anterior entre comillas. Las comillas del anterior hay que escribirlas como \", y sus
barras invertidas como \\, así que cada nivel es más largo que el anterior:
$ build/naive_growth
 k   bytes de Pk   lo que imprime Pk
 0            14   nada
 1            67   P0, de 14 bytes
 2           124   P1, de 67 bytes
 3           188   P2, de 124 bytes
 4           266   P3, de 188 bytes
 5           372   P4, de 266 bytes
 6           534   P5, de 372 bytes
 7           808   P6, de 534 bytes
 8          1306   P7, de 808 bytes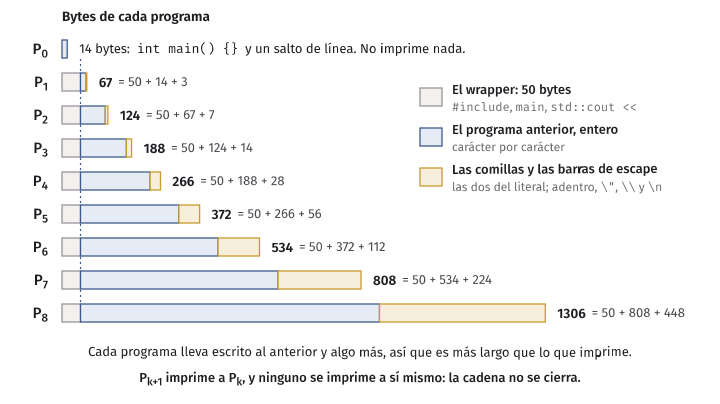
Cada imprime a , y ninguno se imprime a sí mismo. La cadena no se cierra nunca, y la razón es una cuenta de longitudes que vale la pena escribir como proposición.
Proposición. Ningún programa de la forma “imprimir este literal” es un quine.
Demostración. Por comparación de longitudes. Un programa de esa forma tiene un literal y algo más: como mínimo, las comillas y la instrucción que imprime. Su salida es el texto que el literal denota. Ese texto no es más largo que el literal, porque cada carácter del texto ocupa uno o dos caracteres en el literal. Entonces la salida es estrictamente más corta que el programa, y no puede ser igual a él. ∎
El intento ingenuo no falla por falta de ingenio con las comillas. Falla porque le pide al programa contenerse entero como dato, y nada puede contener una copia de sí mismo y además otra cosa.
Idea clave. Un programa no puede llevar escrito su código completo: lo escrito ocupa menos que el programa que lo lleva. La salida de un quine tiene que salir, en parte, de un cálculo.
Lo que sí puede pasar es que un programa corto produzca una salida más larga que él. Un ciclo que imprime mil
veces la letra a lo hace. Lo que hay que encontrar es un programa que, calculando, produzca justo el texto
de sí mismo.
La frase que se describe a sí misma
Antes de resolverlo con un programa conviene resolverlo en español, donde se ve la idea sin la sintaxis. Queremos una instrucción escrita en una hoja tal que, al obedecerla, uno termine escribiendo esa misma instrucción.
El intento ingenuo es:
Escriban esta frase.
Funciona, pero hace trampa. La palabra esta señala a la frase desde afuera, como __FILE__ señala al
archivo. Una máquina de Turing no tiene la palabra esta: solo puede escribir símbolos y calcular con ellos.
Prohibamos entonces las palabras que señalan, y permitamos solo instrucciones que dicen qué hacer con un
texto que se da entre comillas:
Escriban lo que sigue: «hola»
Al obedecerla uno escribe hola. Es el programa prints_other: imprime un texto, que no es la instrucción.
Si ponemos entre comillas la instrucción completa caemos en la cadena de antes.
La salida es dar una instrucción que use el texto entre comillas dos veces:
Escriban dos veces lo que sigue, la segunda vez entre comillas: «Escriban dos veces lo que sigue, la segunda vez entre comillas:»
Obedezcámosla despacio. Lo que sigue a los dos puntos, entre comillas, es el texto
Escriban dos veces lo que sigue, la segunda vez entre comillas:
La instrucción pide escribirlo una vez tal cual y una segunda vez entre comillas. El resultado es
Escriban dos veces lo que sigue, la segunda vez entre comillas: «Escriban dos veces lo que sigue, la segunda vez entre comillas:»
que es, letra por letra, la frase de la que partimos. Hay un quine en español.
Miremos por qué funciona, porque el programa en C++ va a ser esto mismo.
- La frase tiene dos partes. La parte de afuera de las comillas es una instrucción: se obedece. La parte de adentro es un dato: no se obedece, se copia.
- Las dos partes tienen el mismo texto. La diferencia está en cómo se usan, y la marcan las comillas. En lógica se dice que un texto fuera de comillas se usa y un texto entre comillas se menciona.
- La instrucción nunca habla de sí misma. Solo dice qué hacer con el dato. Que el dato resulte ser igual a la instrucción es algo que arregló quien escribió la frase, y que la instrucción no necesita saber.
- La frase no se contiene entera. Contiene la mitad de sí misma como dato, y la instrucción produce las dos mitades a partir de esa: una copiando, la otra copiando y poniendo comillas.
Lo último es lo que rompe el círculo de la sección anterior. El dato no describe a toda la frase: describe solo a la parte que no es dato. La parte que es dato no necesita descripción, porque ya está ahí, en la hoja, y se puede copiar.
test_self.cpp comprueba la frase: toma lo que está entre comillas, lo escribe dos veces, la segunda entre
comillas, y verifica con assert que el resultado es igual a la frase completa.
Dos partes: datos y código
Pasemos la idea a máquinas. Vamos a construir una máquina de Turing, llamada , que ignora su entrada y se detiene con su propia descripción escrita en la cinta. La descripción es de alto nivel, como todas desde la semana 9.
Hace falta una herramienta, que ya vimos funcionar en naive_growth.
Lema. Existe una función computable tal que, para toda cadena , es la descripción de una máquina de Turing que, con cualquier entrada, escribe en la cinta y se detiene.
Demostración. Por construcción. La máquina tiene un estado por cada símbolo de : en el estado escribe el símbolo de , se mueve a la derecha y pasa al estado . Antes borra la entrada. Escribir la tabla de esa máquina a partir de es un trabajo mecánico, símbolo por símbolo, y lo hace esta máquina:
Q = "Con la entrada w:
  1. Construir la máquina P_w = "Con cualquier entrada:
       1. Borrar la cinta.
       2. Escribir w en la cinta y detenerse."
2. Escribir ⟨P_w⟩ en la cinta y detenerse."calcula . ∎
En C++, es la función printer_of de self.h: recibe un texto y devuelve el código de un programa que lo
imprime. La parte delicada, poner el texto entre comillas con sus escapes, es la función cpp_literal.
Observen qué recibe y qué devuelve . No es una máquina que escribe : es una máquina que, a partir de , escribe la descripción de una máquina que escribe . Trabaja un nivel más arriba. En la frase en español, es la operación “poner entre comillas”.
Ahora las dos partes. se arma con dos máquinas, y , que corren una después de la otra: primero y, cuando termina, sigue con lo que dejó en la cinta. A la máquina que resulta de unir dos máquinas así la escribimos .
La parte se define primero, y se define sin mencionar a :
B = "Con la entrada ⟨M⟩, donde M es una máquina de Turing:
  1. Calcular q(⟨M⟩). Es la descripción de una máquina que escribe ⟨M⟩.
  2. Unir esa máquina con M: primero la que se acaba de calcular, después M.
  3. Escribir en la cinta la descripción de la máquina unida y detenerse."
La parte se define después, a partir de , que ya está completa:
Es decir, es la máquina que escribe en la cinta y se detiene. Y
Teorema. , con cualquier entrada, se detiene con en la cinta.
Demostración. Se sigue la ejecución, paso por paso.
- Corre . Por definición borra la cinta y escribe .
- Corre con lo que hay en la cinta, que es . En su descripción, es ahora .
- calcula . Por la definición de , eso es .
- une la máquina calculada, , con , que es . El resultado es .
- escribe y se detiene. ∎
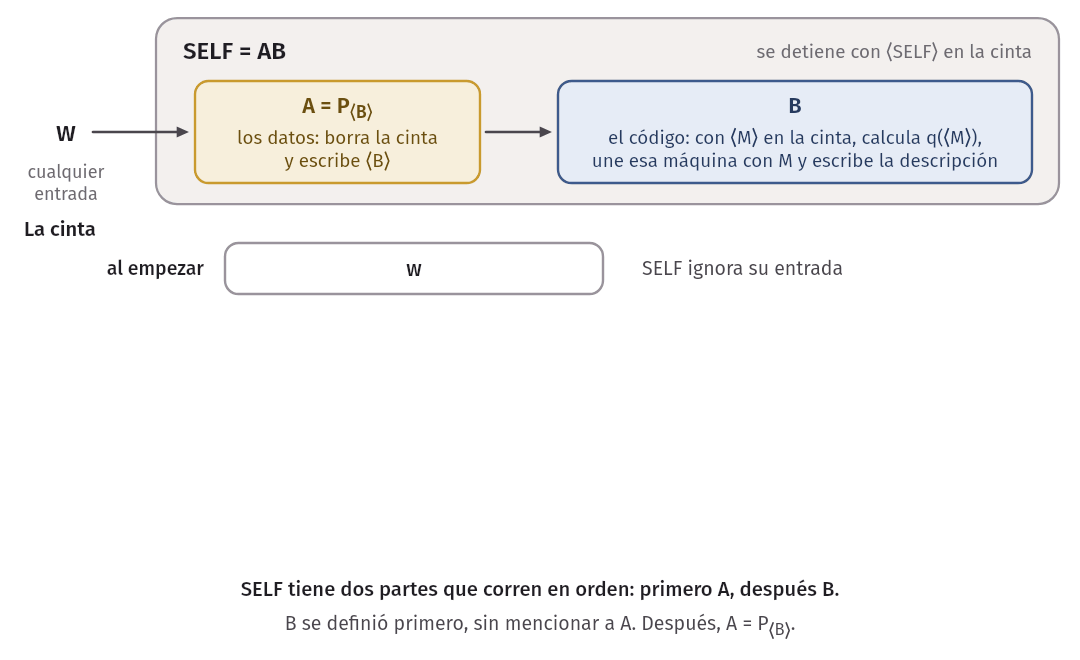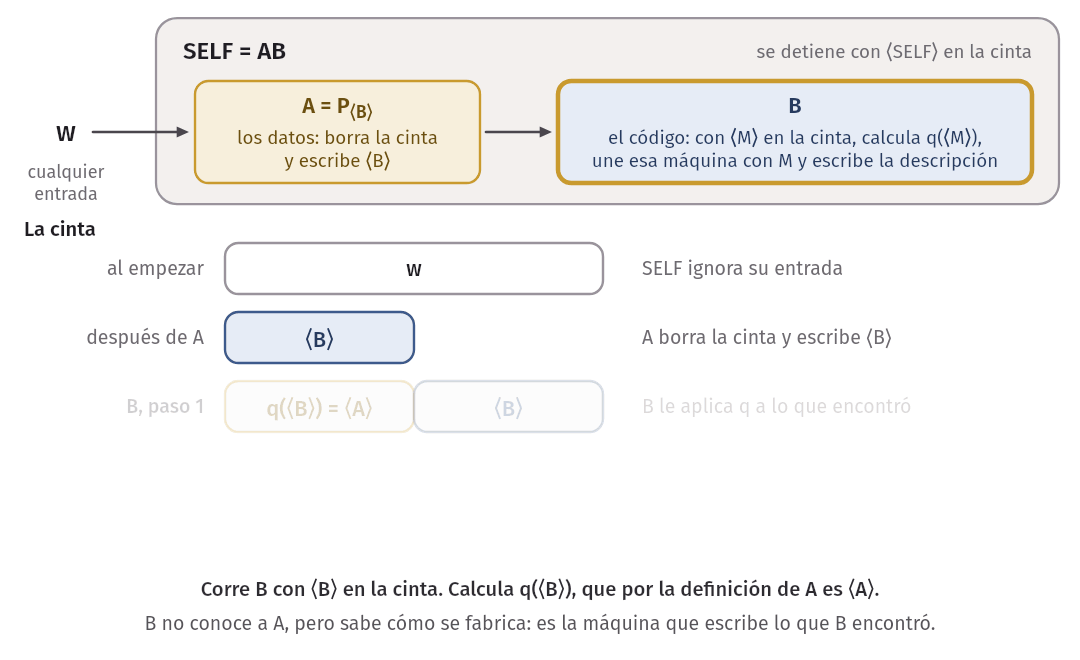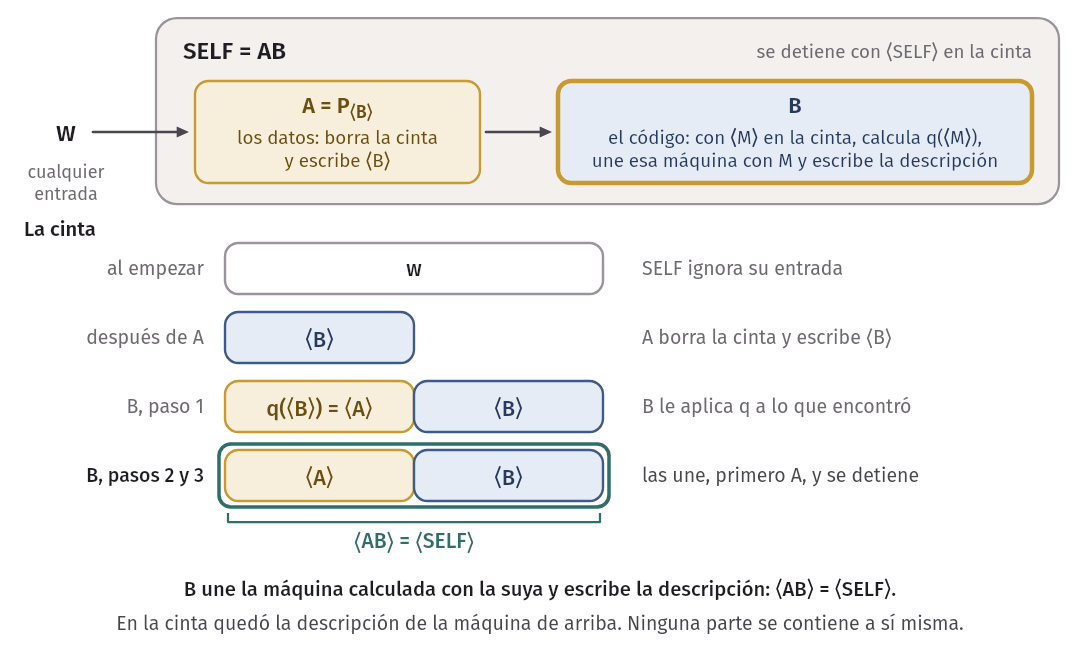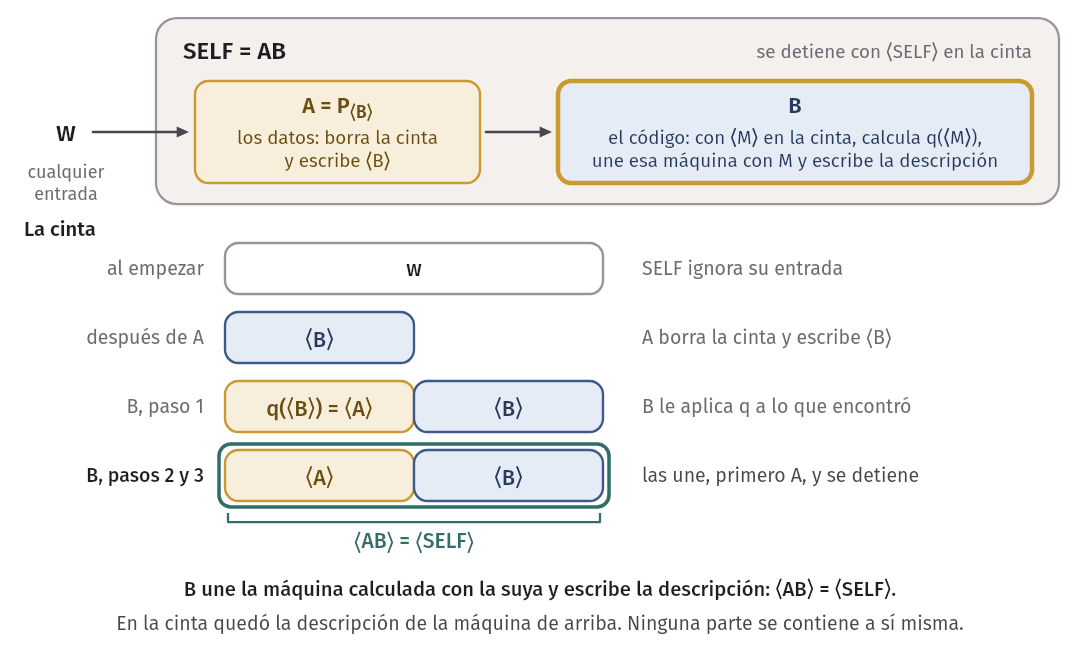
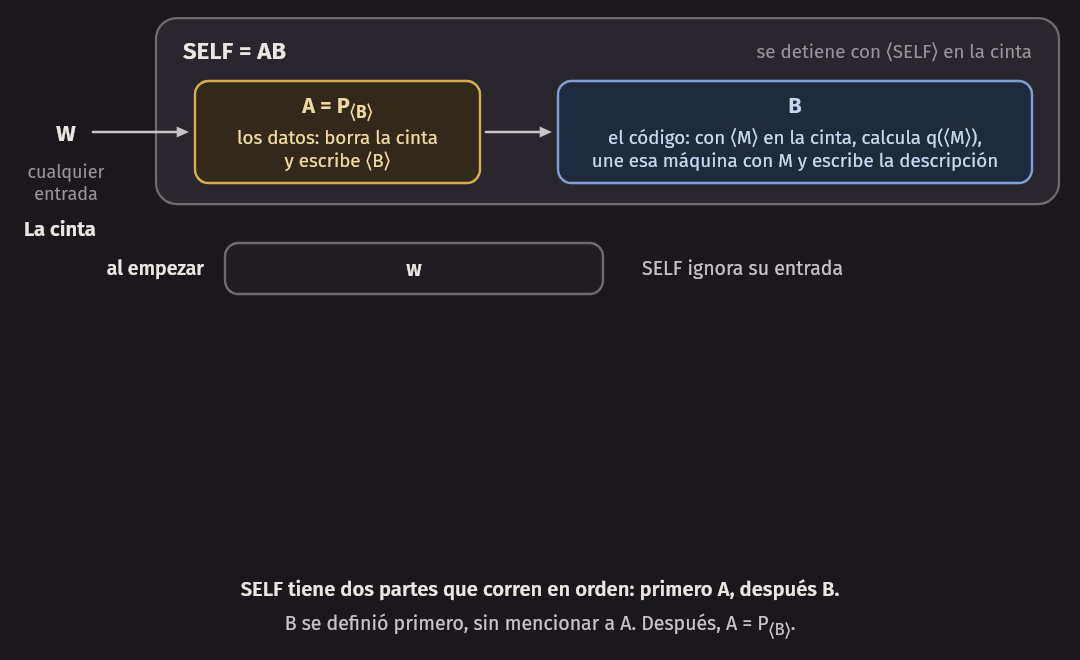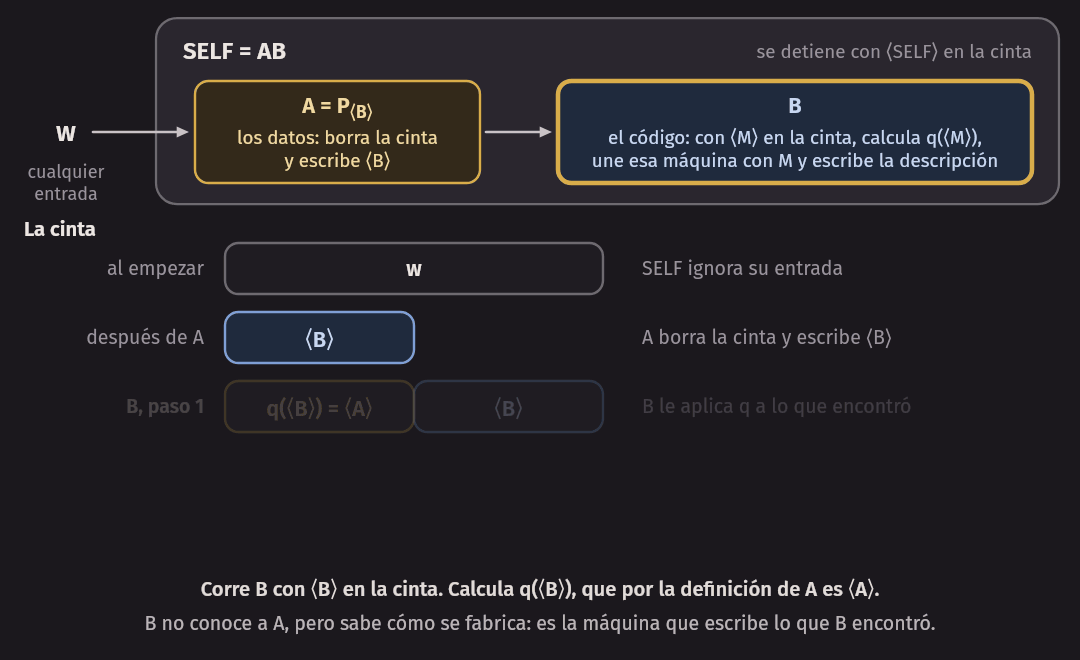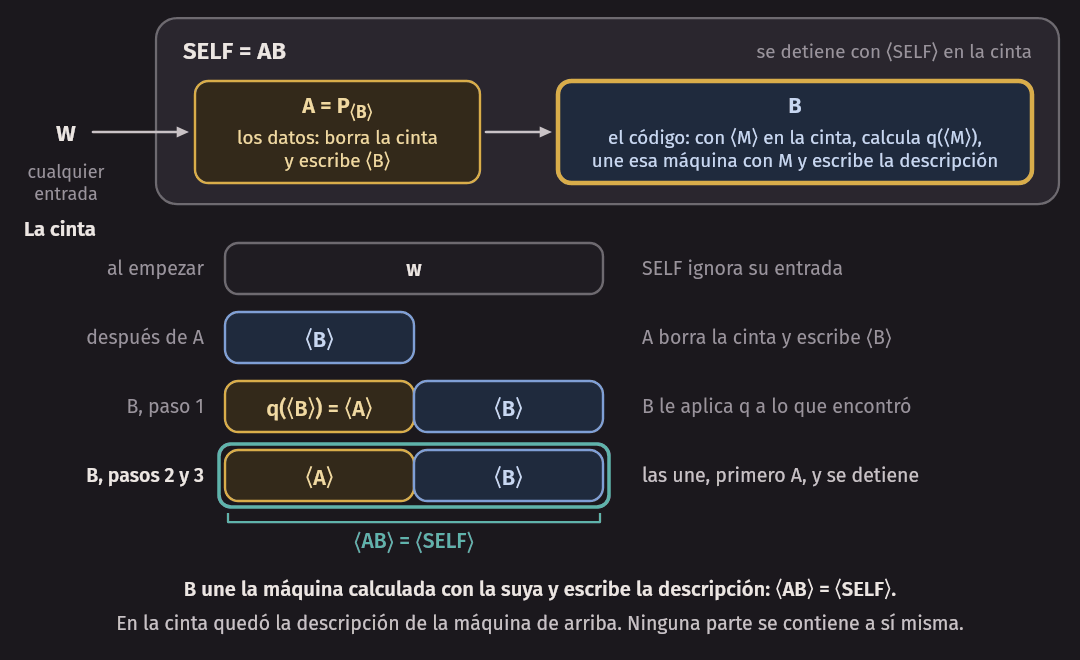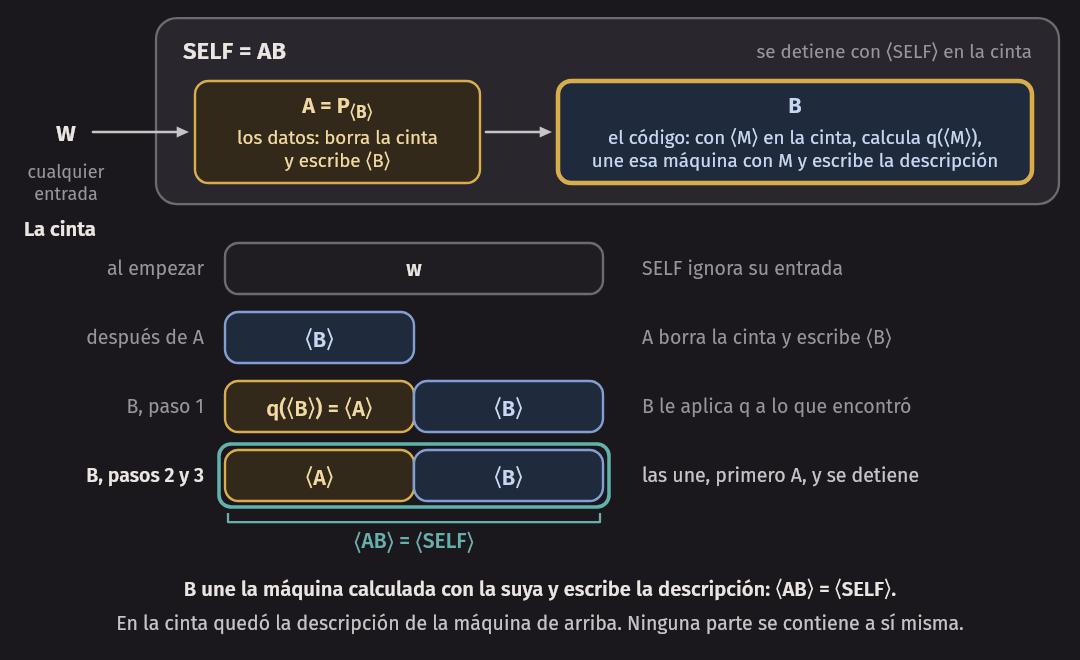
El orden de las definiciones es lo que evita el círculo. Si definiéramos como “la máquina que escribe ”, tendríamos definida con y definida con : es el intento ingenuo. Aquí no depende de nada, depende solo de , y de las dos.
| En la frase | En | En el quine de C++ | |
|---|---|---|---|
| Los datos | El texto entre comillas | : escribe | El literal text |
| El código | La instrucción de afuera | : reconstruye a y la une consigo | Las líneas que imprimen |
| Poner entre comillas | « » | Escribir text como literal |
¿Cómo consigue a la parte , si no la conoce? No la conoce, pero sabe cómo se fabrica: es, por definición, la máquina que escribe lo que encuentra en la cinta. Para reconstruirla, le aplica a lo que encontró. Y a sí misma no tiene que reconstruirse: su descripción es justamente lo que le dejó.
Idea clave. lleva escrita la descripción de , y solo la de . no lleva escrita ninguna descripción: recibe la suya de , y calcula la de a partir de la suya. Ninguna de las dos se contiene a sí misma.
En la práctica. Las células hacen lo mismo. El ADN es la parte : una descripción que no hace nada por sí sola. La maquinaria de la célula es la parte : lee la descripción para construir una maquinaria nueva y, por separado, copia la descripción tal cual, sin interpretarla, para dársela a la célula hija. John von Neumann llegó a esta división en dos usos, interpretar y copiar, cuando estudiaba a fines de los años cuarenta si una máquina podía construir otra igual a ella, antes de que se conociera la estructura del ADN.
Un quine en C++, línea por línea
El quine del curso está en quine.cpp. Antes de mostrarlo entero conviene ver su molde, que es el
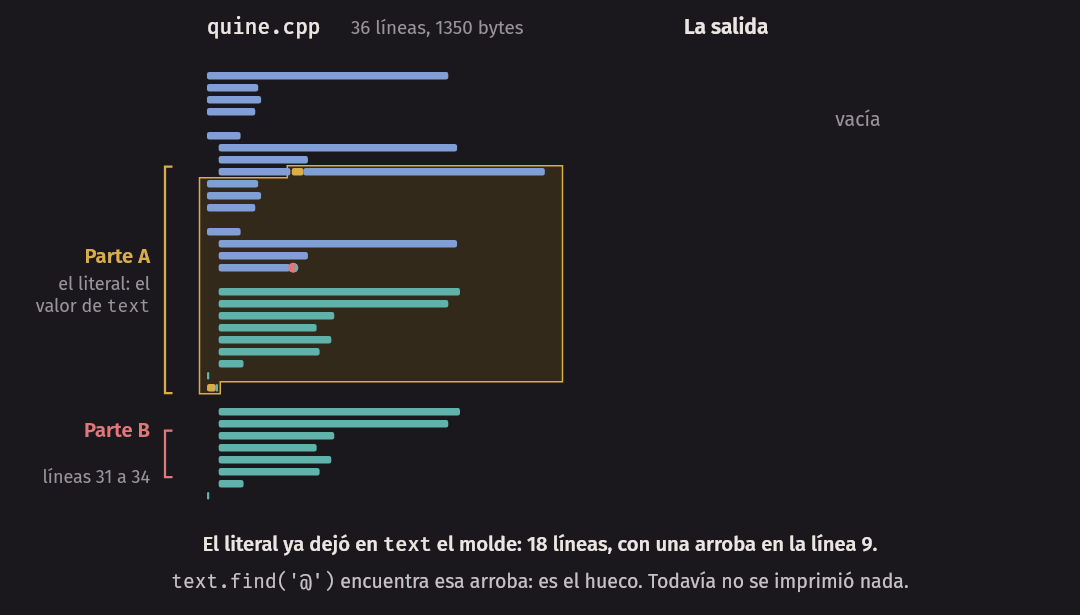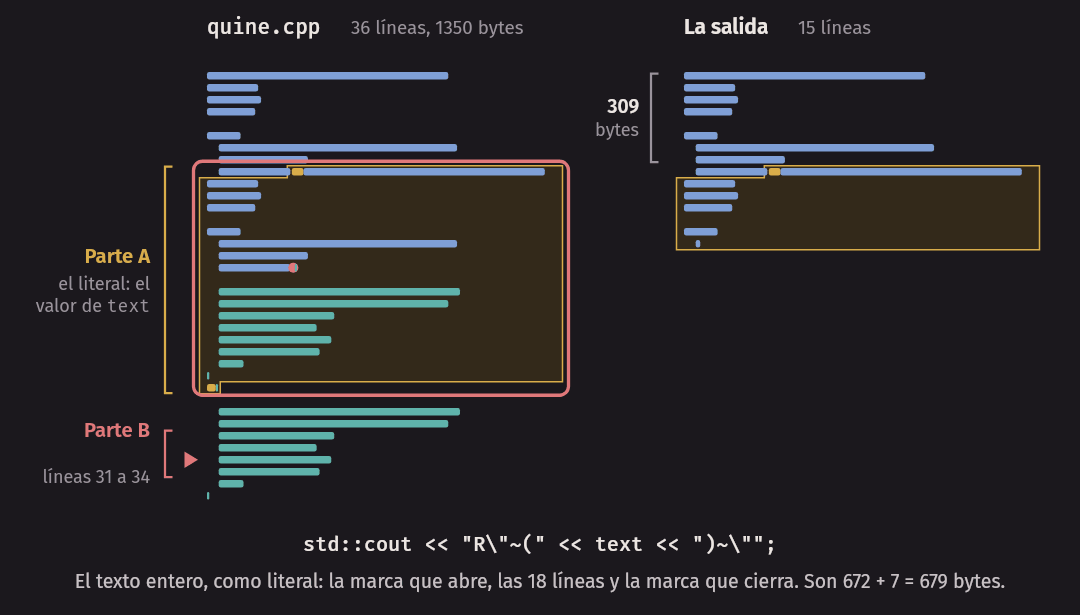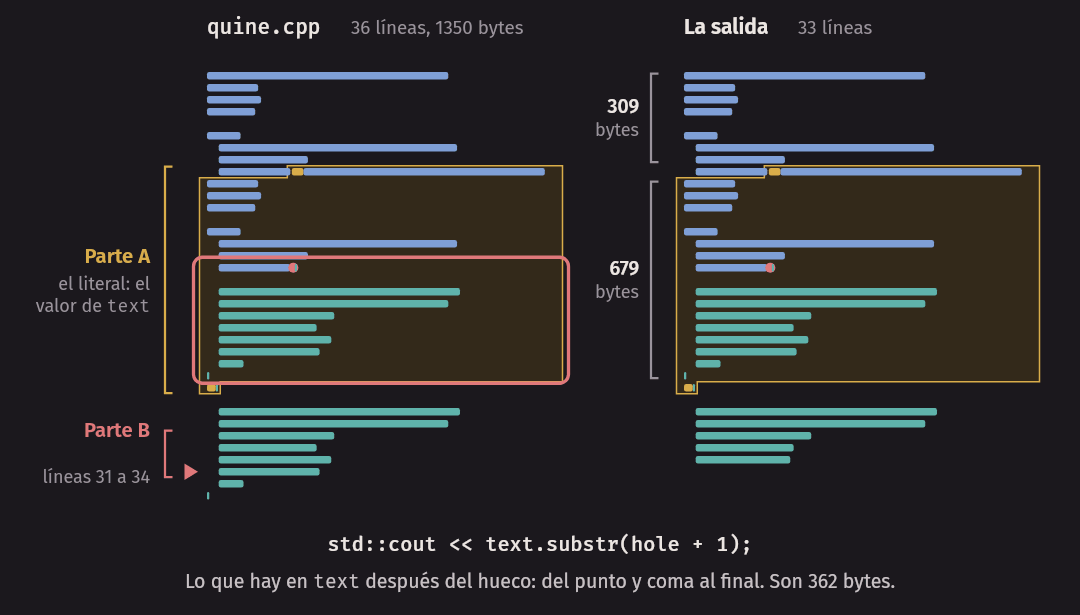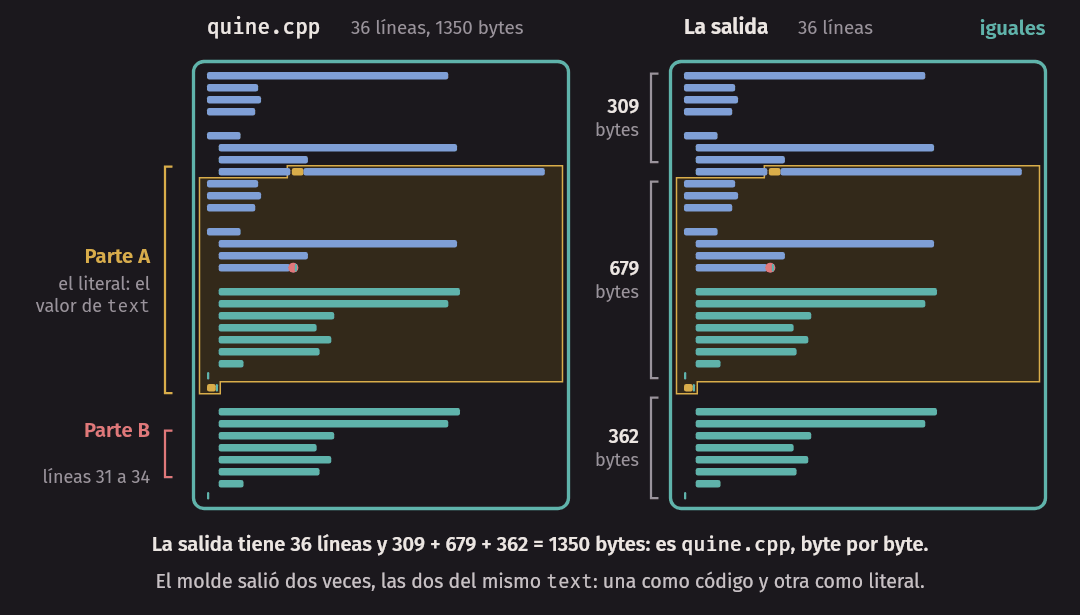
programa con un hueco donde van los datos. Está en templates/quine.tpl, y el hueco es la arroba de la línea 9:
// Un quine: imprime exactamente su propio código fuente, sin abrir ningún archivo.
#include <cstddef>
#include <iostream>
#include <string>

int main() {
    // Parte A: los datos. Es el texto de todo el programa, con una arroba en el lugar
    // donde va este mismo literal.
    const std::string text = @;

    // Parte B: el código. Imprime lo que hay antes de la arroba, después el texto otra
    // vez, ahora escrito como literal, y al final lo que hay después de la arroba.
    const std::size_t hole = text.find('@');
    std::cout << text.substr(0, hole);
    std::cout << "R\"~(" << text << ")~\"";
    std::cout << text.substr(hole + 1);
    return 0;
}
El programa completo se obtiene poniendo, en el lugar de la arroba, un literal cuyo contenido es el molde
mismo, con arroba y todo. Este es quine.cpp:
// Un quine: imprime exactamente su propio código fuente, sin abrir ningún archivo.
#include <cstddef>
#include <iostream>
#include <string>

int main() {
    // Parte A: los datos. Es el texto de todo el programa, con una arroba en el lugar
    // donde va este mismo literal.
    const std::string text = R"~(// Un quine: imprime exactamente su propio código fuente, sin abrir ningún archivo.
#include <cstddef>
#include <iostream>
#include <string>

int main() {
    // Parte A: los datos. Es el texto de todo el programa, con una arroba en el lugar
    // donde va este mismo literal.
    const std::string text = @;

    // Parte B: el código. Imprime lo que hay antes de la arroba, después el texto otra
    // vez, ahora escrito como literal, y al final lo que hay después de la arroba.
    const std::size_t hole = text.find('@');
    std::cout << text.substr(0, hole);
    std::cout << "R\"~(" << text << ")~\"";
    std::cout << text.substr(hole + 1);
    return 0;
}
)~";

    // Parte B: el código. Imprime lo que hay antes de la arroba, después el texto otra
    // vez, ahora escrito como literal, y al final lo que hay después de la arroba.
    const std::size_t hole = text.find('@');
    std::cout << text.substr(0, hole);
    std::cout << "R\"~(" << text << ")~\"";
    std::cout << text.substr(hole + 1);
    return 0;
}
Y esta es la comprobación:
$ build/quine | cmp - quine.cpp && echo iguales
iguales
Tiene 36 líneas, y las 18 del molde aparecen dos veces: una vez como código, que el compilador traduce, y una vez dentro del literal, como datos. Es la frase en español, con sus dos mitades iguales. Leámoslo por partes.
Líneas 1 a 6: el encabezado. El comentario, los tres #include y el comienzo de main. No hacen nada
especial. Están aquí porque todo lo que aparece en el archivo tiene que aparecer en la salida, también los
comentarios.
Líneas 9 a 27: la parte , los datos. Es una sola declaración, const std::string text = ...;, que ocupa
19 líneas porque el literal las ocupa. El literal empieza en R"~( y termina en )~". Todo lo que está entre
esas dos marcas es el valor de text, carácter por carácter: desde // Un quine hasta la llave final y su
salto de línea. Dentro del literal está la línea const std::string text = @;. Esa arroba marca el lugar
donde, en el programa de verdad, está el literal.
Líneas 31 a 34: la parte , el código. Son cuatro instrucciones.
    const std::size_t hole = text.find('@');
    std::cout << text.substr(0, hole);
    std::cout << "R\"~(" << text << ")~\"";
std::cout << text.substr(hole + 1);text.find('@')busca la primera arroba detext, que es la del hueco. La instrucciónfind('@')también contiene una arroba, pero está más adelante, así que no estorba. Por eso los comentarios del encabezado dicen arroba con letras.- La segunda línea imprime lo que hay en
textantes del hueco: las líneas 1 a 8 del archivo y el comienzo de la 9, hastatext =. - La tercera imprime
textcomo literal: la marca de apertura, el texto completo y la marca de cierre. Eso reproduce desde elR"~(de la línea 9 hasta el)~"de la línea 27. Es el paso de “poner entre comillas”, la función . - La cuarta imprime lo que hay en
textdespués del hueco: desde el punto y coma de la línea 27 hasta el final del archivo.
Sumando: antes del hueco, el literal, después del hueco. Es el archivo entero. En tamaños, el molde tiene 672 bytes, y el programa : dos veces el molde, menos la arroba que se reemplaza, más los 7 caracteres de las dos marcas.
$ wc -c templates/quine.tpl quine.cpp
 672 templates/quine.tpl
1350 quine.cpp
2022 total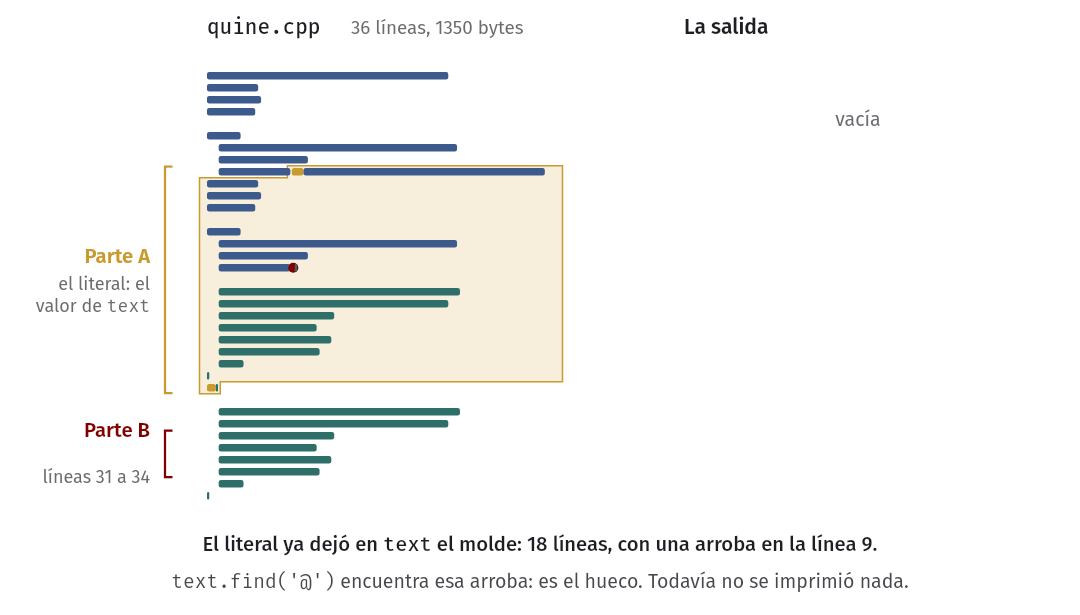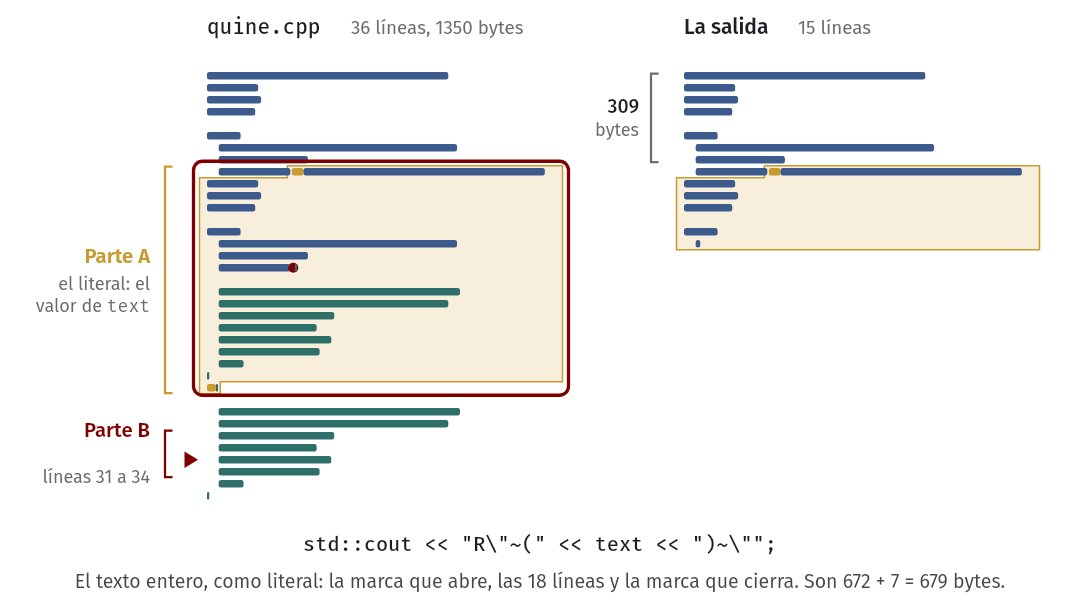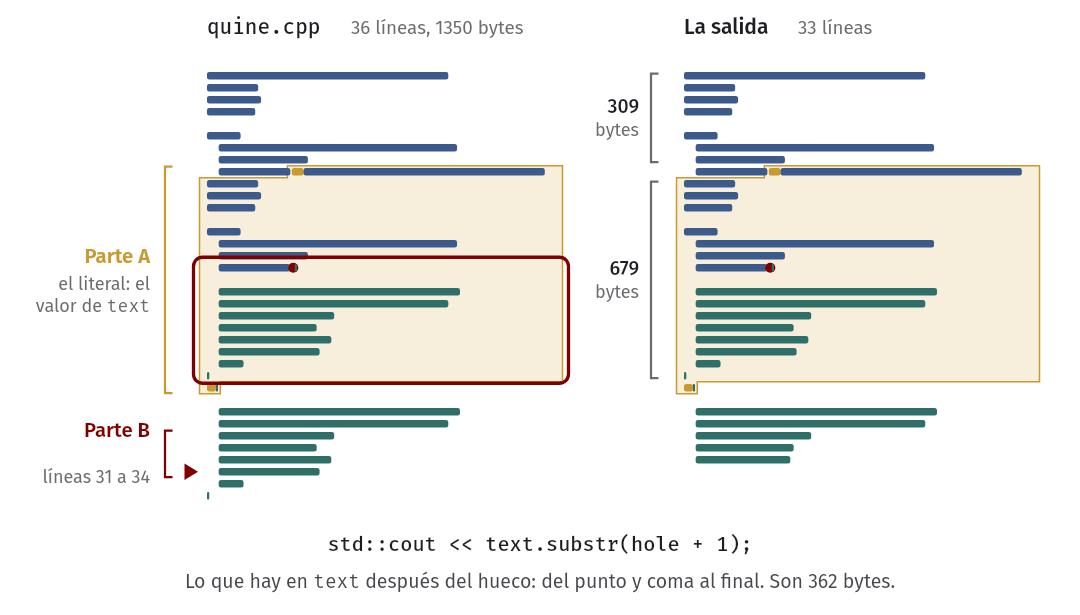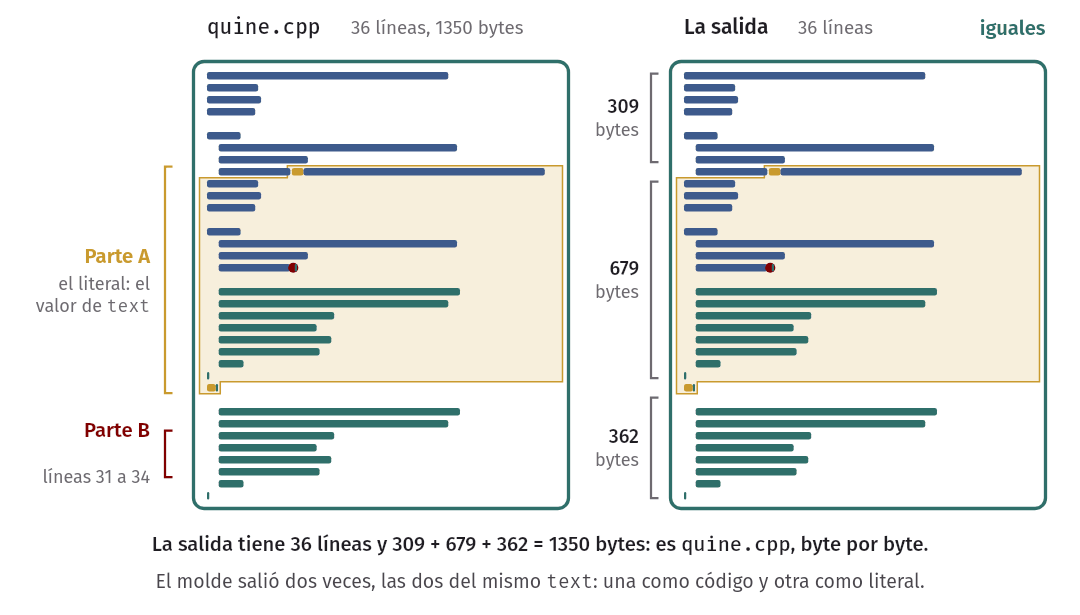
La correspondencia con es exacta. El literal es : no calcula nada, solo deja un texto en una variable, como deja en la cinta. Ese texto describe a todo lo que no es el literal, que es . Las cuatro instrucciones son : con el texto que encuentran, reconstruyen el literal (calculan ) y lo imprimen junto con el texto mismo, en el orden correcto. La única diferencia es de forma. En , va entera antes de . En C++ el literal va en medio del código, y por eso hace falta la arroba que dice dónde.
En C++. Un raw string literal se escribe
R"delim(…)delim", con un delimitador a elección de hasta 16 caracteres, aquí~. Entre las marcas no hay secuencias de escape: una comilla es una comilla, una barra invertida es una barra invertida y un salto de línea es un salto de línea. Por eso el texto del molde se puede pegar tal cual. La única condición es que el texto no contenga el cierre)~". El molde lo evita: donde el código necesita escribir esas marcas, las escribe como literales comunes,"R\"~("y")~\"", y la barra invertida que llevan impide que coincidan con el cierre.
¿Y las comillas? En el intento ingenuo eran el problema visible: cada nivel de comillas agregaba barras invertidas. Con el raw string literal no hay nada que escapar, y poner entre comillas es pegar una marca adelante y otra atrás. Se puede escribir un quine sin esa comodidad, con literales comunes, y entonces la parte necesita una función que escriba los escapes. Ese es el ejercicio opcional de la semana.
La construcción es mecánica
Nadie escribió a mano las 36 líneas de quine.cpp. Se escribió el molde, y un programa de pocas líneas,
make_self, hizo el resto: lee un molde y reemplaza la primera arroba por un literal con el molde
mismo. Su núcleo es la función fill_hole de self.h:
inline std::string fill_hole(const std::string& tpl) {
    const std::size_t hole = tpl.find('@');
    if (hole == std::string::npos) {
        throw std::invalid_argument("el molde no tiene una arroba");
    }
    return tpl.substr(0, hole) + raw_literal(tpl) + tpl.substr(hole + 1);
}
$ build/make_self < templates/quine.tpl | cmp - quine.cpp && echo iguales
igualesComparen la última línea de fill_hole con la parte del quine: es la misma expresión. make_self hace
desde afuera, una vez, lo que el quine hace desde adentro cada vez que corre. Que la construcción sea mecánica
importa por dos razones. La práctica: cada vez que se cambia una coma del código hay que rehacer los datos, y
conviene que lo haga un programa. La teórica: el paso de un molde al programa completo es una función
computable, y de ahí va a salir el teorema de recursión.
make_self sí abre un archivo, el molde. No hay contradicción: make_self no es el quine, es la
herramienta con la que se fabricó. El quine, una vez fabricado, no necesita nada.
La copia de la copia
La salida del quine es un programa. Se puede compilar, y lo que resulta es otro quine, igual al primero:
$ build/quine > build/copy.cpp
$ g++ -Wall -Wextra -std=c++20 build/copy.cpp -o build/copy
$ build/copy | cmp - quine.cpp && echo iguales
iguales
No es sorprendente, porque copy.cpp es idéntico a quine.cpp. Pero dice algo: el ejecutable build/copy
se construyó sin que quine.cpp interviniera. Toda la información necesaria pasó por la salida de
build/quine. make test hace esta misma comprobación.
Error común. Creer que un quine “hace trampa” leyendo su archivo. No lee nada: no incluye
<fstream>, no abre nada, y funciona igual si borranquine.cppdespués de compilar. El código está construido para reproducirse a partir de lo que lleva dentro. Un programa que abre su archivo fuente y lo copia no es un quine, y no enseña nada sobre lo que un programa puede calcular.
Para ver la diferencia, errors/reads_file.cpp es el tramposo:
// No es un quine: abre su propio archivo y lo copia. Deja de funcionar apenas el ejecutable
// se separa del fuente, y no dice nada sobre lo que un programa puede calcular por sí solo.
#include <fstream>
#include <iostream>

int main() {
    std::ifstream source(__FILE__);
    if (!source) {
        std::cerr << "no encuentro mi código fuente\n";
        return 1;
    }
    std::cout << source.rdbuf();
    return 0;
}
__FILE__ es una macro que el compilador reemplaza por la ruta del archivo que está compilando. El programa
funciona mientras esa ruta siga llevando al archivo:
$ g++ -Wall -Wextra -std=c++20 errors/reads_file.cpp -o build/reads_file
$ build/reads_file | cmp - errors/reads_file.cpp && echo iguales
iguales
$ cd build && ./reads_file; cd ..
no encuentro mi código fuente
Desde otra carpeta la ruta errors/reads_file.cpp ya no existe y el programa no tiene nada que imprimir. El
quine no tiene ese problema porque no depende de nada que esté fuera de él.
¿Depende de C++? No. La construcción solo usó dos cosas: que el lenguaje puede guardar un texto en una variable e imprimirlo, y que puede calcular, a partir de un texto, el literal que lo denota. Todo lenguaje de programación de uso general puede hacer ambas cosas, así que en todos hay quines. La versión precisa de esa afirmación es el teorema de la sección siguiente.
El teorema de recursión
Un quine imprime su código y termina. Es una curiosidad si no se puede hacer nada más con ese código. El teorema de recursión dice que sí se puede: una máquina puede obtener su propia descripción y seguir calculando con ella, junto con su entrada.
Para enunciarlo hay que decir qué es “calcular con la propia descripción”. La forma de hacerlo es separar el trabajo en dos. Primero se escribe una máquina común y corriente, con dos entradas: la descripción de una máquina y una cadena. no sabe nada de autorreferencia; para ella la descripción es un dato. El teorema entrega después una máquina , con una sola entrada, que se comporta como cuando en el lugar de la descripción está la de la propia .
Teorema de recursión. Sea una máquina de Turing cuya entrada es un par . Existe una máquina de Turing tal que, para toda cadena , con la entrada hace lo mismo que con la entrada : si acepta, acepta; si rechaza, rechaza; si se detiene con una cadena en la cinta, se detiene con la misma; y si no se detiene, tampoco.
Cuando calcula una función , el teorema se escribe en una línea: calcula la función con
Demostración. Por construcción, la misma que la de con dos cambios: ahora hay una entrada que no se puede perder, y al final, en lugar de detenerse, se le pasa el control a . La máquina tiene tres partes que corren en orden:
Hace falta una variante de . Sea la función que a cada cadena le asigna la descripción de una máquina que conserva su entrada y escribe a continuación, dejando en la cinta . Es computable por la misma razón que : la tabla de esa máquina se escribe mecánicamente a partir de .
Primero se define , que no menciona a :
B = "Con la cinta w#⟨M⟩, donde M es una máquina de Turing:
  1. Calcular q'(⟨M⟩). Es la descripción de una máquina que agrega ⟨M⟩ después de su entrada.
  2. Unir esa máquina con M: primero la que se acaba de calcular, después M. Sea N la máquina unida.
  3. Dejar en la cinta ⟨N, w⟩ y pasar el control a la parte siguiente."
Después , a partir de y de , que ya están completas: es la máquina con descripción . Es decir, conserva y escribe a continuación.
Sigamos la ejecución de con una entrada .
- Corre y deja en la cinta .
- Corre . En su descripción, es ahora . Calcula , que por la definición de es .
- une la máquina calculada, , con , que es . La máquina unida es .
- deja en la cinta y pasa el control a .
- Corre con la entrada , y lo que haga es lo que hace . ∎
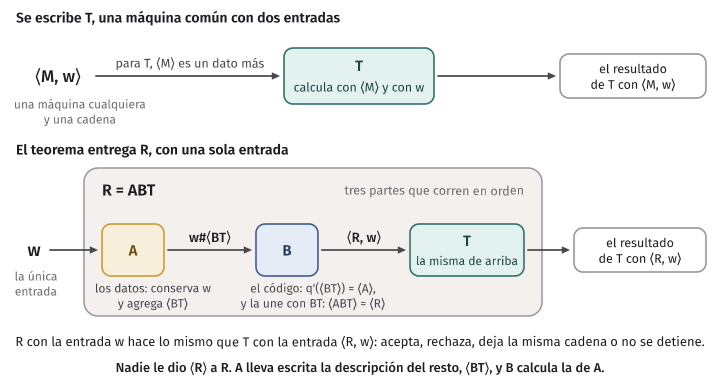
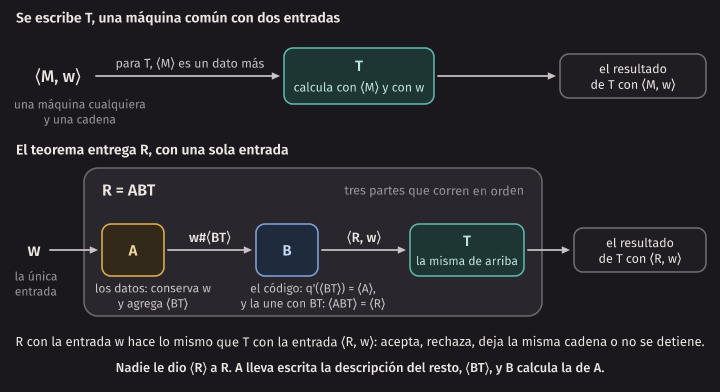
Los datos, , ahora describen a todo el resto de la máquina, , y no solo a . En quine.cpp pasa lo
mismo: el literal contiene todo lo que no es el literal.
Cómo se usa
En la práctica nadie nombra a . El teorema autoriza a escribir, en una descripción de alto nivel, un paso nuevo:
M = "Con la entrada w:
  1. Obtener, por el teorema de recursión, la propia descripción ⟨M⟩.
  2. ... seguir calculando con ⟨M⟩ y con w ..."
Una descripción así es legítima, y la justificación es siempre la misma. Sea la máquina que recibe y hace lo que dicen los pasos desde el 2, usando donde la descripción dice . es una máquina común. El teorema da una que, con , se comporta como con : es decir, hace los pasos desde el 2 con su propia descripción. Esa es la máquina que queríamos.
Idea clave. “Obtener la propia descripción” es un paso válido en cualquier máquina de Turing, igual que “simular otra máquina” o “copiar la entrada”. Con cualquier descripción que la máquina reciba puede hacer lo que haría con la de otra máquina: medirla, compararla, modificarla, simularla.
Lo último merece atención. Una máquina que tiene puede simularse a sí misma con la máquina universal de la semana 9, con la entrada que quiera. De ahí salen las demostraciones de las dos secciones siguientes.
En C++
La parte del quine imprimía. Si en lugar de imprimir devuelve el texto, queda una función que le da al
programa su propio código, y el programa puede hacer con él lo que quiera. Es own_source, y este es el
final del molde templates/self_check.tpl:
// Devuelve el código de este programa. Es la construcción del quine, sin imprimir.
std::string own_source() {
    const std::string text = @;
    const std::size_t hole = text.find('@');
    return text.substr(0, hole) + "R\"~(" + text + ")~\"" + text.substr(hole + 1);
}

int main() {
    const std::string self = own_source();
    const std::string input{std::istreambuf_iterator<char>(std::cin), std::istreambuf_iterator<char>()};
    if (input == self) {
        std::cout << "es mi código: " << self.size() << " bytes\n";
    } else {
        std::cout << "no es mi código: yo tengo " << self.size() << " bytes y la entrada " << input.size() << "\n";
    }
    return 0;
}
own_source es la construcción del quine: lo que hay antes del hueco, el texto como literal, lo que hay
después. El programa main es la máquina del teorema: recibe el código en self, la entrada en input, y
hace un cálculo cualquiera con los dos. Aquí el cálculo es compararlos.
$ build/self_check < self_check.cpp
es mi código: 1890 bytes
$ build/self_check < quine.cpp
no es mi código: yo tengo 1890 bytes y la entrada 1350
El programa reconoce su propio código entre todas las cadenas posibles, sin haber abierto ningún archivo.
self_check.cpp se armó con make_self a partir de su molde, igual que el quine: el paso de a es
el mismo programa de pocas líneas para cualquier . Eso es lo que dice el teorema.
make test comprueba las dos respuestas de arriba y dos más: con la entrada vacía, y con el código seguido de
un salto de línea de más, el programa responde que no es su código.
Primer uso: A_TM es indecidible, en cuatro líneas
Con el teorema de recursión, la demostración de la semana 9 se puede escribir sin la tabla de la diagonal y sin darle a ninguna máquina una entrada especial.
Teorema. es indecidible.
Demostración. Por contradicción, con el teorema de recursión. Supongamos que una máquina decide . Construimos:
B = "Con la entrada w:
  1. Obtener, por el teorema de recursión, la propia descripción ⟨B⟩.
  2. Correr H con la entrada ⟨B, w⟩.
3. Si H acepta, rechazar. Si H rechaza, aceptar."es un decididor, así que el paso 2 termina y se detiene con toda entrada. Tomemos cualquier . Si acepta , entonces acepta , y por el paso 3, rechaza . Si no acepta , entonces rechaza , y por el paso 3, acepta . En los dos casos hace lo contrario de lo que hace. Contradicción: no existe. ∎
Comparen con la semana 9. Allá la máquina recibía una descripción y la contradicción aparecía con una entrada, , elegida por nosotros. Aquí se contradice con todas las entradas, y nadie tuvo que darle nada: ella misma consigue su descripción, le pregunta a qué va a hacer, y hace lo otro.
Esta es la respuesta a la objeción del comienzo. Que una máquina trabaje con su propia descripción no es un truco de la demostración. Es algo que toda máquina puede hacer, y por eso ningún puede predecir a todas las máquinas: siempre habrá una que consulte la predicción y la desobedezca.
Segundo uso: no hay algoritmo para la máquina más pequeña
El segundo uso es un resultado nuevo. Fijemos la codificación de las máquinas de Turing, de modo que cada máquina tenga una descripción con una longitud .
Definición. Una máquina de Turing es mínima si ninguna máquina con una descripción más corta reconoce el mismo lenguaje: no existe con y .
Es la pregunta que se haría quien quiere el programa más corto posible: ¿se puede achicar este programa sin cambiar lo que hace?
Para los DFA la respuesta fue un algoritmo: en la semana 4 vimos cómo minimizar un DFA, y un DFA es mínimo si y solo si la minimización no le quita estados. Probemos lo mismo con máquinas de Turing.
Un intento. Para saber si es mínima, revisar todas las máquinas con descripción más corta que . Son una cantidad finita, porque hay una cantidad finita de cadenas de cada longitud. Para cada una, comprobar si reconoce el mismo lenguaje que . Si alguna lo hace, no es mínima.
La búsqueda es finita, y ese no es el problema. El problema es el paso “comprobar si reconoce el mismo lenguaje”: es , que en la semana 10 resultó indecidible, y ni siquiera reconocible. El intento no funciona. Pero eso solo dice que este algoritmo falla. Podría haber otro, más astuto, que reconozca las máquinas mínimas sin comparar lenguajes. El teorema dice que no lo hay.
Tampoco sirve el teorema de Rice. Rice habla de propiedades del lenguaje de una máquina: si dos máquinas reconocen el mismo lenguaje, las dos tienen la propiedad o ninguna la tiene. Ser mínima no es así. Dos máquinas pueden reconocer el mismo lenguaje y ser una mínima y la otra no. Es una propiedad de la descripción, y hace falta otra herramienta.
Antes del teorema, dos hechos sencillos.
Lema 1. es infinito.
Demostración. Hay infinitos lenguajes reconocibles distintos: por ejemplo, para cada , el lenguaje , que tiene una sola cadena. Para cada lenguaje reconocible , el conjunto de las máquinas que lo reconocen no es vacío, y entre ellas hay alguna de descripción más corta, porque las longitudes son números naturales. Esa máquina es mínima. Máquinas que reconocen lenguajes distintos son distintas, así que hay infinitas máquinas mínimas. ∎
Lema 2. Un conjunto infinito de cadenas tiene cadenas más largas que cualquier número dado.
Demostración. Para cada hay una cantidad finita de cadenas de longitud a lo sumo . Un conjunto infinito no cabe entre ellas. ∎
Teorema. Ningún subconjunto infinito de es reconocible. En particular, no es reconocible, y por lo tanto no es decidible.
Demostración. Por contradicción, con el teorema de recursión. Sea un conjunto infinito, y supongamos que es reconocible. En la semana 7 vimos que un lenguaje es reconocible si y solo si algún enumerador lo enumera. Sea un enumerador de : imprime, una tras otra, descripciones de máquinas; toda cadena de aparece alguna vez, y no aparece ninguna cadena que no esté en . Construimos:
C = "Con la entrada w:
  1. Obtener, por el teorema de recursión, la propia descripción ⟨C⟩.
  2. Correr el enumerador E hasta que imprima una descripción ⟨D⟩ más larga que ⟨C⟩.
  3. Simular D con la entrada w. Si D acepta, aceptar. Si D rechaza, rechazar."
El paso 2 termina. es infinito, así que por el lema 2 contiene una cadena más larga que . imprime todas las cadenas de , y esa en particular, después de una cantidad finita de pasos.
La máquina es la misma para toda entrada. El paso 2 no mira : imprime siempre la misma lista, y es la primera de la lista que es más larga que .
y reconocen el mismo lenguaje. Por el paso 3, acepta si y solo si acepta : si acepta, acepta; si rechaza, rechaza; y si no se detiene, tampoco, así que no acepta. Entonces .
La contradicción. Por el paso 2, . Entonces es una máquina con descripción más corta que la de que reconoce el mismo lenguaje: no es mínima. Pero imprimió , así que , y sí es mínima. Contradicción: no es reconocible.
Para la segunda afirmación, es un subconjunto infinito de sí mismo, por el lema
- Y todo lenguaje decidible es reconocible. ∎
La máquina es corta y fija: su tamaño no depende de cuán grandes sean las máquinas que imprime. Por eso puede esperar a que aparezca una más grande que ella y hacerse pasar por esa. Para saber cuándo una máquina es “más grande que ella”, necesita medir su propia descripción, y ahí entra el teorema de recursión.
El enunciado es más fuerte de lo que parece. No dice solo que no se puede decidir si una máquina es mínima. Dice que ningún procedimiento puede producir una lista infinita de máquinas con la garantía de que todas son mínimas. Se puede certificar que es mínima una cantidad finita de máquinas, por ejemplo las más cortas, revisándolas una por una con un argumento especial para cada una. No existe un método general.
En la práctica. Un compilador que optimiza para tamaño (
g++ -Os) aplica una lista de transformaciones que achican el programa sin cambiar lo que hace. Ninguna lista es completa: no existe el optimizador que entrega siempre el programa más corto equivalente al que recibe, porque con él se decidiría si un programa es mínimo. Siempre queda una optimización por agregar. Los superoptimizadores, que sí buscan el código más corto, lo hacen para fragmentos pequeños y sin ciclos, donde la equivalencia de dos fragmentos es decidible.
Virus: un quine con algo más
Un programa que se copia a sí mismo es un quine. Un quine que, además de copiarse, hace otra cosa, tiene la forma de un virus.
quine_payload.cpp es un quine con esa forma, sin la parte dañina. Usa la misma función own_source que
self_check, y su main tiene dos partes:
int main() {
    const std::string self = own_source();
    // La copia.
    std::cout << self;
    // El payload.
    const std::ptrdiff_t lines = std::count(self.begin(), self.end(), '\n');
    std::cerr << "payload: me copié completo, " << lines << " líneas y " << self.size() << " bytes\n";
    return 0;
}
La primera parte es la replicación: escribe su código en la salida estándar. La segunda es el payload, lo que el programa hace además de copiarse. Aquí cuenta sus líneas y lo dice por la salida de errores, para no ensuciar la copia.
$ build/quine_payload > build/copy2.cpp
payload: me copié completo, 48 líneas y 1898 bytes
$ cmp build/copy2.cpp quine_payload.cpp && echo iguales
iguales
La copia es exacta, incluido el payload: copy2.cpp, compilado, vuelve a copiarse y vuelve a ejecutarlo.
Para un virus real faltan dos cosas, y ninguna es teoría nueva. La copia no va a la salida estándar sino
dentro de otro programa o de otro archivo, que al ejecutarse la pone a correr. Y el payload hace algo que quien
usa la computadora no pidió.
En la práctica. Los virus son quines con algo más: el teorema de recursión garantiza que la parte que se copia siempre se puede escribir, en cualquier lenguaje y para cualquier payload. El ejemplo más citado es la conferencia de Ken Thompson Reflections on Trusting Trust (1984). Empieza con un quine en C y termina con un compilador modificado que, al compilar el programa
login, le agrega una puerta trasera, y al compilarse a sí mismo vuelve a agregarse la modificación. El código fuente del compilador queda limpio: la modificación solo vive en el ejecutable y se copia de versión en versión. La otra cara es la defensa. Un antivirus perfecto tendría que decidir si un programa cualquiera llega a copiarse, y esa es una pregunta sobre el comportamiento de un programa, del tipo que las semanas 9 y 10 mostraron indecidible. Los antivirus reales buscan patrones conocidos y comportamientos sospechosos, y se equivocan en los dos sentidos.
El programa de Hilbert
La segunda sesión cambia de tema en apariencia: de las máquinas a las demostraciones. En realidad vuelve al origen del curso. Las máquinas de Turing se inventaron para responder una pregunta sobre demostraciones.
A comienzos del siglo XX, David Hilbert propuso un plan para poner toda la matemática sobre una base segura. La idea era escribirla dentro de un sistema formal: una lista fija de axiomas y unas reglas tan precisas que comprobar una demostración fuera un trabajo mecánico, sin intuición ni interpretación. De ese sistema esperaba tres cosas.
- Que fuera completo. Toda afirmación matemática bien escrita se podría demostrar o refutar dentro del sistema. Ninguna pregunta quedaría sin respuesta.
- Que fuera consistente, es decir, que nunca demostrara una afirmación y también su negación. Y que eso mismo se pudiera demostrar con métodos elementales.
- Que fuera decidible. Habría un procedimiento que, dada una afirmación cualquiera, dijera en un tiempo finito si tiene demostración. Hilbert y Wilhelm Ackermann formularon esta pregunta en 1928 con el nombre de Entscheidungsproblem, el problema de la decisión.
Las tres esperanzas resultaron falsas. Las dos primeras cayeron en 1931, con los dos teoremas de incompletitud de Kurt Gödel. La tercera cayó en 1936, con dos trabajos independientes, uno de Alonzo Church y otro de Alan Turing. Para poder demostrar que ningún procedimiento decide, Turing tuvo que definir qué es un procedimiento, y definió sus máquinas. El artículo donde aparecen por primera vez lleva el Entscheidungsproblem en el título.
Nosotros recorremos la historia al revés. Ya tenemos las máquinas y el problema de la parada, y con ellos la incompletitud sale en media página. Primero hay que decir con precisión de qué habla.
Sistemas formales
Afirmaciones, y cuándo son verdaderas
Trabajaremos con las afirmaciones de la aritmética: las que hablan de los números naturales con la suma y el producto. Se escriben con variables que representan números, los símbolos , , , las constantes y , los conectores , , , y los cuantificadores y . Una afirmación es una fórmula en la que toda variable está cuantificada. Para lo que sigue importa una sola cosa de esta sintaxis: una afirmación es una cadena sobre un alfabeto finito, y una máquina puede decidir si una cadena es una afirmación bien escrita.
Algunos ejemplos.
Todo número tiene un siguiente. Es verdadera.
Existe un número cuyo doble es 3. Es falsa.
Con lo básico se escriben propiedades más ricas. ” es menor que ” es . ” es primo” es
Y entonces:
Hay primos tan grandes como se quiera. Es verdadera, y la demostró Euclides.
Hay infinitos pares de primos que difieren en 2. Hoy nadie sabe si es verdadera.
El último ejemplo muestra el punto que hay que tener claro antes de seguir. Cada afirmación de la aritmética es verdadera o falsa: habla de los números naturales, y en los números naturales las cosas son de una manera. O hay infinitos primos gemelos o no los hay. Que nosotros no sepamos cuál de las dos no cambia eso. La verdad de una afirmación no depende de ningún sistema de axiomas ni de que alguien la haya demostrado.
Demostraciones que una máquina puede comprobar
Un sistema formal tiene axiomas, que son afirmaciones que se aceptan sin demostración, y reglas de inferencia, que dicen cómo obtener una afirmación nueva a partir de otras ya obtenidas. Una regla típica: de y de se obtiene . Una demostración de en el sistema es una lista finita de afirmaciones en la que cada una es un axioma o sale de las anteriores por una regla, y la última es .
Hay muchos sistemas formales, con distintos axiomas y reglas. Los más conocidos son la aritmética de Peano, para los números naturales, y la teoría de conjuntos ZFC, en la que se puede escribir casi toda la matemática actual. No necesitaremos los detalles de ninguno, porque todo lo que sigue usa una sola propiedad, que es la que Hilbert pedía.
Definición. Un sistema formal , para lo que nos interesa, está dado por una máquina de Turing , el comprobador, que siempre se detiene. recibe una afirmación y una cadena , y acepta si es una demostración de en . Una afirmación es demostrable en si alguna cadena es una demostración suya.
La definición esconde los axiomas y las reglas dentro de . No se pierde nada: con axiomas y reglas razonables, comprobar una demostración es recorrer la lista y revisar cada línea, y eso es un algoritmo. Lo que la definición exige es que comprobar sea mecánico. No exige que encontrar la demostración lo sea.
Tres propiedades que un sistema puede tener o no:
| Propiedad | Qué dice | De qué habla |
|---|---|---|
| Correcto (sound) | Toda afirmación demostrable es verdadera | Del sistema y de los números |
| Consistente | Ninguna afirmación es demostrable junto con su negación | Solo del sistema |
| Completo | Para toda afirmación , es demostrable o es demostrable | Solo del sistema |
Un sistema correcto es consistente: si demostrara y , las dos serían verdaderas, y eso no pasa. Al revés no vale: un sistema puede no contradecirse nunca y aun así demostrar algo falso.
Idea clave. Verdadero y demostrable son dos nociones distintas. Verdadero habla de los números: la afirmación describe lo que pasa en Demostrable habla de cadenas: existe una lista de símbolos que el comprobador acepta. Un sistema correcto garantiza que lo demostrable es verdadero. La pregunta de Hilbert era la otra dirección: si todo lo verdadero es demostrable.
Como comprobar es mecánico, buscar también lo es, aunque pueda no terminar.
Lema. Para todo sistema formal , el conjunto de las afirmaciones demostrables en es reconocible.
Demostración. Por construcción. Esta máquina lo reconoce:
B_S = "Con la entrada φ:
  1. Para cada cadena π, en orden de longitud y, dentro de la misma longitud, alfabético:
  2.     Correr el comprobador V con ⟨φ, π⟩. Si acepta, aceptar."
Cada llamada a termina. Si tiene una demostración, esa cadena aparece en algún momento y acepta. Si no la tiene, sigue buscando para siempre y no acepta. ∎
Es la misma búsqueda con la que en la semana 10 reconocimos el problema de correspondencia de Post: probar todos los candidatos, por longitud. Y tiene el mismo defecto. Si la afirmación no tiene demostración, la máquina no lo dice nunca.
La aritmética puede hablar de máquinas
Para conectar los sistemas formales con el problema de la parada hace falta un puente: escribir hechos sobre máquinas de Turing como afirmaciones sobre números.
Lema (las máquinas en la aritmética). Existe una función computable que, a partir de , produce una afirmación de la aritmética tal que
No vamos a demostrarlo completo. Damos la idea, que tiene tres pasos y usa una herramienta de la semana 10.
- Las cadenas son números. Una configuración de es una cadena sobre un alfabeto finito, y una cadena se puede leer como un número escrito en una base adecuada, con un dígito por símbolo. Lo mismo vale para una secuencia de configuraciones separadas por .
- Un paso de la máquina es una relación entre números. En la semana 10 vimos que comprobar que una configuración sigue a otra es un trabajo local: las dos cadenas son iguales salvo alrededor del cabezal, y ahí cambian según . Hablar del dígito de un número es hablar de cocientes y restos, que se escriben con suma y producto. Entonces “la configuración número sigue a la configuración número ” se escribe como una fórmula de la aritmética, distinta para cada .
- Detenerse es que exista una historia. se detiene con si y solo si existe una historia de cómputo: una secuencia finita de configuraciones que empieza en la inicial con , avanza de a un paso y termina en o en . Una historia es una cadena, y por lo tanto un número . Con los pasos 1 y 2:
La parte técnica que omitimos está en el paso 2. Para sacar el dígito de un número hace falta la potencia , y el lenguaje solo tiene suma y producto. Gödel resolvió ese detalle con un argumento de teoría de números. El resultado es el del lema: la fórmula existe, y hay un algoritmo que la escribe a partir de la tabla de y de .
Lo que importa es la forma de la afirmación. ” se detiene con ” dice que existe un número con una propiedad que se puede comprobar mecánicamente. ” no se detiene con ” dice que ningún número la tiene. Para confirmar la primera basta exhibir el número. Para confirmar la segunda habría que revisar infinitos candidatos, o tener una demostración.
A un sistema formal cuyas afirmaciones incluyen las de la aritmética, y en particular todas las , le diremos que expresa la aritmética.
El primer teorema de incompletitud
Teorema (primer teorema de incompletitud, para sistemas correctos). Sea un sistema formal que cumple tres condiciones:
- Es efectivo: una máquina que siempre se detiene comprueba si una cadena es una demostración de una afirmación. Es la definición de sistema formal que dimos.
- Expresa la aritmética: entre sus afirmaciones están las .
- Es correcto: toda afirmación de la aritmética demostrable en es verdadera.
Entonces hay una afirmación de la aritmética que es verdadera y no tiene demostración en . Más aún, hay una máquina y una cadena tales que no se detiene con , y la afirmación , que lo dice, no es demostrable en .
Demostración. Por contradicción, con el problema de la parada. Supongamos que no: siempre que no se detiene con , la afirmación tiene una demostración en . Construimos:
P = "Con la entrada ⟨M, w⟩:
  1. Construir la afirmación φ_{M,w}.
  2. Para k = 1, 2, 3, ...:
  3.     Simular M con w durante k pasos. Si se detiene, aceptar.
  4.     Correr el comprobador V con φ_{M,w} y cada una de las primeras k cadenas.
         Si alguna es una demostración de φ_{M,w}, rechazar."
El paso 1 es posible por el lema de las máquinas en la aritmética. Los pasos 3 y 4 terminan en cada vuelta: la simulación está acotada y siempre se detiene. Veamos qué hace en cada caso.
Si se detiene con . Entonces es falsa. Como es correcto, no tiene demostración, y el paso 4 nunca rechaza. Cuando llega a la cantidad de pasos que necesita, el paso 3 acepta.
Si no se detiene con . El paso 3 nunca acepta. es verdadera y, por lo que supusimos, tiene una demostración. Esa demostración es una cadena, y cuando llega a su posición en la lista, el paso 4 la encuentra y rechaza.
En los dos casos se detiene, y acepta exactamente cuando se detiene con . Entonces decide , que es indecidible. Contradicción: hay un par , para el que no se detiene con y no tiene demostración. Esa afirmación es verdadera, porque dice justamente que no se detiene con . ∎
Corolario. Un sistema que cumple las tres condiciones no es completo.
Demostración. Sea la afirmación del teorema: verdadera y sin demostración. Su negación es falsa, y como es correcto, tampoco tiene demostración. Ni ni son demostrables. ∎
Revisemos dónde se usó cada hipótesis, porque el teorema es falso si se quita cualquiera de las tres.
- Efectivo. Se usó para que pudiera buscar demostraciones. Sin esta condición hay un “sistema” correcto y completo trivial: tomar como axiomas todas las afirmaciones verdaderas. No sirve de nada, porque nadie puede comprobar si una afirmación es un axioma.
- Expresa la aritmética. Se usó para escribir . Hay sistemas correctos, efectivos y completos para lenguajes más pobres, donde las máquinas no se pueden describir. Vuelven en la sección Lo que el teorema no dice.
- Correcto. Se usó en el primer caso, para saber que una afirmación falsa no tiene demostración. Un sistema que se contradice demuestra todo, y es completo de la peor manera.
El argumento se puede decir sin la máquina , en tres líneas, y así conviene recordarlo.
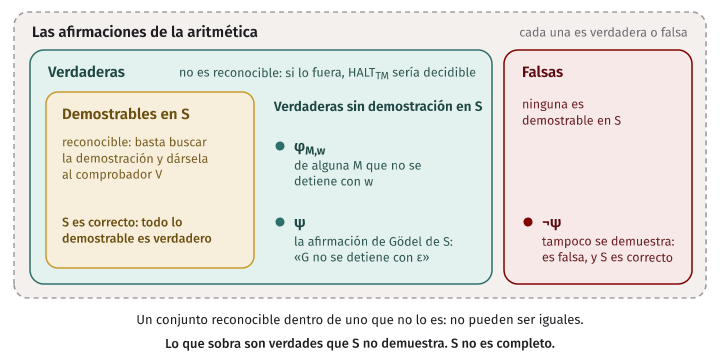
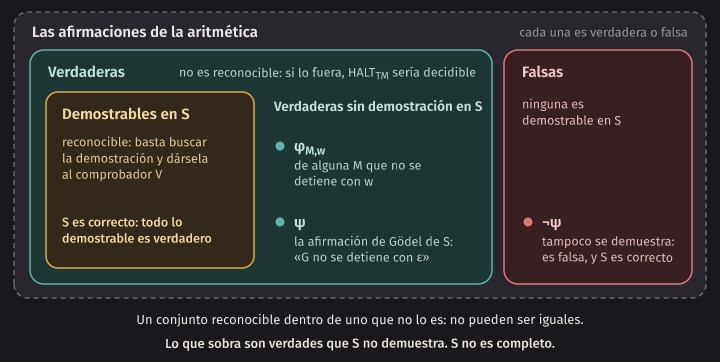
Idea clave. Lo demostrable es reconocible: basta buscar la demostración. Lo verdadero no lo es: si lo fuera, se reconocería cuándo una máquina no se detiene, y el problema de la parada sería decidible. Dos conjuntos de los que uno es reconocible y el otro no, no pueden ser iguales. En un sistema correcto lo demostrable está dentro de lo verdadero, así que lo que sobra son verdades sin demostración.
Dos observaciones sobre el alcance.
Agregar axiomas no lo arregla. Si es verdadera y no demostrable en , se la puede agregar como axioma. El sistema nuevo, , sigue siendo efectivo, sigue expresando la aritmética y sigue siendo correcto, porque el axioma agregado es verdadero. Entonces el teorema se le aplica, y tiene su propia afirmación verdadera sin demostración. Se puede repetir sin fin, y agregar de una vez una lista infinita de axiomas tampoco ayuda, mientras una máquina pueda reconocer cuáles son los axiomas.
El teorema habla de programas. Para todo sistema que cumpla las condiciones hay un programa concreto que no termina y cuya no terminación ese sistema no puede demostrar. Es el reflejo, en la lógica, de lo que significó el problema de la parada en la semana 9. Una herramienta que demuestra automáticamente que los programas terminan trabaja dentro de algún sistema formal, y habrá programas que no terminan sobre los que no podrá concluir nada.
La demostración que dimos prueba que la afirmación existe, pero no la muestra. La sección siguiente construye una.
La afirmación de Gödel
Gödel no tenía máquinas de Turing en 1931. Su demostración construye directamente una afirmación que dice de sí misma “no tengo demostración”. Con el teorema de recursión, esa construcción es corta.
Sea un sistema que cumple las tres condiciones, con comprobador . Construimos una máquina que busca una demostración de que ella misma no se detiene:
G = "Con cualquier entrada:
  1. Obtener, por el teorema de recursión, la propia descripción ⟨G⟩.
  2. Construir la afirmación ψ = φ_{G,ε}: "G no se detiene con la entrada ε".
  3. Para cada cadena π, en orden de longitud:
4. Correr el comprobador V con ⟨ψ, π⟩. Si π es una demostración de ψ, detenerse."no mira su entrada, así que hace lo mismo con todas, y en particular con . Por los pasos 3 y 4:
Y por cómo se construyó :
Juntando las dos líneas:
La afirmación es una afirmación sobre números, larga y sin gracia. Pero es verdadera exactamente cuando ella misma no es demostrable. Es la versión precisa de la frase esta afirmación no tiene demostración, y la palabra esta, que en la primera sesión no nos permitimos, la puso el teorema de recursión.
Teorema. Si cumple las tres condiciones, es verdadera y no tiene demostración en .
Demostración. Por contradicción. Supongamos que tiene una demostración en . Entonces la encuentra y se detiene con . Pero dice que no se detiene con , así que es falsa. habría demostrado una afirmación falsa, y es correcto. Contradicción: no tiene demostración. Entonces busca para siempre y no se detiene con , que es lo que afirma. Luego es verdadera. ∎
La frase de la primera sesión se copiaba. Esta afirmación habla de su propia demostrabilidad. La construcción es la misma: una parte que es dato, una parte que calcula con el dato, y el teorema de recursión para unirlas.
Hay una pregunta que surge siempre en este punto. Acabamos de demostrar que es verdadera. ¿No es eso una demostración de ? Lo es, pero no en . Nuestro argumento usó una hipótesis: que es correcto. Es una demostración en un sistema más fuerte, que tiene los axiomas de y además sabe que no demuestra falsedades. Ese sistema más fuerte tiene a su vez su propia afirmación de Gödel, distinta de . “Verdadera pero indemostrable” siempre quiere decir indemostrable en un sistema dado.
Qué demostró Gödel exactamente
La versión de estos apuntes es más débil que el teorema original en un punto, y hay que decirlo.
Nuestra hipótesis es que es correcto: no demuestra nada falso. Es una hipótesis que habla de la verdad en los números naturales. Gödel no quería apoyarse en esa noción, y su teorema pide menos: que sea consistente y que pueda no solo expresar sino demostrar los hechos elementales de la aritmética, como los resultados de sumas y productos concretos. La conclusión es la misma, que no es completo. En su forma original pedía una condición un poco más fuerte que la consistencia; John Barkley Rosser la redujo a la consistencia sola en 1936. La demostración con esa hipótesis es más fina que la nuestra y no la veremos.
El segundo teorema de incompletitud dice que un sistema formal efectivo y consistente que contiene la aritmética de Peano no puede demostrar la afirmación que expresa su propia consistencia. Era la segunda esperanza de Hilbert.
Lo que el teorema no dice
Pocos teoremas se citan tanto fuera de la matemática, y casi siempre para hacerle decir algo que no dice. Vale la pena revisar las confusiones más frecuentes una por una.
No dice que “nada se puede demostrar”, ni que la matemática es incierta. Los teoremas demostrados siguen demostrados. El teorema de incompletitud es él mismo un teorema, con una demostración que acaban de leer. Lo que dice es que ningún sistema formal fijo agota las verdades de la aritmética. Siempre queda algo afuera, y lo que queda afuera de un sistema puede estar dentro de otro.
No dice que haya verdades “absolutamente indemostrables”. La afirmación depende de : se construyó a partir de su comprobador. No tiene demostración en , y la tiene, trivialmente, en el sistema que resulta de agregarla como axioma, y de manera más interesante en sistemas más fuertes. El teorema da, para cada sistema, una afirmación que a ese sistema se le escapa. No da una afirmación que se le escape a todos.
No habla de todos los sistemas formales. Habla de los que expresan la aritmética con suma y producto. Con menos, puede haber sistemas completos. La aritmética de Presburger, que tiene los números naturales con la suma y sin el producto, es correcta, completa y decidible: Mojżesz Presburger lo demostró en 1929. Lo mismo pasa con la teoría de los números reales con suma y producto, por un teorema de Alfred Tarski, y con la geometría elemental. No es que esos sistemas sean mejores: su lenguaje no alcanza para describir máquinas de Turing, y sin eso nuestra demostración no arranca.
No habla de la mente humana. Se ha argumentado, por ejemplo John Lucas en 1961 y Roger Penrose en 1989, que el teorema demuestra que la mente no es una máquina: nosotros “vemos” que la afirmación de Gödel es verdadera y el sistema no puede demostrarla. Pero lo que vimos nosotros es condicional: si es correcto, es verdadera. Para concluir que es verdadera hay que saber que es correcto, y el teorema no dice que las personas puedan saber eso de todo sistema, ni que el razonamiento humano sea correcto o siquiera consistente. El teorema es sobre sistemas formales. Para aplicarlo a la mente hay que agregar hipótesis que el teorema no trae.
No dice que las afirmaciones indemostrables sean rarezas autorreferentes. La de Gödel lo es, y la del primer teorema habla de una máquina. Pero se conocen afirmaciones que cualquiera reconocería como matemática común y que ciertos sistemas no deciden. El teorema de Goodstein, sobre unas secuencias de números naturales que siempre llegan a cero, es verdadero y no se puede demostrar en la aritmética de Peano (Laurie Kirby y Jeff Paris, 1982). Y la hipótesis del continuo, sobre el tamaño del conjunto de los números reales, no se puede demostrar ni refutar en ZFC, si ZFC es consistente (Gödel en 1940 y Paul Cohen en 1963).
No se debe confundir con el teorema de completitud. Gödel también demostró, en 1929, un teorema de completitud: en la lógica de primer orden, todo lo que es verdadero en todas las interpretaciones de unos axiomas tiene demostración a partir de ellos. No contradice al de incompletitud, porque la palabra completo significa cosas distintas. La afirmación de Gödel es verdadera en los números naturales, pero no en todas las estructuras que cumplen los axiomas.
Error común. Usar “incompleto” como si quisiera decir “contradictorio”. Son propiedades distintas, y el teorema las enfrenta. Un sistema es inconsistente, o contradictorio, si demuestra una afirmación y su negación: demuestra de más. Es incompleto si para alguna afirmación no demuestra ni ella ni su negación: demuestra de menos. Un sistema inconsistente demuestra todas las afirmaciones, porque de una contradicción se sigue cualquier cosa, así que es completo. El teorema dice que, para un sistema efectivo que contiene la aritmética, hay que elegir: si es consistente, es incompleto. La incompletitud no es un defecto que delate una contradicción. Es el precio de no tenerla.
Para cerrar la sesión, el estado de las tres esperanzas de Hilbert para un sistema efectivo que contiene la aritmética:
| Esperanza | Resultado | De dónde sale |
|---|---|---|
| Completo | No, si es consistente | Primer teorema de incompletitud |
| Demuestra su propia consistencia | No, si es consistente | Segundo teorema de incompletitud |
| Hay un algoritmo que decide qué es demostrable | No, si es consistente | Church y Turing, 1936: es el problema de la parada |
La tercera fila, para sistemas correctos, la pueden demostrar ustedes con lo de esta semana: es el ejercicio 8.
Complejidad de Kolmogorov
✂️ Sección opcional. Nada de lo que sigue en el curso depende de ella.
Miren estas dos cadenas de 40 símbolos:
0101010101010101010101010101010101010101
1010001100011110010010111100110000001000
La primera se puede dictar por teléfono en cuatro palabras: “veinte veces cero uno”. Para la segunda no se ve otra forma que leerla entera. Las dos tienen la misma longitud, y sin embargo la primera parece tener menos información. La complejidad de Kolmogorov convierte esa impresión en una definición: la información de una cadena es la longitud de su descripción más corta. Lleva el nombre de Andréi Kolmogórov, que la propuso en los años sesenta; Ray Solomonoff y Gregory Chaitin llegaron a la misma idea por su cuenta.
Hay que decir qué es una descripción. No puede ser una frase en español, porque “describir” en español no está definido con precisión, y esa imprecisión lleva a una paradoja que veremos al final. Una descripción será un programa que produce la cadena.
La definición
En esta sección todas las cadenas son binarias, y es una codificación binaria de la máquina .
Definición. Una descripción de una cadena es un par formado por una máquina de Turing y una entrada tales que , con la entrada , se detiene con en la cinta. El par se escribe como una sola cadena binaria , de este modo: primero con cada bit duplicado, después , después . La complejidad de Kolmogorov de , que se escribe , es la longitud de la descripción más corta de .
La codificación del par está elegida para que se pueda separar sin ambigüedad: mientras los bits vienen de a dos iguales, son de ; el primer par distinto, , marca el final, y lo que sigue es . Cuesta
Una descripción tiene entonces dos partes, y son las mismas dos del quine: un programa, , y unos datos, . Para una cadena con mucha regularidad conviene un programa que aproveche la regularidad y unos datos cortos. Para una cadena sin regularidad no queda más que un programa trivial y la cadena entera como datos. Esa última opción siempre está disponible.
Teorema (una cadena nunca cuesta mucho más que su longitud). Existe una constante tal que, para toda cadena , .
Demostración. Por construcción. Sea la máquina que se detiene de inmediato, sin tocar la cinta. Con la entrada se detiene con en la cinta, así que es una descripción de . Su longitud es . Tomamos , que no depende de . ∎
En el otro extremo, la cadena cuesta muy poco. Sea la máquina que lee un número en binario y escribe ceros. El par describe a , y en binario ocupa bits. Entonces
con una constante que depende de y no de . Un millón de ceros se describe con unos 20 bits más una constante.
No depende mucho del lenguaje
La definición usa máquinas de Turing con una codificación fija. ¿Qué pasa si las descripciones se escriben en C++, o en otro lenguaje? La respuesta es que cambia, pero poco: a lo sumo en una constante.
Un lenguaje de descripción es cualquier función computable que a algunas cadenas les asigna otra cadena: quiere decir que describe a en ese lenguaje. Puede no estar definida para todas las cadenas. Sea la longitud de la cadena más corta con .
Teorema (invariancia). Para todo lenguaje de descripción existe una constante tal que, para toda cadena , .
La razón es corta. Como es computable, hay una máquina que la calcula. Si es la descripción más corta de en el lenguaje , entonces es una descripción de en el sentido de la definición, de longitud . La constante es el costo de incluir el intérprete del lenguaje , y se paga una sola vez, sea cual sea .
Dos consecuencias:
- es, salvo una constante, la mejor medida posible. Ningún lenguaje de descripción le gana por más que una constante. Por eso se habla de la complejidad de una cadena, aunque la definición dependa de una codificación.
- Un compresor da una cota superior.
gzip -des una función computable: recibe un archivo comprimido y devuelve el original. Es un lenguaje de descripción, y por lo tanto es a lo sumo el tamaño de comprimido congzip, más una constante. Lo mismo con cualquier otro compresor.
La constante impide decir cosas sobre una cadena aislada: "" depende de la codificación. Los enunciados con sentido son los que valen para todas las cadenas, o para cadenas de longitud creciente, donde una constante deja de importar.
Cadenas incompresibles
Definición. Una cadena es incompresible si : ninguna descripción es más corta que la cadena misma.
Teorema. Para todo existe una cadena incompresible de longitud .
Demostración. Por conteo. Hay cadenas binarias de longitud . Una descripción es una cadena binaria, y la cantidad de cadenas binarias de longitud menor que es
Cada descripción describe a lo sumo una cadena: la que deja en la cinta la máquina al detenerse. Entonces las descripciones de longitud menor que describen, entre todas, a lo sumo cadenas. Hay cadenas de longitud , así que al menos una no tiene ninguna descripción de longitud menor que . Para esa cadena, . ∎
Es el principio del palomar: un argumento de conteo, como el de la semana 1 cuando vimos que hay más lenguajes que programas, pero aquí con conjuntos finitos. El mismo conteo dice más: casi todas las cadenas son casi incompresibles.
Corolario. Para todo y todo , menos de una fracción de las cadenas de longitud cumple .
Demostración. Las cadenas binarias de longitud a lo sumo son . Describen a lo sumo esa cantidad de cadenas, y
Con : menos de una cadena de cada 1000 se puede describir ahorrando 11 bits o más, porque . Si se elige una cadena de un millón de bits lanzando una moneda, es casi seguro que no se puede comprimir ni en 11 bits. Las cadenas con regularidad, las que un compresor aprovecha, son una minoría ínfima.
Error común. Concluir que un buen compresor achica cualquier archivo. Ningún compresor sin pérdida puede achicar todas las entradas: es el mismo conteo. Si algunas cadenas salen más cortas, otras tienen que salir más largas. Los compresores sirven porque los archivos que nos interesan (texto, código, tablas) están en la minoría con regularidad.
K no es computable
El teorema anterior dice que hay cadenas incompresibles de toda longitud. No dice cuáles. La razón es que no hay forma de calcular .
Empecemos por la paradoja que lo anuncia. Consideren
el menor número natural que no se puede describir con menos de veinte palabras.
Con menos de veinte palabras se puede describir solo una cantidad finita de números, así que hay números que no se pueden describir así, y entre ellos hay uno que es el menor. Pero la frase de arriba lo describe, y tiene catorce palabras. Es la paradoja de Berry. En español la paradoja se disuelve diciendo que “describir” no está bien definido. Con sí lo está, y entonces el mismo razonamiento deja de ser una paradoja y pasa a ser una demostración: lo que falla es la suposición de que se puede calcular cuánto cuesta describir algo.
Teorema. La función no es computable.
Demostración. Por contradicción, con el argumento de la paradoja de Berry. Supongamos que una máquina calcula . Construimos:
N = "Con la entrada m, un número escrito en binario:
  1. Para cada cadena x, en orden de longitud y, dentro de la misma longitud, alfabético:
  2.     Calcular K(x).
3. Si K(x) ≥ m, escribir x en la cinta y detenerse."se detiene con toda entrada : por el teorema anterior hay una cadena de longitud con , así que la búsqueda encuentra alguna cadena que cumple la condición. Sea la cadena que escribe. Por el paso 3,
Por otro lado, el par es una descripción de , porque con la entrada se detiene con en la cinta. El número en binario ocupa bits, así que
con , una constante que no depende de . Juntando las dos desigualdades,
Eso es falso: crece más rápido que , y para suficientemente grande . Contradicción: ninguna máquina calcula . ∎
es “la primera cadena que no se puede describir con menos de bits”, escrita como programa. El programa mide una constante más los bits de , que son muchos menos que . La frase de Berry tiene catorce palabras y habla de veinte. Es la misma trampa.
La demostración da un poco más de lo que dice el enunciado. Si una función computable cumple para toda , entonces está acotada: no puede crecer sin límite. Se puede acotar por arriba, con cualquier compresor, pero no por abajo. Se puede mostrar que una cadena es simple, exhibiendo su descripción corta. No hay método para mostrar que una cadena es compleja.
Lo que hace un compresor
Los compresores permiten ver las cotas superiores con números. gen_string escribe tres cadenas binarias,
y make compress las comprime con gzip, bzip2 y xz. Los primeros 40 símbolos de cada una:
$ build/gen_string pattern 40; echo; build/gen_string count 40; echo; build/gen_string prng 40; echo
0101010101010101010101010101010101010101
1101110010111011110001001101010111100110
1010001100011110010010111100110000001000patternes repetido.countson los números escritos en binario y pegados sin separación: , , , , …prngson los bits que produce un generador seudoaleatorio de la biblioteca estándar,std::mt19937_64, con una semilla fija.
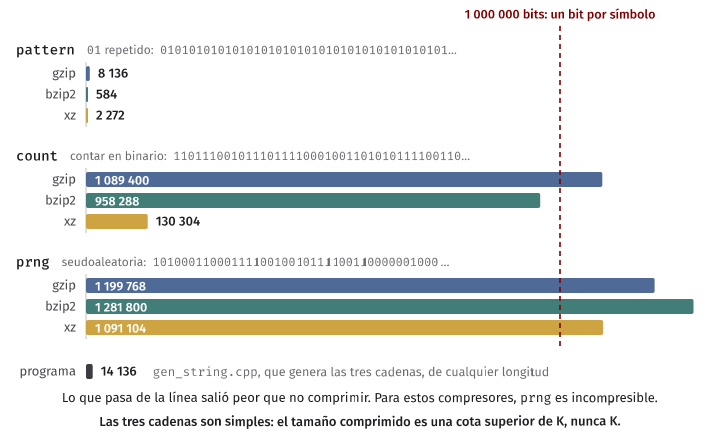
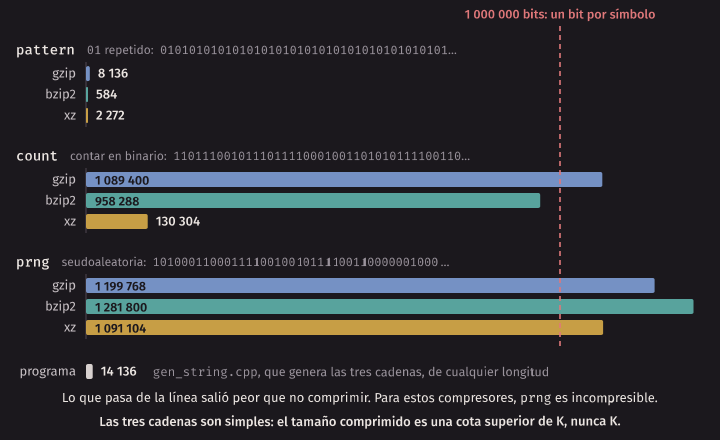
Con un millón de símbolos de cada una:
$ make compress
cadenas de 1000000 símbolos (0 y 1); tamaños comprimidos en bits
cadena           gzip        bzip2           xz
pattern          8136          584         2272
count         1089400       958288       130304
prng          1199768      1281800      1091104
el programa que las genera: 14136 bits de código fuente
Los archivos guardan cada símbolo, 0 o 1, en un byte. La cadena tiene un millón de bits de contenido, y
con eso hay que comparar: un compresor “comprime” de verdad si entrega menos de 1 000 000 bits.
Tres lecturas de la tabla.
pattern: todos encuentran la regularidad. bzip2 deja el millón de símbolos en 584 bits. Para esta
cadena es a lo sumo más una constante, por el mismo argumento que para , y los
tres compresores confirman que es simple.
count: la regularidad está y casi nadie la ve. gzip entrega más de un millón de bits: sale peor que
escribir un bit por símbolo. xz la reduce a cerca de la octava parte. Ninguno descubre la regla verdadera, que cabe
en una línea: contar en binario.
prng: para los tres compresores es incompresible, y no lo es. Los tres entregan más de un millón de
bits. Si solo tuviéramos estos números diríamos que la cadena no tiene regularidad. Pero las tres cadenas
salen del mismo programa, gen_string.cpp, de 1767 bytes, con dos argumentos. “Compilar este programa y
correrlo con estos argumentos” es un lenguaje de descripción, así que por el teorema de invariancia
donde no depende de la cadena. Y con mil millones de símbolos en lugar de un millón, la descripción crece
solo en los 10 bits que hacen falta para escribir un número mil veces mayor. La cadena prng es de las más
simples que hay. Es simple de una manera que estos compresores no buscan.
Idea clave. El tamaño comprimido es una cota superior de , nunca . Un compresor busca algunas regularidades, las que su algoritmo conoce. las considera todas, porque considera todos los programas. Y por eso mismo no es computable: no hay un compresor que encuentre siempre la descripción más corta.
En la práctica. Un generador seudoaleatorio es un programa corto cuya salida ningún método estadístico rápido distingue del azar. Toda su salida tiene complejidad de Kolmogorov pequeña: se describe con el programa y la semilla. Por eso quien conoce la semilla conoce toda la secuencia, y por eso en criptografía la semilla es el secreto que hay que proteger.
¿Y una cadena incompresible de verdad? Por el corolario, lanzar una moneda un millón de veces da una con probabilidad mayor que , si se tolera un ahorro de hasta 10 bits. Pero no hay forma de certificarlo. Esto une las dos mitades de la sesión: Gregory Chaitin demostró que un sistema formal correcto solo puede demostrar "" para valores de por debajo de una constante que depende del sistema, aunque esa afirmación sea verdadera para casi todas las cadenas. Es otra forma del teorema de incompletitud, y su demostración, que es el argumento de Berry una vez más, queda como el ejercicio 12.
El código de la semana
code/week-11/
├── self.h                 literal de un texto, programa que lo imprime, molde que se completa
├── naive_growth.cpp       el intento ingenuo: P0, P1, P2... cada uno imprime al anterior
├── make_self.cpp          completa un molde con una copia de sí mismo
├── templates/             los moldes: el programa con una arroba en el lugar de los datos
├── quine.cpp              el quine del capítulo
├── self_check.cpp         obtiene su código y lo compara con la entrada
├── quine_payload.cpp      un quine que además hace otra cosa
├── gen_string.cpp         las tres cadenas de la sección de Kolmogorov
├── compress.sh            las comprime con gzip, bzip2 y xz
├── errors/                dos programas que no son quines
├── test_self.cpp          pruebas con assert de las funciones de self.h, la frase y los conteos
├── test_quines.sh         compila, ejecuta y compara con cmp
└── lab/quine/             el ejercicio opcional
make compila todo, y make test corre las pruebas con ASan y UBSan. Esta semana hay dos tipos de prueba.
test_self comprueba con assert, como siempre, lo que el capítulo afirma sobre las funciones de self.h:
que leer el literal de un texto devuelve el texto, que el programa que imprime un texto es siempre más largo
que el texto, los tamaños de la tabla de naive_growth, que fill_hole arma lo que la parte vuelve a
armar, la frase en español y los conteos de cadenas. Pero la afirmación central de la semana, que un programa
imprime su propio código, no cabe en un assert: hay que compilar un programa, ejecutarlo y comparar su
salida con un archivo. Eso lo hace test_quines.sh, con cmp.
$ make test
test_self: ok
make_self: ok (3 moldes)
quine: ok (1350 bytes, y la copia de la copia es igual)
quine_payload: ok (48 líneas, 1898 bytes)
self_check: ok
naive_growth: ok (P3 imprime P2, P2 imprime P1, P1 imprime P0)
errors: ok (prints_other no se imprime; reads_file falla sin su archivo)
gen_string: ok
Todas las pruebas pasaron.
Línea por línea, lo que comprueba el script:
| Línea | Qué se comprobó |
|---|---|
make_self |
quine.cpp, quine_payload.cpp y self_check.cpp son exactamente lo que make_self produce con su molde |
quine |
La salida de quine es igual a quine.cpp; esa salida, compilada, vuelve a imprimir lo mismo |
quine_payload |
La salida estándar es igual al fuente, y el payload dice las líneas y los bytes que cuenta wc |
self_check |
Responde que sí con su código, y que no con otro programa, con la entrada vacía y con su código más un salto de línea |
naive_growth |
imprime , imprime y imprime , y ninguno se imprime a sí mismo |
errors |
prints_other no imprime su código; reads_file lo imprime solo desde la carpeta donde se compiló |
gen_string |
Las cadenas tienen la longitud pedida y son siempre las mismas; gzip y xz devuelven la original |
Si cambian quine.cpp a mano, aunque sea un espacio, make test falla en la primera línea: el archivo ya no
es lo que da el molde. El camino correcto es cambiar el molde y regenerar:
build/make_self < templates/quine.tpl > quine.cppLas reglas de C++ del curso se cumplen sin excepciones: ninguno de los programas usa variables globales. En
los quines el texto es una variable local de main o de own_source.
La tabla de make compress no es parte de make test, porque los tamaños exactos dependen de la versión de
cada compresor. Los de este capítulo se obtuvieron en el entorno del curso, con gzip 1.13 y xz 5.8.1.
El laboratorio
La sesión de laboratorio de esta semana es la Práctica 3. El ejercicio opcional está en lab/quine: escribir
un quine en C++ sin raw string literals, es decir, resolviendo a mano el problema de las comillas y los
saltos de línea que quine.cpp evita.
cd lab/quine
make test          # revisa el fuente, compila, ejecuta y compara con cmp
make test-length   # el paso 3: el quine que además imprime cuántos bytes tiene
Este problema no usa el juez ni tiene carpeta casos/, porque la salida esperada es el propio programa.
make test rechaza además un fuente que abra archivos o que use __FILE__ y similares. Es una búsqueda de
texto simple: la regla es no pedirle el código a nadie, no esquivar la búsqueda. El enunciado, en
README.md, propone un orden de trabajo.
Resumen
- Un quine es un programa que imprime exactamente su propio código fuente, sin leer nada.
- El intento ingenuo, un programa que lleva su código entero entre comillas, no puede funcionar: lo que un programa lleva escrito es más corto que el programa.
- La solución tiene dos partes. Los datos, , describen al código. El código, , usa los datos dos veces: una para copiarlos y otra para reconstruir, poniéndolos entre comillas, la parte que es datos. Ninguna parte se contiene a sí misma.
- La frase Escriban dos veces lo que sigue, la segunda vez entre comillas: seguida de sí misma entre comillas es un quine en español.
- con y la máquina que, con , calcula y lo une con . La función , de una cadena a la descripción de una máquina que la escribe, es computable.
- Teorema de recursión. Para toda máquina con entrada hay una máquina que con hace lo que con . En la práctica: “obtener la propia descripción” es un paso válido en cualquier máquina.
- Con el teorema, es indecidible en cuatro líneas: una máquina obtiene su descripción, le pregunta al supuesto decididor qué va a hacer, y hace lo contrario.
- no es reconocible, ni lo es ninguno de sus subconjuntos infinitos: una máquina que mide su propia descripción espera a que el enumerador imprima una más larga y la imita.
- Un virus es un quine con un payload.
- Un sistema formal tiene demostraciones que una máquina comprueba. Por eso lo demostrable es reconocible. Lo verdadero es otra noción: habla de los números, no de cadenas.
- Correcto: todo lo demostrable es verdadero. Consistente: no demuestra una afirmación y su negación. Completo: de cada afirmación demuestra ella o su negación. Correcto implica consistente.
- ” no se detiene con ” se escribe como una afirmación de la aritmética, .
- Primer teorema de incompletitud, en la versión que demostramos: en todo sistema efectivo y correcto que exprese la aritmética hay una afirmación verdadera sin demostración. Si no, buscar demostraciones decidiría el problema de la parada.
- La afirmación de Gödel de un sistema es verdadera si y solo si no tiene demostración en ese sistema. Se construye con el teorema de recursión.
- El teorema no dice que nada se pueda demostrar, ni habla de la mente, ni vale para todo sistema. Incompleto no es inconsistente: un sistema inconsistente demuestra todo.
- ✂️ es la longitud de la descripción más corta de . Cambiar de lenguaje de descripción la cambia a lo sumo en una constante. Hay cadenas incompresibles de toda longitud, por conteo. no es computable, por el argumento de la paradoja de Berry. Un compresor da una cota superior.
Ejercicios
-
Frases. Para cada instrucción, digan qué texto resulta de obedecerla y si es igual a la instrucción completa. (a) Escriban lo que sigue: «Escriban lo que sigue:» (b) Escriban dos veces lo que sigue: «Escriban dos veces lo que sigue:» (c) Escriban lo que sigue, primero entre comillas y después sin ellas: «Escriban lo que sigue, primero entre comillas y después sin ellas:» Para cada una que falle, expliquen qué le falta.
-
El crecimiento del intento ingenuo. En la tabla de
naive_growth, las diferencias entre un tamaño y el siguiente son 53, 57, 64, 78, 106, 162, 274 y 498. (a) Expliquen por qué la diferencia no es constante, mirando y . (b) Las diferencias de esas diferencias son 4, 7, 14, 28, 56, 112 y 224. ¿Qué carácter es el responsable de que desde la segunda se dupliquen? (c) Cambiennaive_growth.cpppara que llegue a y comprueben su explicación. -
La marca. El molde del quine usa una arroba para marcar el hueco, y el código busca la primera. (a) ¿Qué pasa si agregan una arroba en el comentario de la primera línea de
templates/quine.tply regeneran? Predigan el resultado y después pruébenlo conmake_selfy el compilador. (b) ¿Por qué el carácter#no sirve como marca en este molde? (c) ¿Qué tendría que cambiar en el código para poder usar como marca un carácter que aparece antes del hueco? -
Programar: sin comentarios. Escriban un molde nuevo,
templates/tiny.tpl, para un quine lo más corto que puedan dentro de las reglas del curso. Genérenlo conmake_selfy comprueben concmpque es un quine. ¿Cuántos bytes tiene? ¿Qué relación hay entre el tamaño del molde y el del programa? -
Programar: un payload. A partir de
templates/quine_payload.tpl, escriban un programa que no imprima su código, sino solo la línea más larga de su propio código y su número de línea. Comprueben la respuesta con un editor. -
Una máquina que solo se acepta a sí misma. Demuestren con el teorema de recursión que existe una máquina de Turing con . ¿Cuál de los programas de la semana es esa máquina?
-
Más indecidibilidad en cuatro líneas. Demuestren con el teorema de recursión, sin reducciones: (a) es indecidible; (b) es indecidible. Para (b): una máquina que obtiene su descripción, le pregunta al supuesto decididor si su lenguaje es vacío, y hace que la respuesta sea falsa. (c) Con la misma idea, demuestren el teorema de Rice: tomen una máquina que tiene la propiedad y otra que no, y una máquina que le pregunta al decididor por sí misma e imita a la que lo contradice.
-
Lo demostrable es indecidible. Sea un sistema que cumple las tres condiciones del primer teorema de incompletitud y además esta: siempre que se detiene con , la afirmación , que dice que se detiene, es demostrable en . (La demostración es la historia de cómputo, comprobada paso a paso.) Demuestren que el conjunto de las afirmaciones demostrables en es indecidible. Digan de qué problema a cuál va la reducción y dónde usan cada hipótesis.
-
La longitud de la máquina mínima. (a) En la demostración de que no es reconocible, ¿dónde se usa que es infinito? Den un subconjunto finito de y expliquen por qué es decidible. (b) Sea la longitud de la descripción más corta de una máquina que reconoce . Demuestren que no es computable.
-
Punto fijo. Sea una función computable que transforma descripciones de máquinas en descripciones de máquinas; piensen en un programa que modifica programas. Demuestren que existe una máquina tal que describe una máquina que reconoce el mismo lenguaje que . Es decir: toda transformación de programas deja sin cambiar el comportamiento de alguno. Sugerencia: obtiene su descripción, le aplica y simula el resultado.
-
✂️ Cotas para . Demuestren que existen constantes tales que, para toda cadena : (a) ; (b) ; (c) para todo , . (d) Demuestren que para todo hay una cadena de longitud con , sin mirar los apuntes. (e) ¿Por qué no se puede esperar con la codificación de pares de la definición? Digan qué información falta.
-
✂️ La incompletitud según Chaitin. Sea un sistema formal efectivo y correcto en el que se puede escribir, para cada cadena y cada número , la afirmación "". Demuestren que existe un número tal que no demuestra ninguna afirmación de la forma "", aunque sea verdadera para todas las cadenas salvo una cantidad finita. Sugerencia: una máquina que, con la entrada , busca entre las demostraciones de la primera que termine en una afirmación "" y escribe esa . ¿Cuánto mide su descripción?
-
✂️ Programar: otro compresor engañado. Agreguen a
gen_string.cppun cuarto tipo de cadena que salga de una regla de pocas líneas, sin usar<random>, y que ninguno de los tres compresores logre bajar de 900 000 bits con un millón de símbolos. Corranmake compress, digan cuál es la regla y den una cota superior de la complejidad de Kolmogorov de su cadena en función de .