
Apuntes · Capítulo 15Complejidad
Jerarquías, azar y lo que sigue abierto
Jerarquías, azar y lo que sigue abierto
La semana pasada terminó con una cadena de clases, cada una dentro de la siguiente:
Cada inclusión tiene su demostración, y todas son del mismo tipo: una simulación. Lo que no tenemos es lo contrario. Para ninguna de las cinco inclusiones hemos demostrado que sea estricta, es decir, que la clase de la derecha tenga algún lenguaje que la de la izquierda no tiene. Con lo que sabemos hasta hoy, las seis clases podrían ser la misma.
Eso no puede ser, y esta semana se demuestra. La herramienta es la más vieja del curso: la diagonalización de la semana 9, la que mostró que es indecidible. Ahora la diagonal lleva un reloj y una cinta medida, y el resultado son los teoremas de jerarquía: con más espacio, o con más tiempo, se decide estrictamente más. De ahí sale que y que . Son las únicas separaciones de la cadena que se conocen, y veremos también por qué esta técnica, sola, no puede dar las que faltan.
La segunda mitad agrega un recurso que hasta aquí no habíamos usado: el azar. Una máquina que lanza monedas puede comprobar si sin multiplicar las matrices, y equivocarse con una probabilidad tan pequeña como se quiera. Eso da una clase nueva, BPP, y la última pregunta del curso: si el azar permite resolver algo que sin él no se puede resolver en tiempo polinomial.
Esta es la última semana de clases. El capítulo cierra con lo que sigue abierto, con lo que queda fuera del curso, y con el mapa completo: de los lenguajes regulares a los que ninguna máquina reconoce, con un lenguaje que separa cada nivel y la técnica que lo demuestra.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Lo que la cadena no dice y La diagonal, otra vez. Antes de la sesión B, Máquinas que lanzan monedas. Con eso llegan con la pregunta de cada sesión y con la tabla de la diagonal recordada.
En clase: Sesión A, de Lo que la cadena no dice a Oráculos y los límites de la diagonalización. Sesión B, de Máquinas que lanzan monedas a El mapa completo del curso.
Después de clase: el Resumen y los Ejercicios. Antes del laboratorio, Verificar un producto sin multiplicar, Repetir para bajar el error y El código de la semana. Para preparar el examen final, El mapa completo del curso. La sección Oráculos y los límites de la diagonalización es opcional (✂️): se puede saltar sin perder el hilo.
Lectura. Sipser, sec. 9.1 (Hierarchy Theorems) y 9.2 (Relativization) para la sesión A, y sec. 10.2 (Probabilistic Algorithms) para la sesión B. Barak, capítulos 19 (Probabilistic computation) y 20 (Modeling randomized computation). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-15. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/freivalds.
Lo que la cadena no dice
Repasemos de dónde salió cada eslabón.
| Inclusión | Por qué vale | Semana |
|---|---|---|
| Una máquina determinista es una no determinista que nunca elige | 14 | |
| Una máquina de espacio logarítmico tiene una cantidad polinomial de configuraciones, y aceptar es alcanzar una de ellas en ese grafo | 14 | |
| Lo mismo que en la primera fila, ahora con tiempo | 12 | |
| Se prueban los certificados uno por uno, reutilizando el espacio | 14 | |
| Con espacio hay a lo sumo configuraciones, y una máquina que se detiene no repite ninguna | 14 |
Aquí es la clase de los lenguajes que se deciden en tiempo exponencial:
Las cinco filas tienen la misma forma: “lo que hace una máquina del primer tipo lo puede hacer una del segundo”. Ninguna dice “y la del segundo tipo hace algo que la del primero no puede”. Para afirmar eso hay que exhibir un lenguaje y demostrar que ninguna máquina del primer tipo lo decide. Es un enunciado sobre todas las máquinas posibles, también las que a nadie se le han ocurrido.
Ya hicimos algo así una vez. En la semana 9 demostramos que ninguna máquina de Turing decide . No revisamos las máquinas una por una: construimos una máquina que, puesta frente a cualquier otra, hace lo contrario que ella en al menos una entrada. Esta semana se repite la jugada, con una diferencia. Entonces bastaba con que fuera distinta de todas las máquinas. Ahora tiene que ser distinta de todas las máquinas que usan pocos recursos, y además tiene que usar ella misma una cantidad de recursos conocida. Si lo logramos, el lenguaje de queda en la clase grande y fuera de la pequeña.
Idea clave. Una inclusión se demuestra con una simulación: una máquina imita a otra. Una separación pide más: un lenguaje y un argumento sobre todas las máquinas de una clase. La única técnica del curso que produce un argumento así es la diagonalización.
La diagonal, otra vez
Recordemos el argumento en su forma más simple, sobre una lista finita y concreta. Tomemos seis máquinas que
siempre se detienen y las seis primeras cadenas binarias, en el orden de la semana 1. El programa
diagonal_demo arma la tabla de respuestas: una fila por máquina, una columna por cadena, A si acepta y R
si rechaza.
$ build/diagonal_demo
                         ε    0    1   00   01   10
M1: acepta todo         [A]   A    A    A    A    A
M2: no acepta nada       R   [R]   R    R    R    R
M3: longitud par         A    R   [R]   A    A    A
M4: termina en 1         R    R    A   [R]   A    R
M5: contiene un 0        R    A    R    A   [A]   A
M6: empieza con 1        R    R    A    R    R   [A]
D: lo contrario          R    A    A    A    R    R

D y M1 responden distinto con la cadena ε.
D y M2 responden distinto con la cadena 0.
D y M3 responden distinto con la cadena 1.
D y M4 responden distinto con la cadena 00.
D y M5 responden distinto con la cadena 01.
D y M6 responden distinto con la cadena 10.
Las casillas entre corchetes son la diagonal: lo que la máquina responde con la cadena . La última fila se arma cambiando cada casilla de la diagonal. Esa fila no puede ser igual a ninguna de las seis, porque difiere de la fila justo en la columna . No hizo falta saber qué hace cada máquina: solo poder preguntarle.
En la semana 9 la lista era infinita, la de todas las máquinas de Turing, y la cadena número era la descripción de la máquina número . El argumento era el mismo, y tenía un precio que conviene mirar con cuidado, porque es todo el tema de hoy:
Para llenar su fila, tiene que averiguar qué responde cada máquina. Es decir, tiene que simularla.
En la semana 9 eso era un problema sin salida: la máquina simulada podía no detenerse, y por eso el argumento terminaba en una contradicción y no en una máquina de verdad. Hoy las máquinas de la lista tienen un límite de recursos. Una máquina que usa a lo sumo celdas se puede simular hasta el final con un poco más de celdas. Entonces sí existe, y lo que el argumento entrega ya no es una contradicción: es un lenguaje que decide con sus recursos y que ninguna máquina más pobre decide.
Quedan tres detalles por resolver, y cada uno deja una marca en el enunciado del teorema.
- tiene que saber cuánto es para ponerse el límite, y calcularlo no puede costarle más que el propio límite. Eso es pedir que sea construible.
- Simular cuesta un poco más que lo simulado. Por eso el teorema separa de , y no de .
- “Poco espacio” es una promesa para entradas grandes. Para que se enfrente a cada máquina con una entrada lo bastante grande, cada máquina tiene que aparecer en la lista muchas veces. Eso se resuelve con un relleno.
Funciones construibles
Antes de los teoremas, dos convenciones.
El modelo. El espacio se mide como en la semana 14, con una cinta de entrada de solo lectura y una cinta de trabajo, y solo cuenta la cinta de trabajo. Así tienen sentido las cotas menores que . Todas las funciones de esta sección cumplen .
La notación . Decimos que si crece estrictamente más lento que : para toda constante existe un tal que para todo . Es más fuerte que , que solo pide alguna constante. Por ejemplo, y , pero no es .
Una función , con , es construible en espacio (space constructible) si alguna máquina de Turing, con la entrada , escribe en binario usando espacio .
En palabras: se puede averiguar cuánto espacio es sin gastar más que eso. Todas las funciones que uno escribe al medir un algoritmo lo son: , , , , , . Para , por ejemplo, la máquina cuenta los unos de la entrada en binario, que ocupa celdas, y multiplica ese número por sí mismo, que ocupa otras .
¿Por qué hace falta la condición? Porque la máquina va a empezar marcando celdas de su cinta, para no pasarse de ahí. Si calcular exigiera más espacio que , la propia ya no cabría en la clase donde queremos ponerla. Y sin la condición el teorema es falso: existen funciones raras, que no son construibles, para las que dar más espacio no agrega ningún lenguaje. No las veremos; alcanza con saber que la hipótesis no es un adorno.
Para el tiempo la definición es la misma, cambiando el recurso. Una función , con , es construible en tiempo (time constructible) si alguna máquina, con la entrada , escribe en binario en tiempo .
El teorema de jerarquía de espacio
Teorema (jerarquía de espacio). Para toda función construible en espacio existe un lenguaje que se decide en espacio y que no se decide en espacio .
Con más espacio se decide estrictamente más, y basta con muy poco más: cualquier cantidad que no sea un múltiplo constante.
El primer intento, y dónde falla
Copiemos la semana 9 sin pensar. Sea la máquina que, con la entrada , simula a con la entrada usando a lo sumo celdas, y responde lo contrario. Si la simulación quiere más celdas, rechaza.
Esta usa espacio , y eso está bien. El problema aparece al comparar. Supongamos que una máquina decide el lenguaje de en espacio , y démosle a la entrada . Quisiéramos decir: ” simula a hasta el final y responde lo contrario, contradicción”. Fallan dos cosas.
- La simulación puede no caber. Que dice que es menor que para grande. Para la longitud concreta de no dice nada. Y ni siquiera simula con celdas: usa algunas más, como veremos. Si no cabe, rechaza sin haber terminado la simulación, y que también rechace no contradice nada.
- podría no detenerse. A le llega la descripción de cualquier máquina, también de una que entra en un ciclo sin salir de sus primeras tres celdas. El límite de espacio no la detiene nunca, y tiene que detenerse siempre: si no, no decide ningún lenguaje.
Cada falla tiene su arreglo.
La máquina D
D = "Con la entrada w:
  1. Sea n la longitud de w.
  2. Calcular f(n) y marcar f(n) celdas de la cinta de trabajo.
     Si alguna etapa posterior intenta salir de las celdas marcadas, rechazar.
  3. Si w no tiene la forma ⟨M⟩10* para alguna máquina de Turing M, rechazar.
  4. Simular M con la entrada w, contando los pasos de M.
     Si la cuenta pasa de 2^(2·f(n)), rechazar.
  5. Si M aceptó, rechazar. Si M rechazó, aceptar."
La descripción es de alto nivel, como todas desde la semana 9. Sea . Veamos las piezas.
Etapa 2: el límite. Se puede calcular dentro de espacio porque es construible. Desde ahí, trabaja dentro de las celdas marcadas.
Etapa 3: el relleno. La entrada es la descripción de una máquina, seguida de un y de cualquier cantidad de ceros: . El marca dónde termina la descripción, y los ceros solo alargan la entrada. Así cada máquina tiene infinitas entradas que “hablan de ella”, de todas las longitudes a partir de cierto punto. Noten que en la etapa 4 se simula a con la entrada completa, con relleno y todo: lo que importa es que y respondan distinto con una misma cadena.
Etapa 4: la simulación y el contador. tiene un alfabeto de cinta fijo, y puede tener cualquiera. Para simular, escribe cada símbolo de con un bloque de celdas, y guarda aparte el estado de y la posición de sus cabezales. Si usa celdas, usa , donde es una constante que depende de (de cuántos símbolos y estados tiene) y no de . Este es el “poco más” que cuesta simular.
El contador de pasos ocupa bits, así que también cabe en espacio . Se guarda en una zona propia de la cinta, fuera de las celdas de la simulación.
Etapa 5: lo contrario. Si la simulación terminó, invierte la respuesta.
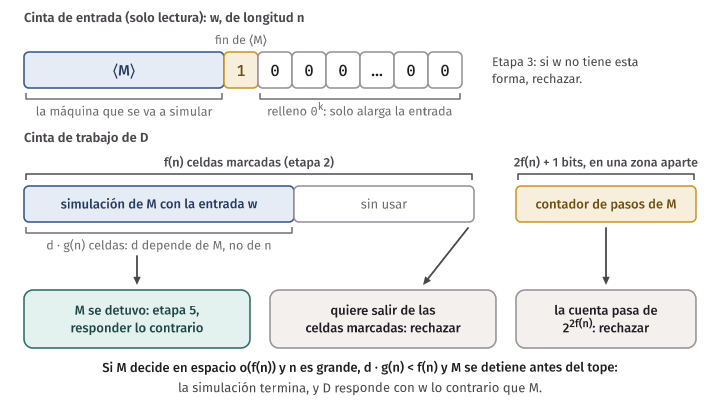
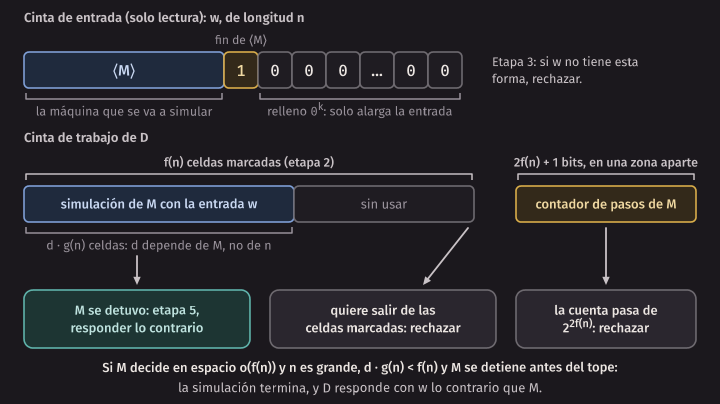
Por qué el contador
¿De dónde sale el número ? De contar configuraciones, como en la semana 14. Una configuración de es su estado, la posición del cabezal de entrada, la posición del cabezal de trabajo y el contenido de la cinta de trabajo. Si usa a lo sumo celdas de trabajo, con un alfabeto de cinta y un conjunto de estados , la cantidad de configuraciones distintas es a lo sumo
Una máquina determinista que se detiene no repite ninguna configuración: si repitiera una, repetiría también todo lo que vino después, para siempre. Entonces, si se detiene, lo hace en a lo sumo esa cantidad de pasos.
Ahora supongamos que . El factor es a lo sumo , porque . El resto, , es a lo sumo para alguna constante que depende de , y cuando es grande. En total:
Así que el contador cumple dos funciones a la vez, y hay que comprobar las dos:
- Corta a las máquinas que no se detienen. Pase lo que pase, la etapa 4 termina en a lo sumo pasos simulados. se detiene con toda entrada.
- No corta a las máquinas que importan. Una máquina que decide un lenguaje en espacio se detiene, con las entradas grandes, antes de que el contador llegue al tope.
Error común. Creer que el límite de espacio ya garantiza que la simulación termina. Una máquina puede dar vueltas para siempre dentro de dos celdas. El espacio acotado limita cuántas configuraciones distintas hay, y de ahí sale un límite de tiempo para las máquinas que se detienen. A las que no se detienen hay que cortarlas contando pasos.
La demostración
Demostración del teorema. Por diagonalización. Hay que probar dos cosas: que se decide en espacio , y que ninguna máquina lo decide en espacio .
decide en espacio . La etapa 2 usa espacio porque es construible. La etapa 3 solo recorre la entrada. La etapa 4 trabaja dentro de las celdas marcadas, más el contador, que ocupa celdas. Y se detiene siempre: las etapas 2 y 3 terminan, y la etapa 4 termina porque el contador tiene un tope. Entonces es un decididor y usa espacio .
Ninguna máquina decide en espacio . Por contradicción. Supongamos que una máquina decide usando espacio , con . Sea la constante con la que simula a . Como , existe un tal que para todo pasan dos cosas:
La primera es la definición de con la constante . La segunda es la cuenta de configuraciones de la sección anterior, y usa que , por ser un decididor, se detiene.
Tomemos ahora la entrada . Su longitud es mayor que . Sigamos a con esa entrada. Pasa la etapa 3, porque tiene la forma pedida. En la etapa 4 simula a con la entrada : la simulación necesita celdas, así que no sale de las marcadas, y se detiene antes de que el contador llegue al tope. La simulación termina, entonces, con la respuesta de . Y en la etapa 5, responde lo contrario:
Pero decide , así que acepta exactamente cuando acepta . Las dos cosas no pueden ser ciertas a la vez. La contradicción muestra que tal no existe. ∎
Vale la pena comparar con la semana 9, pieza por pieza.
| Semana 9: es indecidible | Hoy: jerarquía de espacio | |
|---|---|---|
| La lista | Todas las máquinas de Turing | Las máquinas que usan espacio |
| La casilla de la diagonal | con la entrada | con la entrada , con grande |
| Cómo averigua la respuesta | Con un decididor que se supone que existe | Simulando, con un límite de celdas y un contador de pasos |
| ¿ existe? | No: de ahí la contradicción con | Sí: es una máquina concreta |
| Qué se concluye | Ninguna máquina decide | está en una clase y no en la otra |
Lo que se agrega es el límite de recursos, y con él tres cosas: la función construible para fijar el límite, el relleno para que la entrada sea lo bastante grande, y el contador para que se detenga.
Un número para el relleno
Para ver que el relleno hace falta, pongamos números. Sea , y sea una máquina que usa espacio , que es . Supongamos que simularla le cuesta a el triple, . La simulación cabe en las celdas marcadas cuando
Si la descripción tiene, digamos, 500 símbolos, con la entrada la simulación necesitaría celdas y solo tiene 500. rechaza por falta de espacio, sin saber qué habría respondido . Con la entrada , en cambio, la simulación cabe, y ahí y quedan enfrentadas. A cada máquina le llega su turno con alguna entrada lo bastante larga, y una sola entrada en la que difieran alcanza.
Lo que el teorema da de inmediato
Corolario. Si y es construible en espacio, entonces .
Demostración. La inclusión vale porque . Es estricta porque el lenguaje del teorema, con , está en y no se decide en espacio . Toda función que es es , así que no está en . ∎
En particular:
Dentro de PSPACE hay una escalera infinita, y cada escalón tiene lenguajes que el anterior no tiene.
El teorema de jerarquía de tiempo
Teorema (jerarquía de tiempo). Para toda función construible en tiempo existe un lenguaje que se decide en tiempo y que no se decide en tiempo .
El enunciado es casi el de espacio, con un factor logarítmico de diferencia: aquí no alcanza con “cualquier cantidad que no sea un múltiplo constante”. Hace falta ganarle a la otra máquina por algo más que un factor . El tiempo se mide como en la semana 12, en máquinas de una cinta.
No haremos la demostración completa. La idea es la de la sección anterior, y lo que interesa es entender de dónde sale el logaritmo.
D = "Con la entrada w:
  1. Sea n la longitud de w.
  2. Calcular t(n) y guardar en un contador binario el número t(n) / log t(n), redondeado hacia arriba.
  3. Si w no tiene la forma ⟨M⟩10* para alguna máquina de Turing M, rechazar.
  4. Simular M con la entrada w. Antes de cada paso propio dedicado a la simulación, restar 1
     al contador. Si el contador llega a 0, rechazar.
  5. Si M aceptó, rechazar. Si M rechazó, aceptar."
Es la misma máquina, con una sola guarda en vez de dos: aquí el contador de pasos es el límite de recursos. Lo nuevo es lo que cuesta llevarlo.
- En el teorema de espacio, el contador ocupaba celdas, y las celdas se reutilizan: actualizarlo un millón de veces no gasta más espacio que actualizarlo una. Por eso el teorema de espacio no pierde nada.
- En el teorema de tiempo, cada actualización del contador es tiempo que se va. El contador tiene unos bits, y restarle 1 cuesta pasos. Además, en una máquina de una cinta el contador no puede quedarse en un extremo mientras el cabezal trabaja lejos: ir y volver costaría muchísimo más. La solución es llevarlo consigo, escrito en una pista paralela de la cinta, y moverlo junto con el cabezal simulado. Lo mismo se hace con el estado de y su tabla de transiciones.
Con ese cuidado, simular un paso de le cuesta a una cantidad constante de pasos propios, donde depende de y no de , como antes. El contador cuenta esos pasos propios de , y cada uno viene acompañado de pasos más para actualizar el contador. Como el contador empieza en , la etapa 4 gasta en total
Así corre en tiempo , sea cual sea la máquina que le toque simular. Y si termina en pasos, simularla completa pide pasos propios, que para grande es menos que : el contador no la corta. El resto del argumento es el de espacio: el relleno, la entrada larga, la contradicción.
Idea clave. El factor es el costo del reloj. En espacio, llevar la cuenta es gratis porque el espacio se reutiliza. En tiempo, mirar el reloj en cada paso cuesta tiempo. El factor sale de cómo se hace la simulación en este modelo, y no de que haga falta tanta ventaja para poder decidir más.
Corolario. Si y es construible en tiempo, entonces .
La demostración es la misma del corolario de espacio. Por ejemplo, , así que:
También dentro de P hay una escalera infinita. Para cada existe un lenguaje que se decide en tiempo y no en tiempo .
Error común. Leer el teorema de jerarquía como “con más tiempo todo problema se resuelve mejor”. El teorema dice que existe algún lenguaje al que más tiempo le sirve: el lenguaje , construido a propósito con la diagonal. No dice nada de un problema que a ustedes les interese. El lenguaje se decide en tiempo , y darle tiempo no cambia nada. Y que SAT se pueda decidir en tiempo no implica que necesite tanto: para saber eso habría que resolver P frente a NP. Los teoremas de jerarquía separan clases. Decir cuánto cuesta un problema concreto es otra tarea, casi siempre más difícil.
Lo que se sabe distinto: las consecuencias
Con los dos teoremas y el teorema de Savitch de la semana 14 salen todas las separaciones conocidas de la cadena.
Teorema. .
Demostración. La función es construible en tiempo. Por el teorema de jerarquía de tiempo existe un lenguaje que se decide en tiempo y no se decide en tiempo .
está en EXPTIME, porque .
no está en P. Si estuviera, se decidiría en tiempo para algún . Pero para todo , porque una exponencial crece más rápido que cualquier polinomio. Entonces se decidiría en tiempo , y eso contradice lo que sabemos de . ∎
Teorema. , y por lo tanto .
Demostración. Son tres pasos:
El primero es el teorema de Savitch, , con : el teorema vale también para cotas menores que , desde , con la cinta de entrada de solo lectura. El segundo es el corolario de la jerarquía de espacio: , y es construible en espacio. El tercero es la definición de PSPACE. Como en medio hay una inclusión estricta, NL no es todo PSPACE.
Para L: como , si L fuera igual a PSPACE también lo sería NL. ∎
Aquí Savitch es indispensable. El teorema de jerarquía solo compara clases deterministas entre sí. Para decir algo de NL, que es no determinista, primero hay que meterla en una clase determinista, y eso es lo que hace Savitch.
La cadena, par por par
En la cadena hay seis clases y, por lo tanto, 15 pares. Esto es todo lo que se sabe.
| NL | P | NP | PSPACE | EXPTIME | |
|---|---|---|---|---|---|
| L | ? | ? | ? | ||
| NL | ? | ? | |||
| P | ? | ? | |||
| NP | ? | ? | |||
| PSPACE | ? |
Cinco pares son distintos con seguridad:
- y , por el teorema de arriba.
- , por el teorema de arriba.
- y , porque y P ya es distinta de EXPTIME.
De los otros diez no se sabe nada, y ahí están todas las preguntas famosas: L frente a NL, P frente a NP, NP frente a PSPACE. Tampoco se sabe si NP es distinta de EXPTIME.
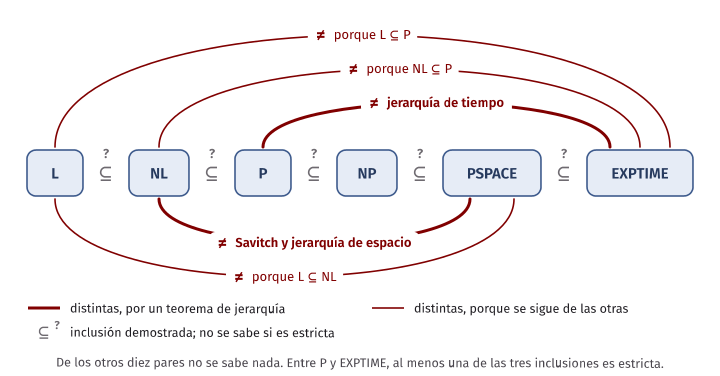
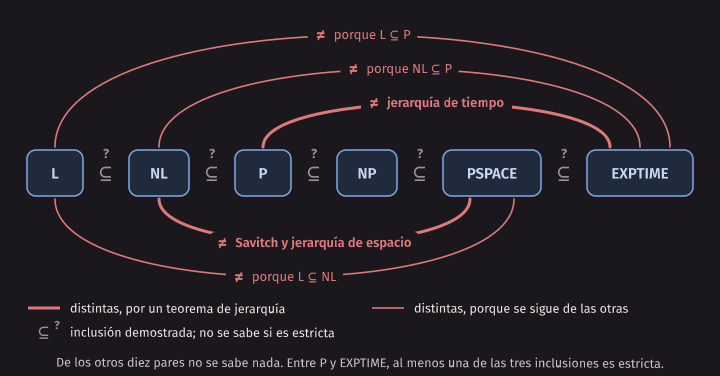
Aun así, las separaciones conocidas dicen algo sobre las desconocidas:
- En , los extremos son distintos. Entonces al menos una de las tres inclusiones es estricta. No se sabe cuál. Se cree que las tres.
- En pasa lo mismo: al menos una es estricta.
Es una situación curiosa. Hay un teorema que dice “alguna de estas tres afirmaciones es verdadera”, y para ninguna de las tres hay una demostración.
Un problema que no está en P, por teorema
Hasta hoy, cada vez que dijimos que un problema “no tiene algoritmo polinomial” fue con un “se cree”: los problemas NP-completos no están en P si . Con el teorema de jerarquía hay problemas que no están en P sin ningún “si”.
El primero es el lenguaje de la demostración, que es artificial. Uno más natural es la versión con reloj del problema de aceptación:
donde es una máquina de Turing determinista y está escrito en binario.
Afirmación. es decidible y no está en P.
Demostración. Es decidible: se simula a con durante pasos. Como la simulación tiene un tope, siempre termina. Cuesta un tiempo polinomial en y en el tamaño de . Pero está en binario: si la entrada tiene longitud , puede valer hasta . El algoritmo corre en tiempo , así que el lenguaje está en EXPTIME.
No está en P, por reducción. Mostramos que todo lenguaje de EXPTIME se reduce en tiempo polinomial a . La dirección es esa porque queremos concluir que es al menos tan difícil como cualquier lenguaje de EXPTIME. Sea un lenguaje de EXPTIME, y sea una máquina que lo decide en a lo sumo pasos, para alguna constante . La reducción es
Se calcula en tiempo polinomial: es fija, y el número en binario es un seguido de ceros. Y si y solo si acepta dentro de su tiempo, es decir, si y solo si .
Si estuviera en P, todo lenguaje de EXPTIME estaría en P: se calcula y se decide. Tendríamos , contra el teorema . ∎
El detalle del binario es el mismo de la semana 12. Con en unario, el mismo problema está en P: simular pasos es polinomial en la longitud de la entrada, que ya incluye símbolos.
La demostración muestra algo más: es EXPTIME-completo, en el mismo sentido en que SAT es NP-completo. Hay otros problemas EXPTIME-completos que no hablan de máquinas. Los más conocidos son juegos: decidir quién gana desde una posición dada del ajedrez o de las damas, generalizados a un tablero de , es EXPTIME-completo. No lo demostraremos. La consecuencia sí cabe en una línea: ninguno de esos problemas tiene un algoritmo polinomial, y eso es un teorema, sin conjetura de por medio.
En la práctica. Para un tablero de tamaño fijo, como el de , todo esto no dice nada: hay una cantidad finita de posiciones, y un problema con una cantidad finita de entradas se decide en tiempo constante, con una tabla. La complejidad habla de cómo crece el costo con el tamaño. Que un programa juegue bien al ajedrez de verdad es un asunto de ingeniería, no de clases de complejidad.
Oráculos y los límites de la diagonalización
Sección opcional (✂️).
La diagonalización separó P de EXPTIME. La pregunta natural es por qué no separa P de NP. No es por falta de intentos, y hay un resultado que explica qué es lo que falla. Para enunciarlo hace falta un tipo nuevo de máquina.
Máquinas con oráculo
Un oráculo (oracle) para un lenguaje es un dispositivo que responde, en un solo paso, si una cadena está en . Una máquina de Turing con oráculo es una máquina de Turing con una cinta adicional, la cinta de consulta. Cuando la máquina escribe una cadena en esa cinta y entra en un estado especial, en el paso siguiente recibe la respuesta: sí, si ; no, si . Escribir la consulta cuesta lo que cuesta escribirla. La respuesta es gratis, sea fácil, difícil o indecidible.
En términos de programación, es un programa que puede llamar a una función en_A(q) que alguien más
implementó, y cuyo costo no se le cobra.
Con eso se definen las clases relativas a :
- : los lenguajes que decide una máquina determinista de tiempo polinomial con oráculo .
- : lo mismo con una máquina no determinista.
Siempre vale , por la razón de siempre. Con un oráculo trivial, como , se recuperan P y NP.
Dos oráculos que responden distinto
Teorema. Existe un oráculo con , y existe un oráculo con .
El oráculo . Sea , el problema PSPACE-completo de la semana 14. Entonces:
La primera inclusión: una máquina no determinista de tiempo polinomial con oráculo TQBF se simula sin oráculo en espacio polinomial, calculando la respuesta de cada consulta con el algoritmo de espacio polinomial para TQBF. Las consultas tienen longitud polinomial, porque la máquina tuvo que escribirlas. La igualdad es Savitch. La última inclusión: como TQBF es PSPACE-completo, todo lenguaje de PSPACE se decide reduciéndolo a TQBF en tiempo polinomial y haciendo una sola consulta. Junto con , las dos clases son iguales.
La intuición: el oráculo es tan poderoso que hace por su cuenta todo lo que el no determinismo podría agregar.
El oráculo , la idea. Para cualquier lenguaje , consideren
está en sea cual sea : la máquina adivina una cadena de longitud y le pregunta al oráculo si está. Una máquina determinista, en cambio, tendría que buscar entre cadenas, y en tiempo polinomial solo puede preguntar por una cantidad polinomial. Hay que construir de modo que ninguna búsqueda corta funcione.
Se construye por etapas, con una diagonal. Se listan las máquinas deterministas con oráculo de tiempo polinomial, , de modo que dé a lo sumo pasos. Se puede: a cada máquina se le agrega un reloj, y cada una aparece en la lista infinitas veces, con relojes cada vez mayores. En la etapa se elige un mayor que todas las longitudes tocadas en las etapas anteriores, y tal que . Se corre con la entrada . Cuando pregunta por una cadena cuyo destino ya está decidido, se le responde eso; cuando pregunta por una nueva, se le responde que no, y esa cadena queda fuera de para siempre. Como hace menos de consultas, queda alguna cadena de longitud por la que no preguntó. Ahora se mira la respuesta de :
- Si aceptó , ninguna cadena de longitud entra en . Entonces , y se equivocó.
- Si rechazó, se pone en una cadena de longitud por la que no preguntó. Entonces , y se equivocó. Su ejecución no cambia, porque nunca consultó esa cadena.
Al final, cada falla con alguna entrada. no está en y sí en .
Qué significa: la relativización
Miren otra vez la demostración del teorema de jerarquía. La máquina trata a como una caja: la simula paso a paso y mira la respuesta. Si les damos a todas las máquinas el mismo oráculo , la demostración sigue funcionando sin cambiar una palabra: cuando hace una consulta, hace la misma consulta a su propio oráculo y le pasa la respuesta. Lo mismo pasa con las simulaciones que dieron .
Se dice que una demostración así relativiza (relativization): vale igual en un mundo donde todas las máquinas tienen acceso al mismo oráculo, cualquiera que sea.
Ahora el argumento, que es corto.
- Si una demostración que relativiza probara que , probaría también que para todo oráculo . Eso es falso para .
- Si una demostración que relativiza probara que , probaría también que para todo oráculo . Eso es falso para el de arriba.
Conclusión. Ninguna demostración que relativice puede resolver P frente a NP, en ninguno de los dos sentidos. En particular, no alcanza con simular y diagonalizar tratando a las máquinas como cajas.
Hay que leer esto con cuidado, porque se exagera con facilidad.
- No dice que P frente a NP no se pueda resolver. Dice qué tipo de demostración no sirve.
- No dice que la diagonalización sea inútil en complejidad: acabamos de usarla. Dice que, para esta pregunta, hace falta además algún ingrediente que mire dentro del cómputo, que use cómo funciona un paso de una máquina y no solo lo que responde.
- Esos ingredientes existen. La demostración de Cook-Levin mira dentro: describe cada paso con ventanas del tableau. Y el teorema , que aparece más abajo, es un resultado que no relativiza. Para P frente a NP, hasta hoy, ninguna técnica conocida alcanza.
Máquinas que lanzan monedas
Hasta aquí una máquina tenía dos maneras de avanzar. La determinista da un paso fijo. La no determinista tiene varias opciones y acepta si alguna rama acepta; es una definición, y ninguna computadora funciona así. Ahora viene una tercera, que sí se puede construir: la máquina que, cuando tiene dos opciones, lanza una moneda.
Una máquina de Turing probabilística es una máquina de Turing no determinista en la que cada paso tiene una o dos opciones. Cuando hay dos, se elige una con una moneda justa: probabilidad cada una, y cada lanzamiento es independiente de los anteriores. Una rama de la ejecución en la que se lanzaron monedas tiene probabilidad . La probabilidad de que la máquina acepte es la suma de las probabilidades de las ramas que aceptan.
Es el mismo árbol de ejecuciones de la semana 2 y de la semana 12, y lo que cambia es la pregunta que se le hace:
| Máquina | Acepta si… |
|---|---|
| No determinista | alguna rama acepta |
| Probabilística | la mayor parte de las ramas acepta, medida por su probabilidad |
Hay otra manera de decir lo mismo, que es la que se programa. Un algoritmo probabilístico es un algoritmo determinista que recibe, además de la entrada , una cadena de bits al azar. Compárenlo con el verificador de la semana 12, que recibía y un certificado : en NP se pregunta si existe una cadena que haga aceptar; aquí se pregunta qué fracción de las cadenas hace aceptar.
De probabilidad solo usaremos lo elemental:
- Si un experimento tiene resultados igualmente probables y un evento ocurre en de ellos, su probabilidad es .
- Si dos eventos son independientes, la probabilidad de que ocurran los dos es el producto de sus probabilidades. Dos ejecuciones de un algoritmo con monedas distintas son independientes.
No hace falta más. En particular, no usaremos esperanzas ni varianzas.
Error común. Confundir el azar del algoritmo con el azar de la entrada. Aquí la entrada no es al azar: es la que sea, también la peor. Lo único aleatorio son las monedas del algoritmo. Cuando digamos “se equivoca con probabilidad a lo sumo ”, será para toda entrada, y la probabilidad se calcula sobre las monedas. No hay entradas “con mala suerte” en las que el algoritmo falle siempre.
Verificar un producto sin multiplicar
El problema: dadas tres matrices , y de , ¿es cierto que ?
La manera obvia es calcular y comparar. Con la definición del producto son multiplicaciones. Los mejores algoritmos conocidos para multiplicar matrices bajan el exponente hasta un poco menos de , pero son tan complicados que no se usan, y nadie sabe multiplicar en tiempo . Leer las tres matrices ya cuesta , así que es lo mejor que se puede esperar. ¿Se puede comprobar un producto más rápido de lo que se sabe calcularlo?
El algoritmo de Freivalds
La idea es no comparar las matrices, sino lo que le hacen a un vector. Si , entonces para cualquier vector vale . Y multiplicar una matriz por un vector cuesta solo .
algoritmo freivalds(A, B, C)
    r ← un vector de n bits, cada uno 0 o 1 con una moneda independiente
    x ← B · r
    y ← A · x
    z ← C · r
    si y = z entonces
        devolver "iguales"
    sino
        devolver "distintos"
    fin si
fin algoritmo
Son tres productos de matriz por vector: multiplicaciones. La clave está en el orden: se calcula primero , que es un vector, y después por ese vector. Nunca se calcula .
¿Qué puede salir mal?
- Si , entonces para todo . El algoritmo responde “iguales” siempre. Aquí no se equivoca nunca.
- Si , puede pasar que justo el vector elegido no note la diferencia y dé . Entonces responde “iguales”, y se equivoca.
El error solo es posible de un lado. Cuando el algoritmo responde “distintos” tiene una prueba en la mano: un vector con . Esa respuesta es segura.
Un ejemplo, con todos los vectores
Con hay solo vectores, y se pueden probar todos. El programa freivalds_demo toma dos
matrices pequeñas y tres matrices incorrectas.
$ build/freivalds_demo
A   =   1   2   0
        0   1   3
        2   0   1
B   =   2   1   0
        1   0   2
        0   3   1
A·B =   4   1   4
        1   9   5
        4   5   1

C1: igual a A·B salvo la entrada (2, 3), que vale 6 en vez de 5.
  r           B·r            A·(B·r)         C·r             ¿detecta?
  (0, 0, 0)   (0, 0, 0)      (0, 0, 0)       (0, 0, 0)       no
  (0, 0, 1)   (0, 2, 1)      (4, 5, 1)       (4, 6, 1)       sí
  (0, 1, 0)   (1, 0, 3)      (1, 9, 5)       (1, 9, 5)       no
  (0, 1, 1)   (1, 2, 4)      (5, 14, 6)      (5, 15, 6)      sí
  (1, 0, 0)   (2, 1, 0)      (4, 1, 4)       (4, 1, 4)       no
  (1, 0, 1)   (2, 3, 1)      (8, 6, 5)       (8, 7, 5)       sí
  (1, 1, 0)   (3, 1, 3)      (5, 10, 9)      (5, 10, 9)      no
  (1, 1, 1)   (3, 3, 4)      (9, 15, 10)     (9, 16, 10)     sí
  Detectan la diferencia 4 de 8 vectores.
Sigan una fila a mano. Con , el vector es la suma de la segunda y la tercera columna de : . Después . Y es la suma de la segunda y la tercera columna de : . Difieren en la segunda coordenada, y la diferencia queda detectada.
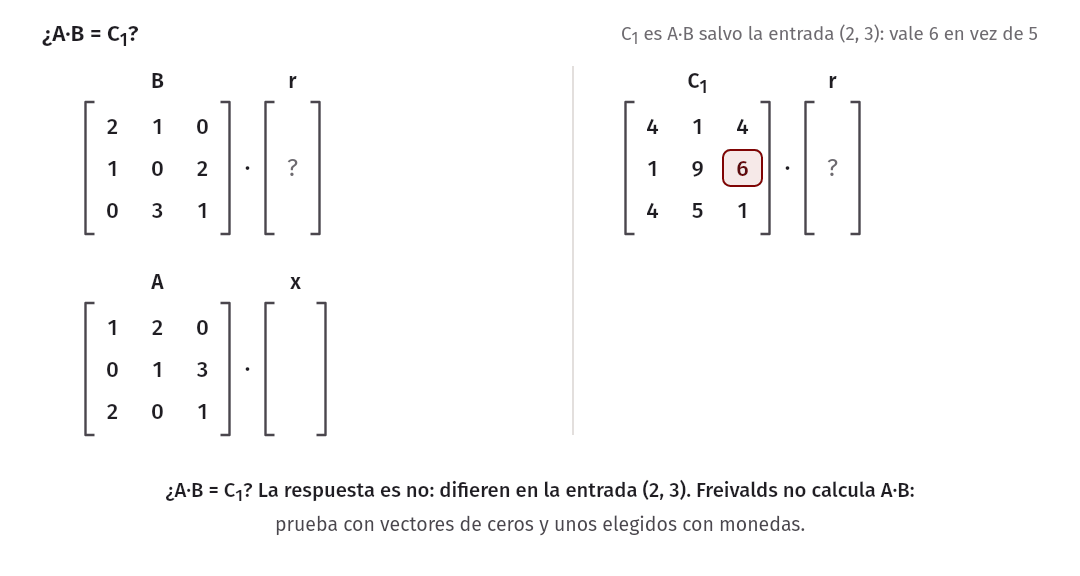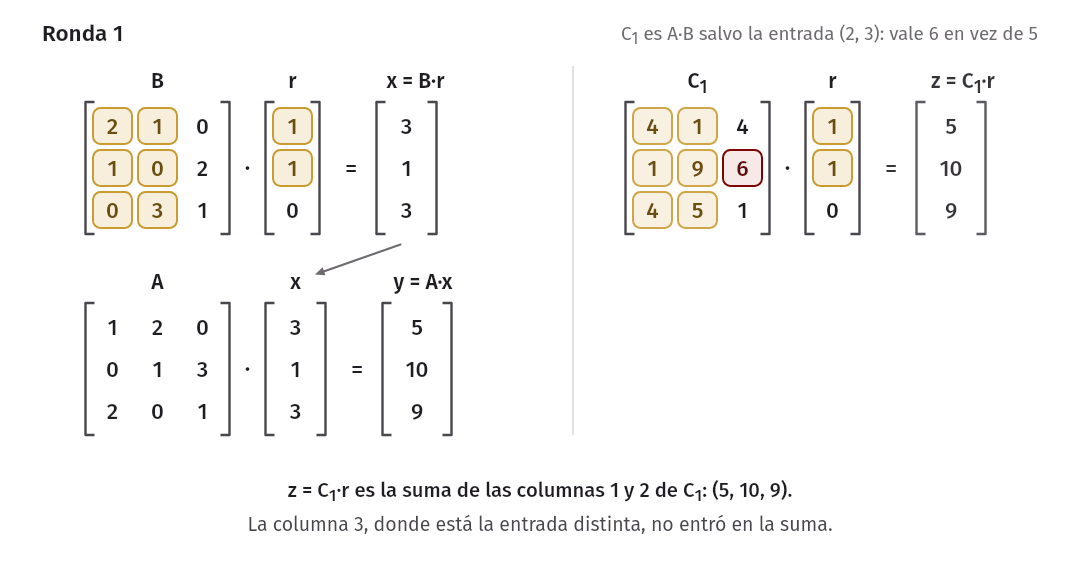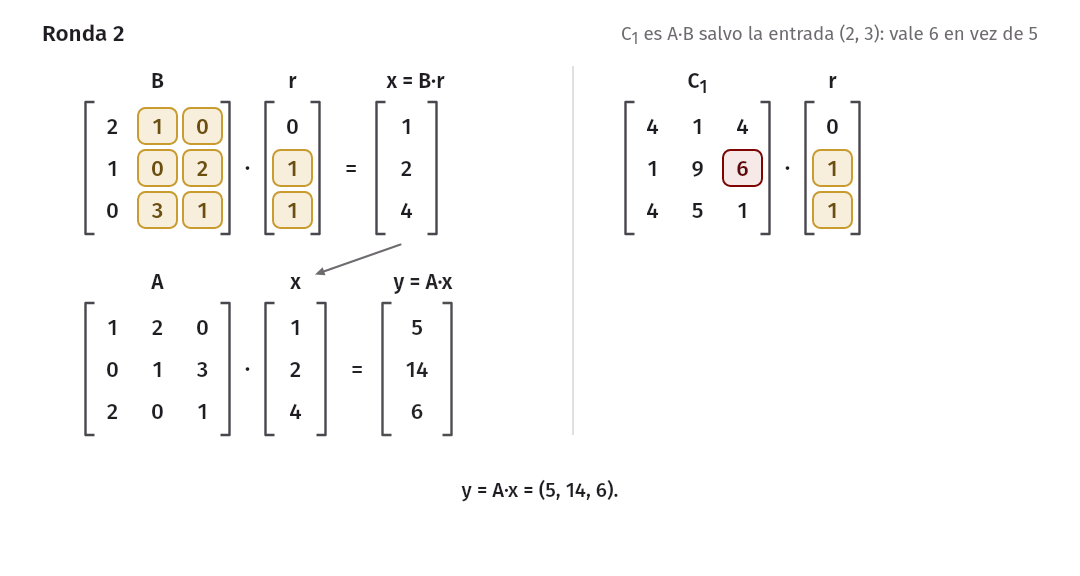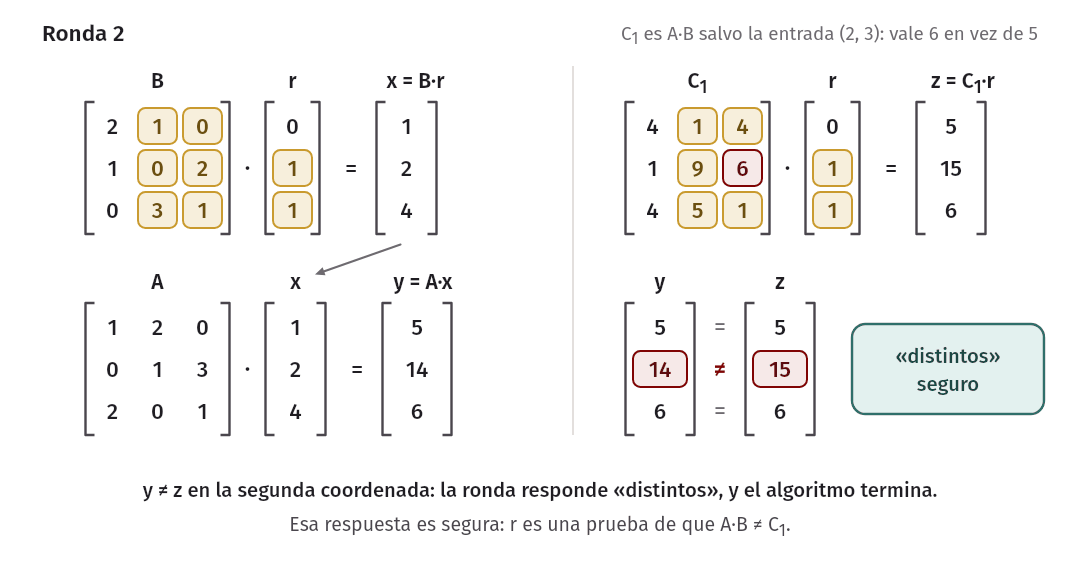
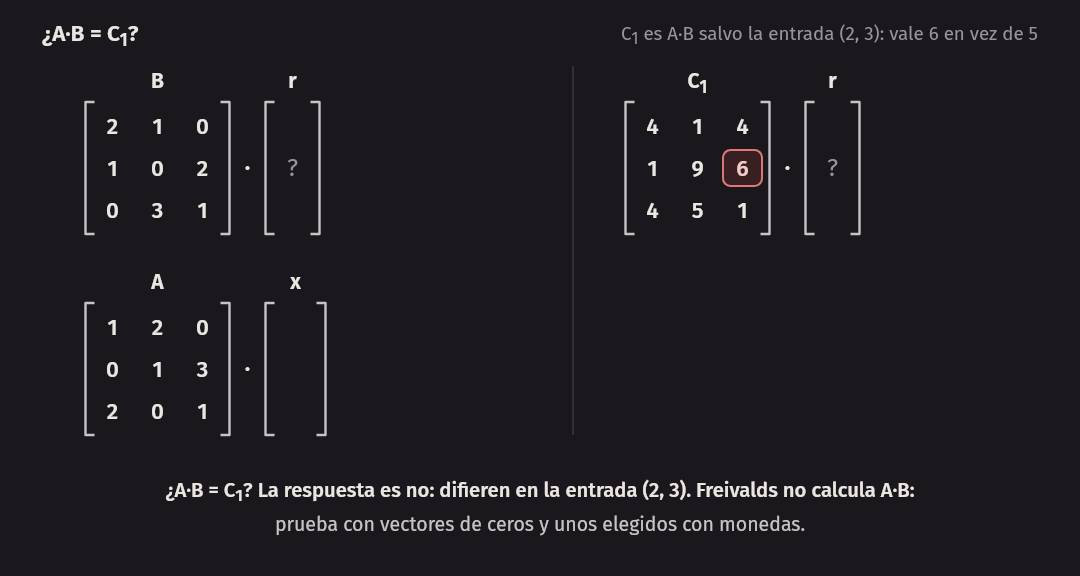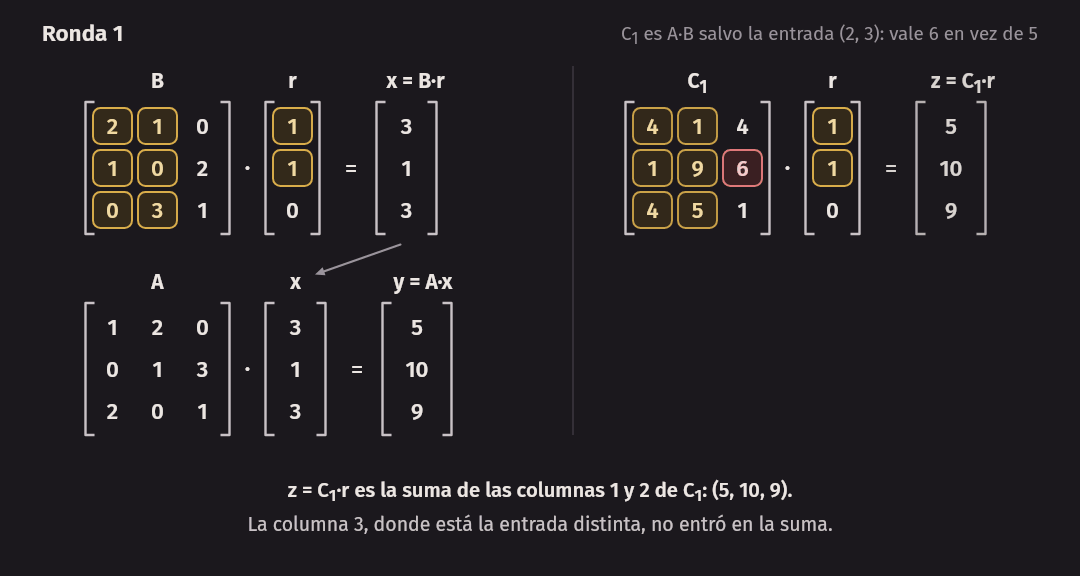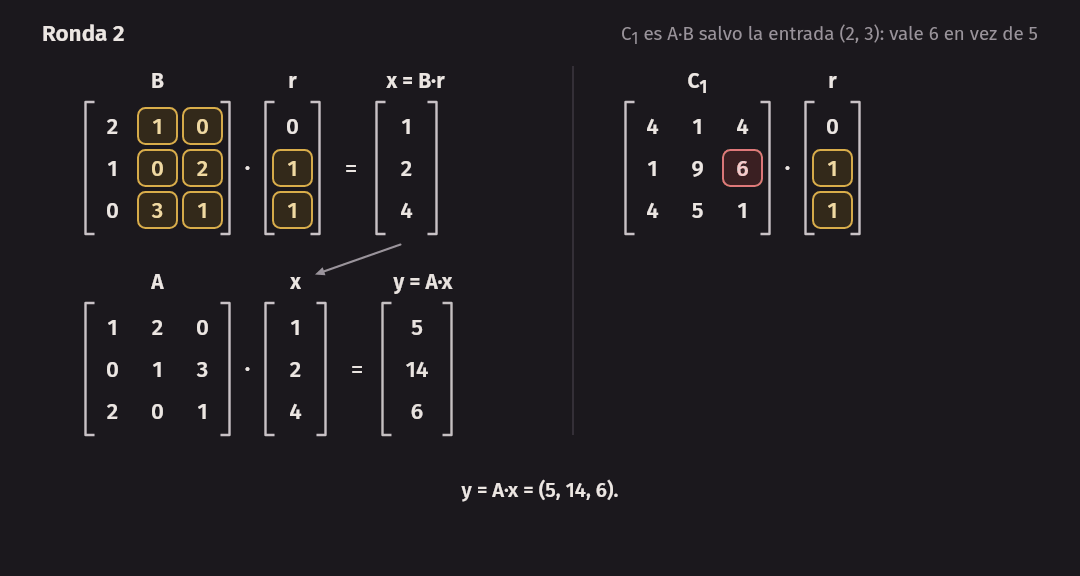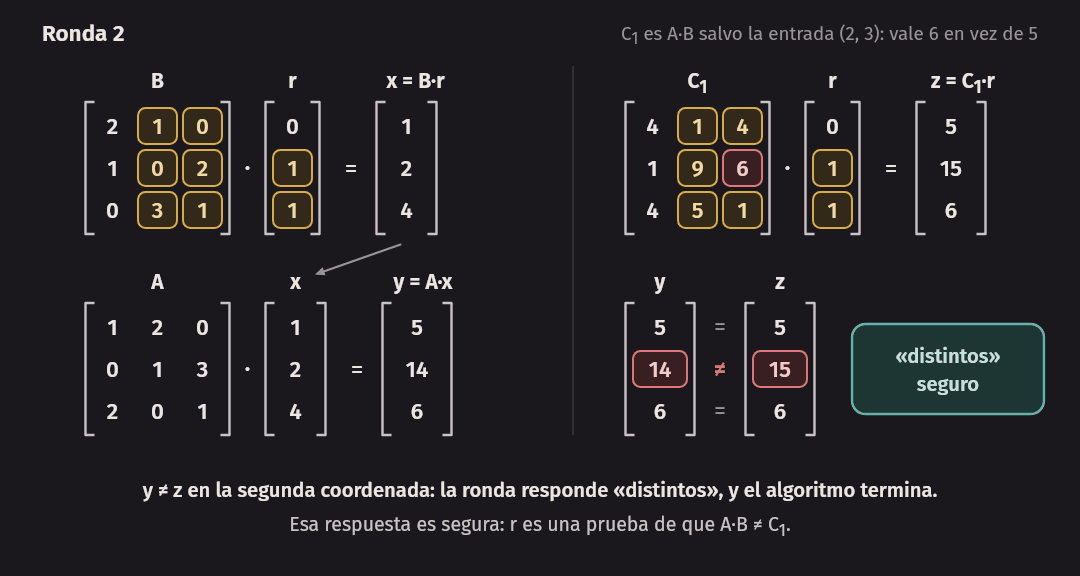
Miren ahora qué vectores detectan: exactamente los que tienen un 1 en la tercera coordenada. Tiene sentido. Multiplicar una matriz por un vector de ceros y unos es sumar las columnas elegidas. La única entrada mala de está en la tercera columna, y se nota si y solo si esa columna entra en la suma. Eso pasa con la mitad de los vectores.
El programa sigue con otras dos matrices. Aquí va solo la línea final de cada una:
C2: en la fila 1, la entrada (1, 1) vale uno más y la (1, 2) uno menos.
  Detectan la diferencia 4 de 8 vectores.

C3: las tres entradas de la diagonal valen uno más.
Detectan la diferencia 7 de 8 vectores.tiene dos errores en la misma fila, uno de y otro de . Si las dos columnas entran en la suma, o ninguna, los errores se cancelan o no aparecen: detectan los vectores con , que otra vez son la mitad. En particular, el vector de solo unos no detecta nada: comparar la suma de cada fila no es una prueba confiable. tiene un error en cada columna, y solo el vector nulo deja de verlo.
En los tres casos detecta al menos la mitad de los vectores. No es casualidad.
Por qué al menos la mitad
Teorema. Sean , y matrices de con entradas enteras. Si , de los vectores de ceros y unos, al menos la mitad cumple . Por lo tanto, el algoritmo de Freivalds se equivoca con probabilidad a lo sumo .
Demostración. Por conteo: emparejamos los vectores de dos en dos y mostramos que en cada pareja al menos uno detecta la diferencia.
Sea . Como el producto de matrices es asociativo y distributivo,
Entonces el vector detecta la diferencia exactamente cuando . La matriz no es nula, porque . Sea una entrada no nula de , en la fila y la columna . Vamos a mirar solo la coordenada de :
El número depende de todas las coordenadas de menos la .
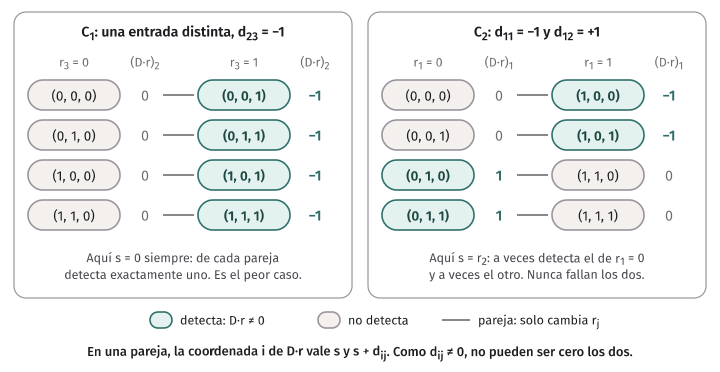
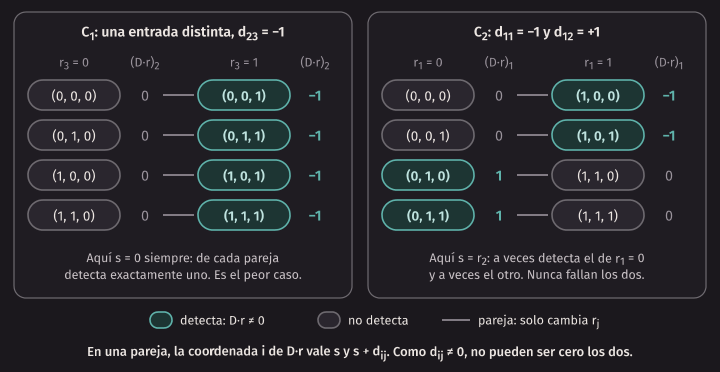
Ahora las parejas. Emparejamos cada vector con el que se obtiene cambiándole solo la coordenada . Los vectores quedan repartidos en parejas, y los dos vectores de una pareja tienen el mismo . Para el que tiene , la coordenada de vale . Para el que tiene , vale . Como , esos dos números son distintos, así que no pueden ser cero los dos. Al menos uno de los dos vectores de la pareja tiene y, por lo tanto, .
Hay parejas y cada una aporta al menos un vector que detecta la diferencia. Son al menos de : la mitad. El algoritmo elige con monedas independientes, así que los vectores son igualmente probables, y la probabilidad de elegir uno que no detecta es a lo sumo . ∎
La demostración no supone nada sobre , y , salvo que . No hay matrices “difíciles” para Freivalds: la cota vale para todas.
En el ejemplo, con , la entrada no nula de es . Las parejas son los vectores que solo difieren en la tercera coordenada: con , con , y así. En la tabla, de cada pareja detecta exactamente uno. Cuando tiene una sola entrada no nula, la cota se alcanza: la probabilidad de fallar es exactamente . Es el peor caso, y es el que usaremos en los experimentos.
Módulo un primo
Con enteros de verdad hay un problema práctico. Si las entradas de y de llegan a y , una entrada de puede llegar a , que no cabe en 64 bits. La salida usual es hacer todas las cuentas módulo un primo : se trabaja con los restos, que siempre son menores que .
El código de la semana usa , un primo menor que . Las matrices tienen entradas en , y la pregunta pasa a ser si módulo : si cada entrada de deja el mismo resto que la de .
El teorema sigue valiendo, con la misma demostración. Ahora tiene alguna entrada que no es múltiplo de . En una pareja, las coordenadas valen y ; si las dos fueran múltiplos de , su diferencia también lo sería. Así que a lo sumo una de las dos es cero módulo , y al menos la mitad de los vectores detecta la diferencia.
Dos advertencias:
- Módulo no es lo mismo que en los enteros. Si las matrices son de enteros y difiere de en un múltiplo de en cada entrada, módulo son iguales y ninguna ronda lo verá. Si lo que interesa es la igualdad en los enteros, hay que elegir mayor que cualquier diferencia posible. En el laboratorio el problema se plantea directamente módulo , y esa dificultad no aparece.
- El argumento de las parejas no usa que sea primo. Solo usa que no es cero módulo : funciona con cualquier módulo. Que sea primo importa en una variante más fuerte, la del ejercicio 8, en la que las coordenadas de se eligen entre los restos y no solo entre 0 y 1.
En C++. Con , dos restos se multiplican sin overflow en 64 bits: el producto es menor que . En 32 bits no cabe.
mul_moddefreivalds.hrecibe y devuelvestd::uint64_ty hacea * b % p. El error típico es guardar las entradas en uninto unstd::uint32_ty escribira * bsin convertir antes: C++ multiplica en el tipo de los operandos, y el resultado ya llega dañado a la variable de 64 bits. Con un primo cercano a ni siquiera 64 bits alcanzan para el producto.
Repetir para bajar el error
Equivocarse la mitad de las veces parece inútil. No lo es, por dos razones: el error está de un solo lado, y se puede repetir.
algoritmo freivalds_repetido(A, B, C, k)
    repetir k veces
        si freivalds(A, B, C) = "distintos" entonces
            devolver "distintos"
        fin si
    fin repetir
    devolver "iguales"
fin algoritmo
Cada ronda lanza monedas nuevas. Si , todas las rondas dicen “iguales” y la respuesta es correcta. Si , el algoritmo se equivoca solo si fallan las rondas. Cada una falla con probabilidad a lo sumo , y son independientes, así que
El costo es veces el de una ronda: .
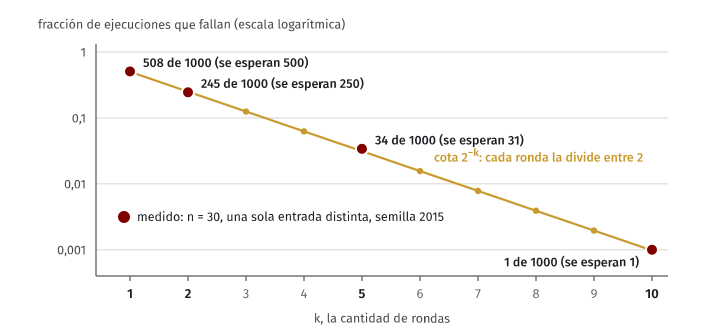
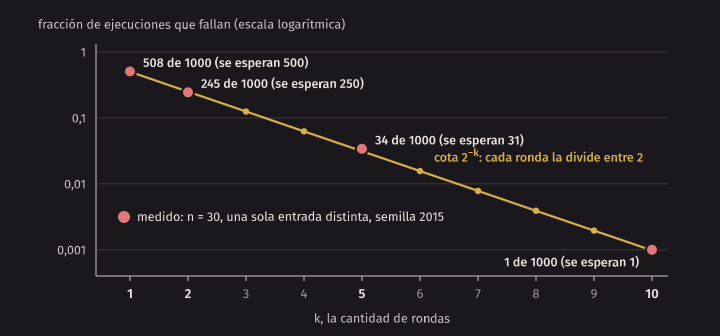
El programa freivalds_experiment lo mide. Arma dos matrices de al azar y una que difiere
de en una sola entrada, el peor caso. Para cada corre el algoritmo 1000 veces y cuenta cuántas
responde “iguales”. La semilla del generador es fija, así que la tabla sale igual cada vez que se corre.
$ build/freivalds_experiment
n = 30, p = 1000000007, semilla = 2015, 1000 ejecuciones por fila
C difiere de A·B solo en la entrada (18, 5).

 k   fallos   fracción   cota 2^-k
 1      508      0.508    0.500000
 2      245      0.245    0.250000
 5       34      0.034    0.031250
10        1      0.001    0.000977

Con C = A·B y k = 10: 0 respuestas "distintos" en 1000 ejecuciones.
Con una sola entrada distinta, la probabilidad de fallar es exactamente , y en 1000 ejecuciones se
esperan cerca de fallos: 500, 250, 31 y 1. Salieron 508, 245, 34 y 1. No son los números
exactos porque es un experimento: si lanzan 1000 monedas, que salgan 508 caras no sorprende a nadie. Con otra
semilla salen otros números igual de cercanos; prueben build/freivalds_experiment 7. La última línea muestra
el otro lado: cuando el producto es correcto, el algoritmo no se equivoca nunca.
¿Cuántas rondas hacen falta? Depende de qué error se tolere:
| Cota del error, | |
|---|---|
| 10 | |
| 20 | |
| 30 | |
| 100 |
Para un error menor que bastan 30 rondas, porque , y 29 no alcanzan, porque . Con 100 rondas, la probabilidad de error es menor que la de que un rayo cósmico cambie un bit de la memoria durante el cálculo, o la de que el procesador tenga un defecto. A esa altura, la respuesta del algoritmo probabilístico es tan confiable como la de cualquier programa que corra en una máquina física.
Error común. Creer que un algoritmo probabilístico “a veces da la respuesta equivocada y no hay nada que hacer”. El error no es un accidente fuera de control: es un número que se elige. Quien corre el algoritmo decide , y con eso fija la probabilidad de error tan pequeña como quiera, pagando un factor en el tiempo. Lo que no se puede es llevarla exactamente a cero.
En C++.
std::mt19937_64 rng(2015)crea un generador con semilla fija: produce siempre la misma secuencia, en cualquier computadora, porque el estándar define el algoritmo. Sirve para que un experimento se pueda repetir y una prueba no falle un día sí y otro no. Las distribuciones, comostd::uniform_int_distribution, no tienen esa garantía: cada biblioteca puede implementarlas distinto. Por esofreivalds.hsaca los bits directamente del generador, conrng() >> 63.
La clase BPP
Freivalds tiene error de un solo lado. La definición general permite que el algoritmo se equivoque en los dos sentidos, con tal de que acierte con una ventaja clara.
Un lenguaje está en BPP (tiempo polinomial probabilístico con error acotado, bounded-error probabilistic polynomial time) si existe una máquina de Turing probabilística , de tiempo polinomial, tal que para toda cadena :
“Tiempo polinomial” quiere decir que todas las ramas se detienen en una cantidad polinomial de pasos. En cada caso la máquina se equivoca con probabilidad a lo sumo .
El problema de Freivalds cabe en la definición. Con dos rondas, si acepta con probabilidad 1, y si rechaza con probabilidad al menos . Pero no es un buen ejemplo de lo que BPP agrega, porque ese lenguaje ya estaba en P: multiplicar y comparar es polinomial. Freivalds muestra que el azar puede acelerar, de a . El ejemplo de la sección siguiente es de otro tipo: un problema para el que no se conoce ningún algoritmo polinomial sin azar.
La constante no importa: amplificación
¿Por qué ? Por nada en especial. Cualquier constante menor que define la misma clase, porque el error se puede bajar repitiendo. Con error de los dos lados ya no sirve “si alguna ronda dice distintos”: hay que correr el algoritmo veces, con impar, y responder lo que diga la mayoría.
Lema de amplificación. Si un algoritmo se equivoca con probabilidad a lo sumo en cada ejecución, la mayoría de ejecuciones independientes se equivoca con probabilidad a lo sumo
No lo demostraremos; el ejercicio 9 da los pasos. La cota baja exponencialmente con : con ejecuciones el error es menor que , porque . Así, un número polinomial de repeticiones da un error exponencialmente pequeño, y el tiempo total sigue siendo polinomial.
El programa majority_table calcula la probabilidad exacta de que la mayoría se equivoque, cuando cada
ejecución falla con probabilidad exactamente , y la pone al lado de la cota.
$ build/majority_table
  k   la mayoría se equivoca   cota (8/9)^(k/2)
  1                3.333e-01          9.428e-01
  5                2.099e-01          7.449e-01
 11                1.221e-01          5.232e-01
 25                4.151e-02          2.294e-01
 51                6.888e-03          4.961e-02
101                2.724e-04          2.611e-03
201                5.531e-07          7.231e-06
La cota es holgada, y aun así alcanza. Comparen con Freivalds, donde 20 rondas daban un error de una millonésima: con error de los dos lados hacen falta unas 200 ejecuciones para lo mismo. La mayoría converge más lento que “basta un testigo”, pero converge igual de seguro.
Lo que no se puede amplificar es un algoritmo que acierta con probabilidad exactamente . Eso es lanzar una moneda sin mirar la entrada, y la mayoría de muchas monedas sigue siendo una moneda.
Idea clave. En BPP el error es un parámetro, no un defecto. Con error por ejecución, repetir y votar lo lleva por debajo de cualquier número que se pida, con un costo polinomial.
Identidad de polinomios
Segundo ejemplo, y el más importante de la clase. El problema: dados dos polinomios, ¿son el mismo?
Si los dos vienen escritos por sus coeficientes, se comparan los coeficientes y listo. La dificultad aparece cuando un polinomio viene como una fórmula, con sumas y productos sin desarrollar. Por ejemplo:
Desarrollar este producto es posible, pero con varias variables se vuelve inmanejable: el producto se escribe con factores y, desarrollado, tiene términos. Evaluar la fórmula en un punto, en cambio, es fácil: sumas y multiplicaciones.
De ahí la idea, que es la misma de Freivalds: en vez de comparar los objetos, comparar lo que valen en un punto al azar.
algoritmo identidad(f, g)
    r ← un elemento al azar de {0, 1, ..., p - 1}
    si f(r) = g(r) módulo p entonces
        devolver "coinciden"
    sino
        devolver "distintos"
    fin si
fin algoritmo
Como antes, “distintos” es una respuesta segura: se encontró un punto donde difieren. El error posible es responder “coinciden” cuando son distintos, por haber caído justo en un punto donde coinciden. ¿Cuántos puntos así puede haber?
Teorema. Sea un primo, y sean y dos polinomios distintos en una variable, de grado a lo sumo , con coeficientes módulo . Entonces módulo para a lo sumo de los valores de . Por lo tanto, el algoritmo se equivoca con probabilidad a lo sumo .
Demostración. La diferencia es un polinomio no nulo de grado a lo sumo , y exactamente cuando es una raíz de . Un polinomio no nulo de grado a lo sumo tiene a lo sumo raíces: por cada raíz se le puede sacar un factor , y cada factor baja el grado en uno. Como se elige entre valores igualmente probables, la probabilidad de caer en una raíz es a lo sumo . ∎
Aquí sí hace falta que sea primo. “Sacar un factor por cada raíz” usa que, módulo , un producto solo es cero si alguno de los factores lo es, y eso es falso con un módulo compuesto: módulo 6, el polinomio tiene grado 1 y dos raíces, 0 y 3.
El programa pit_demo hace el experimento con el polinomio de arriba, de grado 10. Lo compara con tres
polinomios dados por sus coeficientes: su desarrollo correcto, el desarrollo con el coeficiente de
cambiado, y el polinomio cero. Primero con un primo pequeño, 101, y después con el de la semana.
$ build/pit_demo
(x - 1)(x - 2)(x - 3)(x - 4) = x^4 - 10x^3 + 35x^2 - 50x + 24
En x = 7: por factores 360, por coeficientes 360

f(x) = (x - 1)(x - 2)···(x - 10), de grado 10

p = 101, 1000 ejecuciones por fila, cota 10/p = 9.90e-02
  f se compara con                            coinciden en    responde "coinciden"
  su desarrollo                               101 de 101      1000 de 1000
  el desarrollo con un coeficiente cambiado     1 de 101        10 de 1000
  el polinomio cero                            10 de 101       102 de 1000

p = 1000000007, 1000 ejecuciones por fila, cota 10/p = 1.00e-08
  f se compara con                            coinciden en    responde "coinciden"
  su desarrollo                               (no se cuenta)  1000 de 1000
  el desarrollo con un coeficiente cambiado   (no se cuenta)     0 de 1000
  el polinomio cero                           (no se cuenta)     0 de 1000
Las dos primeras líneas son un ejemplo para seguir a mano: , y también .
Con se pueden probar los 101 puntos, y la columna del medio dice en cuántos coinciden. Con su desarrollo, en todos: es el mismo polinomio. Con el coeficiente cambiado, la diferencia es , que solo se anula en 0: coinciden en un punto. Con el polinomio cero coinciden en las raíces de , que son : diez puntos, justo el máximo que permite el teorema. La columna de la derecha es el experimento: 10 y 102 respuestas equivocadas en 1000, cerca de y de .
Un error del 10 % es mucho. Pero miren la cota: . Para bajarla no hace falta repetir: basta agrandar el conjunto del que se elige el punto. Con la cota es , y en 1000 ejecuciones no hubo ningún error.
Con varias variables el resultado es el mismo. Se enuncia sin demostración:
Teorema (Schwartz-Zippel). Sea un polinomio no nulo en las variables , de grado total a lo sumo , con coeficientes módulo un primo . Si se eligen al azar, de forma independiente y uniforme, en , entonces
El grado total de un término es la suma de sus exponentes, y el de un polinomio es el mayor entre sus términos. Lo notable es que la cota no depende de la cantidad de variables. El teorema de una variable es el caso .
Con eso, el problema de decidir si dos fórmulas con sumas y productos describen el mismo polinomio módulo , con mayor que el triple del grado, está en BPP: el grado de una fórmula no pasa de su tamaño, evaluar es polinomial, y el error es a lo sumo . Y aquí está la diferencia con Freivalds: no se conoce ningún algoritmo determinista de tiempo polinomial para este problema. Es el ejemplo estándar de un problema que está en BPP y que no se sabe si está en P.
En la práctica. Comparar dos objetos grandes a través de un valor pequeño calculado con un punto al azar es una técnica de todos los días. Si en Algoritmos vieron la búsqueda de un patrón con hashing (Rabin-Karp), era esto: una cadena se lee como los coeficientes de un polinomio, y su hash es el polinomio evaluado en un punto, módulo un primo. Dos cadenas distintas chocan solo si el punto es raíz de la diferencia. Las bibliotecas de criptografía hacen algo parecido para decidir si un número de cientos de cifras es primo: usan la prueba de Miller-Rabin, que es probabilística, y repiten hasta que el error sea despreciable.
Dónde queda BPP
Teorema. .
Demostración. : una máquina determinista es una máquina probabilística que nunca lanza una moneda. Acepta con probabilidad 1 o con probabilidad 0, y nunca se equivoca.
: sea una máquina probabilística de tiempo . En cada rama lanza a lo sumo monedas. Una máquina determinista recorre todas las cadenas de bits, una por una; para cada una simula a usando los bits de como monedas, y cuenta cuántas cadenas llevan a aceptar. Acepta si son al menos dos tercios del total. La simulación de una rama usa espacio polinomial, la cadena y el contador ocupan bits cada uno, y el espacio se reutiliza entre una cadena y la siguiente. Es la misma idea con la que se mostró que , contando en vez de buscar. ∎
La segunda parte dice algo que conviene no perder de vista: el azar no cambia lo que se puede calcular. Una máquina con monedas se simula sin monedas, probando todas las secuencias. Lo que está en juego es solo el costo: esa simulación tarda un tiempo exponencial.
Lo que no se sabe:
- Si .
- Cómo se compara BPP con NP. No se sabe si , ni si . Lo segundo se cree falso: querría decir que los problemas NP-completos se resuelven en la práctica.
Y lo que se cree: que . Es al revés que con P y NP, donde se cree que son distintas. Hay dos razones.
- La experiencia. Durante décadas, el ejemplo de un problema en BPP sin algoritmo polinomial conocido fue decidir si un número es primo. En 2002, Agrawal, Kayal y Saxena dieron un algoritmo determinista de tiempo polinomial. Varios otros problemas siguieron el mismo camino.
- Teoremas condicionales. Se ha demostrado que, si existen problemas que de verdad requieren recursos exponenciales, en un sentido preciso que usa circuitos y que no vimos, entonces se pueden fabricar de manera determinista secuencias de bits que ningún algoritmo eficiente distingue del azar, y con ellas reemplazar las monedas de cualquier algoritmo de BPP. Casi todos creen que esos problemas difíciles existen.
Si es así, el azar no agrega poder: todo lo que se hace en tiempo polinomial con monedas se haría también sin ellas. Seguiría siendo útil en la práctica, porque los algoritmos con azar suelen ser más simples y más rápidos: Freivalds gana un factor , y no tiene diez líneas.
Lo que sigue abierto
Las cuatro preguntas con las que el curso termina sin respuesta, y lo que cambiaría con cada una.
P frente a NP. ¿Todo problema cuyas soluciones se comprueban rápido se resuelve rápido?
- Si : SAT y todos los problemas NP-completos tendrían algoritmos polinomiales. Encontrar sería tan fácil como comprobar. La criptografía de clave pública que se usa hoy dejaría de ser segura, al menos en principio, porque romperla es un problema de NP. Cuánto cambiaría en la práctica dependería del algoritmo: uno de tiempo no cambia nada.
- Si , que es lo que casi todos creen: se confirmaría que para los problemas NP-completos no hay atajo general. Lo valioso sería la demostración, que tendría que usar una técnica que hoy no existe. No alcanzaría, por sí sola, para garantizar criptografía segura: eso pide problemas difíciles en casi todas las entradas, y no solo en el peor caso.
NP frente a coNP. ¿Toda fórmula insatisfacible tiene una demostración corta de que lo es?
- Si : existirían certificados cortos para el “no”. Habría una demostración de tamaño polinomial de que una fórmula no tiene solución, o de que un grafo no tiene camino hamiltoniano.
- Si : entonces también . La razón es que P es cerrada bajo complemento: si P fuera igual a NP, NP también sería cerrada bajo complemento, y sería igual a coNP. Por eso separar NP de coNP es al menos tan difícil como separar P de NP.
P frente a PSPACE. ¿Lo que se resuelve con memoria polinomial se resuelve en tiempo polinomial?
- Si : entonces también , porque NP queda en medio. Además, decidir quién gana en un juego como la geografía generalizada sería polinomial.
- Si : es lo que se cree, y debería ser más fácil de demostrar que , porque afirma menos. Tampoco se ha podido. Recuerden que alguna de las inclusiones entre P y EXPTIME es estricta, y no se sabe cuál.
L frente a NL. ¿Hace falta el no determinismo para decidir alcanzabilidad con memoria logarítmica?
- Si : PATH se decidiría con espacio logarítmico de forma determinista. Para grafos no dirigidos eso ya se sabe: Reingold lo demostró en 2005. Para grafos dirigidos es la pregunta abierta.
- Si : adivinar el camino sería indispensable, y ningún algoritmo determinista decidiría PATH con memoria logarítmica. En espacio se sabe mucho más que en tiempo: Savitch da , y . Aun así, esto falta.
Las cuatro se parecen: en todas se pregunta si un recurso (adivinar, la memoria reutilizable, el certificado del otro lado) agrega poder, en todas se cree que sí, y en ninguna se sabe.
Más allá del curso
Tres temas que continúan lo visto. Cada uno es un curso entero; aquí solo va de qué tratan.
Demostraciones interactivas. NP es la clase de lo que se puede demostrar con un certificado escrito, que un verificador determinista revisa. ¿Qué pasa si el verificador puede lanzar monedas y hacer preguntas a quien demuestra, en varias rondas, y solo se le pide convencerse con alta probabilidad? Esa clase se llama IP. El resultado es sorprendente: , demostrado por Shamir hacia 1990. Con preguntas y azar, un verificador de tiempo polinomial puede quedar convencido de cosas para las que no se conoce ningún certificado corto, como que una fórmula no es satisfacible. La demostración convierte fórmulas en polinomios y usa la idea de la identidad de polinomios de este capítulo. Es, además, un resultado que no relativiza.
Criptografía. Todo el curso trató la dificultad como un obstáculo. La criptografía la usa como materia prima: un cifrado es seguro si romperlo exige resolver un problema difícil. Lo que necesita es una función de un solo sentido: fácil de calcular y difícil de invertir en casi todas las entradas. Si existe alguna, entonces . No se sabe si existen, y no se sabe si alcanzaría para que existan. Los sistemas que se usan se apoyan en problemas concretos que se creen difíciles, como factorizar un número. La seguridad de internet descansa, hoy, sobre conjeturas.
Computación cuántica. Una computadora cuántica es otro modelo de máquina, con su propia clase de tiempo polinomial con error acotado, BQP. Se sabe que . El resultado más conocido es el algoritmo de Shor, de 1994, que factoriza en tiempo polinomial cuántico, algo que no se sabe hacer con una computadora clásica. Dos precisiones. Primero, una computadora cuántica no calcula nada que una máquina de Turing no pueda: se la puede simular, con un costo exponencial. La tesis de Church-Turing no se toca; lo que está en discusión es el costo. Segundo, no se conoce ningún algoritmo cuántico de tiempo polinomial para un problema NP-completo, y se cree que no existe: para buscar entre candidatos, lo mejor que se conoce baja a unos pasos, que sigue siendo exponencial.
El mapa completo del curso
En la semana 1 dijimos que el camino iría de la máquina más simple a la más general, y que a cada modelo se le buscaría el límite. Este es el camino completo. Tiene dos partes: los niveles que dependen de qué máquina hace falta, y, dentro de lo decidible, las clases que dependen de cuántos recursos.
De lo regular a lo no reconocible
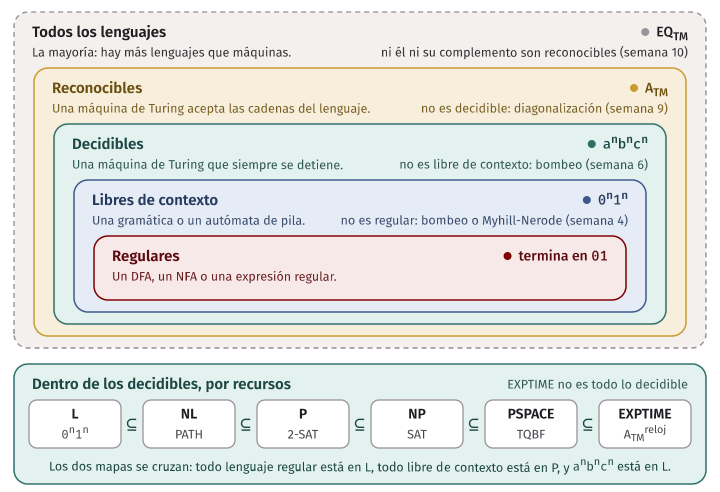
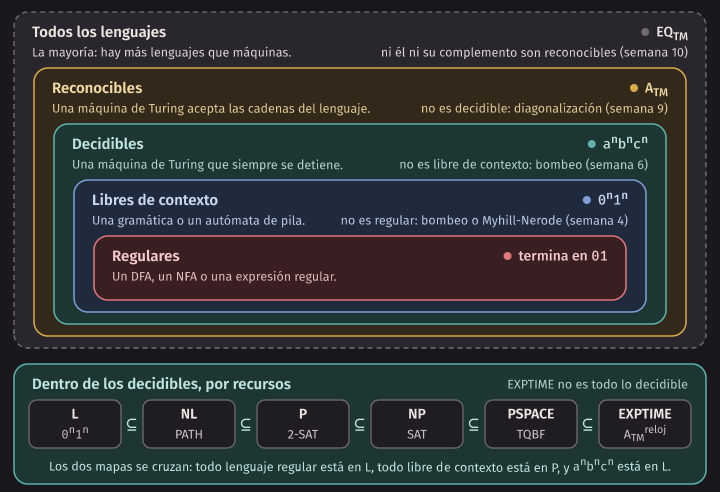
Cada nivel contiene al de más adentro, y cada inclusión es estricta: hay un lenguaje que lo demuestra.
| Nivel | Modelo | Un lenguaje que está aquí y no en el nivel anterior | Técnica que lo demuestra | Semana |
|---|---|---|---|---|
| Regulares | DFA, NFA, expresión regular | Las cadenas que terminan en | (se da el autómata) | 1 a 3 |
| Libres de contexto | Gramática, autómata de pila | Lema de bombeo, o cadenas distinguibles (Myhill-Nerode) | 4 | |
| Decidibles | Máquina de Turing que siempre se detiene | Lema de bombeo para lenguajes libres de contexto | 6 | |
| Reconocibles | Máquina de Turing | Diagonalización | 9 | |
| Todos los lenguajes | Ninguno | El complemento de ; | “Reconocible con complemento reconocible es decidible”; reducción por función | 9 y 10 |
Un párrafo por nivel, con lo que conviene tener a mano.
Regulares. Memoria fija: una cantidad de estados que no depende de la entrada. Tres descripciones equivalentes: DFA, NFA y expresiones regulares (teorema de Kleene), con sus conversiones: la construcción de subconjuntos, la de Thompson y la eliminación de estados. Son cerrados bajo unión, intersección, complemento, concatenación, estrella y reverso. Todo lo que se pregunte sobre un autómata finito es decidible: si acepta una cadena, si su lenguaje es vacío, si dos autómatas son equivalentes. El límite es que no pueden contar sin tope. Para demostrar que un lenguaje no es regular hay dos herramientas. El lema de bombeo, jugado contra un adversario: él elige , nosotros la cadena, él la división, nosotros el exponente. Y las cadenas distinguibles: para , las cadenas son distinguibles dos a dos, porque el sufijo separa a de ; son infinitas, y un DFA necesitaría infinitos estados. Las dos son el principio del palomar.
Libres de contexto. Se agrega una pila: memoria sin límite, pero solo se ve la cima. Dos descripciones equivalentes: gramáticas y autómatas de pila. Aquí el no determinismo sí agrega poder: el autómata de pila determinista reconoce menos. Son cerrados bajo unión, concatenación y estrella, y no bajo intersección ni complemento. Decidir si una gramática genera una cadena es decidible, y polinomial, con CYK. Decidir si dos gramáticas son equivalentes, si una genera todas las cadenas o si es ambigua es indecidible. El límite es que una pila compara una sola pareja de cantidades. Para se usa el lema de bombeo para lenguajes libres de contexto, con : los trozos e no alcanzan a tocar los tres tipos de símbolos, y bombear desequilibra las cantidades.
Decidibles. Una máquina de Turing que se detiene con toda entrada: un algoritmo. Por la tesis de Church-Turing, es lo mismo que “lo que un programa puede resolver”, con cualquier lenguaje de programación y cualquier cantidad de tiempo y memoria. es decidible: la máquina de la semana 7 tacha un símbolo de cada tipo por vuelta. Son cerrados bajo complemento, porque basta intercambiar aceptar y rechazar. El límite es : ninguna máquina decide si otra máquina acepta una cadena. La demostración es la diagonal: una máquina que hace lo contrario que cada máquina con su propia descripción. Desde se llega a los demás problemas indecidibles con reducciones: el problema de la parada, , , el problema de correspondencia de Post, y, con el teorema de Rice, toda propiedad no trivial del lenguaje de una máquina.
Reconocibles. Una máquina de Turing que acepta las cadenas del lenguaje y que, con las demás, puede rechazar o no detenerse nunca. es reconocible: la máquina universal simula y acepta si la simulación acepta. Lo mismo el problema de la parada y el de correspondencia de Post: se busca, y si hay respuesta afirmativa se la encuentra. No son cerrados bajo complemento, y esa es la manera de salir de ellos: si un lenguaje y su complemento son reconocibles, el lenguaje es decidible. Como es reconocible y no decidible, su complemento no es reconocible.
Más allá. Hay lenguajes para los que ni ellos ni su complemento son reconocibles, como ; se demuestra con dos reducciones por función. Y son la mayoría: las máquinas se pueden listar y los lenguajes no, así que casi todos los lenguajes quedan aquí, aunque cueste nombrar uno.
Dentro de lo decidible: las clases de complejidad
La segunda parte del mapa mide recursos. Todas estas clases están dentro de los lenguajes decidibles.
| Clase | Recurso | Un problema característico | Qué se sabe |
|---|---|---|---|
| L | Espacio logarítmico, determinista | , con dos contadores en binario | . No se sabe si |
| NL | Espacio logarítmico, no determinista | PATH, que es NL-completo | , , |
| P | Tiempo polinomial, determinista | PATH, 2-SAT, todo lenguaje libre de contexto (CYK) | . No se sabe si |
| NP | Tiempo polinomial, no determinista; o un verificador con certificado | SAT, 3-SAT, HAMPATH, CLIQUE, SUBSET-SUM: NP-completos (los dos últimos, por las reducciones de Algoritmos) | No se sabe si ni si |
| coNP | Los complementos de los lenguajes de NP | Las fórmulas insatisfacibles | |
| BPP | Tiempo polinomial con monedas, error a lo sumo | Identidad de polinomios | . Se cree que |
| PSPACE | Espacio polinomial | TQBF, geografía generalizada: PSPACE-completos | (Savitch) |
| EXPTIME | Tiempo exponencial | , que es EXPTIME-completo |
Tres cosas para leer bien esta tabla.
Los dos mapas se cruzan. Las clases de complejidad no son “niveles más finos” del primer mapa. Todo lenguaje regular está en L, y todo lenguaje libre de contexto está en P. Pero , que no es libre de contexto, está en L: tres contadores en binario alcanzan. Que un lenguaje pida un modelo más general no quiere decir que cueste más.
Lo que se sabe es poco. Inclusiones: todas las de la cadena. Igualdades: y . Separaciones: las cinco de la tabla de pares, que salen de los teoremas de jerarquía, y la última de la cadena, que también: por el teorema de jerarquía de tiempo hay lenguajes decidibles que no están en EXPTIME. Nada más.
Lo que no se sabe se organiza con reducciones. Sin poder separar las clases, lo que el área sí puede hacer es comparar problemas. Un problema completo para una clase es el más difícil de ella: si SAT está en P, entonces ; si TQBF está en P, entonces ; si PATH está en L, entonces . Cada pregunta abierta sobre clases es una pregunta sobre un problema concreto.
Las cuatro técnicas
Todo el curso se hizo con cuatro ideas, que vuelven con distinta ropa.
| Técnica | La idea | Dónde apareció |
|---|---|---|
| Simulación | Una máquina imita a otra | Construcción de subconjuntos; una cinta por varias; la máquina universal; ; Savitch; |
| Palomar | Con memoria finita, algo se repite, y lo repetido se puede bombear | Los dos lemas de bombeo; Myhill-Nerode; “una máquina que se detiene no repite configuraciones” |
| Diagonalización | Una máquina que hace lo contrario que cada una de una lista | Hay más lenguajes que máquinas; ; los teoremas de jerarquía |
| Reducción | Si se resuelve con , entonces es al menos tan difícil como | Indecidibilidad (semana 10); NP-completitud (semana 13); PSPACE-completitud (semana 14); EXPTIME (hoy) |
Las simulaciones dan inclusiones: lo que se puede. El palomar y la diagonal dan los límites: lo que no se puede. Las reducciones llevan un límite de un problema a otro, y siempre en la misma dirección: para demostrar que es difícil, se reduce desde un problema que ya se sabe difícil hacia .
Idea clave. Para ubicar un lenguaje en el mapa hacen falta dos argumentos. Uno de pertenencia, que es una máquina o un algoritmo: “está en este nivel porque esto lo decide”. Y uno de exclusión, que es una de las técnicas de límite: “no está en el nivel anterior por bombeo, por diagonalización o por reducción”. En el examen se piden los dos.
El código de la semana
Todo está en code/week-15. Dentro del entorno del curso:
make        # compila los programas en build/
make test # corre las pruebas| Archivo | Qué es |
|---|---|
freivalds.h |
Matrices módulo , mul_mod, el producto exacto y el algoritmo de Freivalds con rondas |
freivalds_demo.cpp |
El ejemplo de , con los 8 vectores |
freivalds_experiment.cpp |
La tabla de fallos para , con semilla fija |
pit.h, pit_demo.cpp |
Polinomios módulo y la prueba de identidad en un punto al azar |
majority.h, majority_table.cpp |
La probabilidad exacta de que la mayoría de ejecuciones se equivoque |
diagonal.h, diagonal_demo.cpp |
La tabla de la diagonal con seis decididores |
test_*.cpp |
Las pruebas |
Las pruebas comprueban lo que este capítulo afirma con números:
test_freivaldsverifica el teorema sin azar: para cientos de matrices pequeñas prueba los vectores y comprueba que, si , al menos la mitad detecta la diferencia, y que si ninguno lo hace. Lo repite con varios módulos, también con el 6, que no es primo. Comprueba los conteos 4, 4 y 7 del ejemplo, y que con una sola entrada distinta detectan exactamente los vectores con un 1 en esa columna. Por último vuelve a correr el experimento con la semilla 2015 y exige los números de la tabla: 508, 245, 34 y 1.test_pitcomprueba el desarrollo de , que las dos formas de un polinomio coinciden en todos los puntos, los conteos 101, 1 y 10 con , y los de la tabla del experimento.test_majoritycomprueba los valores exactos para , que se pueden calcular a mano, que la cota se cumple para todo impar hasta 301, y los números de la tabla.test_diagonalcomprueba que la fila de difiere de cada una de las seis en la casilla de la diagonal.
$ make test
test_freivalds: correcto
test_pit: correcto
test_majority: correcto
test_diagonal: correcto
Todas las pruebas pasaron.
Que una prueba de un algoritmo con azar sea determinista no es una contradicción. Con la semilla fija, el generador produce siempre los mismos bits, y el experimento es un cálculo como cualquier otro. Lo que la prueba fija es “con estas monedas sale 508”. El teorema, que habla de todas las monedas, se prueba aparte, contando vectores.
El laboratorio
En lab/freivalds está el enunciado, un esqueleto y los casos. La entrada es y tres matrices de
con entradas en , con , y la salida es iguales o distintos
según sea o no igual a módulo .
cd lab/freivalds
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Se resuelve con Freivalds repetido 30 veces, que da un error menor que por caso. Hay tres cosas que cuidar. La primera es el overflow: el producto de dos entradas no cabe en 32 bits, y hay casos con entradas iguales a hechos para notarlo. La segunda es no “ahorrarse” el azar: hay casos en los que comparar las sumas de las filas, que es Freivalds con el vector de solo unos, no ve la diferencia. La tercera es el tiempo: en los dos casos grandes , y calcular con multiplicaciones no termina dentro del límite. La lectura de la entrada ya viene escrita en el esqueleto, porque son 12 millones de números y leerlos mal cuesta más que todo el algoritmo.
Los pasos 4 y 5 del laboratorio son el experimento de este capítulo, hecho con su propio código: en el archivo
experiment.cpp pegan su función de una ronda, y el programa mide cuántas veces fallan , 2, 5 y 10
rondas en 1000 ejecuciones.
Resumen
- Las inclusiones de la cadena se demuestran con simulaciones. Una separación pide un lenguaje y un argumento sobre todas las máquinas de una clase: una diagonal.
- Una función es construible en espacio si se puede calcular en espacio . Las funciones usuales lo son.
- Teorema de jerarquía de espacio: para construible existe un lenguaje decidible en espacio y no en espacio . La máquina , con la entrada , simula a dentro de celdas y responde lo contrario.
- La diagonal con recursos necesita tres cosas más que la de la semana 9: la función construible, para fijar el límite; el relleno , para que cada máquina se enfrente a una entrada lo bastante larga; y un contador de pasos, para cortar a las máquinas que no se detienen.
- Teorema de jerarquía de tiempo: para construible existe un lenguaje decidible en tiempo y no en tiempo . El factor es lo que cuesta llevar el contador.
- Los teoremas dicen que existe algún lenguaje al que más recursos le sirven. No dicen que a todo problema le sirvan, ni cuánto cuesta un problema dado.
- Se sabe: , y (este con Savitch), y por lo tanto también y . De los otros diez pares de la cadena no se sabe nada. Al menos una de las inclusiones entre P y EXPTIME es estricta, y no se sabe cuál.
- Hay problemas que no están en P por teorema: los EXPTIME-completos, como decidir si una máquina acepta en a lo sumo pasos con en binario.
- ✂️ Con un oráculo las máquinas consultan gratis un lenguaje. Existen y con y . Una demostración que relativiza, como la diagonalización por simulación, no puede resolver P frente a NP.
- Una máquina probabilística lanza monedas. La probabilidad se calcula sobre las monedas, para cada entrada; la entrada no es al azar.
- Freivalds comprueba con tres productos de matriz por vector, . Si , al menos la mitad de los vectores de ceros y unos lo detecta: se emparejan los vectores que difieren en una coordenada. El error es de un solo lado, y con rondas es a lo sumo .
- BPP: tiempo polinomial con error a lo sumo de cada lado. La constante no importa: la mayoría de ejecuciones se equivoca con probabilidad a lo sumo .
- Identidad de polinomios: dos polinomios distintos de grado a lo sumo coinciden en a lo sumo puntos módulo un primo , así que un punto al azar los distingue salvo con probabilidad . Está en BPP y no se sabe si está en P.
- . El azar no cambia lo que se puede calcular, y se cree que tampoco lo que se puede calcular en tiempo polinomial: .
- Abierto: P frente a NP, NP frente a coNP, P frente a PSPACE, L frente a NL.
- El mapa: regulares libres de contexto decidibles reconocibles todos los lenguajes, separados por , , y el complemento de , con el lema de bombeo, el lema de bombeo para lenguajes libres de contexto, la diagonalización y las reducciones.
Ejercicios
- Digan cuáles de estas afirmaciones se siguen de los teoremas de jerarquía, y con qué funciones: (a) ; (b) ; (c) ; (d) ; (e) . En las que no se siguen, digan qué hipótesis falla.
- En la máquina del teorema de jerarquía de espacio, digan qué deja de funcionar en la demostración con cada cambio: (a) se quita la etapa 3 y se simula a con la entrada , sin relleno; (b) se quita el contador de pasos; (c) en la etapa 4 se simula a con la entrada en vez de con completa. En cada caso, señalen la frase de la demostración que ya no vale.
- Sea y sea una máquina que usa espacio y a la que simula con . Encuentren un tal que la simulación quepa en celdas para todo . Si , ¿cuántos ceros de relleno alcanzan?
- Demuestren que . No se pide decir cuál contiene a cuál, que no se sabe. Pista: NP es cerrada bajo reducciones en tiempo polinomial; muestren con un relleno que, si lo fuera, contendría a .
- Demuestren que , donde . Después expliquen por qué el mismo argumento no separa P de NP: ¿qué tendría que poder hacer la máquina ?
- Con las matrices y del ejemplo y la matriz que es igual a salvo que la entrada
vale 6 en vez de 4, hagan a mano la tabla de los 8 vectores. ¿Cuáles detectan la diferencia?
Emparejen los vectores como en la demostración. Comprueben modificando
freivalds_demo.cpp. - Den matrices , y de , con , para las que exactamente 3 de los 4 vectores detecten la diferencia. ¿Puede haber un caso en que detecten los 4? ¿Por qué?
- La variante con en todo el rango. Supongan que cada coordenada de se elige al azar, de forma independiente y uniforme, en , con primo. Demuestren que, si módulo , la probabilidad de no detectarlo es a lo sumo . Pista: agrupen los vectores de a , los que solo difieren en la coordenada , y usen que la ecuación tiene exactamente una solución módulo . ¿Dónde se usa que es primo? Den un ejemplo con módulo 6 en el que la cota falle.
- El lema de amplificación. Sea la probabilidad de error de una ejecución, y
impar. (a) Una secuencia concreta de resultados con errores tiene probabilidad
. Muestren que, si , eso es a lo sumo
. (b) Hay a lo sumo secuencias. Concluyan que la mayoría se
equivoca con probabilidad a lo sumo .
(c) ¿Cuántas ejecuciones garantiza la cota para un error menor que ? Compárenlo con
build/majority_table. - ¿Cuántas rondas de Freivalds hacen falta para que el error sea menor que ? ¿Y menor que ? Si se corre el algoritmo con sobre un millón de casos distintos con , den una cota para la probabilidad de que falle en alguno. Pista: la probabilidad de que ocurra alguno de varios eventos es a lo sumo la suma de sus probabilidades.
- Usen la prueba de identidad para decidir si sin desarrollar el lado izquierdo: evalúen los dos lados en y en . Si coinciden en esos dos puntos, ¿queda demostrada la igualdad? ¿En cuántos puntos distintos habría que evaluar para tener una demostración, y por qué?
- Ubiquen cada lenguaje en el mapa completo: digan el nivel más pequeño al que pertenece y justifiquen la pertenencia y la exclusión, nombrando la técnica. (a) ; (b) las cadenas binarias con igual cantidad de ceros y de unos; (c) ; (d) ; (e) ; (f) las fórmulas booleanas que son tautologías. Para los decidibles, digan además la clase de complejidad más pequeña del curso en la que saben ponerlos.
- Para programar. Agreguen a
freivalds.hla variante del ejercicio 8, con las coordenadas de en , y repitan el experimento defreivalds_experimentcon un módulo pequeño, , para poder ver los fallos. Con una sola entrada distinta, ¿qué fracción de fallos esperan con y con ? ¿Y con ? - Para programar. Escriban una prueba de identidad para polinomios en dos variables dados como sumas de productos de factores de la forma , módulo . Úsenla para comprobar que y para detectar que . Según el teorema de Schwartz-Zippel, ¿qué probabilidad de error tiene cada ejecución?