
Apuntes · Capítulo 14Complejidad
Espacio
Espacio
Las dos últimas semanas midieron un solo recurso: el tiempo. Con él definimos P y NP, demostramos el teorema de Cook-Levin y nos quedamos con una pregunta sin responder: si adivinar ayuda, es decir, si una máquina no determinista de tiempo polinomial puede más que una determinista. Esta semana medimos el otro recurso de una máquina de Turing, la cantidad de cinta que usa, y hacemos las mismas preguntas. Las respuestas salen distintas, y casi todas por una sola razón:
- El tiempo se gasta. Un paso que ya se dio no se recupera.
- El espacio se reutiliza. Una celda que ya no hace falta se borra y se vuelve a escribir.
Esa diferencia es toda la semana. Con ella vamos a demostrar algo que para el tiempo nadie sabe demostrar: en espacio, el no determinismo cuesta poco. Lo que una máquina no determinista hace con espacio , una determinista lo hace con espacio . Es el teorema de Savitch, y de él sale que , la igualdad que para el tiempo sería .
En la segunda sesión buscamos los problemas más difíciles de PSPACE, igual que la semana 13 buscó los más difíciles de NP. El primero es decidir si una fórmula booleana cuantificada es verdadera, el problema TQBF. SAT pregunta si existe una asignación; TQBF alterna “existe” y “para todo”, y eso es exactamente lo que pasa en un juego de dos jugadores: existe una jugada mía tal que para toda respuesta tuya existe otra jugada mía… Por eso decidir quién gana un juego suele ser PSPACE-completo, y lo demostramos para uno, la geografía generalizada. La sesión termina en el otro extremo, con máquinas que usan menos espacio que el tamaño de su entrada: las clases L y NL, donde el problema central es saber si en un grafo se llega de un nodo a otro.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Medir el espacio y Espacio y tiempo. Antes de la sesión B, Fórmulas booleanas cuantificadas. Con eso llegan con las definiciones y con los dos ejemplos que se evalúan en clase.
En clase: Sesión A, de Medir el espacio a El teorema de Savitch. Sesión B, de Fórmulas booleanas cuantificadas a PATH y la clase NL.
Después de clase: el Resumen y los Ejercicios, para repasar. La demostración completa de TQBF es PSPACE-completo se lee con calma después de la sesión B: en clase solo se explica la idea. Antes de intentar el ejercicio opcional de laboratorio, Geografía generalizada y El código de la semana.
Lectura. Sipser, sec. 8.1 (Savitch’s Theorem), 8.2 (The Class PSPACE), 8.3 (PSPACE-completeness) y 8.4 a 8.6 (The Classes L and NL, NL-completeness, NL equals coNL). Barak, capítulo 17 (Space bounded computation). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-14. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El ejercicio opcional de laboratorio está enlab/geography.
Medir el espacio
En la semana 12 el tiempo de una máquina fue el número de pasos que da. El espacio es el número de celdas que toca.
Sea una máquina de Turing determinista que se detiene con toda entrada. La complejidad en espacio (space complexity) de es la función tal que es el máximo número de celdas distintas de la cinta que el cabezal de visita, entre todas las entradas de longitud . Decimos que usa espacio .
Si es no determinista y todas sus ramas se detienen con toda entrada, es el máximo número de celdas que visita en alguna rama, entre todas las ramas y todas las entradas de longitud . Igual que con el tiempo, se mide el peor caso, y la peor rama.
Con eso se definen las clases, igual que y :
Dos observaciones sobre la definición.
- La entrada ocupa celdas. En la máquina de una cinta, la entrada está escrita en la misma cinta en la que se trabaja. Una máquina que lee toda su entrada ya visitó celdas, así que por ahora solo tienen sentido las funciones con . Para hablar de menos espacio que eso hace falta otro modelo, que aparece al final del capítulo.
- El modelo importa poco. Una máquina de varias cintas se simula en una sola guardando las cintas una a continuación de otra, como en la semana 7. La simulación tarda más, pero usa la misma cantidad de celdas, salvo una constante. Por eso podemos seguir describiendo las máquinas en alto nivel y contar su espacio como se cuenta la memoria de un programa.
Un primer ejemplo: SAT con espacio lineal
SAT es NP-completo, y nadie conoce un algoritmo de tiempo polinomial que lo decida. En espacio, en cambio, SAT es barato.
M = "Con la entrada ⟨φ⟩, donde φ es una fórmula booleana con variables x1, …, xm:
  1. Para cada asignación de valores a x1, …, xm:
  2.     Evaluar φ con esa asignación. Si resulta verdadera, aceptar.
  3. Si ninguna asignación sirvió, rechazar."
Hay asignaciones, así que tarda un tiempo exponencial. Pero no las guarda todas: guarda una, en celdas, y para pasar a la siguiente escribe encima de la anterior, como un contador binario que suma 1. Evaluar con una asignación fija necesita un espacio proporcional a la longitud de la fórmula. Si la entrada tiene longitud , entonces y todo cabe en celdas:
El programa eval_qbf de esta semana hace eso mismo cuando todos los cuantificadores son (el formato
del archivo se explica en la sesión B). La primera fórmula es satisfacible y la segunda no:
$ build/eval_qbf machines/sat_example.qbf machines/unsat_example.qbf
machines/sat_example.qbf: ∃x ∃y ∃z ((x ∨ y) ∧ (¬x ∨ ¬y) ∧ (¬x ∨ z) ∧ (y ∨ z))
valor: verdadero   llamadas: 7   llamadas activas a la vez: 4

machines/unsat_example.qbf: ∃x ∃y ((x ∨ y) ∧ (x ∨ ¬y) ∧ (¬x ∨ y) ∧ (¬x ∨ ¬y))
valor: falso   llamadas: 7   llamadas activas a la vez: 3
Las llamadas son el tiempo: con la fórmula que no es satisfacible, el programa recorre el árbol completo de las asignaciones de dos variables, que tiene nodos. Las llamadas activas a la vez son el espacio: nunca hay más de una por variable, más una para evaluar. Con variables, el tiempo puede llegar a llamadas y el espacio nunca pasa de .
Idea clave. El espacio se reutiliza y el tiempo no. Probar candidatos uno por uno cuesta veces el tiempo de probar uno, pero solo el espacio de probar uno, más un contador para saber por cuál vamos.
Espacio y tiempo
¿Qué relación hay entre el tiempo y el espacio de una misma máquina? En un sentido es inmediata.
Poco tiempo obliga a poco espacio. En cada paso el cabezal se mueve una celda. Una máquina que da pasos visita a lo sumo celdas: aquella en la que empezó y, como mucho, una nueva por paso. Entonces
Poco espacio no obliga a poco tiempo, como acaba de mostrar SAT. Pero sí pone un tope, y ese tope se calcula contando configuraciones.
Recuerden de la semana 7 que una configuración de una máquina de Turing es todo lo que hace falta para continuar el cómputo: el estado, el contenido de la cinta y la posición del cabezal. Sea una máquina de una cinta, con conjunto de estados y alfabeto de cinta , que con cierta entrada visita a lo sumo celdas. ¿Cuántas configuraciones distintas pueden aparecer en ese cómputo? Se cuentan las opciones de cada componente:
| Componente | Opciones |
|---|---|
| El estado | |
| La posición del cabezal, entre las celdas | |
| El contenido de las celdas, cada una con un símbolo de |
Las tres elecciones son independientes, así que el total es
Por ejemplo, la máquina de code/formats.md que decide tiene
estados y símbolos de cinta, y con una entrada de longitud
visita a lo sumo celdas: las cuatro de la entrada y el blanco que la sigue. La cuenta da
configuraciones. Es un tope muy holgado: con la entrada esa
máquina da 13 pasos y pasa por 14 configuraciones, como pueden comprobar siguiendo su tabla. Pero es un tope
que vale para cualquier máquina con esos tamaños.
Teorema. Si una máquina de Turing determinista usa espacio , con , y se detiene con toda entrada, entonces corre en tiempo .
Demostración. Por conteo y contradicción. Fijemos una entrada de longitud y escribamos por .
-
Hay a lo sumo configuraciones, para una constante que depende solo de la máquina. Tomando logaritmos en base 2, y usando que y que :
La constante es .
-
La máquina no repite ninguna configuración. Supongamos que la misma configuración aparece en los pasos y , con . La máquina es determinista: lo que hace a partir de depende solo de . Entonces después del paso repite exactamente lo que hizo después del paso , vuelve a pasar por , y así sin fin. Eso contradice que se detiene.
-
Como cada paso produce una configuración distinta de todas las anteriores, la máquina da menos de pasos. ∎
La hipótesis se usó sin decirlo: es lo que permite contar la entrada como parte de las celdas. En forma de clases, el teorema dice
Error común. Leer el teorema como “una máquina que usa espacio tarda ”. Es una cota superior: dice que no puede tardar más que eso sin entrar en un ciclo. Una máquina puede usar mucho espacio y terminar rápido.
La misma cuenta sirve para una máquina no determinista en la que todas las ramas se detienen: ninguna rama repite una configuración, porque si una rama pudiera volver a después de haber pasado por , la máquina podría elegir lo mismo otra vez y esa rama no se detendría nunca. Así que cada rama tiene menos de pasos. Lo usaremos en la demostración de Savitch.
PSPACE y la cadena de clases
P es la unión de las clases . La clase análoga para el espacio es
PSPACE son los lenguajes que se deciden con espacio polinomial, sin límite de tiempo. Con las clases de las semanas anteriores forma una cadena:
Cada inclusión tiene su razón.
- . Es de la semana 12: una máquina determinista es una no determinista que nunca elige.
- . Es el argumento de SAT, hecho para cualquier lenguaje de NP. Si , tiene un verificador de tiempo polinomial, con certificados de longitud a lo sumo . Una máquina determinista prueba todos los certificados de longitud a lo sumo , uno por uno, en el mismo espacio, y corre con cada uno. Acepta si acepta alguno. Guarda un certificado, que ocupa celdas, más lo que usa , que es polinomial porque su tiempo lo es. El tiempo total es exponencial, y el espacio, polinomial.
- . Es el teorema de la sección anterior. Recuerden que es la unión de las clases . Una máquina que decide con espacio corre en tiempo , y eso es a lo sumo para todo grande.
¿Cuáles de estas inclusiones son estrictas? Aquí está lo incómodo:
- Se sabe que . Lo demostraremos la próxima semana, con los teoremas de jerarquía.
- Entonces al menos una de las tres inclusiones de la cadena es estricta, porque si las tres fueran igualdades, P sería igual a EXPTIME.
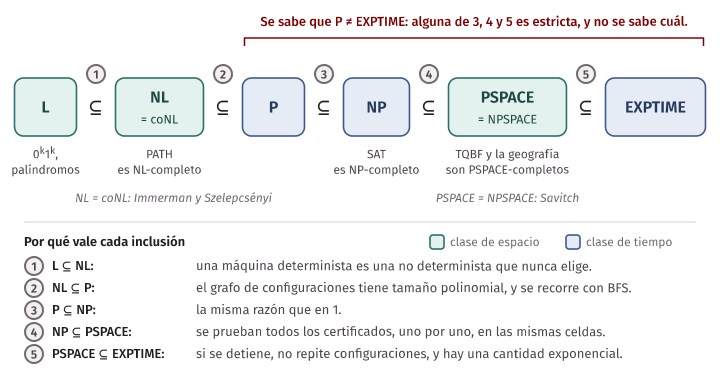
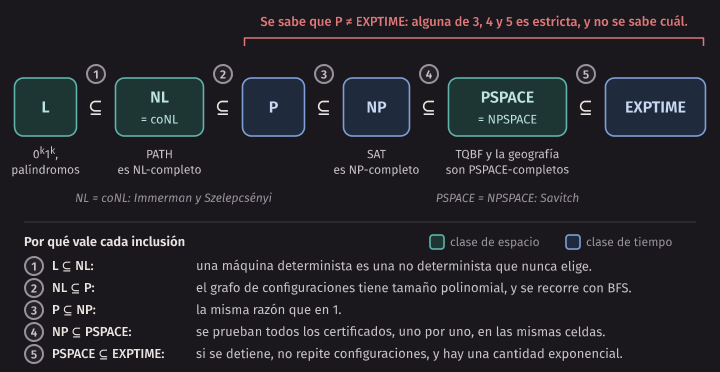
- No se sabe cuál. Nadie ha demostrado que , ni que , ni que . Ni siquiera se sabe si . Lo que casi todos creen es que las tres son estrictas.
Idea clave. , y de esa cadena solo se sabe que los extremos son distintos. Las inclusiones salen de dos hechos de esta semana: probar candidatos uno por uno reutiliza el espacio, y una máquina que no repite configuraciones no puede tardar más que la cantidad de configuraciones.
El teorema de Savitch
La pregunta de la semana 12, para el espacio: ¿cuánto espacio de más necesita una máquina determinista para hacer lo que hace una no determinista?
Teorema de Savitch. Para toda función con ,
Para el tiempo, lo mejor que se conoce es la simulación de la semana 7, que es exponencial. Aquí el costo es apenas elevar al cuadrado.
Un intento que no alcanza
Sea una máquina no determinista que decide un lenguaje con espacio . Lo primero que se ocurre es copiar lo que se hizo con el tiempo: recorrer las ramas de una por una, reutilizando el espacio, como con los certificados de NP.
Para recorrer las ramas en orden hay que recordar en cuál vamos, es decir, qué eligió en cada paso de la rama actual. Y ahí está el problema: una rama de una máquina de espacio puede tener pasos, como vimos recién. Anotar una elección por paso ocupa celdas. El recorrido de ramas muestra que , que es muy lejos de .
Con los certificados de NP el truco funcionó porque las ramas eran cortas, de longitud polinomial. Aquí son largas. Hace falta una idea que no recorra ramas.
La idea: partir el camino por la mitad
Dejemos de pensar en ramas y pensemos en un problema más general, que no menciona la aceptación:
Dadas dos configuraciones y de y un número , ¿puede pasar de a en a lo sumo pasos?
Lo llamamos el problema de alcance. Si lo resolvemos con poco espacio, resolvemos el original: acepta si y solo si de la configuración inicial se alcanza una de aceptación.
La observación es de divide y vencerás. Si pasa de a en a lo sumo pasos, entonces a mitad de camino está en alguna configuración , y
- de pasa a en a lo sumo pasos, y
- de pasa a en a lo sumo pasos.
No sabemos cuál es . Una máquina no determinista la adivinaría. Una determinista las prueba todas, una por una. Y aquí entra la diferencia entre espacio y tiempo: los dos subproblemas se resuelven uno después del otro, y el segundo usa las mismas celdas que usó el primero.
CANYIELD(c1, c2, t) = "Con las configuraciones c1 y c2 y el número t, una potencia de 2:
  1. Si t = 1: aceptar si c1 = c2, o si c1 produce c2 en un paso según las reglas de N.
     Si no, rechazar.
  2. Si t > 1: para cada configuración cm de N que usa a lo sumo f(n) celdas:
  3.     Correr CANYIELD(c1, cm, t/2).
  4.     Correr CANYIELD(cm, c2, t/2).
  5.     Si las dos aceptaron, aceptar.
  6. Si ninguna cm sirvió, rechazar."
La demostración
Demostración del teorema de Savitch. Por construcción: a partir de construimos una máquina determinista que decide el mismo lenguaje, y después contamos su espacio. Supongamos por ahora que puede calcular ; al final quitamos esa suposición.
Preparación. Dos ajustes a , que no cambian su lenguaje ni, salvo una constante, su espacio:
- Antes de aceptar, borra su cinta y lleva el cabezal a la primera celda. Así hay una sola configuración de aceptación, que llamamos .
- Sea una constante tal que tiene a lo sumo configuraciones que usan a lo sumo celdas. Existe por la cuenta de la sección Espacio y tiempo.
Qué se construye.
M = "Con la entrada w, de longitud n:
  1. Correr CANYIELD(c_start, c_accept, 2^(d·f(n))), donde c_start es la configuración
     inicial de N con w.
  2. Si acepta, aceptar. Si no, rechazar."
Por qué CANYIELD responde bien. Afirmación: para toda potencia de 2, , y todo par de configuraciones y que usan a lo sumo celdas, acepta si y solo si puede pasar de a en a lo sumo pasos. Por inducción sobre .
- Caso base, . “En a lo sumo un paso” quiere decir en cero pasos, y entonces , o en un paso. Es lo que revisa la línea 1.
- Paso inductivo, . Supongamos la afirmación para .
- Si CANYIELD acepta, encontró una con la que las dos llamadas aceptaron. Por la hipótesis, pasa de a en a lo sumo pasos y de a en a lo sumo . Juntando los dos tramos, pasa de a en a lo sumo .
- Si pasa de a en pasos, sea la configuración en la que está después de pasos. El primer tramo tiene pasos y el segundo . Por la hipótesis, las dos llamadas con esa aceptan, y el ciclo de la línea 2 llega a ella porque las prueba todas.
Por qué M decide el lenguaje de N. Si acepta , alguna rama llega a . Esa rama no repite configuraciones, así que tiene menos de pasos, y CANYIELD acepta. Si CANYIELD acepta, pasa de a , es decir, alguna rama acepta. Y siempre se detiene, porque la recursión baja a la mitad en cada nivel y cada ciclo recorre una cantidad finita de configuraciones.
Cuánto espacio usa M. Cada llamada a CANYIELD guarda sus datos: , , la que está probando y el número .
- Una configuración que usa celdas se escribe en celdas.
- es una potencia de 2 que no pasa de . Basta guardar su exponente, que es un número entre y : ocupa celdas.
Cada llamada ocupa entonces celdas. ¿Cuántas llamadas hay activas a la vez? Las llamadas de las líneas 3 y 4 no están activas al mismo tiempo: la de la línea 4 empieza cuando la de la línea 3 ya terminó y devolvió su espacio. Así que las llamadas activas forman una sola cadena, una por nivel de la recursión, y los niveles son los valores que toma :
Son niveles. El espacio total es
Eso demuestra el teorema cuando conoce . ∎
Idea clave. En la demostración de Savitch, cada nivel de la recursión guarda un número constante de configuraciones, de tamaño , y hay niveles, porque un camino de pasos se parte por la mitad veces. De ahí el cuadrado.
Si la máquina no conoce f(n)
La máquina necesita para dos cosas: para saber qué configuraciones recorrer en la línea 2 de CANYIELD y para escribir el primer valor de . Si es una función que se puede calcular con espacio , como o , empieza por calcularla. Esas funciones se llaman construibles y vuelven la próxima semana. Para una cualquiera hay otra salida: probar con hasta que alcance.
Para cada valor , llamemos configuraciones de tamaño a las que usan a lo sumo celdas, y al procedimiento de antes cuando recorre solo esas configuraciones y empieza con .
M = "Con la entrada w, de longitud n:
  1. Para i = n, n + 1, n + 2, …  (si n = 0, desde i = 1):
  2.     Correr CANYIELD_i(c_start, c_accept, 2^(d·i)). Si acepta, aceptar.
  3.     Para cada configuración c de tamaño i + 1 con el cabezal en la celda i + 1:
             correr CANYIELD_(i+1)(c_start, c, 2^(d·(i+1))).
  4.     Si ninguna de las llamadas de la línea 3 aceptó, rechazar.
         Si alguna aceptó, seguir con el siguiente valor de i."
La línea 3 pregunta si , con la entrada , llega alguna vez a poner el cabezal en la celda ; es decir, si en alguna rama usa más de celdas.
- se detiene. nunca usa más de celdas. Cuando llega a , ninguna configuración con el cabezal en la celda se alcanza, y termina en la línea 2 o en la 4. Puede terminar antes.
- Si acepta, acepta, porque encontró un camino de a .
- Si rechaza con el valor , no acepta. La línea 4 dice que nunca sale de las primeras celdas, así que todas sus ramas pasan solo por configuraciones de tamaño . Y la línea 2 dice que, pasando solo por esas, no se llega a .
- El espacio. El valor de nunca pasa de , así que cada vuelta usa celdas, y cada vuelta reutiliza las de la anterior.
El teorema también vale con la hipótesis más débil , con el modelo de dos cintas del final del capítulo. La demostración es la misma, y la configuración incluye además la posición del cabezal de la entrada.
La recursión en un grafo, con números
La demostración no usa casi nada de las máquinas de Turing. Las configuraciones son los nodos de un grafo, “pasa
en un paso” es una arista, y CANYIELD pregunta si hay un camino de un nodo a otro con a lo sumo aristas.
savitch.h tiene esa recursión para un grafo cualquiera:
inline bool can_yield(const Graph& g, int u, int v, long long t, int depth, SavitchStats& stats) {
    stats.calls++;
    stats.max_depth = std::max(stats.max_depth, depth);
    if (t == 1) {
        return u == v || has_edge(g, u, v);
    }
    int n = static_cast<int>(g.nodes.size());
    for (int middle = 0; middle < n; middle++) {
        // Las dos llamadas usan el mismo espacio: la segunda empieza cuando la primera terminó.
        if (can_yield(g, u, middle, t / 2, depth + 1, stats) && can_yield(g, middle, v, t / 2, depth + 1, stats)) {
            return true;
        }
    }
    return false;
}
Fíjense en lo que no tiene: ninguna marca de nodos visitados, ninguna cola. Lo único que guarda cada
llamada son tres nodos (u, v y middle) y el número t. El programa savitch_demo la corre en el grafo
más simple posible, un camino , y pregunta si de se llega a .
Al lado pone el algoritmo que ustedes usarían, BFS.
$ build/savitch_demo
   n     t   llega   Savitch: llamadas  activas  bits   BFS: aristas  cola  bits
   4     4   sí                    20        3    24              3     1     6
   8     8   sí                   443        4    44              7     1    11
  16    16   sí                 47038        5    75             15     1    20
  32    32   sí              22290333        6   108             31     1    37
Cómo se leen las columnas:
- llamadas y aristas son el tiempo de cada algoritmo. BFS examina cada arista una vez. La recursión de Savitch, con 32 nodos, hace más de 22 millones de llamadas.
- activas es la cantidad máxima de llamadas activas a la vez: , los valores .
- bits es la memoria, contando bits por nodo. Para Savitch, tres nodos y el exponente de por cada llamada activa. Para BFS, un bit de visitado por nodo más los nodos de la cola.
La animación sigue la primera fila de la tabla, la del camino de 4 nodos, llamada por llamada:
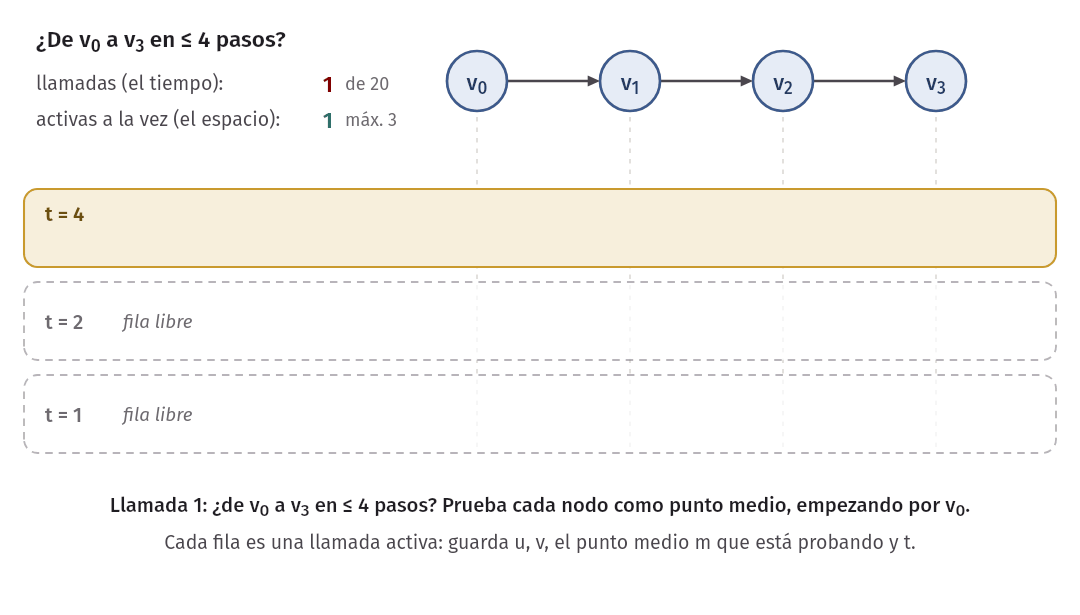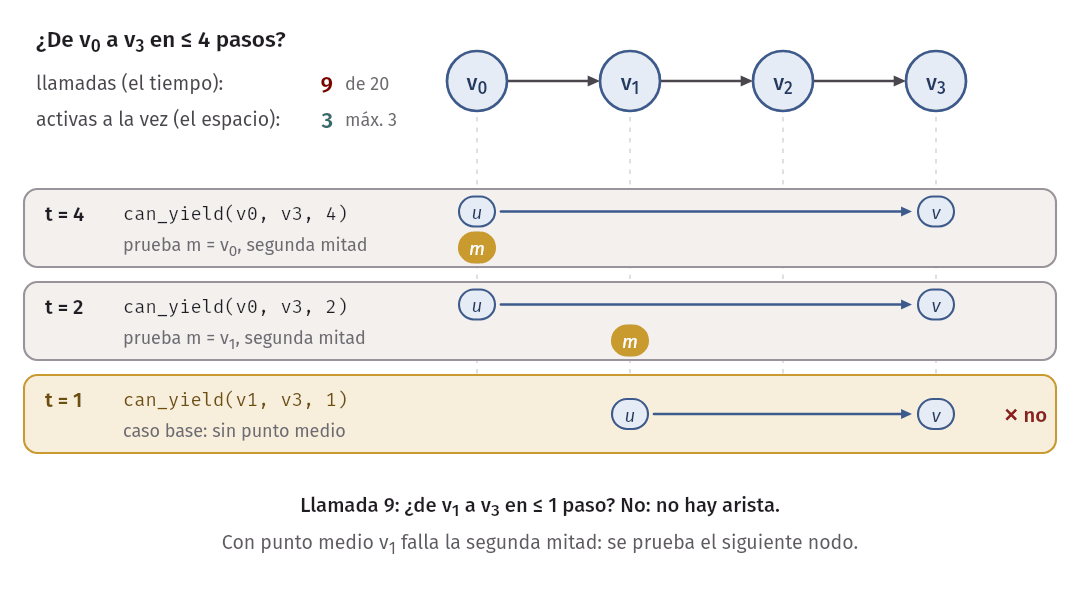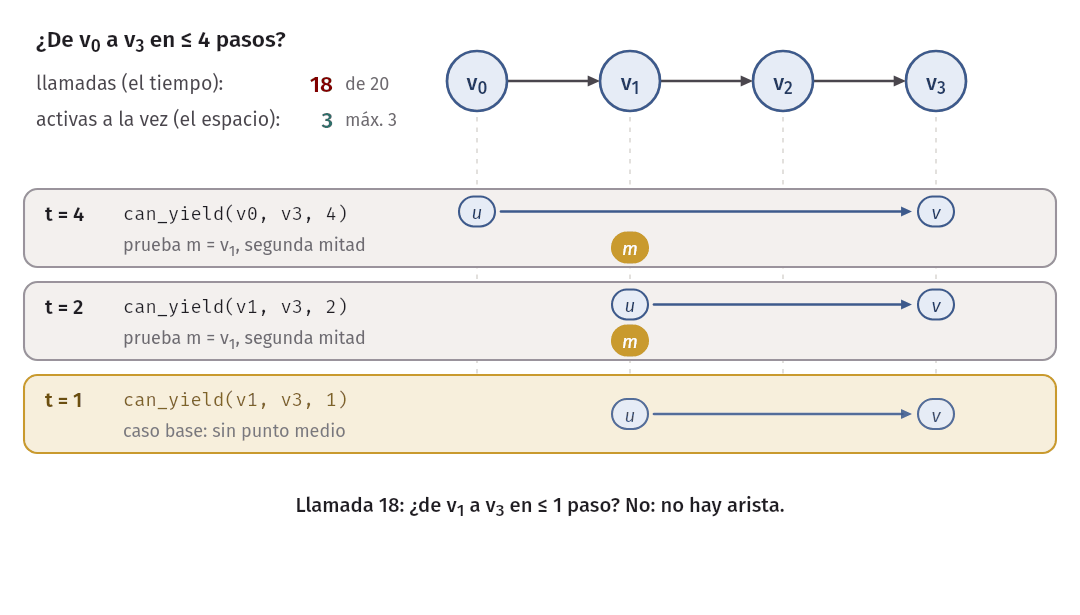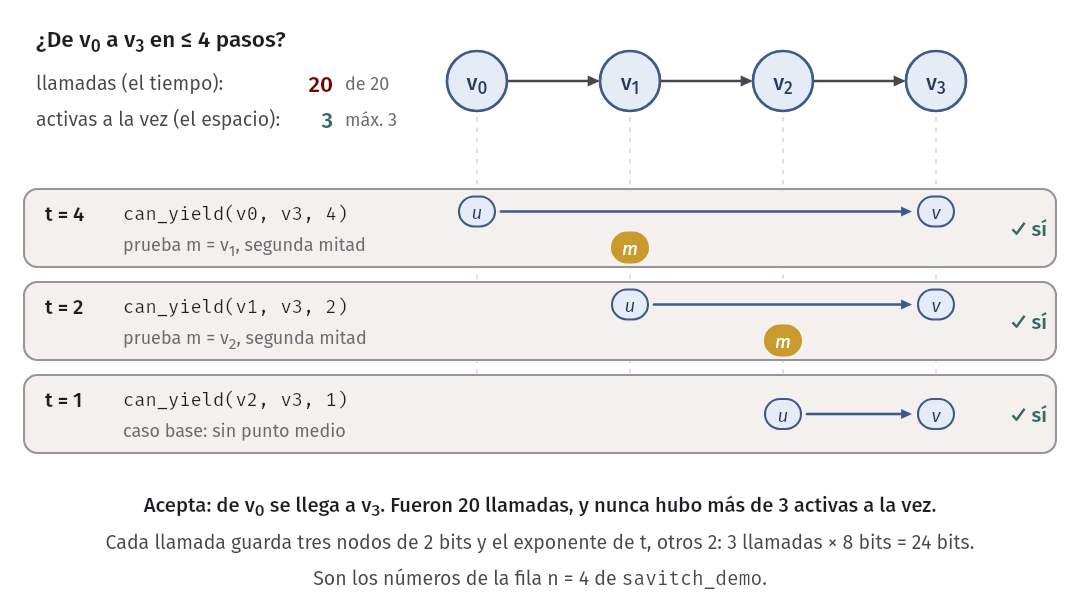
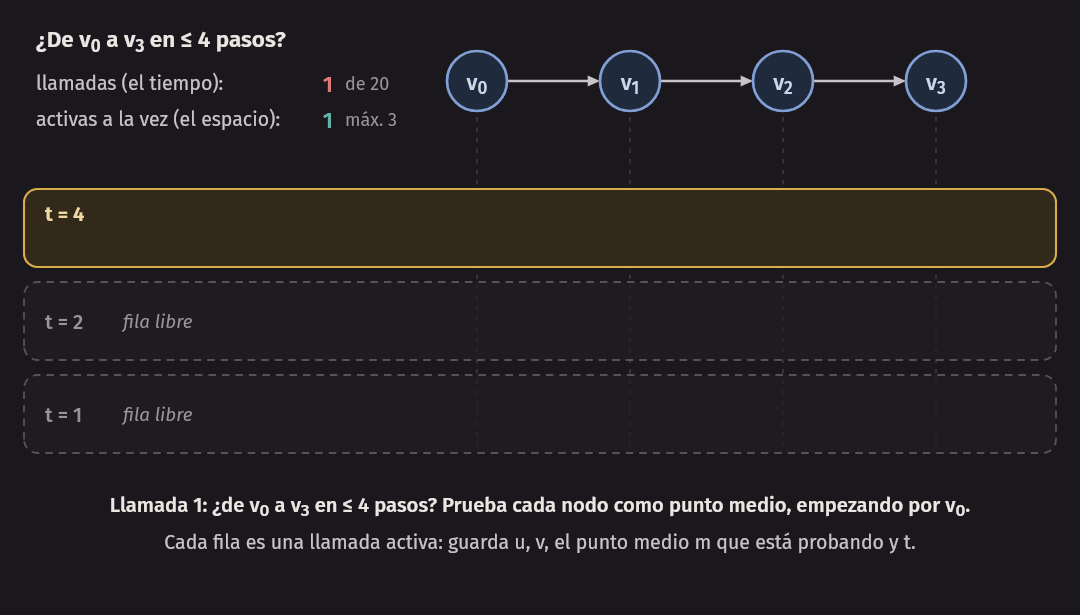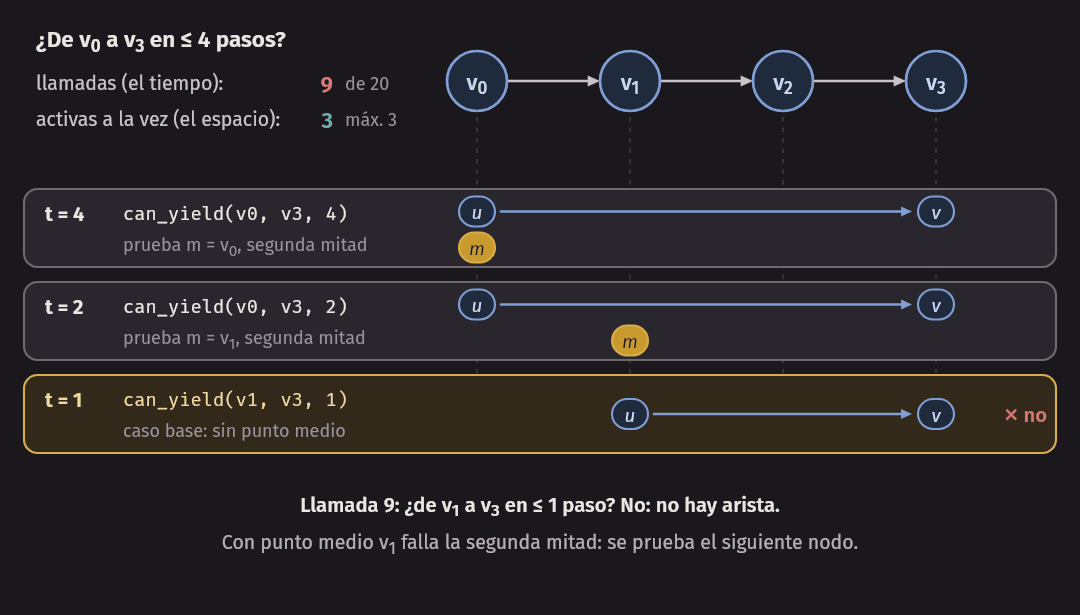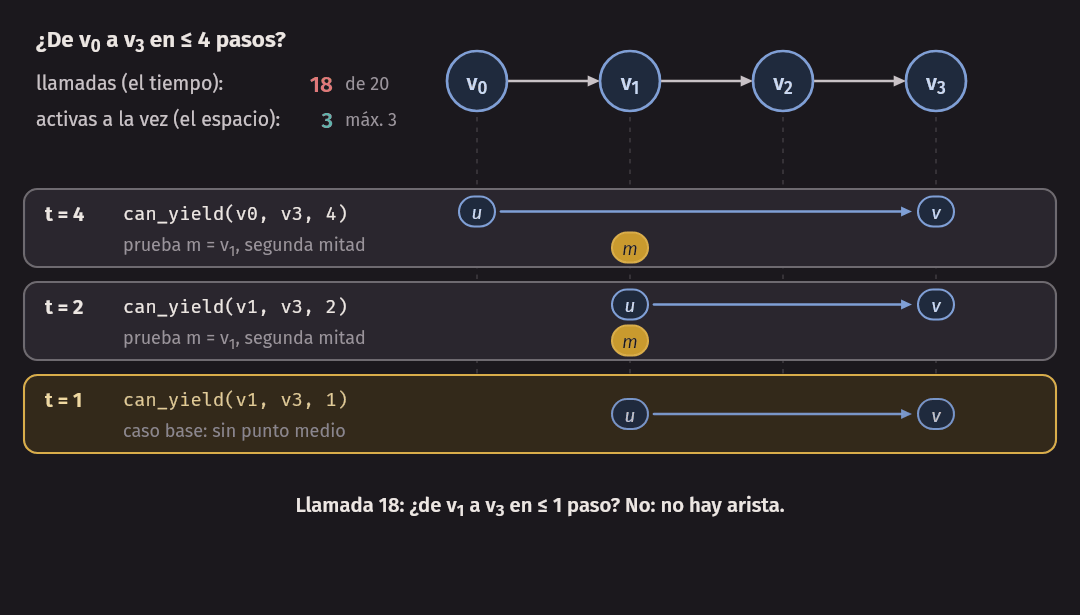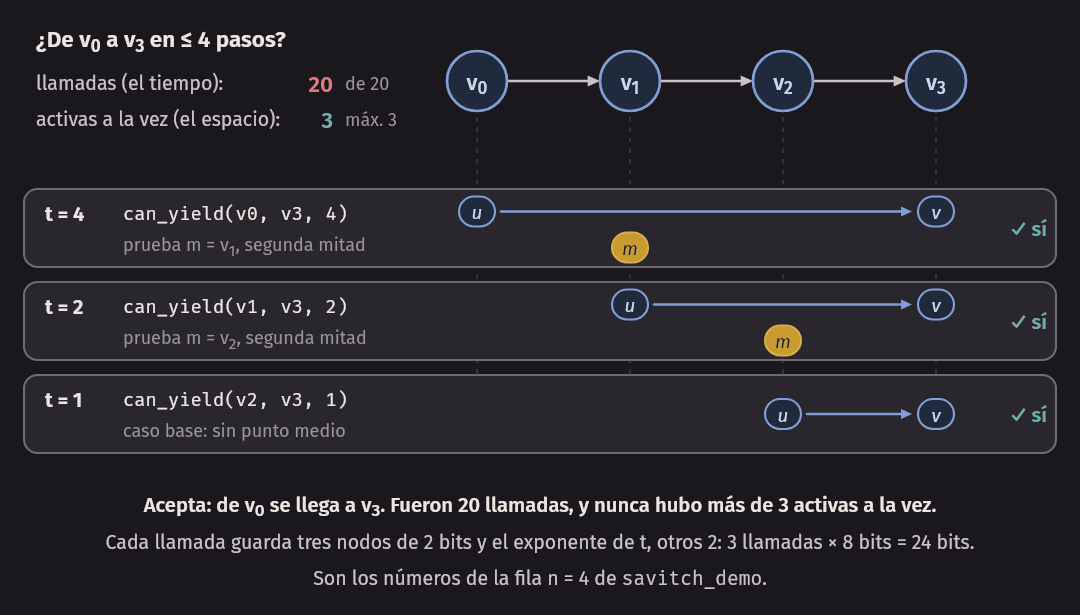
Con estos tamaños BFS gana en todo, también en memoria. El teorema habla de cómo crecen las dos columnas de bits. La de BFS crece como , porque necesita una marca por nodo. La de Savitch crece como : unos niveles con unos bits cada uno. Para un grafo de nodos, poco más de un millón, la cuenta con las mismas fórmulas del programa da
para Savitch, contra más de un millón de bits solo para las marcas de BFS. Ese número está calculado, no medido: nadie va a esperar a que esa recursión termine. La columna de llamadas muestra por qué.
En la práctica. Cambiar memoria por tiempo de esta manera es una técnica real. La búsqueda en profundidad con profundidad creciente, que usan los programas que resuelven rompecabezas, vuelve a explorar los mismos estados para no tener que guardarlos, porque en un espacio de búsqueda grande la memoria se acaba mucho antes que la paciencia.
Por qué el mismo argumento no sirve para el tiempo
Si la recursión de Savitch convierte no determinismo en determinismo, ¿por qué no demuestra que ? Porque todo el ahorro vino de reutilizar, y el tiempo no se reutiliza.
Contemos el tiempo de CANYIELD. Sea el número de llamadas para un valor de y el número de configuraciones que recorre el ciclo. En el peor caso, cada vuelta del ciclo hace dos llamadas con :
Al desarrollar la recurrencia, el factor aparece una vez por nivel, y hay niveles: . Con configuraciones y , eso es : mucho más que las configuraciones que existen, que es lo que tardaría un recorrido que las marcara como visitadas. La tabla de arriba lo muestra en pequeño: con y , más de 22 millones de llamadas para un grafo con 31 aristas.
En el espacio, las dos mitades cuestan lo mismo que una, porque la segunda usa las celdas de la primera. En el tiempo, las dos mitades cuestan el doble que una, y además hay que pagar una vez por cada punto medio que se prueba.
Error común. Aplicar el argumento de Savitch al tiempo y concluir que . Las dos mitades reutilizan el espacio, pero sus tiempos se suman, y se suman para cada uno de los puntos medios. El teorema de Savitch no dice nada sobre P y NP.
PSPACE es igual a NPSPACE
El cuadrado de un polinomio es un polinomio. Si usa espacio , la máquina del teorema usa espacio . Entonces , y como la otra inclusión es inmediata,
En espacio polinomial, adivinar no agrega nada. Tiene una consecuencia práctica para lo que sigue: para mostrar que un problema está en PSPACE podemos describir un algoritmo no determinista de espacio polinomial, si resulta más cómodo.
| Pregunta | Tiempo polinomial | Espacio polinomial |
|---|---|---|
| ¿El no determinismo agrega poder? | No se sabe: es frente a | No: |
| ¿La clase es cerrada bajo complemento? | P sí; de NP no se sabe: es frente a | Sí, porque PSPACE es determinista |
La segunda fila sale sola: una máquina determinista que siempre se detiene se complementa intercambiando aceptar y rechazar, y eso no cambia su espacio.
Fórmulas booleanas cuantificadas
La semana 13 mostró que SAT es el problema más difícil de NP. Para PSPACE hace falta un problema con más estructura, y se obtiene de SAT agregando un ingrediente: el cuantificador “para todo”.
Los cuantificadores son (“existe”) y (“para todo”). Aquí las variables son booleanas, así que cada una toma solo dos valores, (falso) y (verdadero):
- es verdadera si es verdadera con o con .
- es verdadera si es verdadera con y con .
Una fórmula booleana cuantificada (quantified Boolean formula) es una fórmula booleana a la que se le agregaron cuantificadores. Dos condiciones, que supondremos siempre:
- Está totalmente cuantificada: cada variable que aparece tiene su cuantificador. Solo así la fórmula es verdadera o falsa por sí misma. Una fórmula como no tiene valor mientras no se diga quién es .
- Está en forma prenex: todos los cuantificadores van al principio, y después viene una fórmula sin cuantificadores. Toda fórmula cuantificada se puede llevar a esta forma moviendo los cuantificadores hacia la izquierda, después de cambiar los nombres de las variables que se repitan.
Una fórmula en forma prenex se escribe
donde cada es o y no tiene cuantificadores. La lista es el prefijo y es la matriz. El problema de la semana es
La sigla viene de true quantified Boolean formulas.
SAT es un caso particular. Una fórmula con variables es satisfacible exactamente cuando la fórmula cuantificada es verdadera. Y es una tautología exactamente cuando es verdadera. Lo nuevo de TQBF es que los dos cuantificadores se alternan.
El orden importa
Tomemos la matriz
La primera cláusula dice que alguna de las dos es verdadera y la segunda, que alguna es falsa. Juntas dicen que e son distintas. Con esa misma matriz hay dos fórmulas cuantificadas que se parecen mucho:
es verdadera. Dice: para cada valor de hay un valor de distinto de él. Hay que revisar los dos valores de :
- Con , sirve : .
- Con , sirve : .
es falsa. Dice: hay un valor de que es distinto de todos los valores de . Hay que revisar los dos candidatos:
- Con , falla : .
- Con , falla : .
La diferencia está en quién elige primero. En , la se elige después de conocer , y puede depender de ella. En , la se elige antes, y tiene que servir para toda . Es la diferencia entre “toda persona tiene una madre” y “hay una madre de todas las personas”.
Error común. Intercambiar un con un vecino como si fuera lo mismo. Dos cuantificadores iguales que están juntos sí se pueden intercambiar: es lo mismo que . Dos distintos, no: implica , y lo contrario es falso, como acaban de ver.
El formato de los ejemplos
Los programas de la semana leen fórmulas en forma prenex cuya matriz está en CNF, la forma normal conjuntiva
de la semana 13: una conjunción de cláusulas, cada una una disyunción de literales. El archivo tiene dos campos,
con las reglas comunes de code/formats.md (comentarios con #, un campo por línea):
$ cat machines/forall_exists.qbf
# ∀x ∃y ((x ∨ y) ∧ (¬x ∨ ¬y)): para cada x hay una y distinta. Verdadera.
prefix: A x E y
clauses:
x y
-x -yprefix:es el prefijo, de izquierda a derecha: una letra,Apara oEpara , y después el nombre de la variable. El nombre es una palabra sin espacios que no empieza con guion.- Después de
clauses:va una cláusula por línea, con sus literales separados por espacios. Un literal negado lleva un guion delante:-xes . - Una fórmula sin cláusulas es verdadera, porque una conjunción vacía lo es.
Si una cláusula usa una variable que no está en el prefijo, la fórmula no está totalmente cuantificada, y el programa no la acepta como entrada:
$ build/eval_qbf errors/free_variable.qbf
error: errors/free_variable.qbf: la variable z no tiene cuantificador: la fórmula no está totalmente cuantificada
En C++. El
struct Qbfdeqbf.htiene las tres partes de la definición:variables, con en el orden del prefijo;quantifiers, con el cuantificador de cada una,'E'o'A'; yclauses, con la matriz. Un literal es unint, como en el formato DIMACS de la semana 13:ies y-ies , contando desde 1.
TQBF está en PSPACE
Para evaluar una fórmula cuantificada basta seguir la definición de los cuantificadores, de afuera hacia adentro.
T = "Con la entrada ⟨φ⟩, una fórmula booleana totalmente cuantificada:
  1. Si φ no tiene cuantificadores, es una expresión con constantes: evaluarla y aceptar
     si es verdadera. Si no, rechazar.
  2. Si φ = ∃x ψ: correr T con ψ y x = 0, y después con ψ y x = 1.
     Aceptar si alguna de las dos aceptó.
  3. Si φ = ∀x ψ: correr T con ψ y x = 0, y después con ψ y x = 1.
     Aceptar si las dos aceptaron."
En qbf.h es la función evaluate. Los valores elegidos hasta el momento están en un solo vector, values,
que todas las llamadas comparten:
inline bool evaluate(const Qbf& f, std::vector<bool>& values, std::size_t i, EvalStats& stats) {
    stats.calls++;
    stats.max_depth = std::max(stats.max_depth, static_cast<int>(i) + 1);
    if (i == f.variables.size()) {
        return matrix_value(f, values);
    }
    values[i] = false;
    bool with_false = evaluate(f, values, i + 1, stats);
    if (f.quantifiers[i] == 'E' && with_false) {
        return true;   // ∃: basta un valor
    }
    if (f.quantifiers[i] == 'A' && !with_false) {
        return false;  // ∀: basta un valor que falle
    }
    values[i] = true;
    return evaluate(f, values, i + 1, stats);
}
El programa eval_qbf, con la opción --tree, imprime lo que la recursión va probando. Estas son las dos
fórmulas de la sección anterior:
$ build/eval_qbf --tree machines/forall_exists.qbf
machines/forall_exists.qbf: ∀x ∃y ((x ∨ y) ∧ (¬x ∨ ¬y))
x = 0
  y = 0   ψ = falso
  y = 1   ψ = verdadero
  ∃y: verdadero
x = 1
  y = 0   ψ = verdadero
  ∃y: verdadero
∀x: verdadero
valor: verdadero   llamadas: 6   llamadas activas a la vez: 3
$ build/eval_qbf --tree machines/exists_forall.qbf
machines/exists_forall.qbf: ∃y ∀x ((x ∨ y) ∧ (¬x ∨ ¬y))
y = 0
x = 0 ψ = falso
∀x: falso
y = 1
x = 0 ψ = verdadero
x = 1 ψ = falso
∀x: falso
∃y: falso
valor: falso llamadas: 6 llamadas activas a la vez: 3Es la misma cuenta que hicimos a mano. Un deja de probar cuando encuentra un valor que sirve, y un , cuando encuentra uno que falla.
Teorema. .
Demostración. El algoritmo decide TQBF porque sigue la definición de y de . Contemos su espacio con una fórmula de longitud y variables. La recursión tiene un nivel por cuantificador, así que su profundidad es a lo sumo . Cada nivel guarda solo el valor de una variable: un bit. Las dos llamadas de un mismo nivel, con y con , se hacen una después de la otra y usan las mismas celdas. En el fondo, evaluar la matriz con todos los valores fijados usa espacio . En total, : espacio lineal. ∎
El tiempo es otra historia. El programa qbf_growth evalúa una familia de fórmulas verdaderas que repite el
ejemplo de arriba con pares de variables:
$ build/qbf_growth
∀x1 ∃y1 ∀x2 ∃y2 ((x1 ∨ y1) ∧ (¬x1 ∨ ¬y1) ∧ (x2 ∨ y2) ∧ (¬x2 ∨ ¬y2))

 k   variables   valor       llamadas   activas a la vez
 1           2   verdadero          6                  3
 2           4   verdadero         19                  5
 3           6   verdadero         51                  7
 4           8   verdadero        127                  9
 5          10   verdadero        303                 11
 6          12   verdadero        703                 13
 7          14   verdadero       1599                 15
 8          16   verdadero       3583                 17
 9          18   verdadero       7935                 19
10          20   verdadero      17407                 21
11          22   verdadero      37887                 23
12          24   verdadero      81919                 25
La primera línea es la fórmula para . Cada vez que sube en uno, las llamadas crecen a poco más del doble, y las llamadas activas a la vez suben en dos: una por variable, más la que evalúa la matriz. El tiempo crece exponencialmente y el espacio, linealmente. Y esta familia es favorable: cada encuentra su valor en el primer o el segundo intento y corta.
En la práctica. Existen solucionadores de fórmulas cuantificadas, como existen solucionadores SAT, y se usan para verificar circuitos y para planificar contra un adversario. Resuelven instancias mucho más pequeñas que las que resuelve un solucionador SAT: la alternancia de cuantificadores es más difícil también en la práctica.
TQBF es PSPACE-completo
La definición copia la de NP-completo, cambiando la clase.
Un lenguaje es PSPACE-completo si cumple dos condiciones:
- , y
- todo lenguaje de PSPACE se reduce a en tiempo polinomial: .
Si solo cumple la segunda, es PSPACE-difícil. La reducción sigue siendo en tiempo polinomial, aunque la clase sea de espacio. La razón es la de siempre: una reducción tiene que ser más débil que la clase que se estudia. Si se permitieran reducciones de espacio polinomial, la reducción misma podría resolver el problema, y casi todos los lenguajes de PSPACE resultarían completos.
La consecuencia también es la de siempre. Si un lenguaje PSPACE-completo estuviera en P, todo PSPACE estaría en P. Y si estuviera en NP, todo PSPACE estaría en NP.
Teorema. TQBF es PSPACE-completo.
Ya vimos que está en PSPACE. Falta reducir todo lenguaje de PSPACE a TQBF, y estamos en la situación del teorema de Cook-Levin: no hay un problema anterior desde el cual reducir. Lo único que sabemos de un lenguaje de PSPACE es que lo decide alguna máquina con espacio polinomial. La reducción recibe una cadena y tiene que escribir, en tiempo polinomial, una fórmula cuantificada que sea verdadera si y solo si acepta .
Por qué no basta repetir Cook-Levin
En la semana 13 la fórmula describía un tableau: una fila por configuración, una fila por paso. Eso funcionó porque la máquina corría en tiempo polinomial y el tableau tenía un número polinomial de filas. Una máquina de espacio puede dar pasos. Su tableau tiene un número exponencial de filas, y la fórmula que lo describe no se puede ni escribir en tiempo polinomial.
La idea: Savitch escrito como fórmula
No vamos a describir el cómputo paso a paso. Vamos a escribir, como fórmula, la pregunta de alcance del teorema de Savitch. Para dos configuraciones y y un número , queremos una fórmula que diga ” pasa de a en a lo sumo pasos”.
Primer intento. Copiar la recursión de CANYIELD: existe un punto medio tal que las dos mitades se cumplen.
Dice lo correcto, y el reemplaza al ciclo que probaba todos los puntos medios. Pero miren el tamaño. La fórmula para contiene dos copias de la fórmula para . Cada vez que baja a la mitad, el tamaño se duplica, y con la fórmula final tiene tamaño al menos : exponencial. Hemos vuelto a escribir el tableau por otro camino.
En el algoritmo de Savitch las dos mitades no costaban el doble porque reutilizaban el espacio. Una fórmula no “reutiliza”: lo que está escrito dos veces ocupa dos veces. Hace falta decir las dos mitades con una sola copia de la subfórmula.
El truco del . Se escribe la subfórmula una sola vez, con dos configuraciones nuevas y en lugar de sus extremos, y se exige que valga para los dos pares que interesan:
“Para todo par que sea o ” dice lo mismo que la conjunción de las dos mitades, pero la subfórmula aparece una vez. Ahora, cada vez que baja a la mitad, el tamaño no se duplica: solo se le suma lo que ocupa escribir el prefijo nuevo. Como se divide entre 2 un número polinomial de veces, la fórmula final tiene tamaño polinomial.
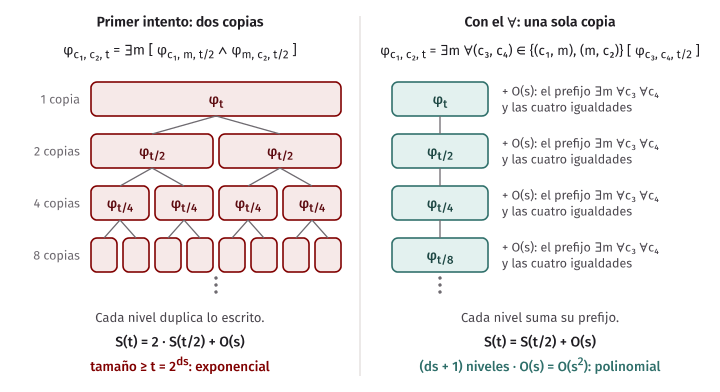
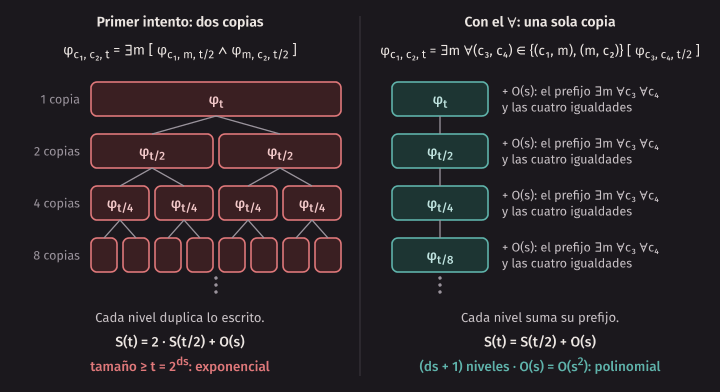
Idea clave. La demostración de que TQBF es PSPACE-completo es la recursión de Savitch escrita como fórmula. El hace el trabajo de “probar todos los puntos medios”. El hace el trabajo de “resolver las dos mitades en el mismo espacio”: permite escribir la subfórmula una sola vez.
Eso es lo que se explica en clase. Lo que sigue es la demostración con sus detalles.
La demostración completa
Demostración de que TQBF es PSPACE-difícil. Por reducción: para un lenguaje cualquiera de PSPACE damos una reducción de a TQBF en tiempo polinomial. Va en esa dirección porque queremos mostrar que TQBF es al menos tan difícil como : quien decida TQBF decide .
Los datos. Sea una máquina determinista de una cinta que decide y que, con entradas de longitud , visita a lo sumo celdas. Como en la demostración de Savitch, hacemos que borre la cinta y lleve el cabezal a la primera celda antes de aceptar, para que haya una sola configuración de aceptación, . Y sea una constante tal que tiene a lo sumo configuraciones con celdas.
Cómo se nombra una configuración con variables booleanas. Igual que una fila del tableau de la semana 13. Una configuración se escribe como una fila: una cadena de símbolos sobre el alfabeto de las celdas del tableau, con el contenido de las celdas y el estado escrito justo antes de la celda donde está el cabezal. Para hablar de una configuración sin conocerla, se usa un grupo de variables
donde verdadera quiere decir “el símbolo número de es ”. Son variables por configuración: . Cuando escribimos o para una configuración, es una abreviatura de un bloque de cuantificadores iguales, uno por cada variable del grupo.
El caso base, . La fórmula no lleva cuantificadores. Es la conjunción de dos partes, y las dos ya aparecieron en la demostración de Cook-Levin:
- y están bien escritas: en cada posición hay exactamente un símbolo. Es el primer grupo de cláusulas de la semana 13.
- , o bien sale de en un paso de . La igualdad es una conjunción de equivalencias . El paso se dice con las ventanas de la semana 13, aplicadas a un tableau de solo dos filas, arriba y abajo: todas las ventanas son legales.
Su tamaño es : una cantidad constante de símbolos por cada posición .
El paso recursivo, . Con tres grupos de variables nuevas, , y :
Esta es la forma precisa de "". Cada igualdad entre configuraciones es una conjunción de equivalencias entre variables. Cada nivel usa variables con nombres nuevos, distintos de los de todos los otros niveles.
La fórmula final. Con dos grupos más de variables, para la configuración inicial y la de aceptación:
con . Las dos frases entre comillas son conjunciones de variables sueltas, una por posición: dicen qué símbolo va en cada lugar, como la primera fila del tableau.
Por qué es correcta. Afirmación: para toda potencia de 2, , y para todos los valores que se les den a las variables de y , la fórmula es verdadera si y solo si esos valores describen dos configuraciones de y pasa de la primera a la segunda en a lo sumo pasos. Por inducción sobre .
-
Caso base. Es lo que dicen las dos partes de , por lo demostrado en la semana 13 sobre las ventanas.
-
Paso inductivo. Fijemos los valores de , y . La condición que está a la izquierda de la flecha se cumple para dos valores del par y para ningún otro: cuando es y cuando es . Para todos los demás valores, la implicación es verdadera sin importar lo que diga . Entonces lo que está dentro del corchete vale para todo exactamente cuando y son verdaderas. Por lo tanto
Por la hipótesis inductiva, el lado derecho dice que hay una configuración a la que llega desde en a lo sumo pasos y desde la cual llega a en a lo sumo . Eso equivale a que pasa de a en a lo sumo pasos, por el mismo argumento del punto medio que en la demostración de Savitch.
Con la afirmación, la fórmula final es verdadera si y solo si pasa de su configuración inicial con a en a lo sumo pasos. Como es determinista y se detiene, no repite configuraciones y da menos de pasos. Así que eso ocurre si y solo si acepta :
Por qué se construye en tiempo polinomial. Sea el tamaño de , contando cada variable como un símbolo. Cada nivel agrega su prefijo y sus cuatro igualdades, que son símbolos, y contiene una copia del nivel siguiente:
Los niveles son los valores : son . Entonces
Compárenlo con el primer intento, donde la recurrencia era y daba un tamaño de al menos . La fórmula tiene variables, y escribir el nombre de cada una en binario agrega un factor . La reducción la escribe de afuera hacia adentro, nivel por nivel, en tiempo polinomial.
Un último detalle: la forma prenex. La fórmula no quedó en forma prenex, porque los cuantificadores de cada nivel están dentro de la implicación del nivel anterior. Se pueden mover al principio sin cambiar el valor: las variables de cada nivel tienen nombres propios y no aparecen en la condición de la izquierda de la flecha, y para una condición en la que no aparece , las fórmulas y valen lo mismo. Igual con . ∎
Comparen las tres demostraciones “desde cero” del curso. Para mostrar que es indecidible no había de dónde reducir, y se usó la diagonal. Para Cook-Levin, la fórmula describió el tableau. Para TQBF, la fórmula describe la recursión de Savitch. En los tres casos, lo único que se sabe del problema de partida es que lo decide, o lo reconoce, una máquina.
Un juego es una fórmula cuantificada
¿Por qué importa un problema sobre fórmulas con cuantificadores? Porque es, casi literalmente, el problema de decidir quién gana un juego.
Tomen una fórmula en forma prenex, , y dos jugadores: E, que juega con los , y A, que juega con los . El juego de la fórmula se juega así:
- Se recorren las variables en el orden del prefijo.
- Si la variable tiene un , su valor lo elige E. Si tiene un , lo elige A.
- Cuando todas tienen valor, se evalúa . Si es verdadera, gana E. Si es falsa, gana A.
Una estrategia ganadora (winning strategy) para un jugador es una regla que le dice qué elegir en cada turno, en función de lo que se eligió antes, y con la que gana haga lo que haga el otro.
Teorema. E tiene una estrategia ganadora en el juego de si y solo si es verdadera.
Demostración. Por inducción sobre el número de cuantificadores. Sin cuantificadores, no hay nada que elegir: E gana exactamente cuando es verdadera. Si , E elige primero. Tiene una estrategia ganadora exactamente cuando hay un valor tal que, después de poner , tiene una estrategia ganadora en el juego que queda. Por la hipótesis, eso pasa cuando con es verdadera para algún : es la definición de . Si , elige A, y E necesita una estrategia ganadora para cada una de las dos elecciones de A: por la hipótesis, que sea verdadera con y con . Es la definición de . ∎
El mismo argumento, con los papeles cambiados, muestra que si es falsa, la estrategia ganadora la tiene A. Siempre la tiene uno de los dos.
Con las fórmulas de antes: en , A elige y E responde con la contraria. E gana siempre, y su estrategia es “elegir lo contrario de lo que eligió A”. En , E tiene que elegir primero, y A responde copiando: gana A. Una partida de tres jugadas:
$ build/eval_qbf --tree machines/three_moves.qbf
machines/three_moves.qbf: ∃x ∀y ∃z ((x ∨ y) ∧ (¬y ∨ z) ∧ (¬x ∨ ¬z ∨ y))
x = 0
  y = 0
    z = 0   ψ = falso
    z = 1   ψ = falso
    ∃z: falso
  ∀y: falso
x = 1
  y = 0
    z = 0   ψ = verdadero
    ∃z: verdadero
  y = 1
    z = 0   ψ = falso
    z = 1   ψ = verdadero
    ∃z: verdadero
  ∀y: verdadero
∃x: verdadero
valor: verdadero   llamadas: 11   llamadas activas a la vez: 4
El árbol que imprime el programa es el árbol del juego, y en él se lee la estrategia de E: empezar con ; después, si A elige , responder , y si A elige , responder . Con habría perdido, porque A responde y ninguna arregla la primera cláusula.
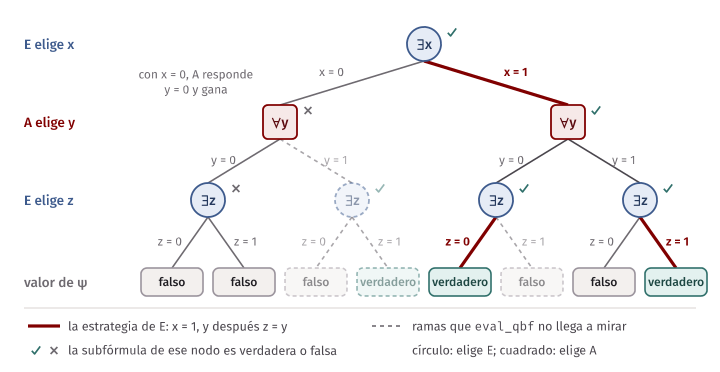
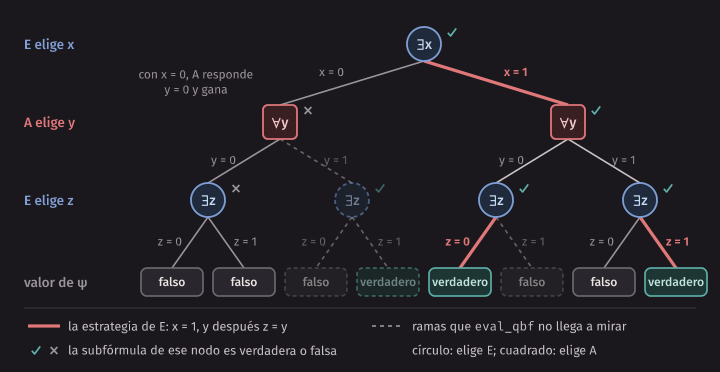
La traducción también va en el otro sentido: un juego cualquiera se escribe como fórmula. “El primer jugador gana en a lo sumo tres jugadas”, contando las de los dos, se escribe con una variable por jugada:
Existe una primera jugada mía tal que, o gano de inmediato, o para toda respuesta legal tuya existe una jugada mía con la que gano. Las frases entre comillas dependen de las reglas del juego y de las jugadas anteriores, y se sobreentiende que es legal. La forma, con los cuantificadores alternados, es la misma para todos los juegos.
Idea clave. es “mi jugada” y es “cualquier jugada tuya”. Una fórmula cuantificada verdadera es un juego que gana el jugador de los , y decidir TQBF es decidir quién gana.
Geografía generalizada
En el juego de geografía, dos jugadores dicen nombres de ciudades por turnos. Cada ciudad tiene que empezar con la letra en que terminó la anterior, y no se puede repetir ninguna. Pierde quien se queda sin ciudad que decir.
Si se dibuja un nodo por ciudad y una arista de cada ciudad a las que pueden seguirla, el juego es mover una ficha por un grafo. La geografía generalizada (generalized geography) olvida las ciudades y se queda con el grafo, que puede ser cualquiera:
- Se juega en un grafo dirigido, con un nodo de partida.
- Una ficha empieza en el nodo de partida, que cuenta como visitado.
- Los jugadores se turnan. En su turno, un jugador mueve la ficha por una arista a un nodo no visitado, que queda visitado.
- El jugador que no puede mover pierde.
El problema de decisión es
Un ejemplo a mano
Los grafos de la semana se escriben en un formato con tres campos, del mismo estilo que los demás del curso:
nodes:, con los nombres de los nodos; start:, con el nodo de partida; y edges:, seguido de una arista por
línea, origen destino.
$ cat machines/small_game.graph
# Un juego de cinco nodos para resolver a mano.
nodes: a b c d e
start: a
edges:
a b
a c
b d
c d
c e
d a
d e
En forma de lista: de se va a o a ; de , a ; de , a o a ; de , a o a ; y de no sale ninguna arista. La ficha empieza en . Llamemos I al primer jugador y II al segundo, y miremos las dos primeras jugadas posibles de I.
- I mueve a . II solo puede mover a . Ahora I está en : la arista a no sirve, porque ya está visitado, así que mueve a . II está en y no tiene jugada. Pierde II. En esta línea nadie tuvo que elegir después de la primera jugada.
- I mueve a . II puede mover a o a . Si mueve a , I se queda sin jugada y pierde. A II le basta esa respuesta. (Si II moviera a , I movería a y ganaría: por eso II no lo hace.)
Entonces I tiene una estrategia ganadora, que empieza con , y la jugada , que parecía dejarle más opciones, pierde.
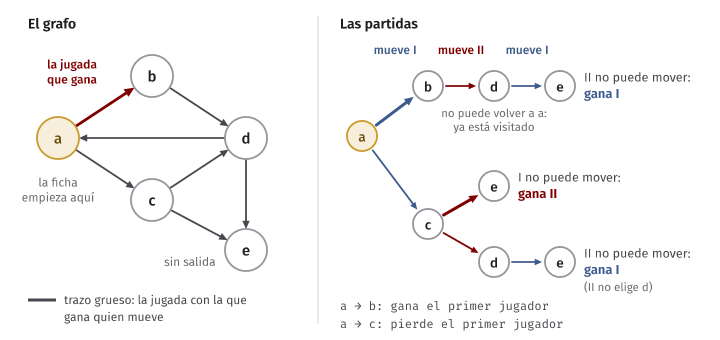
$ build/geography --moves machines/small_game.graph
5 nodos, 7 aristas, empieza en a
  a → b: gana el primer jugador
  a → c: pierde el primer jugador
el primer jugador gana; una primera jugada ganadora: b
posiciones examinadas: 4   camino más largo guardado: 4 nodos
Y el juego con ciudades de verdad. En machines/cities.graph hay nueve ciudades del Perú, con una arista de
una ciudad a otra cuando la segunda empieza con la letra en que termina la primera: de lima se puede ir a
arequipa, abancay, ayacucho o andahuaylas; de abancay, solo a yurimaguas.
$ build/geography --moves machines/cities.graph
9 nodos, 22 aristas, empieza en lima
  lima → arequipa: pierde el primer jugador
  lima → abancay: gana el primer jugador
  lima → ayacucho: gana el primer jugador
  lima → andahuaylas: pierde el primer jugador
el primer jugador gana; una primera jugada ganadora: abancay
posiciones examinadas: 30   camino más largo guardado: 9 nodos
Quien empieza en Lima gana si dice Abancay o Ayacucho, y pierde si dice Arequipa o Andahuaylas, siempre que el otro juegue bien.
La geografía generalizada está en PSPACE
El algoritmo es la definición de “tener una estrategia ganadora”, aplicada a quien le toca mover: gana si tiene alguna jugada después de la cual el otro, que pasa a ser quien mueve, no gana.
G = "Con la entrada ⟨G, b⟩ y el conjunto de nodos visitados, que al principio es {b}:
  1. Para cada arista de b a un nodo v no visitado:
  2.     Marcar v como visitado y correr G con ⟨G, v⟩.
  3.     Desmarcar v.
  4.     Si esa llamada rechazó, aceptar: mover a v deja al rival sin estrategia ganadora.
  5. Rechazar: no hay jugadas, o el rival gana después de cada una."
En geography.h:
inline bool mover_wins(const Graph& g, int current, std::vector<bool>& visited, int path_length, GameStats& stats) {
    stats.calls++;
    stats.max_path = std::max(stats.max_path, path_length);
    for (int next : g.edges[current]) {
        if (visited[next]) {
            continue;
        }
        visited[next] = true;
        bool rival_wins = mover_wins(g, next, visited, path_length + 1, stats);
        visited[next] = false;  // al volver, el espacio queda libre para la jugada siguiente
        if (!rival_wins) {
            return true;  // una jugada que deja al rival sin estrategia: no hace falta mirar más
        }
    }
    return false;  // no hay jugadas, o todas le dejan una estrategia ganadora al rival
}
Teorema. .
Demostración. El algoritmo es correcto por inducción sobre el número de nodos no visitados: sin jugadas posibles, quien mueve pierde, y rechaza; con jugadas, quien mueve gana exactamente cuando alguna lo lleva a una posición en la que el otro pierde. Su espacio: los nodos marcados son siempre los del camino que recorrió la ficha, porque cada llamada desmarca su nodo al volver. Un camino no repite nodos, así que la recursión tiene profundidad a lo sumo , el número de nodos, y cada nivel guarda un nodo y por cuál arista va. El espacio es bits: polinomial. ∎
El tiempo no es polinomial: en el peor caso el algoritmo recorre todos los caminos sin nodos repetidos que salen de , y puede haber una cantidad exponencial.
En C++.
visitedse pasa por referencia: hay un solo vector para toda la búsqueda, y cada llamada deshace su marca antes de volver. Si se pasara por valor, cada llamada tendría su propia copia. El resultado sería el mismo, pero cada jugada costaría copiar el conjunto entero. En el ejercicio de laboratorio esa diferencia se nota.
En la práctica. La búsqueda de los programas que juegan ajedrez es, en lo esencial, esta: en profundidad, guardando la línea que están analizando, más una tabla de tamaño fijo con posiciones ya vistas. Lo contrario es guardar el resultado de cada posición en una tabla. Las tablas de finales de ajedrez hacen eso para las posiciones con pocas piezas, y ocupan una cantidad enorme de disco: cambian espacio por tiempo, en el sentido opuesto al de Savitch.
La geografía generalizada es PSPACE-difícil
Teorema. GG es PSPACE-completo.
Falta mostrar que es PSPACE-difícil. Ya no hay que partir de una máquina: tenemos un problema PSPACE-completo desde el cual reducir.
Demostración. Por reducción de TQBF, en la forma del juego de la fórmula, a GG. Va en esa dirección porque queremos mostrar que GG es al menos tan difícil como TQBF: de una fórmula construimos un grafo, y quien sepa decidir quién gana en el grafo sabrá si la fórmula es verdadera.
La forma de la fórmula. Suponemos que la fórmula de partida es
con los cuantificadores alternados, el primero y el último iguales a (entonces es impar), y en CNF. No se pierde generalidad:
- Si dos cuantificadores vecinos son iguales, o el prefijo empieza o termina con , se intercala una variable nueva que no aparece en , con el cuantificador que falta. Quien la elige no cambia nada, así que el valor de la fórmula es el mismo.
- Si no está en CNF, se pasa a CNF con variables nuevas, como en la semana 13. Esa transformación cumple que, para cada asignación de las variables originales, es verdadera si y solo si existen valores de las variables nuevas que hacen verdadera a la fórmula en CNF. Por eso las variables nuevas se agregan al final del prefijo, con .
Qué se construye. Un grafo con tres partes.
- Un rombo por variable. Para cada variable , cuatro nodos:
x.in,x.T,x.Fyx.out, con las aristasx.in → x.T,x.in → x.F,x.T → x.outyx.F → x.out. Pasar porx.Tsignificará “se eligió verdadera”, y pasar porx.F, “se eligió falsa”. Los rombos se encadenan en el orden del prefijo: delx.outde cada uno sale una arista alx.indel siguiente. - La matriz. Un nodo
matrix, al que llega una arista desde elx.outdel último rombo. Un nodo por cláusula,cl1,cl2, …, con una arista desdematrixa cada uno. Y por cada literal de cada cláusula, un nodo,cl1/1,cl1/2, …, con una arista desde su cláusula. - Las aristas de regreso. De cada nodo de literal sale una arista al nodo de su rombo que lo hace
verdadero: a
x.Tsi el literal es , y ax.Fsi es .
El nodo de partida es el x.in del primer rombo.
Para la fórmula , que empieza con ,
el programa formula_to_geography primero intercala la variable d1 y después escribe el grafo:
$ build/formula_to_geography machines/forall_exists.qbf
# ∀x ∃y ((x ∨ y) ∧ (¬x ∨ ¬y))
# con la forma del juego: ∃d1 ∀x ∃y ((x ∨ y) ∧ (¬x ∨ ¬y))
nodes: d1.in d1.T d1.F d1.out x.in x.T x.F x.out y.in y.T y.F y.out matrix cl1 cl1/1 cl1/2 cl2 cl2/1 cl2/2
start: d1.in
edges:
d1.in d1.T
d1.in d1.F
d1.T d1.out
d1.F d1.out
d1.out x.in
x.in x.T
x.in x.F
x.T x.out
x.F x.out
x.out y.in
y.in y.T
y.in y.F
y.T y.out
y.F y.out
y.out matrix
matrix cl1
matrix cl2
cl1 cl1/1
cl1 cl1/2
cl1/1 x.T
cl1/2 y.T
cl2 cl2/1
cl2 cl2/2
cl2/1 x.F
cl2/2 y.F
El grafo completo, dibujado. La animación primero lo arma, en el orden de las tres partes, y después juega una partida, que se explica más abajo:
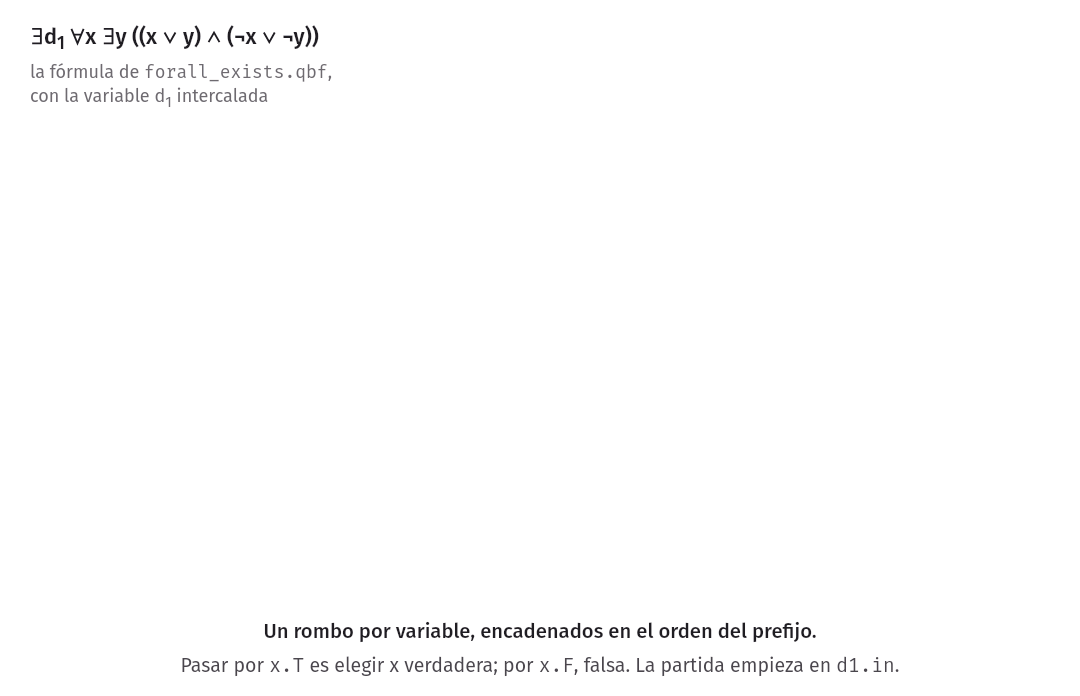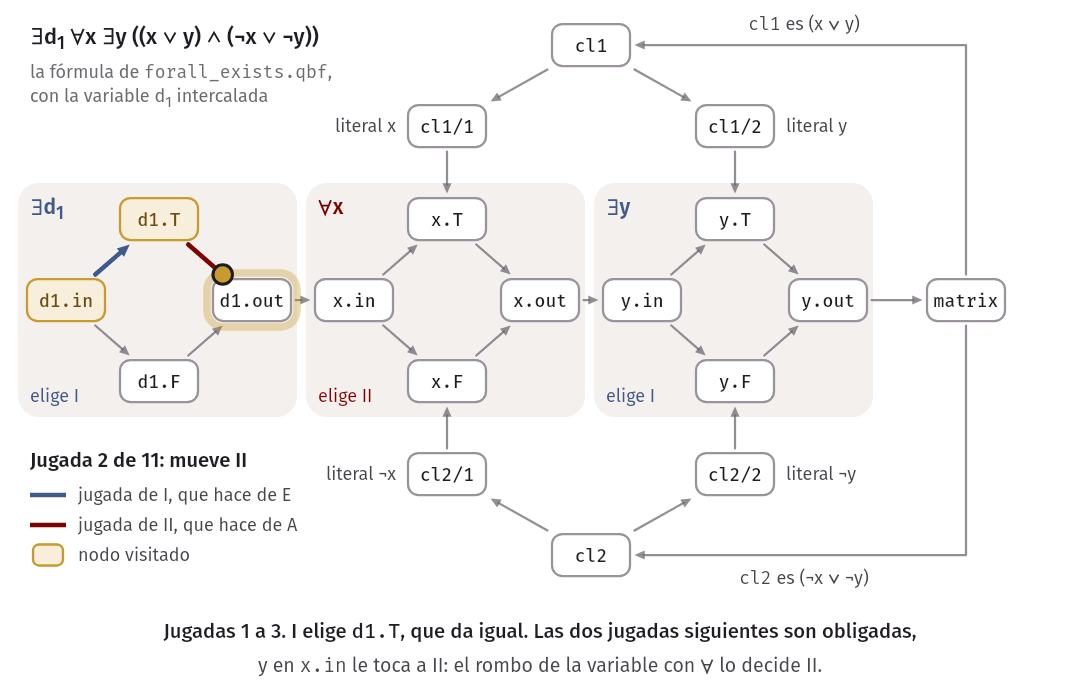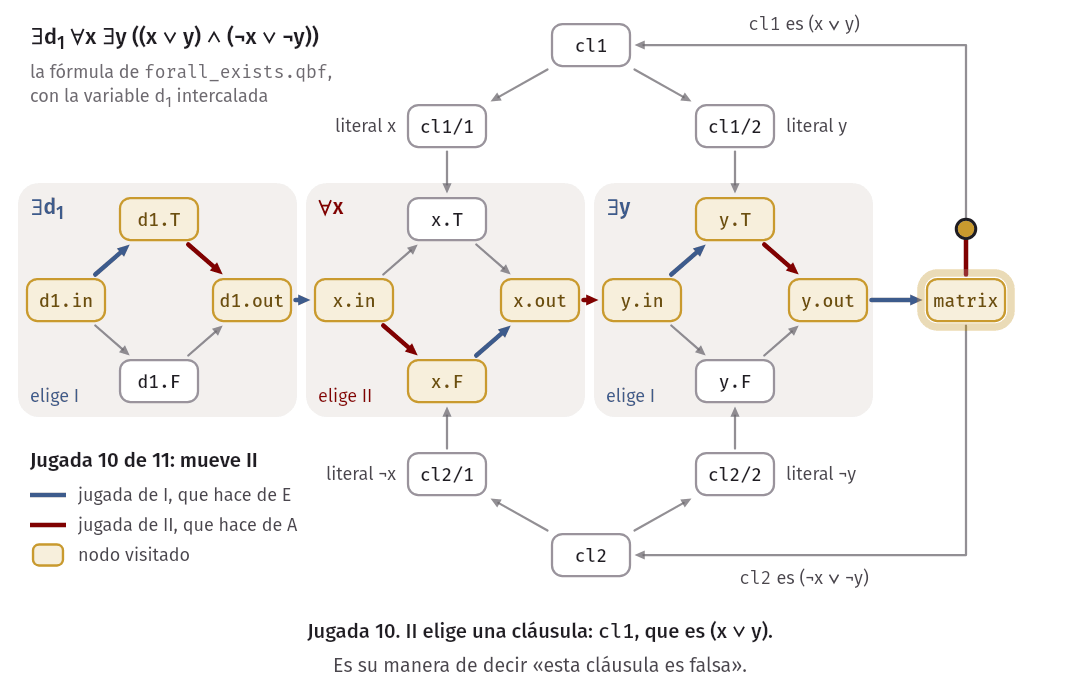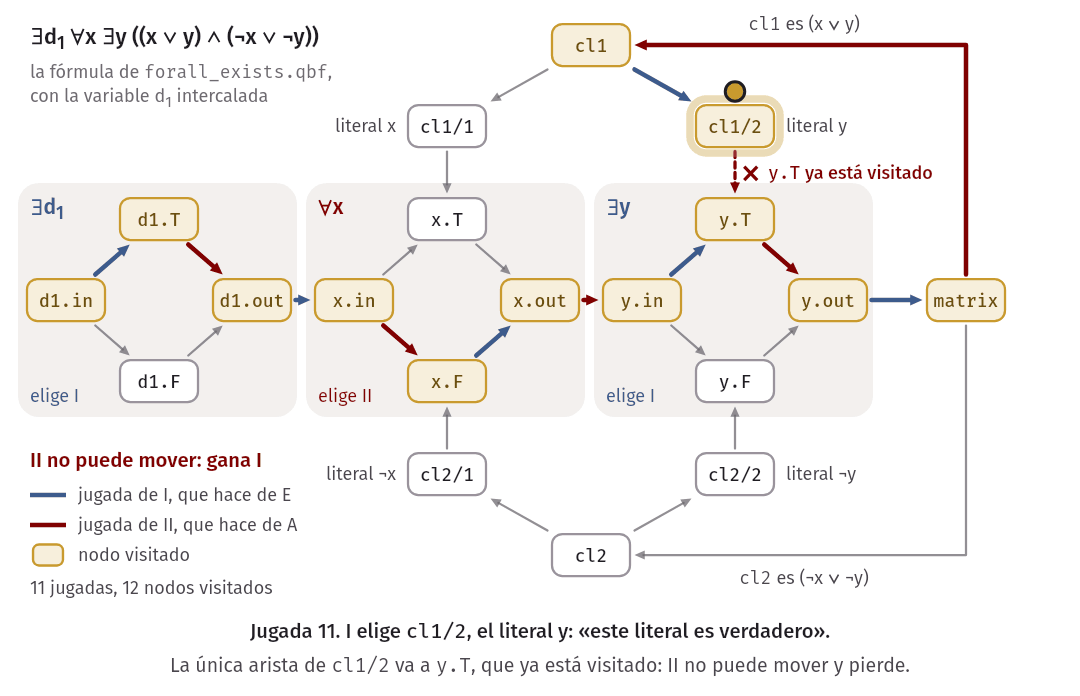
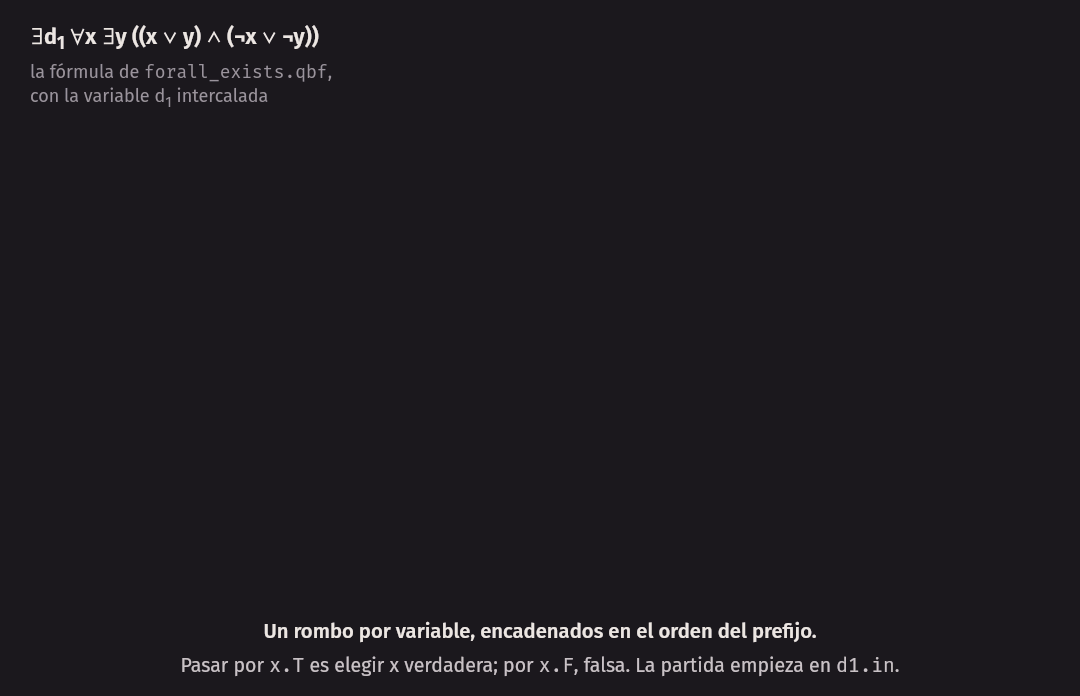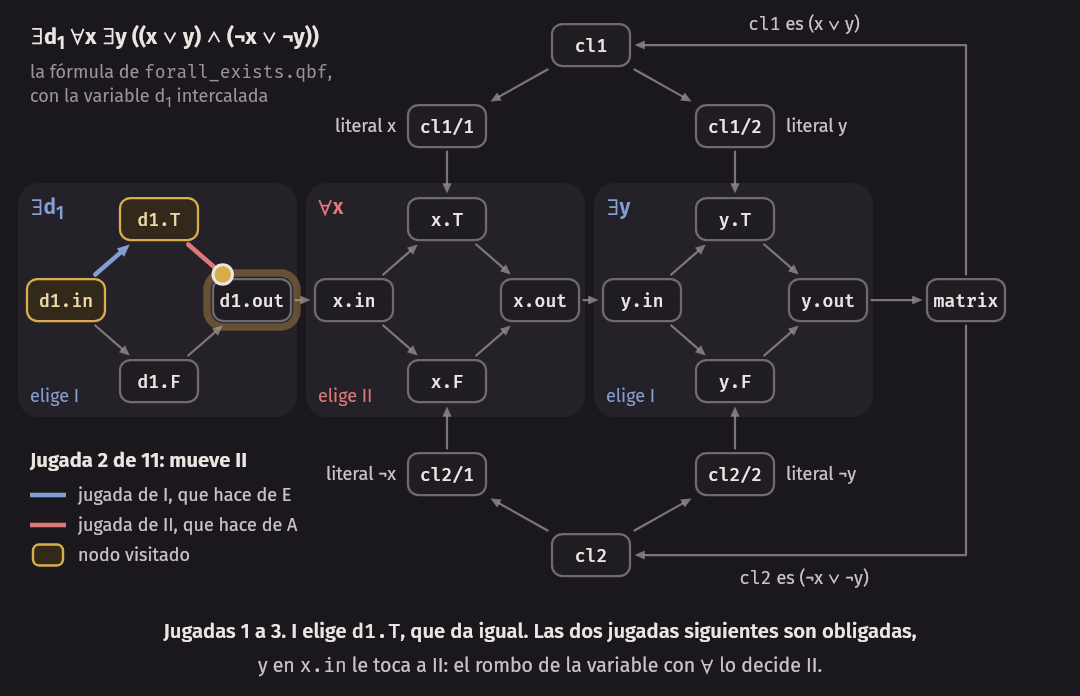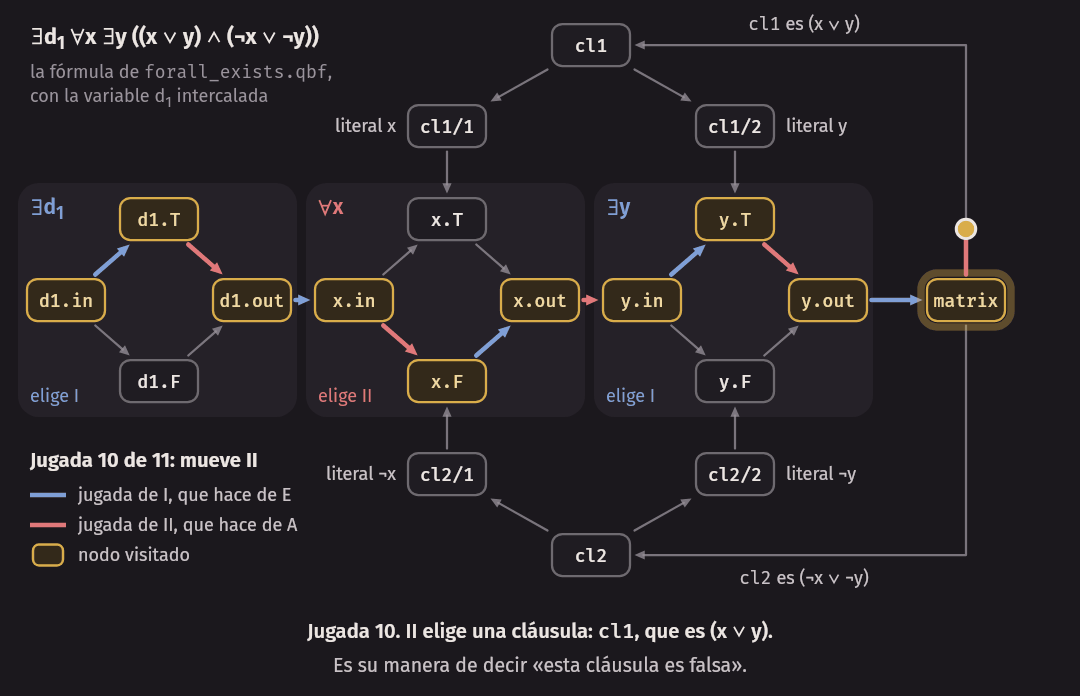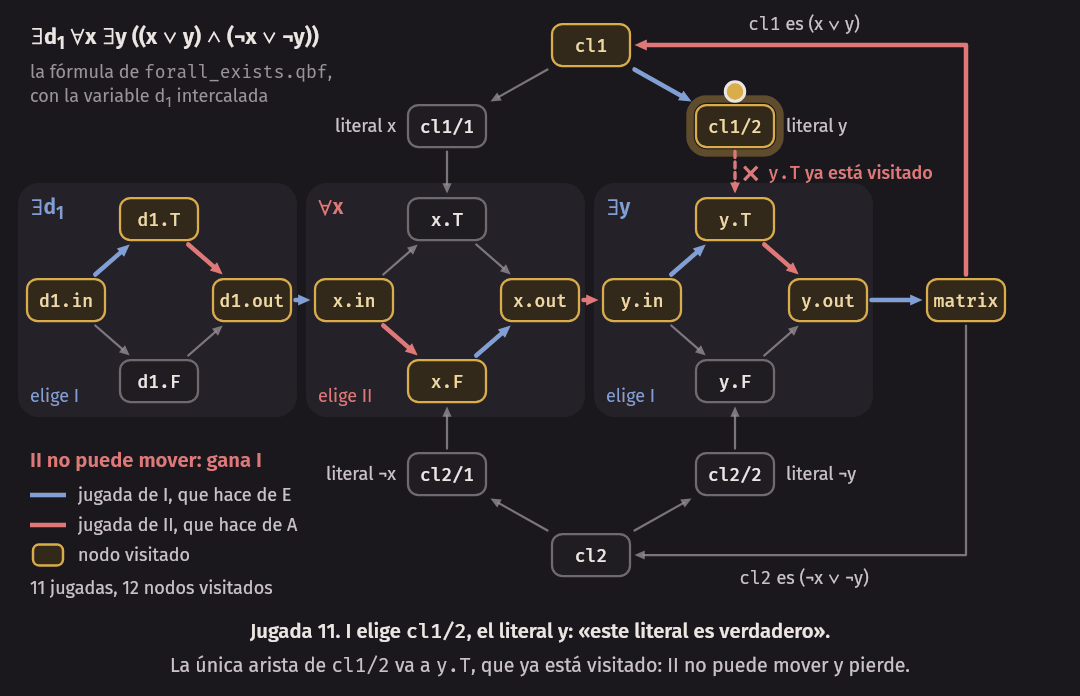
Los tres rombos, de d1, de x y de y, están encadenados: de d1.out se va a x.in, de x.out a y.in
y de y.out a matrix. Las cuatro flechas que salen de los nodos de literal son las aristas de regreso a los
rombos. Son 19 nodos: cuatro por cada una de las 3 variables, uno para la matriz, 2 de cláusulas y 4 de
literales. En general, el grafo tiene nodos más uno por cláusula y uno por literal, y se escribe en tiempo
polinomial.
Por qué funciona: los rombos. Sigamos la ficha. Mientras está en los rombos, casi todas las jugadas son
obligadas, porque de x.T, de x.F y de x.out sale una sola arista. La única elección está en x.in. ¿A
quién le toca mover ahí? Contemos las jugadas:
| Jugada | Quién mueve | Movimiento | ¿Elige? |
|---|---|---|---|
| 1 | I | x1.in a x1.T o x1.F |
Sí: el valor de |
| 2 | II | a x1.out |
No |
| 3 | I | a x2.in |
No |
| 4 | II | x2.in a x2.T o x2.F |
Sí: el valor de |
| 5 | I | a x2.out |
No |
| 6 | II | a x3.in |
No |
| 7 | I | x3.in a x3.T o x3.F |
Sí: el valor de |
Cada rombo consume tres jugadas, un número impar, así que quien elige se alterna: I elige en los rombos
impares, que son las variables con , y II en los pares, las variables con . El jugador I hace
de E y el jugador II hace de A. Al terminar los rombos, los nodos visitados dicen qué asignación se eligió:
x.T está visitado si quedó verdadera, y x.F si quedó falsa.
Por qué funciona: el final. Como es impar, en el último rombo elige I. Después II mueve a x.out, I
mueve a matrix, y siguen tres jugadas:
- II elige una cláusula. Es su manera de decir “esta cláusula es falsa”.
- I elige un literal de esa cláusula. Es su manera de decir “este literal es verdadero”.
- II tiene que mover por la única arista del nodo del literal, que va al nodo del rombo que hace
verdadero al literal.
- Si el literal es verdadero con la asignación elegida, ese nodo ya está visitado. II no puede mover y pierde.
- Si el literal es falso, ese nodo no está visitado. II mueve ahí. Ahora le toca a I, y la única arista
de ese nodo va al
x.outde su rombo, que está visitado. I no puede mover y pierde.
Las dos direcciones.
- Si es verdadera, E tiene una estrategia ganadora en el juego de la fórmula. I elige en los rombos lo que dice esa estrategia, y al final es verdadera: todas las cláusulas tienen un literal verdadero. Elija II la cláusula que elija, I responde con un literal verdadero de esa cláusula, y II pierde. I tiene una estrategia ganadora en el grafo.
- Si es falsa, la estrategia ganadora del juego de la fórmula la tiene A. II elige en los rombos lo que dice esa estrategia, y al final es falsa: alguna cláusula tiene todos sus literales falsos. II elige esa cláusula. Elija I el literal que elija, es falso, y I pierde. I no tiene estrategia ganadora.
Entonces si y solo si el grafo construido, con su nodo de partida, está en GG. ∎
Con el ejemplo: el grafo de la fórmula verdadera lo gana el primer jugador, y el de la misma matriz con los cuantificadores en el otro orden, que es falsa, no.
$ build/formula_to_geography machines/forall_exists.qbf | build/geography -
19 nodos, 25 aristas, empieza en d1.in
el primer jugador gana; una primera jugada ganadora: d1.T
posiciones examinadas: 38   camino más largo guardado: 13 nodos
$ build/formula_to_geography machines/exists_forall.qbf | build/geography -
19 nodos, 25 aristas, empieza en y.in
el primer jugador no tiene estrategia ganadora
posiciones examinadas: 61   camino más largo guardado: 13 nodos
Sigan una partida en el primer grafo; es la de la animación de arriba. I elige d1.T, que da igual. II elige, digamos, x.F: falsa. I
responde y.T: verdadera, la contraria. Después de las jugadas obligadas, II elige una cláusula, por
ejemplo cl1, que es . I elige cl1/2, el literal . La arista de cl1/2 va a y.T, que está
visitado: II no puede mover. La partida tuvo 11 jugadas y pasó por 12 nodos. El camino más largo que guardó el
programa tiene 13: es una línea en la que I elige un literal falso y II alcanza a mover una vez más. Las pruebas de la semana comprueban la equivalencia con 1500 fórmulas al azar: en cada una, el valor
que da evaluate coincide con quién gana en el grafo.
Error común. Leer la reducción al revés y decir que “la geografía se reduce a TQBF, así que es difícil”. Para mostrar que GG es difícil se parte del problema que ya se sabe difícil, TQBF, y se construye una instancia de GG. La otra dirección también existe, porque GG está en PSPACE y TQBF es PSPACE-completo, pero lo que muestra es que GG no es más difícil que TQBF.
Juegos y rompecabezas
¿Por qué los juegos de dos jugadores parecen más difíciles que los rompecabezas de uno solo, como un sudoku o un problema de SAT? La respuesta está en cómo se vería un certificado.
- En un rompecabezas, quien dice “tiene solución” puede mostrarla: una asignación, un camino, una lista de jugadas. Es corta y se revisa rápido. Eso es estar en NP: un solo .
- En un juego, quien dice “gano yo” no puede mostrar una lista de jugadas, porque sus jugadas dependen de
las del rival. Tiene que mostrar una estrategia: qué responder ante cada jugada posible del otro, y ante
cada respuesta a esa respuesta. Es un árbol entero, como el que imprimió
eval_qbf --tree, y su tamaño crece exponencialmente con la duración de la partida.
Nadie sabe demostrar que no existan certificados cortos para los juegos: eso sería demostrar que . Pero la alternancia de y es la explicación de por qué no se ve ninguno.
Esto va más allá de la geografía. Las versiones generalizadas de muchos juegos de tablero, las que se juegan en un tablero de en lugar del tablero de siempre, son PSPACE-difíciles: pasa con el Hex, las damas, el go y el ajedrez. Un tablero de tamaño fijo, como el de ajedrez de , es otra cosa: tiene una cantidad finita de posiciones, y la complejidad asintótica no dice nada sobre un problema de tamaño fijo.
Menos espacio que la entrada: L y NL
Hasta aquí el espacio fue al menos , porque la entrada ocupa celdas de la cinta. Pero muchos algoritmos útiles necesitan mucha menos memoria que el tamaño de sus datos: un programa que busca una palabra en un archivo de un gigabyte no carga el gigabyte. Para medir eso hay que separar la entrada de la memoria de trabajo.
El modelo es una máquina de Turing con dos cintas:
- una cinta de entrada, de solo lectura: el cabezal se mueve por ella en los dos sentidos, pero no escribe y no sale de la parte que contiene la entrada;
- una cinta de trabajo, de lectura y escritura, como la de siempre.
El espacio de la máquina es el número de celdas que visita en la cinta de trabajo. La entrada no cuenta. Con esta definición tienen sentido funciones menores que , y la más importante es el logaritmo:
L son los lenguajes que se deciden con espacio logarítmico (logarithmic space) y NL, los que se deciden así con una máquina no determinista. Para las funciones , este modelo y el de una cinta dan las mismas clases, así que no hay dos definiciones distintas de PSPACE.
Un primer ejemplo: todo lenguaje regular está en L. Un DFA es una máquina de este modelo que lee la entrada de izquierda a derecha y no usa la cinta de trabajo: su único recuerdo es el estado.
¿Qué se puede guardar en celdas? Un número entre y se escribe en binario con bits. Entonces, con espacio logarítmico se guarda una cantidad constante de contadores y de posiciones de la entrada: tres índices, cinco, pero no un índice por cada símbolo. No alcanza para copiar la entrada, ni una parte de ella de tamaño proporcional a . En términos de un programa: unas cuantas variables enteras, y ningún arreglo.
Ejemplo 1. . La máquina de la semana 7 iba tachando un y un por vuelta: escribía en la entrada, y aquí no se puede. La de espacio logarítmico cuenta:
M = "Con la entrada w:
  1. Recorrer w. Si aparece un 0 después de un 1, rechazar.
  2. Recorrer w otra vez, contando los ceros en un contador binario y los unos en otro.
  3. Aceptar si los dos contadores son iguales. Si no, rechazar."
Los dos contadores llegan como mucho a : ocupan celdas de la cinta de trabajo.
Ejemplo 2. Los palíndromos están en L. La máquina guarda dos posiciones, y , compara los símbolos que hay en ellas y avanza . Para leer el símbolo de una posición, mueve el cabezal de la entrada contando celdas. Son unos pocos contadores.
Ejemplo 3. Dado un grafo y un nodo, decidir si de ese nodo salen al menos dos aristas está en L: se recorre la lista de aristas con un contador.
Error común. Contar la entrada como espacio usado y concluir que ninguna máquina usa menos de celdas. En L y NL solo cuenta la cinta de trabajo. El error contrario también aparece: creer que una máquina de espacio logarítmico “no puede leer toda su entrada”. La lee completa, y las veces que quiera. Lo que no puede es recordarla.
Las configuraciones, otra vez
En este modelo, una configuración tiene el estado, el contenido de la cinta de trabajo y las posiciones de los dos cabezales. La entrada no es parte de la configuración, porque no cambia. Si la máquina usa espacio y la entrada tiene longitud , el número de configuraciones es a lo sumo
donde el factor cuenta las posiciones del cabezal de entrada, incluidas las dos celdas que bordean la entrada. Con , el último factor es , un polinomio. Una máquina de espacio logarítmico tiene una cantidad polinomial de configuraciones. Dos consecuencias inmediatas:
- . Una máquina determinista que se detiene no repite configuraciones, así que una de espacio logarítmico da una cantidad polinomial de pasos.
- En general, el teorema de la sección Espacio y tiempo vale para con este modelo: el factor queda absorbido porque .
PATH y la clase NL
El problema central de esta parte ya lo conocen de la semana 12:
Está en P: BFS o DFS lo deciden en tiempo lineal. ¿Está en L? BFS no sirve para mostrarlo, porque marca los nodos que ya visitó, y eso es un bit por nodo: espacio lineal, no logarítmico. La cola puede llegar a tener una cantidad de nodos proporcional a , y DFS tiene el mismo problema con sus marcas y su pila. Sin las marcas, ninguno de los dos funciona: en un grafo con ciclos darían vueltas sin fin.
Nadie sabe si PATH está en L. Lo que sí se sabe es que está en NL.
PATH está en NL
Una máquina no determinista no necesita buscar el camino: lo adivina, nodo por nodo. Y para adivinar el siguiente nodo no hace falta recordar los anteriores.
N = "Con la entrada ⟨G, s, t⟩, donde G tiene m nodos:
  1. Poner actual ← s y pasos ← 0.
  2. Mientras actual ≠ t:
  3.     Si pasos = m − 1, rechazar.
  4.     Elegir, de manera no determinista, un nodo v. Si no hay arista de actual a v, rechazar.
  5.     Poner actual ← v y pasos ← pasos + 1.
  6. Aceptar."
Teorema. .
Demostración. Es correcta. Si acepta en alguna rama, los nodos que eligió forman un camino de a
. Si hay un camino de a , hay uno sin nodos repetidos, que tiene a lo sumo aristas; la rama
que elige justo esos nodos llega a antes de que el contador la corte, y acepta. Todas las ramas se
detienen, por el contador de la línea 3. El espacio. La cinta de trabajo guarda tres números entre y
: actual, pasos y el nodo v que se está probando. Comprobar si hay una arista de actual a v es
recorrer la entrada. Son celdas, y . ∎
El contador de pasos hace dos trabajos: garantiza que todas las ramas se detengan, como pide la definición, y reemplaza a las marcas de BFS. La máquina no sabe si está dando vueltas en un ciclo. No le hace falta: si existe un camino, existe uno corto, y alguna rama lo sigue.
El programa guess_path hace de una rama de esa máquina: los nodos de la línea de comandos son las
elecciones. Lee cada elección una sola vez y guarda solo el nodo actual y el contador. El grafo es
machines/two_routes.graph, con las aristas , , , , , y
.
$ build/guess_path machines/two_routes.graph t a b c t
paso 0: en s
paso 1: en a
paso 2: en b
paso 3: en c
paso 4: en t
acepta: llegó a t
memoria de trabajo: 2 números de 3 bits, para un grafo de 6 nodos
Una rama que da vueltas en el ciclo entre y la corta el contador, y una que elige una arista que no existe rechaza de inmediato:
$ build/guess_path machines/two_routes.graph t a b a b a b
paso 0: en s
paso 1: en a
paso 2: en b
paso 3: en a
paso 4: en b
paso 5: en a
rechaza: ya dio 5 pasos, y un camino sin repetir nodos no tiene más
$ build/guess_path machines/two_routes.graph t a c
paso 0: en s
paso 1: en a
rechaza: no hay arista de a a c
Es la versión, para NL, de la definición de NP con verificadores: las elecciones son un certificado, y comprobarlo cuesta espacio logarítmico leyéndolo una sola vez, de izquierda a derecha.
PATH es NL-completo
Para hablar de los problemas más difíciles de NL hace falta una reducción más débil que la de tiempo polinomial. La razón es la misma que con PSPACE, vista desde abajo: como , una reducción de tiempo polinomial podría resolver ella misma cualquier problema de NL, y casi todos resultarían completos.
Una reducción en espacio logarítmico de a es una función tal que si y solo si , y que se calcula con una máquina de tres cintas: la de entrada, de solo lectura; una de trabajo con celdas; y una de salida, en la que solo se escribe, de izquierda a derecha, sin volver atrás. La salida no cuenta como espacio, igual que la entrada. Se escribe .
Un lenguaje es NL-completo si está en NL y todo lenguaje de NL cumple .
Estas reducciones se comportan como las de siempre: si y , entonces . No es tan inmediato como en tiempo polinomial, porque la máquina de no puede escribir entera en su cinta de trabajo: puede ser mucho más larga que . Lo que hace es simular la máquina de y, cada vez que esa máquina quiere leer el símbolo número de , volver a calcular desde el principio, descartando todo menos ese símbolo. Tarda mucho más, y usa espacio logarítmico. Otra vez: el tiempo se gasta, el espacio se reutiliza.
Teorema. PATH es NL-completo.
Idea de la demostración. Por reducción: para un lenguaje cualquiera de NL damos una reducción en espacio logarítmico de a PATH. Sea una máquina no determinista que decide con espacio , modificada para tener una sola configuración de aceptación. Con una entrada , la reducción escribe el grafo de configuraciones de con :
- Los nodos son las configuraciones de con . Cada una se escribe en símbolos, y hay una cantidad polinomial, por la cuenta de la sección anterior.
- Hay una arista de a si puede pasar de a en un paso.
- es la configuración inicial y , la de aceptación.
acepta si y solo si alguna rama lleva de la configuración inicial a la de aceptación, es decir, si y solo si hay un camino de a en ese grafo. Y el grafo se escribe con espacio logarítmico: la máquina recorre, en orden, todas las cadenas de la longitud de una configuración, y por cada par comprueba si es una arista. Para eso solo necesita tener escritas y , que ocupan celdas, y mirar el símbolo de que está bajo el cabezal de entrada en . ∎
Es la tercera vez en la semana que aparece el mismo objeto. En Savitch, en TQBF y aquí, una máquina con poco espacio se convierte en un grafo cuyos nodos son sus configuraciones, y aceptar es alcanzar un nodo desde otro. Por eso la alcanzabilidad es el problema de las clases de espacio.
Idea clave. Una máquina no determinista de espacio logarítmico es, para cada entrada, un grafo de tamaño polinomial, y aceptar es encontrar un camino. PATH no es un ejemplo más de NL: es todo NL.
Dónde quedan L y NL
. Sea . Para decidir si en tiempo polinomial: construir el grafo de configuraciones de la máquina de con , que tiene tamaño polinomial, y correr BFS desde la configuración inicial. El no determinismo de espacio logarítmico se simula en tiempo polinomial sin ninguna dificultad. Compárenlo con NP, donde el grafo de configuraciones es exponencial.
PATH con espacio . El teorema de Savitch, en su versión para , da
Para PATH, la máquina determinista que produce el teorema es exactamente la función can_yield de la sesión A:
la recursión del punto medio sobre el grafo de la entrada, sin marcas. Es lo mejor que se conoce para grafos
dirigidos. Para grafos no dirigidos sí se conoce un algoritmo determinista de espacio logarítmico; es un
resultado de 2005, de Omer Reingold, y su demostración es mucho más difícil que todo lo de este capítulo.
. La clase tiene los complementos de los lenguajes de NL, como con NP. En la semana 13 vimos que nadie sabe si : no se conoce un certificado corto de que una fórmula no es satisfacible. Para el espacio logarítmico, la pregunta está resuelta, y la respuesta sorprendió cuando se encontró, a fines de los años ochenta:
Teorema (Immerman y Szelepcsényi). .
No lo demostramos. Dice, en particular, que : una máquina no determinista de espacio logarítmico puede convencerse de que no hay camino de a . No es evidente. Adivinar un camino es fácil, pero ¿qué se adivina para mostrar que no existe ninguno? La demostración hace que la máquina cuente, nivel por nivel, cuántos nodos se alcanzan desde , y con ese número puede comprobar que revisó todos y que no está entre ellos.
Con todo lo de hoy, la cadena completa de las clases del curso queda así:
Ninguna de las inclusiones que se ven ahí se sabe estricta. No se sabe si , que es la pregunta de si PATH está en L. La próxima semana veremos qué pares de clases de esa cadena sí se pueden separar, y con qué técnica.
En la práctica. Los algoritmos de espacio logarítmico son los que procesan una entrada enorme con unas pocas variables: contar líneas, comprobar que unos paréntesis de un solo tipo están balanceados, validar un archivo mientras se lee. Cuando además la entrada se puede leer una sola vez, de corrido, se llaman algoritmos de streaming.
El código de la semana
Todo está en code/week-14. make compila los programas en build/ y make test corre las pruebas.
| Archivo | Qué tiene |
|---|---|
qbf.h |
El struct Qbf, la lectura del formato .qbf y evaluate, la recursión de TQBF está en PSPACE |
graph.h |
El struct Graph y la lectura del formato .graph |
geography.h |
mover_wins, la búsqueda que guarda solo el camino actual |
savitch.h |
can_yield, la recursión del punto medio, y BFS para comparar |
formula_game.h |
La reducción del juego de la fórmula a la geografía generalizada |
fields.h |
La lectura de campos y comentarios, común a los dos formatos |
eval_qbf.cpp, qbf_growth.cpp |
Evaluar una fórmula, con su árbol; la tabla de tiempo y espacio |
geography.cpp |
Decidir quién gana en un grafo |
savitch_demo.cpp |
La tabla de Savitch frente a BFS |
formula_to_geography.cpp |
Escribir el grafo de una fórmula |
guess_path.cpp |
Una rama de la máquina no determinista de PATH |
machines/ |
Las fórmulas (.qbf) y los grafos (.graph) del capítulo |
errors/ |
Entradas mal formadas a propósito, con el mensaje que producen |
Los dos formatos de esta semana, .qbf y .graph, no describen máquinas, así que no están en
code/formats.md: son los que se explicaron en El formato de los ejemplos y en Un ejemplo a mano. Siguen
las mismas reglas comunes.
$ make test
test_qbf: las fórmulas de la clase y 3000 fórmulas al azar (1093 verdaderas)
test_geography: los grafos de la clase y 4000 grafos al azar (en 1841 gana el primer jugador)
test_savitch: el grafo de la clase y 23684 consultas en grafos al azar
test_formula_game: las fórmulas de la clase y 1500 fórmulas al azar (740 verdaderas)
Todas las pruebas pasaron.
Las pruebas comprueban lo que este capítulo afirma sobre sus ejemplos, y cada algoritmo de espacio pequeño se compara con otro que resuelve lo mismo gastando memoria:
test_qbf: los valores de las fórmulas del capítulo y el número de llamadas de los dos primeros ejemplos. En fórmulas al azar,evaluateda lo mismo que una tabla con el valor de la matriz en las asignaciones, que se va reduciendo a la mitad, cuantificador por cuantificador. La tabla ocupa bits: es justo lo que la recursión evita.test_geography: que el grafo de las ciudades cumple la regla de las letras, los resultados de los dos ejemplos, y que en el grafo completo de nodos gana el primer jugador exactamente cuando es par. En grafos al azar,mover_winsda lo mismo que una tabla con una casilla por cada par (conjunto de visitados, nodo actual), y la jugada que devuelve gana de verdad.test_savitch:can_yield(u, v, t)responde que sí exactamente cuando la distancia deuav, calculada con BFS, es a lo sumot, y nunca tiene más de llamadas activas.test_formula_game: el tamaño del grafo de la reducción y, con las fórmulas del capítulo y 1500 al azar, que el primer jugador gana en el grafo exactamente cuando la fórmula es verdadera.
El laboratorio
La sesión de laboratorio de esta semana es para la Práctica 4. El problema de lab/geography queda como
ejercicio opcional: leer un grafo en formato .graph y responder si el primer jugador tiene una estrategia
ganadora, con una primera jugada ganadora si la tiene. Como puede haber varias, el juez usa un verificador que
acepta cualquiera y comprueba que gana. El enunciado está en lab/geography/README.md.
Lo que se practica es la sección La geografía generalizada está en PSPACE: una búsqueda recursiva que guarda
solo el camino actual. Los casos grandes distinguen dos maneras de escribirla. Una búsqueda que deja de probar
jugadas cuando encuentra una ganadora pasa todos los casos. Una que las prueba todas de todos modos recorre muchas más
posiciones, y el juez le da TLE. Y una que copia el grafo y el conjunto de visitados en cada llamada paga
esa copia por cada posición, lo que también alcanza para pasarse del tiempo en el caso más grande. El último
paso del enunciado pide medir cómo crece el tiempo con grafos de 10, 15 y 20 nodos.
Resumen
- El espacio de una máquina es el número de celdas que visita. y se definen como las clases de tiempo. La diferencia de fondo: el espacio se reutiliza y el tiempo no.
- SAT se decide con espacio lineal, probando las asignaciones una por una en las mismas celdas.
- Una máquina que usa espacio tiene a lo sumo configuraciones. Si se detiene, no repite ninguna, así que corre en tiempo .
- . Solo se sabe que : alguna de las tres inclusiones es estricta, y no se sabe cuál.
- Teorema de Savitch: . Para saber si de una configuración se llega a otra en pasos, se prueba cada configuración intermedia y se resuelven las dos mitades, una después de la otra, en el mismo espacio. La recursión tiene niveles y cada uno guarda celdas.
- Consecuencia: . El argumento no sirve para el tiempo, porque los tiempos de las dos mitades se suman.
- Una fórmula booleana cuantificada alterna y , y el orden importa. TQBF está en PSPACE por una recursión de profundidad igual al número de variables.
- TQBF es PSPACE-completo. La fórmula escribe la recursión de Savitch: un para el punto medio y un para decir las dos mitades con una sola copia de la subfórmula, lo que mantiene el tamaño polinomial.
- Una fórmula cuantificada es un juego entre el jugador de los y el de los : es verdadera si y solo si el primero tiene una estrategia ganadora.
- La geografía generalizada es PSPACE-completa. Está en PSPACE por una búsqueda que guarda solo el camino actual, y es PSPACE-difícil por una reducción desde el juego de la fórmula, con un rombo por variable.
- Un certificado de que un jugador gana sería una estrategia entera, que es un árbol. Por eso los juegos parecen estar fuera de NP.
- Con una cinta de entrada de solo lectura y una de trabajo, que es la única que cuenta, se definen y . Espacio logarítmico quiere decir una cantidad constante de contadores y posiciones.
- PATH está en NL: se adivina el camino recordando solo el nodo actual y un contador. Es NL-completo con reducciones en espacio logarítmico, porque una máquina de NL con una entrada es un grafo de configuraciones de tamaño polinomial. De ahí también .
- . En espacio, el complemento no cuesta; en NP no se sabe.
| Clase | Definición | Problema completo | El no determinismo |
|---|---|---|---|
| NL | Espacio logarítmico, no determinista | PATH | No se sabe si |
| NP | Tiempo polinomial, no determinista | SAT | No se sabe si |
| PSPACE | Espacio polinomial | TQBF, geografía generalizada | No agrega nada: |
Ejercicios
-
Evalúen a mano las fórmulas y , dibujando el árbol de cada una. Después escriban en formato
.qbflas fórmulas y , evalúenlas a mano y comprueben conbuild/eval_qbf --tree. -
Una máquina de una cinta tiene 10 estados y un alfabeto de cinta de 4 símbolos, y con cierta entrada usa a lo sumo 8 celdas. ¿Cuántas configuraciones distintas puede tener, como máximo? Si la máquina es determinista y con esa entrada ya dio más pasos que ese número, ¿qué pueden concluir?
-
Demuestren que una máquina determinista que usa espacio y siempre se detiene corre en tiempo . Indiquen en qué paso se usa que es determinista y en cuál que se detiene.
-
En la demostración del teorema de Savitch: a) ¿Qué guarda cada nivel de la recursión y cuántos niveles hay? b) ¿Por qué la máquina no necesita guardar qué configuraciones intermedias ya probó y descartó? c) Calculen cuántas llamadas hace, en el peor caso,
can_yielden un grafo de nodos con , y compárenlo con la fila de la tabla desavitch_demo. -
Demuestren que de otra manera: usando solo el teorema de Savitch y la relación entre tiempo y espacio. Después demuestren que .
-
Escriban como fórmula cuantificada, con una variable por jugada, “el segundo jugador gana en a lo sumo cuatro jugadas”. Digan qué significa cada cuantificador.
-
En el grafo
machines/small_game.graph, agreguen la arista y resuelvan el juego a mano. ¿Cambia quién gana? Comprueben conbuild/geography --moves. Después busquen un grafo de a lo sumo seis nodos en el que el primer jugador tenga tres primeras jugadas posibles y solo una gane. -
Demuestren que en el grafo completo de nodos (una arista de cada nodo a cada uno de los otros) el primer jugador de la geografía generalizada gana si y solo si es par. Después expliquen por qué la búsqueda de
geography.hexamina muchas menos posiciones que caminos tiene ese grafo, y escriban la recurrencia del número de posiciones que examina. -
Apliquen a mano la reducción de La geografía generalizada es PSPACE-difícil a la fórmula : listen los nodos y las aristas. ¿Cuántos nodos tiene? Comprueben con
build/formula_to_geography machines/three_moves.qbfy describan la estrategia del primer jugador en el grafo a partir de la estrategia de E que se ve en el árbol deeval_qbf --tree. -
En la reducción a la geografía generalizada, el prefijo debe terminar con . Tomen la fórmula , que es verdadera, y construyan el grafo sin agregar la variable del final, conectando el último rombo con
matrixigual que antes. ¿Quién gana en ese grafo? Compruébenlo conbuild/geographyy expliquen qué paso de la demostración falla. -
Demuestren que cada uno de estos lenguajes está en L, describiendo la máquina y diciendo qué guarda en la cinta de trabajo: a) ; b) las cadenas de paréntesis balanceados, con un solo tipo de paréntesis; c) los grafos dirigidos en los que todo nodo tiene al menos una arista de salida.
-
¿Por qué el algoritmo de BFS para PATH no muestra que PATH está en L? ¿Y por qué el algoritmo no determinista de la sección PATH está en NL no se puede convertir en uno determinista simplemente “probando todas las elecciones”? Calculen cuánto espacio haría falta para anotar en qué rama se va.
-
Para programar. Modifiquen una copia de
geography.cpppara que, cuando el primer jugador gana, imprima su estrategia completa: la primera jugada y, por cada respuesta posible del rival, la jugada siguiente, y así hasta el final, con sangría como el árbol deeval_qbf --tree. Córranlo conmachines/cities.graph. ¿Cuántas líneas tiene la estrategia? ¿Qué relación tiene ese número con la sección Juegos y rompecabezas? -
Para programar. Escriban una versión de la búsqueda de la geografía que guarde en una tabla el resultado de cada par (conjunto de visitados, nodo actual), con el conjunto como máscara de bits. Midan con el grafo completo de 20 nodos cuánto tarda y cuánta memoria ocupa la tabla, y compárenlo con la búsqueda que guarda solo el camino. ¿Cuál de las dos muestra que el problema está en PSPACE?