
Apuntes · Capítulo 3Lenguajes regulares
Expresiones regulares
Expresiones regulares
Hasta aquí, un lenguaje regular se dio siempre con una máquina. En la semana 1 fue un DFA: una tabla que dice qué hacer con cada símbolo. La semana pasada fue un NFA, que puede adivinar y por eso suele ser más pequeño, y vimos que adivinar no agrega ningún lenguaje: la construcción de subconjuntos convierte cualquier NFA en un DFA. En los dos casos, quien quiere saber qué lenguaje reconoce la máquina tiene que ejecutarla en la cabeza.
Esta semana aparece la tercera manera de dar un lenguaje regular, y es de otro tipo. Una expresión regular
no dice cómo reconocer las cadenas: dice cómo son. La expresión se
lee de corrido: cualquier cantidad de ceros y unos, y al final un uno. Es la notación que usan grep, los
editores de texto y los validadores de formularios, y la que usa un compilador para decir qué forma tiene un
número o un identificador.
Las dos preguntas de la semana son las dos direcciones entre describir y reconocer.
- De la descripción a la máquina. Dada una expresión, ¿se puede construir un autómata que reconozca
exactamente las cadenas que describe? Sí, y la construcción es mecánica: una pieza de NFA por cada operación.
Es lo que hace
grepcada vez que lo usan. - De la máquina a la descripción. Dado un autómata, ¿hay una expresión que describa su lenguaje? También, y esta dirección cuesta más: se eliminan los estados uno por uno, y las flechas van acumulando expresiones.
Las dos respuestas juntas son el teorema de Kleene: los DFA, los NFA y las expresiones regulares describen exactamente los mismos lenguajes. Con eso la clase de los lenguajes regulares queda definida de tres maneras independientes, y se puede elegir en cada problema la que convenga.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Describir en vez de reconocer y La definición de expresión regular. Antes de la sesión B, La dirección difícil y Autómatas con expresiones en las flechas.
En clase: Sesión A, de Describir en vez de reconocer a Las abreviaturas de las herramientas. Sesión B, de La dirección difícil a Cómo busca un motor real.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, De expresión regular a NFA: la construcción de Thompson otra vez, Cómo busca un motor real y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 1.3 (Regular Expressions); su segunda mitad trata los autómatas generalizados (GNFA) de la sesión B. Erickson, Models of Computation, notas 2 (Regular languages) y 4. Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-03. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/mini_grep.
Describir en vez de reconocer
Supongan que quieren encontrar, en un archivo de registro de un millón de líneas, las que tienen una fecha. Nadie escribe para eso la tabla de transiciones de un autómata. Se escribe algo como esto:
[0-9][0-9]/[0-9][0-9]/[0-9][0-9][0-9][0-9]Dos dígitos, una barra, dos dígitos, una barra, cuatro dígitos. El patrón no dice en qué orden mirar los caracteres ni qué recordar: dice qué forma tiene lo que se busca. La herramienta se encarga del resto.
Esa manera de trabajar está en muchos sitios.
grepy los editores.greprecibe un patrón y un archivo, e imprime las líneas en las que el patrón aparece. El nombre viene de un comando del editored:g/re/p, por global, regular expression y print. Buscar y reemplazar con patrones en cualquier editor de código es lo mismo.- Los validadores. Un formulario web comprueba que un campo tenga forma de código postal o de número de teléfono comparándolo con un patrón.
- Los lexers. La primera fase de un compilador parte el texto del programa en tokens: identificadores, números, operadores. La forma de cada token se da con una expresión regular, y una herramienta genera el autómata que los reconoce.
En los tres casos pasa lo mismo: la persona escribe una descripción, y un programa la convierte en una máquina que lee el texto. La sesión A estudia las descripciones y esa conversión. La sesión B demuestra que no se pierde nada en el cambio: todo lo que una máquina de estados finitos reconoce se puede describir así.
La notación de las herramientas tiene muchos operadores, y cada herramienta agrega los suyos. La teoría se queda con tres, y con ellos alcanza. Los demás, como los corchetes y las llaves del ejemplo, son abreviaturas, y al final de la sesión A veremos por qué no agregan nada.
Una advertencia sobre la escritura, que vale para todo el capítulo. En la teoría, la unión se escribe con
: . En el teclado, en las herramientas y en el código del
curso, la unión se escribe con la barra vertical: (0|1)*1. Es la misma expresión. En estos apuntes, las
fórmulas usan , y lo que se escribe en la terminal y lo que imprimen los programas usa |.
La definición de expresión regular
En la semana 1 definimos tres operaciones sobre lenguajes que se llaman operaciones regulares: la unión , la concatenación y la estrella . La semana pasada demostraron que los lenguajes regulares son cerrados bajo las tres. Una expresión regular es una fórmula escrita con esas tres operaciones, a partir de los lenguajes más simples que hay.
La definición es inductiva, como la de las cadenas en la semana 1: dice cuáles son las expresiones más pequeñas y cómo se arman las más grandes a partir de otras ya armadas.
Definición. Sea un alfabeto. es una expresión regular (regular expression) sobre si es de una de estas seis formas:
- , para algún símbolo de ;
- ;
- ;
- , donde y son expresiones regulares;
- , donde y son expresiones regulares;
- , donde es una expresión regular.
Los casos 1 a 3 son los casos base. Los casos 4 a 6 construyen una expresión a partir de otras más pequeñas. La definición no es circular: toda expresión se termina descomponiendo en símbolos, y , igual que toda cadena se termina descomponiendo hasta llegar a la cadena vacía.
Una expresión es un texto, una fórmula. Lo que interesa es el lenguaje que describe, que se escribe y se define siguiendo los mismos seis casos:
| Expresión | Lenguaje | En palabras |
|---|---|---|
| Solo la cadena de un símbolo | ||
| Solo la cadena vacía | ||
| Ninguna cadena | ||
| Las cadenas de y las de | ||
| Una cadena de seguida de una de | ||
| Cero o más cadenas de , una tras otra |
Con , la expresión se arma en tres pasos y su lenguaje se calcula en los mismos tres:
Tres cosas de la definición que conviene leer despacio.
- Una expresión y su lenguaje son objetos distintos. es una fórmula finita, y es un conjunto de cadenas, casi siempre infinito. Dos expresiones distintas pueden describir el mismo lenguaje: y son fórmulas distintas con . Cuando escribimos entre expresiones queremos decir : que son equivalentes.
- Los símbolos y tienen aquí un segundo uso. En la semana 1, era una cadena y un lenguaje. Dentro de una expresión regular los dos son expresiones: la expresión describe el lenguaje , y la expresión describe el lenguaje . Siguen siendo cosas opuestas, como entonces.
- Las palabras. Una máquina reconoce un lenguaje. Una expresión lo describe. De una cadena de diremos que la describe, o que la cadena coincide con .
Dos abreviaturas que usaremos en la teoría. Si , dentro de una expresión se escribe en lugar de : un símbolo cualquiera. Y es concatenada veces. Así, es la expresión del principio, y o describe las cadenas de longitud par.
Idea clave. Una expresión regular se arma con tres operaciones, unión, concatenación y estrella, a partir de los símbolos, y . Cada caso de la definición dice a la vez cómo se escribe la expresión y qué lenguaje describe. Por eso casi todo lo que se demuestra sobre expresiones regulares se demuestra con seis casos: tres bases y tres operaciones.
Precedencia y paréntesis
Con la definición tal cual, toda operación lleva sus paréntesis, y hasta las expresiones pequeñas se vuelven ilegibles. Como en la aritmética, se fija un orden y se quitan los paréntesis que ese orden hace innecesarios.
Precedencia. Primero la estrella, después la concatenación, al final la unión.
Es el mismo orden que el de la potencia, el producto y la suma: es , y es . La estrella se aplica solo a lo que tiene inmediatamente a su izquierda: un símbolo, o un grupo entre paréntesis.
El programa regex_tree lee una expresión y muestra cómo la entendió: con todos sus paréntesis, uno por cada
operación, y como árbol, con la última operación que se aplica en la raíz.
$ build/regex_tree '0|10*' '(0|1)0*' '0|(10)*'
expresión:           0|10*
con sus paréntesis:  (0|(1(0*)))
nodos del árbol:     6
unión
    0
    concatenación
        1
        estrella
            0

expresión:           (0|1)0*
con sus paréntesis:  ((0|1)(0*))
nodos del árbol:     6
concatenación
    unión
        0
        1
    estrella
        0

expresión:           0|(10)*
con sus paréntesis:  (0|((10)*))
nodos del árbol:     6
unión
    0
    estrella
        concatenación
            1
            0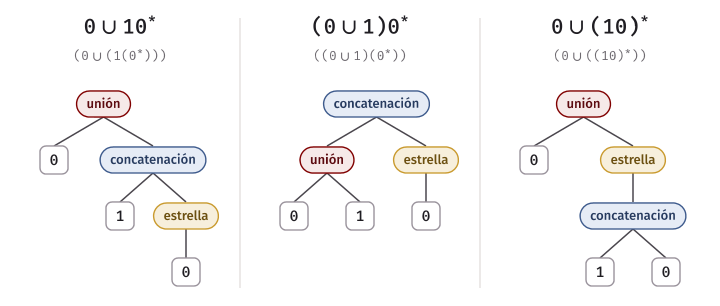
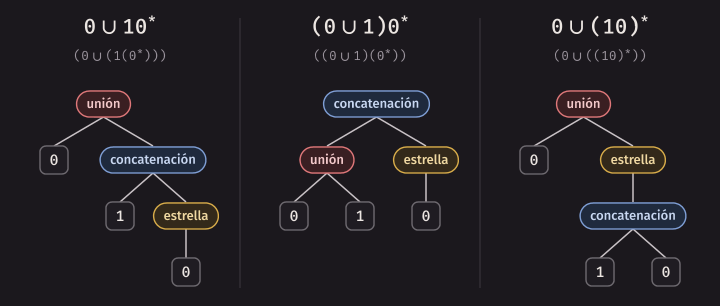
Las tres expresiones tienen los mismos símbolos en el mismo orden, y solo cambian los paréntesis. Describen tres lenguajes distintos:
- : la cadena , o un seguido de ceros. Es .
- : un símbolo cualquiera seguido de ceros. Tiene además a , , …
- : la cadena , o repeticiones de . Tiene a y a , y no a .
El árbol es la forma en que conviene pensar una expresión, y es la forma en que la guardan los programas. Cada nodo es un caso de la definición: las hojas son los casos base y los nodos interiores son las operaciones. El tamaño de una expresión, que escribiremos , es el número de nodos de su árbol. Las tres de arriba tienen tamaño 6: tres hojas y tres operaciones.
La unión y la concatenación son asociativas, así que y se escriben sin paréntesis. El árbol sí tiene que elegir cómo agrupar, y el parser del curso agrupa hacia la izquierda: . El lenguaje es el mismo con cualquiera de las dos agrupaciones.
Error común. Leer como “repeticiones de ”. La estrella liga más que la concatenación: es , un cero seguido de unos. Las repeticiones de son . El mismo error con la unión: no es . Si dudan, pongan el paréntesis: uno de más no cambia el lenguaje, y uno de menos sí.
Cómo se escriben las expresiones en el código
Los programas de code/week-03 leen las expresiones en una línea de texto, con estas reglas:
| En la teoría | En el código | Nota |
|---|---|---|
| un símbolo | a |
Una letra o un dígito |
R1|R2 |
La barra vertical | |
R1R2 |
No se escribe nada | |
R* |
||
% |
También se acepta la letra ε |
|
@ |
También se acepta el signo ∅ |
Los paréntesis agrupan y los espacios se ignoran. Al imprimir, los programas escriben ε y ∅, y solo los
paréntesis necesarios. En la terminal, la expresión va entre comillas simples, porque |, * y los
paréntesis significan otra cosa para el shell.
Una expresión mal escrita no tiene árbol, y el parser dice dónde se quedó:
$ build/regex_tree '0|' '(0|1' '0+1'
0|
  error: posición 3: la expresión termina donde se esperaba un símbolo o un paréntesis

(0|1
  error: posición 5: falta cerrar un paréntesis

0+1
  error: posición 2: sobra +
La tercera no es un descuido: el + de las herramientas no está entre las tres operaciones de la definición.
En errors/malformed.txt hay nueve expresiones mal formadas, y las pruebas comprueban que el parser rechaza
cada una.
En C++. En
regex.h, una expresión es un árbol de nodosRegex. Cada nodo tiene su caso,kind, que es uno deEmpty,Epsilon,Symbol,Union,ConcatyStar: los seis de la definición. Los hijos sonstd::shared_ptr<const Regex>, sinnewnidelete, y como un árbol no cambia después de construido, dos expresiones pueden compartir un subárbol. El parser tiene una función por nivel de precedencia:parse_unionllama aparse_concat, que llama aparse_star, que llama aparse_atom. Lo que liga más fuerte queda más abajo en la cadena de llamadas, y por eso más abajo en el árbol.
Leer expresiones
Leer una expresión es decir en palabras qué cadenas describe. El método es el de la definición: de adentro hacia afuera, o del árbol hacia la raíz. Tres ejemplos sobre .
Termina en 1
La raíz es una concatenación de dos partes. La primera, , es : cualquier cadena. La segunda es el símbolo . Una cadena cualquiera seguida de un : las cadenas que terminan en .
El programa regex_lang lista las cadenas más cortas del lenguaje de una expresión, en el orden de siempre.
$ build/regex_lang '(0|1)*1' 3
L((0|1)*1), hasta longitud 3:
  1 01 11 001 011 101 111
7 de 15 cadenas
De las 15 cadenas de longitud a lo sumo 3, hay 7 en el lenguaje: las que terminan en . La cadena vacía no está, porque no termina en nada.
Longitud par
Adentro, describe las cuatro cadenas de dos símbolos. La estrella las repite cero o más veces: cadenas que se parten en trozos de longitud 2. Son las de longitud par, con la vacía incluida.
$ build/regex_lang '((0|1)(0|1))*' 4
L(((0|1)(0|1))*), hasta longitud 4:
  ε 00 01 10 11 0000 0001 0010 0011 0100 0101 0110 0111 1000 1001 1010 1011 1100 1101 1110 1111
21 de 31 cadenas
Son : todas las de longitud 0, 2 y 4.
Exactamente dos unos
Es una concatenación de cinco partes. Las partes fijas son los dos unos, y entre ellas, antes y después, hay ceros en cualquier cantidad. Las cadenas con exactamente dos unos.
$ build/regex_lang '0*10*10*' 4
L(0*10*10*), hasta longitud 4:
  11 011 101 110 0011 0101 0110 1001 1010 1100
10 de 31 cadenas
En cada longitud hay tantas como maneras de elegir las dos posiciones de los unos: 1, 3 y 6 para , 3 y 4.
Para leer una expresión con estrellas, una buena pregunta es cómo se parte una cadena. La cadena está en el lenguaje porque se parte en , una parte por cada factor de la expresión, y cada parte está en el lenguaje de su factor. Que una cadena esté en quiere decir que existe alguna manera de partirla que funcione. Puede haber varias, y basta una. Es el mismo “existe” de la aceptación de un NFA, y no es casualidad.
Escribir expresiones
Escribir es más difícil que leer, igual que diseñar un autómata es más difícil que seguirlo. No hay un método que siempre funcione, pero sí una pregunta que ordena el trabajo: ¿cómo se arma una cadena del lenguaje, pieza por pieza? Un autómata se diseña pensando qué recordar. Una expresión se diseña pensando en qué trozos se parte una cadena.
Número par de ceros
Lenguaje. .
Los unos no importan: pueden estar en cualquier parte. Los ceros tienen que venir de dos en dos. Una cadena de se parte así: primero unos, y después varios bloques, cada uno con exactamente dos ceros y los unos que los acompañan.
Cada bloque empieza en un cero impar (el primero, el tercero…), llega hasta el cero par siguiente y se lleva los unos que vienen después. Por ejemplo, se parte en , que son los unos del principio, y el bloque .
$ build/regex_lang '1*(01*01*)*' 3
L(1*(01*01*)*), hasta longitud 3:
  ε 1 00 11 001 010 100 111
8 de 15 cadenas
Hay otra manera de partir las mismas cadenas: en trozos que son un suelto, o un par de ceros con
unos en medio. Eso da , que es más corta. Las dos
describen . El programa regex_diff las compara con todas las cadenas cortas:
$ build/regex_diff '1*(01*01*)*' '(1|01*0)*' 10
R1 = 1*(01*01*)*
R2 = (1|01*0)*
2047 cadenas de longitud a lo sumo 10
solo en R1: 0
solo en R2: 0
sin diferencias hasta esa longitud
Que no haya diferencias hasta longitud 10 no es una demostración: es una prueba, en el sentido de los programas. Sirve para encontrar errores, y encuentra casi todos, porque una expresión equivocada suele fallar con alguna cadena corta.
Sin 11
Lenguaje. .
Aquí la condición es negativa, y las expresiones regulares no tienen un “no”. Hay que decir en positivo cómo es una cadena sin : todo va seguido de un , salvo que sea el último símbolo. Entonces la cadena se parte en bloques y , y al final puede sobrar un :
$ build/regex_lang '(0|10)*(%|1)' 3
L((0|10)*(ε|1)), hasta longitud 3:
  ε 0 1 00 01 10 000 001 010 100 101
11 de 15 cadenas
Faltan cuatro de las 15: , , y , que son justo las que contienen .
Esta vez vale la pena demostrarlo, porque la demostración muestra cómo se razona sobre una expresión: dos inclusiones, una por cada manera de equivocarse.
Afirmación. .
Demostración. Por doble inclusión.
La expresión no describe de más (). Sea una cadena del lenguaje de la expresión. Entonces , donde es una concatenación de bloques y , y es o . En , cada es el primer símbolo de un bloque , así que el símbolo que le sigue es un : en no hay , y si no es vacía, termina en . Si , ese final va después de un o es toda la cadena. En ningún caso aparece , y .
La expresión no describe de menos (). Sea una cadena sin . La partimos de izquierda a derecha. Si el símbolo que sigue es un , lo tomamos como un bloque . Si es un y no es el último símbolo, el siguiente tiene que ser un , porque no contiene : tomamos los dos como un bloque . Si es un y es el último, queda como la parte final. Así toda la cadena queda partida en bloques y , seguidos de o de , y por lo tanto está en el lenguaje de la expresión. ∎
Probar con cadenas de los dos lados
Una expresión puede estar mal de dos maneras, y las dos pasan desapercibidas si solo se prueba con las cadenas que uno tenía en mente.
Primer intento para : , sin la parte final. Todas las cadenas que describe están bien, sin . Pero describe de menos: ninguna de sus cadenas termina en .
$ build/regex_diff '(0|10)*' '(0|10)*(%|1)' 6
R1 = (0|10)*
R2 = (0|10)*(ε|1)
127 cadenas de longitud a lo sumo 6
solo en R1: 0
solo en R2: 20. Las más cortas: 1 01 001 101 0001 0101
Segundo intento, para arreglarlo: , “y al final pueden venir unos”. Ahora están todas las cadenas de . Pero describe de más:
$ build/regex_diff '(0|10)*1*' '(0|10)*(%|1)' 6
R1 = (0|10)*1*
R2 = (0|10)*(ε|1)
127 cadenas de longitud a lo sumo 6
solo en R1: 26. Las más cortas: 11 011 111 0011 0111 1011
solo en R2: 0
La estrella final deja pasar a , que es justo lo que había que excluir.
Error común. Escribir una expresión que describe todo lo pedido y también cadenas que no debía, y comprobarla solo con ejemplos del lenguaje. Esa comprobación pasa siempre, por mala que sea la expresión: la expresión también describe todas las cadenas sin . Una expresión se prueba con cadenas de los dos lados: unas que deben estar y otras que no. Las de afuera se eligen cerca del borde: para “sin ”, la propia , y cadenas que la tienen al principio, en medio y al final. Y siempre .
En la práctica. Es el error típico de un validador: un patrón para direcciones de correo que acepta todas las direcciones de prueba y también textos que no lo son. Las pruebas de un patrón llevan siempre dos listas, lo que debe coincidir y lo que no, y la segunda es la que encuentra los errores.
Identidades y trampas
Como las expresiones se combinan con operaciones, tienen su álgebra. Algunas igualdades valen para toda expresión , y conviene conocerlas porque permiten simplificar. En cada una, el signo igual dice que los dos lados describen el mismo lenguaje.
| Identidad | Por qué |
|---|---|
| Unir con el conjunto vacío no agrega cadenas | |
| Concatenar con la cadena vacía no cambia una cadena | |
| Para formar hay que elegir en , y no hay ninguna | |
| La única manera de partir una cadena en trozos de es en cero trozos | |
| Repetir la cadena vacía da la cadena vacía | |
| Es una unión de conjuntos | |
| Repetir repeticiones es repetir |
Las cuatro primeras son las de la semana 1, escritas ahora con expresiones: hace de cero y hace de uno. Si la unión fuera la suma y la concatenación el producto, las tres primeras serían , y .
La que sorprende es : la estrella de la expresión que no describe nada describe algo. Sale de la definición, porque siempre contiene a , sea lo que sea.
$ build/regex_lang '@*' 3 01
L(∅*), hasta longitud 3:
  ε
1 de 15 cadenas
$ build/regex_lang '0@' 3 01
L(0∅), hasta longitud 3:
  (ninguna)
0 de 15 cadenas
$ build/regex_lang '0|@' 3 01
L(0|∅), hasta longitud 3:
  0
1 de 15 cadenas
$ build/regex_lang '0%' 3 01
L(0ε), hasta longitud 3:
  0
1 de 15 cadenas
El tercer argumento de regex_lang es el alfabeto, que aquí hay que dar porque en @* no aparece ningún
símbolo.
Las trampas son las mismas identidades con y cruzados. Son falsas:
- es falsa en general. Si , la izquierda describe y la derecha . Unir con agrega la cadena vacía.
- es falsa. Si , la izquierda describe . Concatenar con lo destruye todo.
Error común. Tratar a y a como “nada” en los dos casos. Para la unión, el que no hace nada es . Para la concatenación, el que no hace nada es . Cruzados, uno agrega una cadena y el otro borra el lenguaje entero.
Estas identidades no son solo una curiosidad. En la sesión B, un programa va a construir expresiones de forma
mecánica, y sin ellas arrastraría términos como por todas
partes. Las funciones simple_union, simple_concat y simple_star de regex.h aplican las cinco primeras
filas de la tabla, y nada más.
Otras igualdades son menos evidentes. Por ejemplo, : los dos lados describen . No hay un procedimiento simple, como el de simplificar polinomios, que lleve una expresión a una forma única. Decidir si dos expresiones son equivalentes se puede, y el camino pasa por los autómatas: es uno de los frutos del teorema de esta semana.
De expresión regular a NFA: la construcción de Thompson
Ahora la primera de las dos direcciones: dada una expresión , construir un autómata que reconozca .
La idea ya la tienen. La definición de expresión regular tiene seis casos. Para los tres casos base, el autómata se escribe a mano: son lenguajes de una cadena o de ninguna. Para los otros tres, la semana pasada vieron cómo combinar NFA con transiciones para obtener la unión, la concatenación y la estrella. Entonces basta recorrer el árbol de la expresión de las hojas a la raíz, armando en cada nodo el autómata de ese nodo con los autómatas de sus hijos.
La versión que usaremos es la de Ken Thompson, que la publicó en 1968 como parte de un algoritmo para buscar patrones en texto. Son las construcciones de cierre de la semana pasada con una disciplina adicional, que las hace más fáciles de programar y de contar.
La disciplina. Cada pieza tiene un solo estado inicial y un solo estado de aceptación, distintos entre sí. Al combinar piezas solo se agregan estados nuevos y transiciones : nunca se toca lo que hay dentro de una pieza ya construida.
Con una sola entrada y una sola salida, una pieza se puede tratar como una caja: para conectarla no hace falta saber qué tiene adentro.
Las seis piezas
Llamaremos a la entrada de una pieza y a su salida, que es su único estado de aceptación.
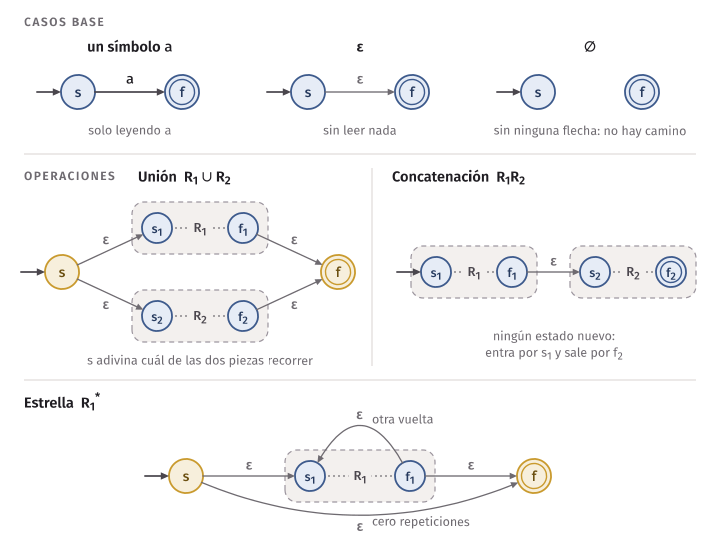
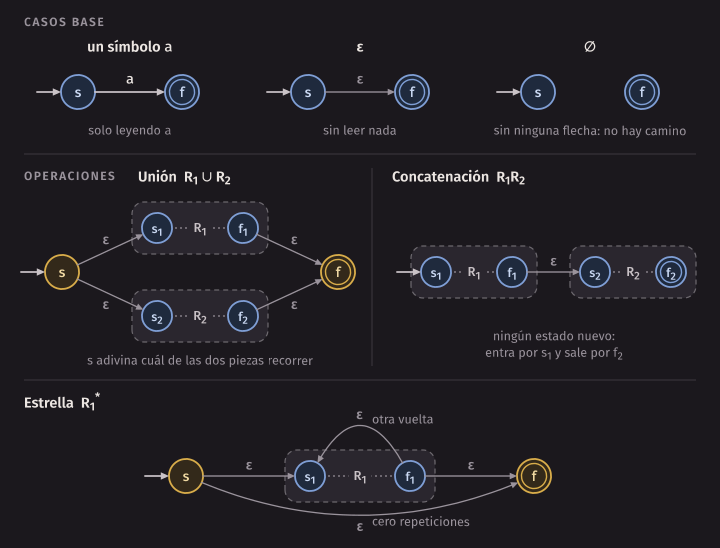
Los casos base. Tres piezas de dos estados.
Para un símbolo , la única manera de ir de a es leyendo . Para , sin leer nada. Para no hay ninguna manera, y el autómata no acepta nada.
Unión. Dadas la pieza de , con entrada y salida , y la de , con y , se agregan una entrada nueva y una salida nueva , con cuatro transiciones : dos de a las entradas y , y dos de las salidas y a .
Desde , el autómata adivina cuál de las dos piezas va a recorrer. Al salir de cualquiera de las dos llega a .
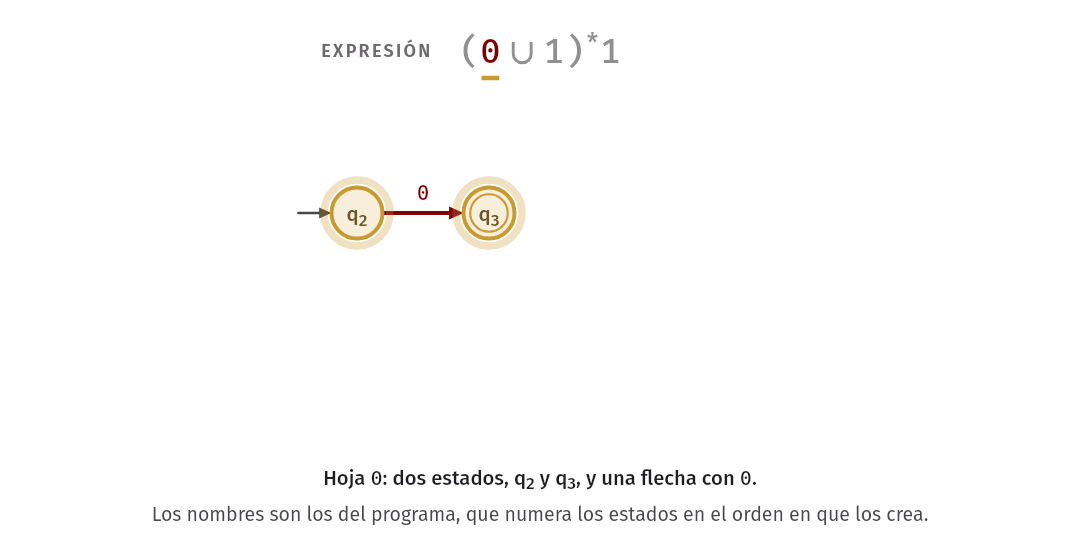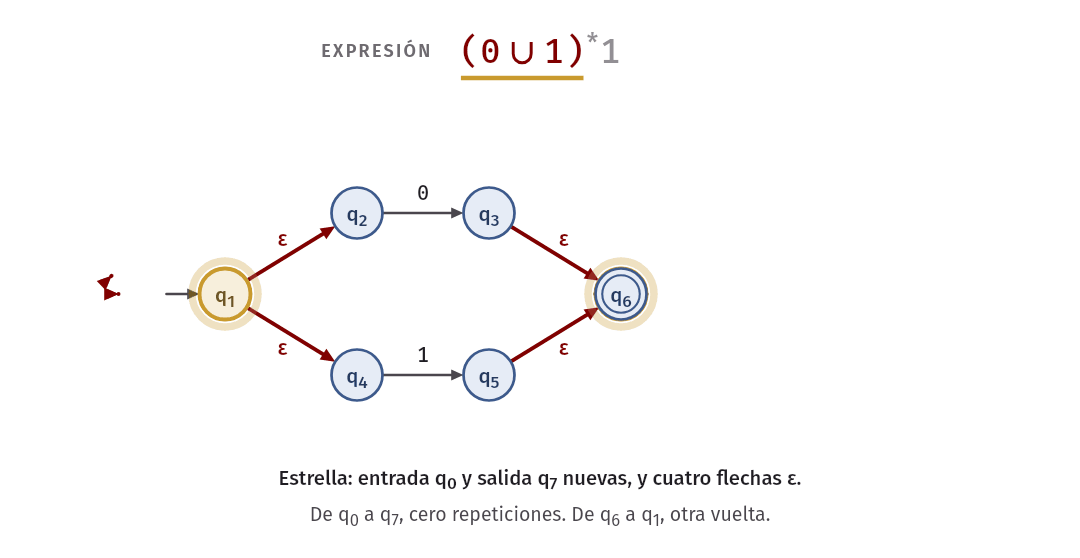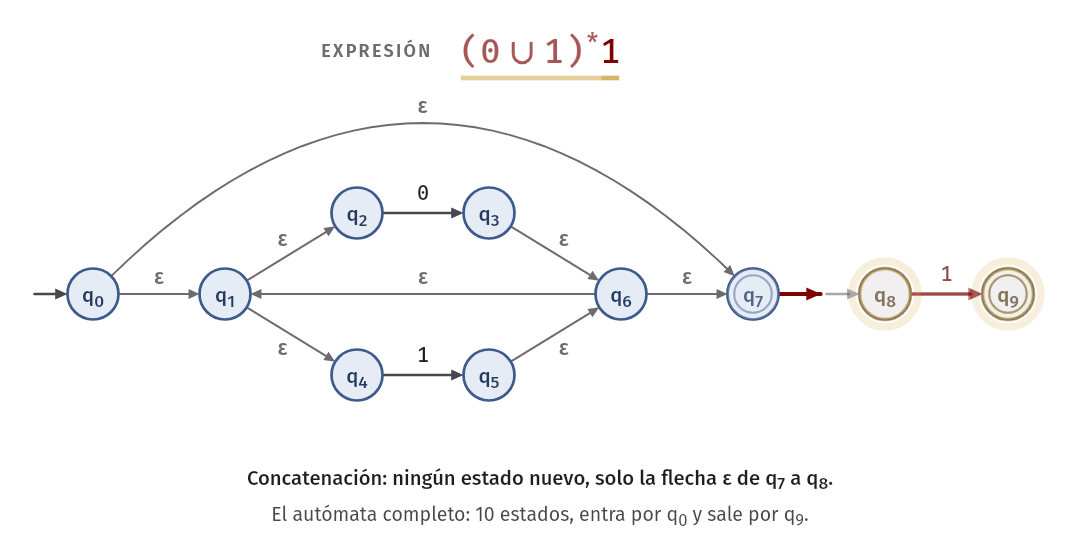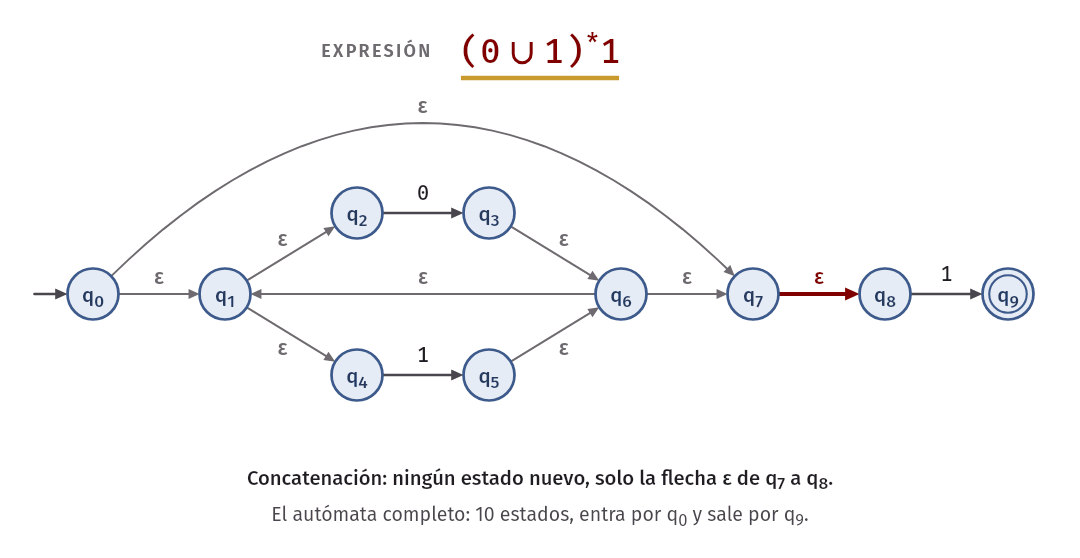
Concatenación. No se agrega ningún estado: una transición une la salida de la primera pieza con la entrada de la segunda. La entrada del conjunto es y la salida es .
Estrella. Una entrada y una salida nuevas, y cuatro transiciones : de a , de a , de de vuelta a , y de directo a .
Desde se puede ir directo a , sin recorrer la pieza: cero repeticiones. O entrar a la pieza, y al llegar a elegir entre volver a , para dar otra vuelta, y salir a .
La estrella es la operación delicada, como vieron la semana pasada: marcar el estado inicial de la pieza como de aceptación, para aceptar , puede hacer que el autómata acepte cadenas que no debía. Aquí el problema no aparece, porque la entrada y la salida nuevas no forman parte de la pieza: nada de lo que pasa adentro puede terminar en sin haber llegado antes a .
En el formato .nfa, las piezas más pequeñas se ven así. El programa thompson recibe una expresión y escribe
su autómata:
$ build/thompson '0|1'
# NFA de Thompson de 0|1
states: q0 q1 q2 q3 q4 q5
alphabet: 0 1
start: q0
accept: q5
delta:
q0 eps q1 q3
q1 0 q2
q2 eps q5
q3 1 q4
q4 eps q5
La entrada nueva es q0 y la salida nueva es q5. La pieza del es q1 y q2, y la del
es q3 y q4.
$ build/thompson '0*'
# NFA de Thompson de 0*
states: q0 q1 q2 q3
alphabet: 0
start: q0
accept: q3
delta:
q0 eps q1 q3
q1 0 q2
q2 eps q1 q3
Aquí la pieza del es q1 y q2. Desde q0 se entra a la pieza o se salta a q3. Desde q2, la
salida de la pieza, se vuelve a q1 o se sale a q3.
Un ejemplo completo
Construyamos el autómata de , la expresión de las cadenas que terminan en . Su árbol tiene 6 nodos: una concatenación en la raíz, con la estrella de una unión a la izquierda y un a la derecha.
$ build/thompson '(0|1)*1'
# NFA de Thompson de (0|1)*1
states: q0 q1 q2 q3 q4 q5 q6 q7 q8 q9
alphabet: 0 1
start: q0
accept: q9
delta:
q0 eps q1 q7
q1 eps q2 q4
q2 0 q3
q3 eps q6
q4 1 q5
q5 eps q6
q6 eps q1 q7
q7 eps q8
q8 1 q9
El programa numera los estados en el orden en que los crea. Cada grupo de estados es una pieza:
| Nodo del árbol | Entrada | Salida | Estados nuevos |
|---|---|---|---|
| , | |||
| , el de la unión | , | ||
| , | |||
| , | |||
| , el final | , | ||
| la concatenación | ninguno |
Como diagrama, armado en el orden de la tabla:
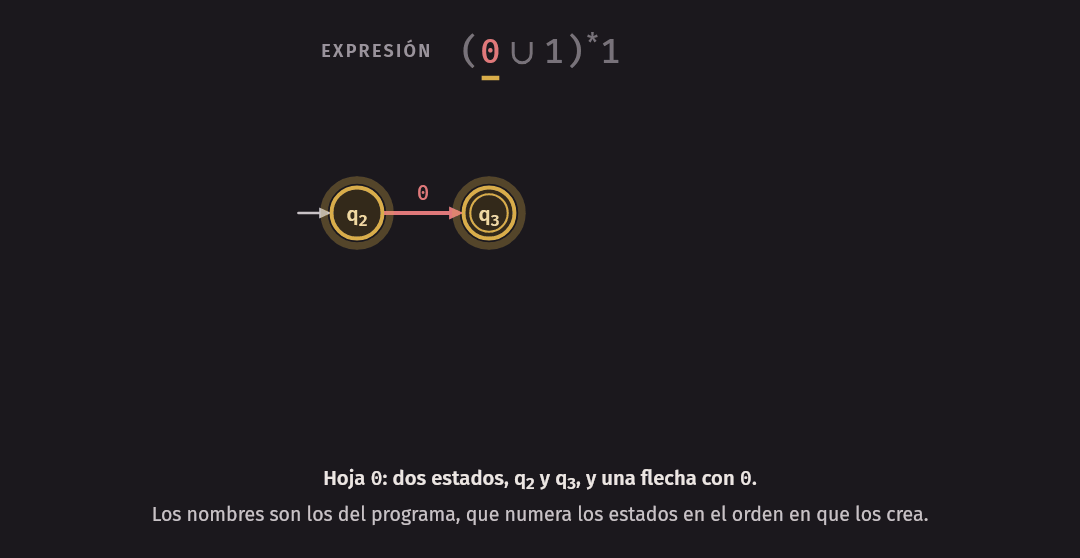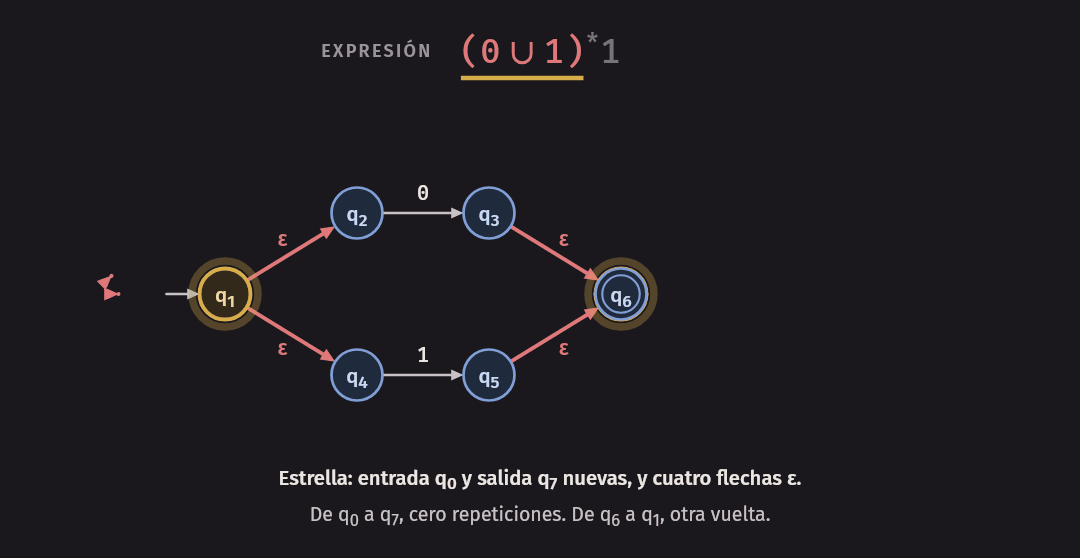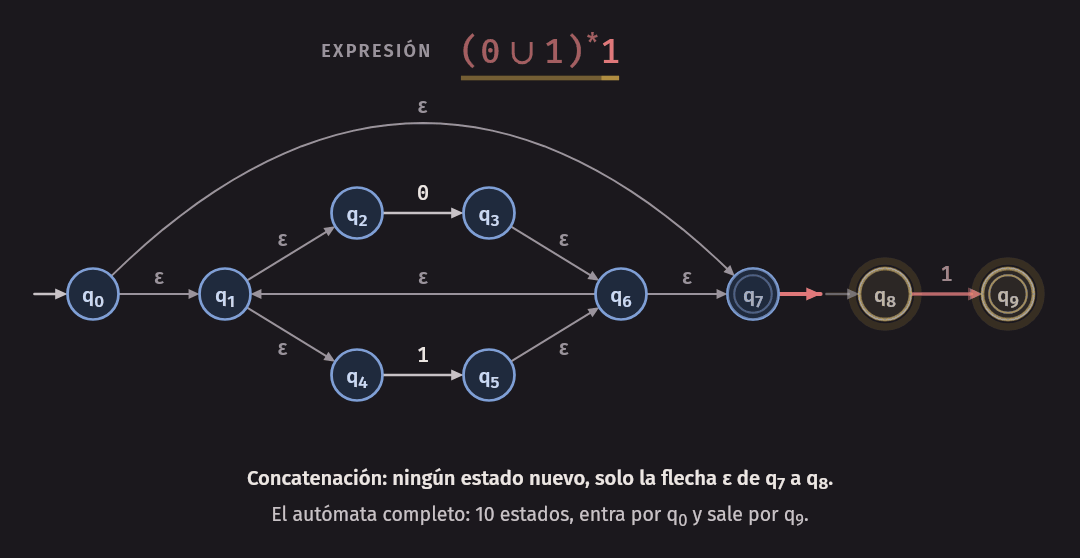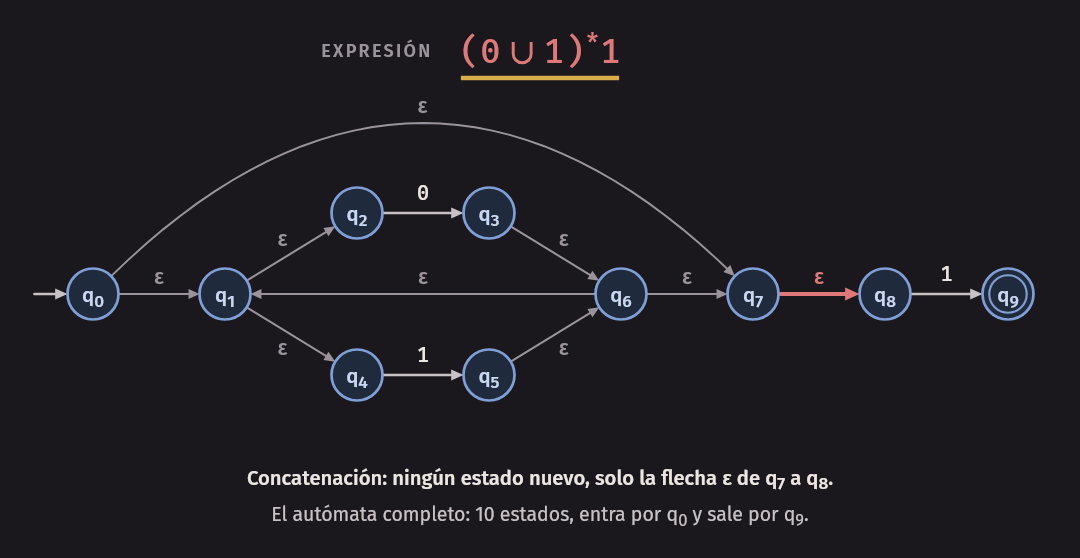
La tabla de transiciones tiene una columna más que la de un DFA, la de , y en cada casilla hay un conjunto de estados. Las casillas vacías son : desde ahí, con ese símbolo, el camino muere.
Este autómata está guardado en machines/ends_in_1.nfa. Para seguirlo con una cadena se lleva, como la semana
pasada, el conjunto de estados activos: todos los estados en los que el autómata puede estar después de lo
leído. Se empieza con la clausura del estado inicial. Con cada símbolo se avanza por las flechas
de ese símbolo desde todos los activos, y se toma otra vez la clausura .
$ build/run_nfa machines/ends_in_1.nfa 011 010 ''
w = 011
  inicio  {q0, q1, q2, q4, q7, q8}
  lee 0   {q1, q2, q3, q4, q6, q7, q8}
  lee 1   {q1, q2, q4, q5, q6, q7, q8, q9}
  lee 1   {q1, q2, q4, q5, q6, q7, q8, q9}
  hay un estado de F entre los activos: acepta
w = 010
  inicio  {q0, q1, q2, q4, q7, q8}
  lee 0   {q1, q2, q3, q4, q6, q7, q8}
  lee 1   {q1, q2, q4, q5, q6, q7, q8, q9}
  lee 0   {q1, q2, q3, q4, q6, q7, q8}
  ningún estado activo está en F: rechaza
w = ε
  inicio  {q0, q1, q2, q4, q7, q8}
  ningún estado activo está en F: rechaza
Miren el conjunto inicial. Antes de leer nada, el autómata ya está en seis estados a la vez: en y , listo para leer un símbolo de , y en , listo para leer el final. No sabe cuál de los unos será el último, y no hace falta que lo sepa: sigue las dos posibilidades. Después de cada , el estado está entre los activos, que es la manera en que el autómata dice “si la cadena terminara aquí, la aceptaría”.
Idea clave. La construcción de Thompson copia la estructura de la expresión: una pieza por cada nodo del árbol, con una entrada y una salida. Las transiciones son el pegamento. El autómata que sale no es pequeño ni elegante, pero se construye sin pensar, y eso es justo lo que necesita un programa.
Por qué funciona
Teorema. Para toda expresión regular hay un NFA que reconoce .
Demostración. Por construcción, y la construcción es la de Thompson. Demostramos algo un poco más preciso, que es lo que permite combinar piezas.
Afirmación. La pieza de , con entrada y salida , cumple para toda cadena : hay un camino de a que deletrea si y solo si .
Un camino deletrea si, al leer en orden las etiquetas de sus flechas y saltarse las , sale . Como es el estado inicial y el único de aceptación, la afirmación dice exactamente que el autómata acepta si y solo si .
La demostración es por inducción sobre la estructura de : se demuestra para los casos base y, para cada operación, se supone cierta para las expresiones más pequeñas y . Es la inducción sobre el tamaño del árbol.
Casos base. En la pieza de un símbolo hay un solo camino de a , y deletrea : la afirmación vale porque . En la de hay un solo camino, que deletrea . En la de no hay ninguno, y no tiene cadenas.
Unión. Supongamos la afirmación para las piezas de y de .
Si , entonces está en o en . Digamos que en . Por hipótesis hay un camino de a que deletrea . Con la flecha de a delante y la de a detrás, es un camino de a que deletrea .
Al revés, tomemos un camino de a que deletrea . Su primera flecha sale de , y de solo salen las dos hacia y . Digamos que va a . Desde ahí el camino está dentro de la pieza de , y la única flecha que sale de esa pieza es la de a . De no sale ninguna flecha, así que el camino termina ahí. El camino es entonces: una , un camino de a dentro de la pieza de , y otra . El tramo del medio deletrea , y por hipótesis .
Concatenación. Si , entonces con y . Un camino de a que deletrea , la flecha de a , y un camino de a que deletrea forman un camino de a que deletrea .
Al revés, un camino de a tiene que pasar de la primera pieza a la segunda, y la única flecha que las une es la de a . No hay flechas de vuelta, así que la usa exactamente una vez. Lo que hay antes es un camino de a dentro de la primera pieza, que deletrea alguna . Lo que hay después es un camino de a dentro de la segunda, que deletrea alguna . Y .
Estrella. Si , hay dos casos. Si , la flecha de a es un camino que la deletrea. Si no, con y cada . Por hipótesis, para cada hay un camino de a que lo deletrea. El camino buscado entra con la de a , recorre esos caminos unidos por la flecha de vuelta, de a , y sale con la de a .
Al revés, tomemos un camino de a que deletrea . Si es la flecha directa, , que está en . Si no, empieza con la de a y termina con la de a , porque a solo se llega desde y desde . Entre una y otra, el camino solo puede usar flechas de la pieza de y la flecha de vuelta. Lo cortamos en cada uso de la flecha de vuelta. Cada trozo empieza en , termina en y usa solo flechas de la pieza: por hipótesis deletrea una cadena de . Entonces es una concatenación de una o más cadenas de , y está en . ∎
La demostración tiene la misma forma que la definición y que el programa: seis casos. La función
build_fragment de thompson.h es un switch con esos seis casos, y cada uno hace lo que dice su dibujo.
Cuántos estados tiene
Contemos. Cada caso base crea 2 estados. La unión y la estrella crean 2 cada una. La concatenación no crea ninguno. Entonces el número de estados es exactamente
Para son 3 hojas, 1 unión y 1 estrella: estados, los de arriba. Y las flechas también son pocas: de cada estado salen a lo sumo dos. En las seis piezas se ve que de un estado sale una flecha con un símbolo, o una o dos , o ninguna.
Idea clave. El NFA de Thompson tiene un número de estados y de flechas lineal en el tamaño de la expresión: a lo sumo estados y flechas. Pasar de la descripción a una máquina no determinista es barato. Lo caro, cuando hace falta, es el paso siguiente: la construcción de subconjuntos puede multiplicar los estados de forma exponencial.
Si se compara con lo que uno dibujaría a mano, sobran estados. Para las cadenas que terminan en basta un NFA de dos estados: uno con un ciclo para y , y una flecha con al de aceptación. Los ocho estados de más son el precio de no pensar. Hay construcciones que evitan las transiciones y dan autómatas más pequeños, pero ninguna es tan simple de programar ni de demostrar.
En C++.
thompson.hagrega los estados a unNfaconnew_state, que les pone el siguiente nombre libre, y cada caso devuelve unFragment: el nombre de la entrada y el de la salida. La concatenación son tres líneas: construir la primera pieza, construir la segunda, y agregar una transición entre ellas. El código construye las dos piezas en dos instrucciones separadas a propósito: si las dos llamadas fueran argumentos de una misma función, C++ no fija cuál se evalúa primero, y los estados podrían quedar numerados de otro modo en otra máquina.
Las abreviaturas de las herramientas
Las expresiones de grep, de un editor o de un lenguaje de programación tienen muchos más operadores que los
tres de la definición. Casi todos son abreviaturas: se pueden reescribir con unión, concatenación y
estrella, y por eso no agregan ningún lenguaje nuevo.
| En las herramientas | Significa | Con las tres operaciones |
|---|---|---|
R+ |
Una o más repeticiones | |
R? |
Opcional: cero o una vez | |
[abc] |
Uno de estos símbolos | |
[a-z] |
Un símbolo del rango | |
. |
Un símbolo cualquiera | |
R{3} |
Exactamente tres veces | |
R{2,3} |
Entre dos y tres veces | |
R{2,} |
Dos veces o más |
El argumento de que no agregan poder es siempre el mismo: una expresión con abreviaturas se traduce, operador por operador, a una expresión de la definición que describe el mismo lenguaje. Entonces todo lenguaje que se describe con abreviaturas se describe también sin ellas. La expresión de las fechas del principio es
Y los enteros sin ceros a la izquierda, que en una herramienta serían 0|[1-9][0-9]*, son
. Las
pruebas de la semana comparan esa expresión, escrita entera, con una función que mira si la cadena es
o empieza con un dígito distinto de cero.
Que no agreguen poder no quiere decir que no sirvan. Sirven para escribir menos, a veces muchísimo menos:
[a-z]{1000} son once caracteres, y la expresión sin abreviaturas tiene 1000 copias de una unión de 26
símbolos. Las llaves pueden hacer que la expresión traducida, y con ella su autómata, sea exponencialmente más
grande que lo que se escribió, porque el número va escrito en decimal.
Hay dos diferencias más entre las herramientas y la teoría, que no son abreviaturas sino convenciones.
- Buscar frente a coincidir. es el conjunto de las cadenas que describe completas.
grep, por defecto, imprime una línea si el patrón aparece en alguna parte de ella. En nuestros términos,grep Rdecide si la línea está en . Con la opción-x, o con las anclas^y$al principio y al final del patrón, pide la línea completa. - El alfabeto. Para la teoría es un conjunto pequeño que se fija de antemano. Para una herramienta son
todos los caracteres, y hace falta una manera de escribir como símbolo un carácter que también es operador:
\*,\(,\|.
$ printf '1\n0110\n\n0111\n' | grep -xE '(0|1)*1'
1
0111
Con -x, grep hace lo mismo que nuestra definición: de las cuatro líneas, imprime las dos que terminan en
. La tercera línea es la cadena vacía. La opción -E elige la sintaxis en la que |, ( y )
son operadores sin necesidad de barra invertida.
En la práctica. No todo lo que una herramienta llama regex es una expresión regular en el sentido de este capítulo. Algunas agregan operadores que no son abreviaturas, y con ellos describen lenguajes que ningún autómata finito reconoce. El más conocido es la referencia hacia atrás, que aparece al final de la sesión B.
La dirección difícil
La sesión A mostró que toda expresión regular tiene su autómata. Como todo NFA se convierte en un DFA, el lenguaje de una expresión regular es siempre regular. Falta la otra dirección: ¿todo lenguaje regular tiene una expresión?
No es evidente. Las expresiones no tienen complemento ni intersección, y los lenguajes regulares son cerrados bajo los dos. El lenguaje de las cadenas sin nos costó dos intentos fallidos, y su DFA sale casi sin pensar: es el complemento de “contiene ”. ¿Y si hubiera lenguajes regulares que ninguna expresión alcanza a describir?
Intentemos leer la expresión directamente de un diagrama, con el autómata de la paridad de la semana 1, que
acepta las cadenas con un número par de unos. Está en machines/even_ones.dfa.
| (inicial, de aceptación) | ||
Una cadena aceptada es un paseo que sale de y vuelve a . Ese paseo se parte en vueltas: cada vuelta sale de y regresa por primera vez. Hay dos tipos de vuelta. La corta es el ciclo con . La larga va a con un , se queda ahí dando vueltas con ceros, y regresa con otro : es . Una cadena aceptada es cualquier secuencia de vueltas:
Funcionó, y lo que hicimos tiene nombre. Para describir las vueltas largas nos deshicimos del estado : resumimos todo lo que pasa mientras el autómata está ahí en una sola expresión, , que va de a . El estado desapareció y, a cambio, una flecha pasó a llevar una expresión en vez de un símbolo.
Esa es la idea de toda la sesión. Con dos estados se hace de memoria. Con veinte hay que hacerlo con método, y el método necesita un tipo de autómata en el que una flecha pueda llevar una expresión.
Autómatas con expresiones en las flechas
Definición. Un autómata finito no determinista generalizado (generalized nondeterministic finite automaton), o GNFA, es un autómata en el que cada flecha lleva una expresión regular, y que cumple tres condiciones de forma:
- Tiene un estado inicial al que no entra ninguna flecha.
- Tiene un único estado de aceptación , distinto del inicial, del que no sale ninguna flecha.
- Entre cada par de estados hay exactamente una flecha en cada sentido, y cada estado tiene una flecha a sí mismo, salvo lo que prohíben las condiciones 1 y 2.
La expresión de la flecha que va de a se escribe . La condición 3 parece exigir muchísimas flechas, pero una flecha puede llevar la expresión , y una flecha con no se puede usar nunca. Entonces la condición se cumple sola con un convenio: una flecha que no está dibujada lleva .
Un GNFA lee la entrada por trozos. Para pasar de a consume de la entrada un trozo entero, que tiene que estar en . Con precisión: el GNFA acepta si se puede partir en trozos , donde cada es una cadena, y hay una secuencia de estados tal que:
- y ;
- para cada , el trozo está en , donde es la expresión de la flecha de a .
Un trozo puede ser vacío, si la expresión de su flecha describe . Un NFA es el caso en el que todas las expresiones son un símbolo o .
Normalizar un DFA
Un DFA cualquiera no cumple las condiciones 1 y 2: su estado inicial puede tener flechas que entran, y puede tener varios estados de aceptación, con flechas que salen. Se arregla con dos estados nuevos.
- Un estado inicial nuevo, , con una flecha al estado inicial del DFA.
- Un estado de aceptación nuevo, , al que llega una flecha desde cada estado de aceptación del DFA. Los que eran de aceptación dejan de serlo.
- Si de un estado a otro hay varias flechas, con símbolos distintos, se juntan en una que lleva la unión de esos símbolos.
El programa eliminate empieza mostrando el GNFA de un DFA. Los estados nuevos se llaman ini y fin.
Autómata generalizado de machines/even_ones.dfa
  estados: ini par impar fin
  ini -> par :  ε
  par -> par :  0
  par -> impar :  1
  par -> fin :  ε
  impar -> par :  1
  impar -> impar :  0
El GNFA tiene dos estados más que el DFA. Las flechas que no aparecen en la lista, como la de ini a impar,
llevan .
Afirmación. El GNFA de un DFA acepta las mismas cadenas que .
Demostración. En las dos direcciones.
Si acepta , su ejecución es con y . En el GNFA, la secuencia con los trozos cumple la definición: la flecha de a lleva la unión de los símbolos que hacen ese paso, y es uno de ellos.
Al revés, supongamos que el GNFA acepta con cierta secuencia de estados. De sale una sola flecha que no es , la hacia : el primer trozo es y el segundo estado es . A solo llegan flechas desde estados de : el último trozo es y el penúltimo estado está en . Todas las demás flechas llevan una unión de símbolos, así que cada trozo intermedio es un solo símbolo , y va de un estado a . Los estados intermedios son entonces la ejecución de con , que termina en . ∎
Eliminar un estado
Ahora el paso central. Tenemos un GNFA con al menos tres estados y queremos otro con un estado menos que acepte lo mismo. Elegimos un estado que no sea ni , y lo quitamos. Para que no se pierda ninguna cadena hay que reparar las flechas: todo camino que pasaba por tiene que seguir existiendo sin él.
Un camino que pasa por entra desde algún estado , da cero o más vueltas en el ciclo de sobre sí mismo, y sale hacia algún estado . Lo que lee en ese tramo es un trozo de , después cero o más trozos de , y después un trozo de . Eso es una concatenación con una estrella en medio. La flecha directa de a pasa a ofrecer las dos posibilidades, la que ya tenía y el desvío:
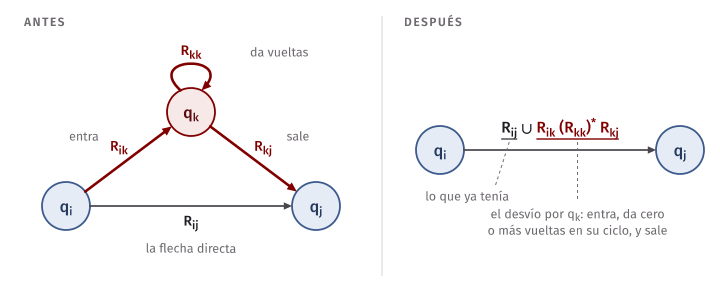
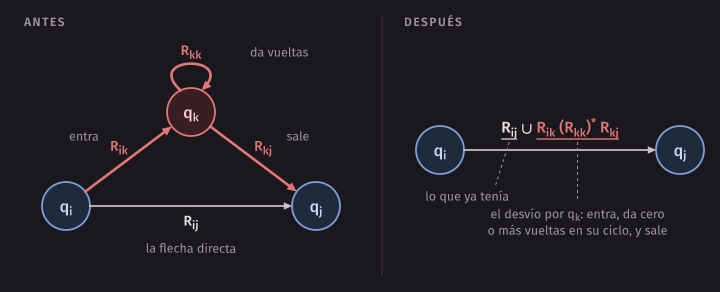
La regla. Para eliminar , se cambia la expresión de cada pareja de los estados que quedan por . Después se borra con todas sus flechas.
“Cada pareja” incluye las parejas con : el ciclo de un estado sobre sí mismo también se repara. E incluye las dos direcciones, y , que son parejas distintas. Solo se excluyen las que las condiciones de forma prohíben: no hace de y no hace de .
En la práctica, casi todas las parejas se resuelven solas gracias a las identidades de la sesión A. Si no hay flecha de a , entonces , el desvío es , y la flecha queda como estaba, porque . Solo cambian las parejas en las que tiene una flecha hacia y tiene una flecha hacia . Y si no tiene ciclo, , y el factor del medio es , que desaparece de la concatenación.
Método para hacerlo a mano sin olvidar nada:
- Listar los estados que entran a : los con flecha hacia .
- Listar los estados que salen de : los a los que tiene flecha.
- Anotar el ciclo , si lo hay.
- Por cada combinación de uno que entra y uno que sale, calcular y unirlo a la flecha de a . Si hay que entran y que salen, son parejas. Un mismo estado puede estar en las dos listas, y entonces la pareja repara su ciclo.
El ejemplo de dos estados
Eliminemos en el GNFA de la paridad.
- Entra: , con .
- Sale: , con .
- Ciclo: .
- Una sola pareja, :
Queda un GNFA de tres estados, , y . Ahora eliminamos . Entra con , sale con , y el ciclo es el que acabamos de calcular. No había flecha de a :
Quedan dos estados y una flecha. La expresión de esa flecha es la respuesta, y es la que habíamos leído del diagrama. El programa hace los mismos pasos:
$ build/eliminate machines/even_ones.dfa impar par
Autómata generalizado de machines/even_ones.dfa
  estados: ini par impar fin
  ini -> par :  ε
  par -> par :  0
  par -> impar :  1
  par -> fin :  ε
  impar -> par :  1
  impar -> impar :  0

Se elimina impar
  estados: ini par fin
  ini -> par :  ε
  par -> par :  0|10*1
  par -> fin :  ε

Se elimina par
  estados: ini fin
  ini -> fin :  (0|10*1)*

Expresión: (0|10*1)*
Error común. Al eliminar un estado, olvidar su ciclo o alguna de las parejas. Sin el ciclo, la flecha reparada sería , y se perderían todas las cadenas que dan vueltas en , como . El otro olvido es más frecuente cuando el estado tiene varias entradas y varias salidas: con 2 que entran y 3 que salen son 6 parejas, y cada una que falte quita cadenas del lenguaje. Por eso conviene hacer las dos listas antes de calcular nada, y contar.
Un ejemplo completo: los múltiplos de 3
El DFA de tres estados de la semana 1 que reconoce los múltiplos de 3 en binario está en
machines/multiple_of_3.dfa. El estado dice que el valor de lo leído deja resto al dividir entre 3.
| (inicial, de aceptación) | ||
¿Qué expresión regular describe los múltiplos de 3? No es nada evidente, y con el método sale sin pensar. Eliminaremos en el orden , , .
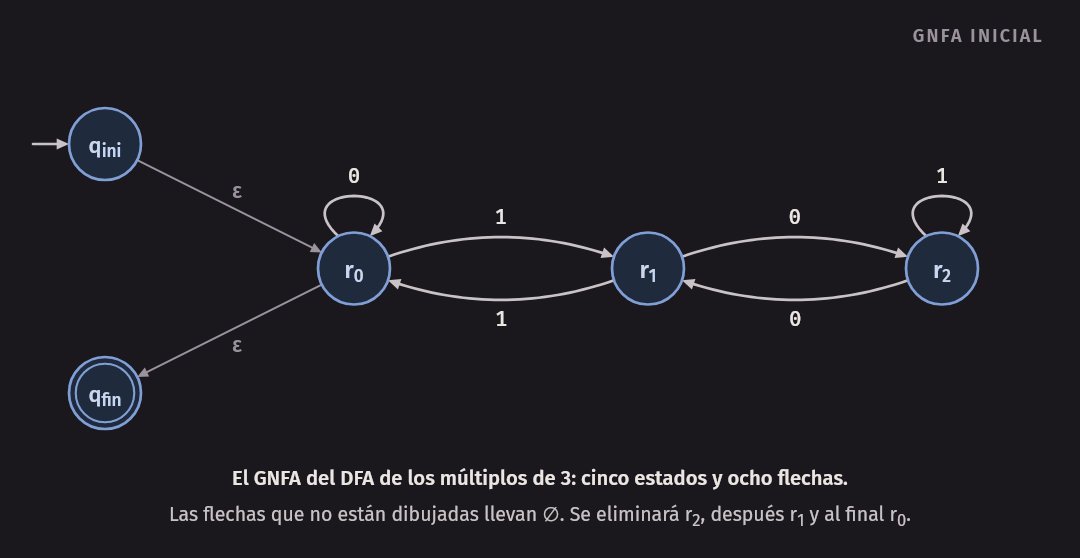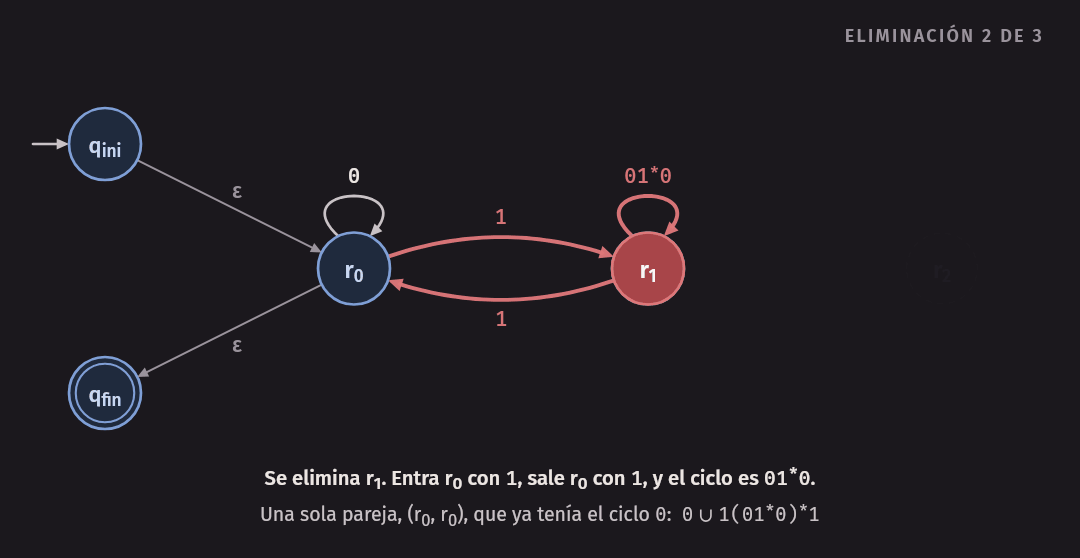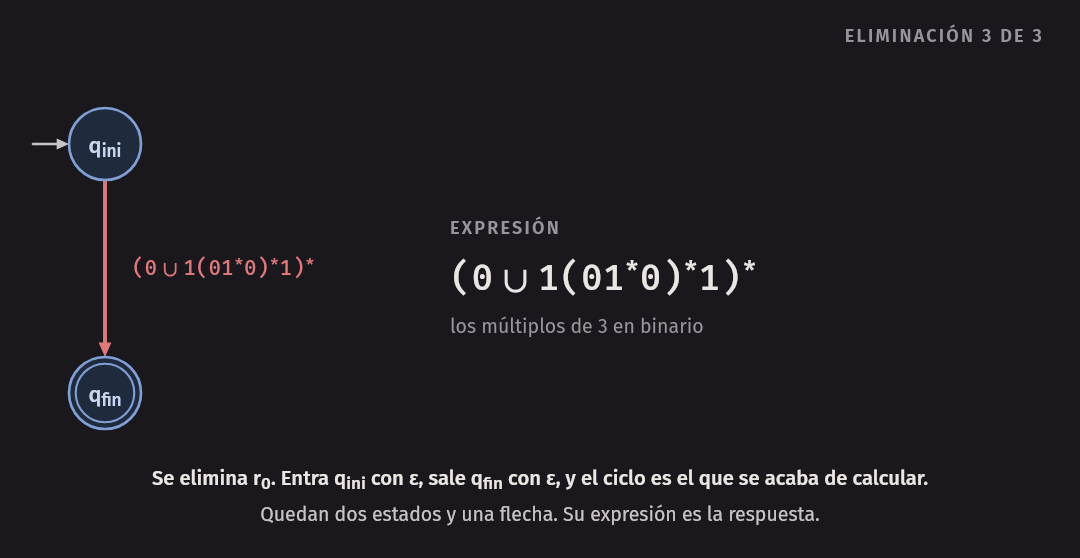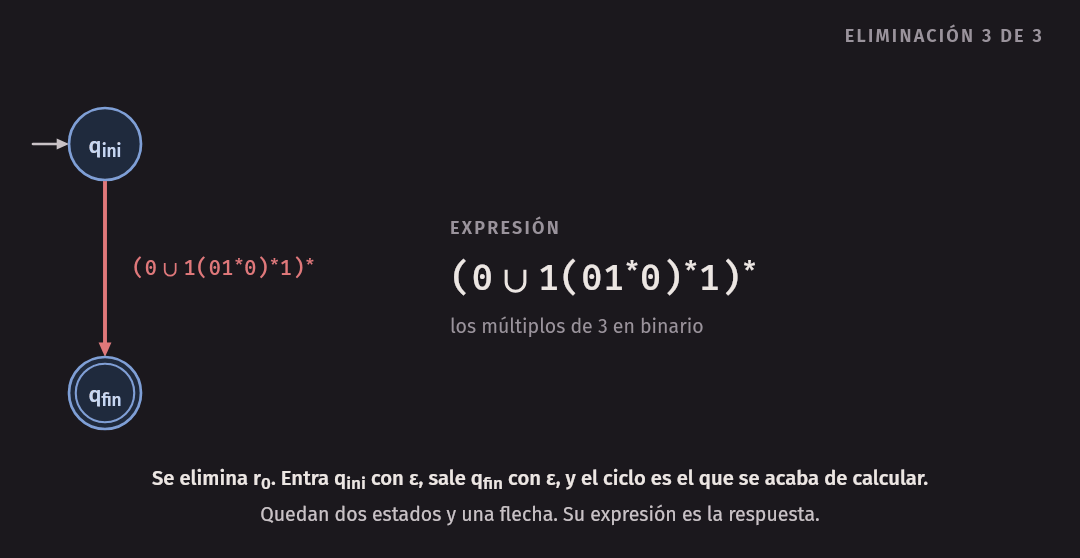
El GNFA inicial. Cinco estados y ocho flechas.
$ build/eliminate machines/multiple_of_3.dfa r2 r1 r0
Autómata generalizado de machines/multiple_of_3.dfa
  estados: ini r0 r1 r2 fin
  ini -> r0 :  ε
  r0 -> r0 :  0
  r0 -> r1 :  1
  r0 -> fin :  ε
  r1 -> r0 :  1
  r1 -> r2 :  0
  r2 -> r1 :  0
  r2 -> r2 :  1
Se elimina . Entra , con . Sale , con . El ciclo es . Hay una sola pareja, , y no tenía ciclo:
Se elimina r2
  estados: ini r0 r1 fin
  ini -> r0 :  ε
  r0 -> r0 :  0
  r0 -> r1 :  1
  r0 -> fin :  ε
  r1 -> r0 :  1
  r1 -> r1 :  01*0
La flecha nueva resume toda excursión de a y de vuelta. Las otras cinco flechas no cambiaron, porque sus parejas no tenían desvío por .
Se elimina . Entra , con . Sale , con . El ciclo es . Otra vez una sola pareja, , que ya tenía el ciclo :
Se elimina r1
  estados: ini r0 fin
  ini -> r0 :  ε
  r0 -> r0 :  0|1(01*0)*1
  r0 -> fin :  ε
Se elimina . Entra con , sale con :
Se elimina r0
  estados: ini fin
  ini -> fin :  (0|1(01*0)*1)*

Expresión: (0|1(01*0)*1)*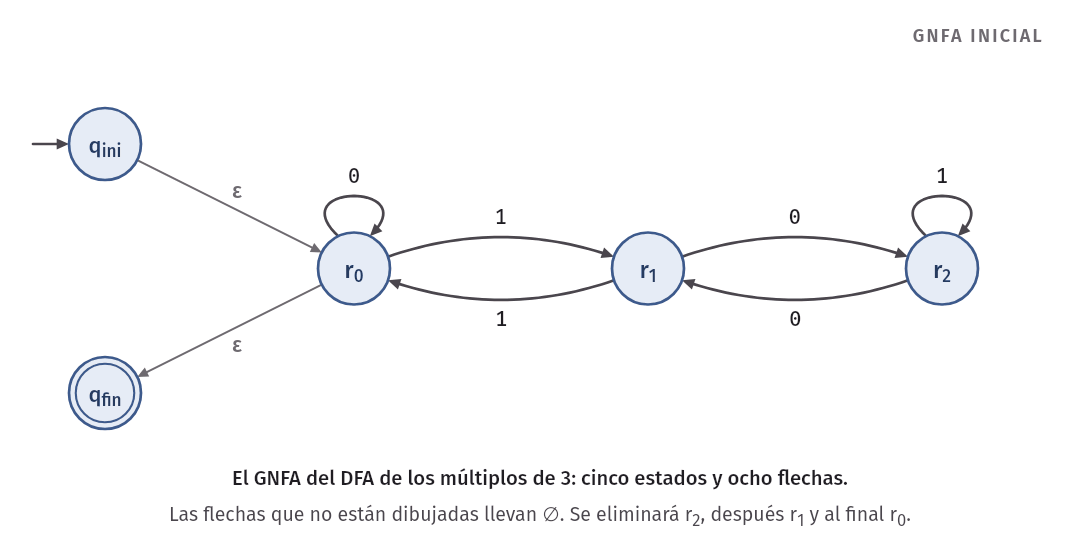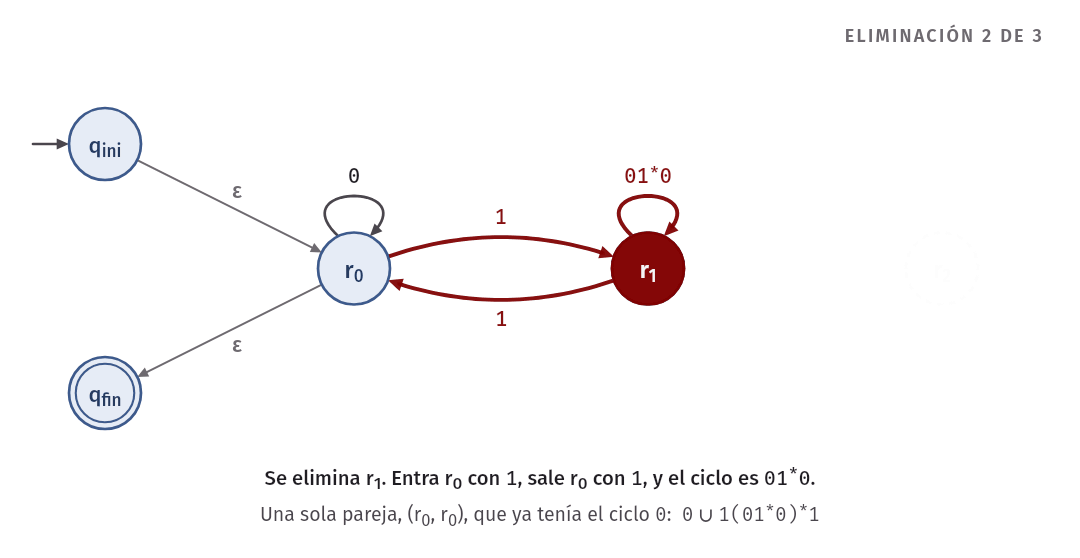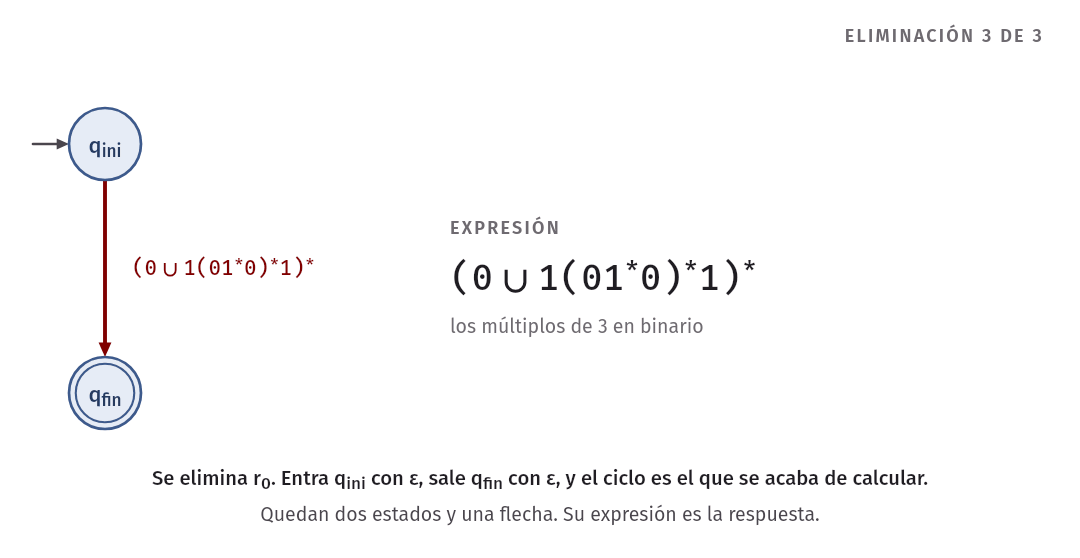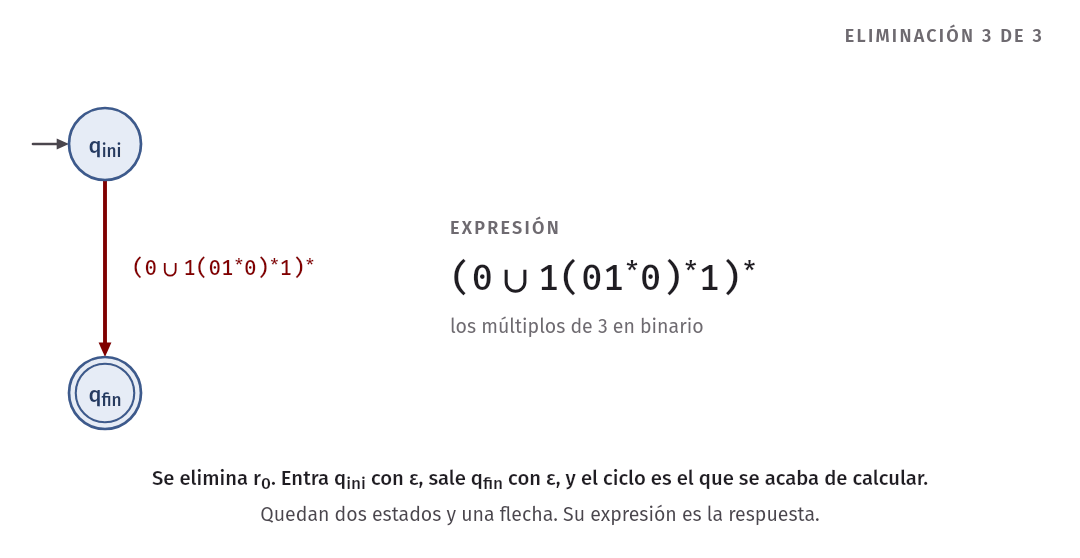
La respuesta. Los múltiplos de 3 en binario son
La expresión se puede leer, ahora que la tenemos. Un múltiplo de 3 es una secuencia de vueltas desde el resto 0 hasta el resto 0. La vuelta corta es un , que duplica el valor y conserva el resto. La larga sale con un al resto 1, hace cualquier número de excursiones al resto 2 y de vuelta, y regresa con un . Por ejemplo, , que es 9, es una vuelta larga con una excursión . Y , que es 6, son dos vueltas: y .
Las pruebas de la semana cierran el círculo con esta expresión: la convierten en un NFA con la construcción de Thompson y comprueban que ese NFA y el DFA original responden lo mismo con todas las cadenas cortas.
Por qué funciona la eliminación
Afirmación. Sea un GNFA con al menos tres estados, y el que resulta de eliminar el estado con la regla. Entonces y aceptan las mismas cadenas.
Demostración. En las dos direcciones. Escribimos para las expresiones de y para las de .
Lo que acepta lo acepta . Supongamos que acepta con los estados y los trozos . Si no aparece entre los estados, la misma secuencia sirve en : cada es una unión que contiene a , así que cada trozo sigue estando en el lenguaje de su flecha.
Si aparece, miramos cada racha de apariciones seguidas. Una racha no está al principio ni al final, porque no es ni : tiene un estado antes, , y uno después, , y los dos son distintos de . Los trozos que se leen desde hasta son: uno de , para entrar; uno de por cada paso de a dentro de la racha, que pueden ser cero; y uno de , para salir. Su concatenación está en , y por lo tanto en . Reemplazamos toda la racha por un solo paso de a que lee esa concatenación. Los pasos que no tocan a sirven tal cual, como en el caso anterior. Hecho esto con cada racha, queda una secuencia sin que cumple la definición en y lee la misma .
Lo que acepta lo acepta . Supongamos que acepta con ciertos estados y trozos. Miramos cada paso, de a con el trozo . Como , hay dos casos. Si , el mismo paso existe en . Si no, con , cada en , y : en reemplazamos el paso por el desvío , que lee esos mismos trozos. La secuencia que resulta cumple la definición en y lee la misma . ∎
Con la afirmación, el algoritmo completo queda demostrado.
Teorema. Para todo DFA hay una expresión regular con .
Demostración. Por construcción. Se normaliza para obtener un GNFA con estados, que acepta lo mismo que . Se eliminan los estados de uno por uno, en cualquier orden: cada eliminación conserva las cadenas aceptadas. Después de eliminaciones quedan y , con una sola flecha entre ellos, que lleva una expresión . Un GNFA de esa forma acepta si y solo si : la única secuencia de estados posible es , con entera como único trozo. Entonces . ∎
Dos observaciones sobre la demostración.
- Vale para cualquier orden. La afirmación no pide nada de , salvo que no sea uno de los dos estados especiales. El orden no cambia el lenguaje. Sí cambia la expresión, como veremos enseguida.
- Vale también para un NFA. La normalización funciona igual con un NFA: sus flechas ya llevan símbolos o
. Empezamos por un DFA porque es el caso que ya tienen en
machines/.
El orden de eliminación
La paridad, eliminando primero y después :
$ build/eliminate machines/even_ones.dfa par impar
Autómata generalizado de machines/even_ones.dfa
  estados: ini par impar fin
  ini -> par :  ε
  par -> par :  0
  par -> impar :  1
  par -> fin :  ε
  impar -> par :  1
  impar -> impar :  0

Se elimina par
  estados: ini impar fin
  ini -> impar :  0*1
  ini -> fin :  0*
  impar -> impar :  0|10*1
  impar -> fin :  10*

Se elimina impar
  estados: ini fin
  ini -> fin :  0*|0*1(0|10*1)*10*

Expresión: 0*|0*1(0|10*1)*10*
Esta vez tenía dos que entran, e , y dos que salen, y : cuatro parejas, y las cuatro flechas nuevas están en la salida. El resultado es
que tiene 22 nodos, contra los 9 de . Las dos describen las cadenas con un número par de unos. La segunda las ve desde : o la cadena no tiene unos, o tiene ceros, un que lleva a , vueltas desde , y un final de regreso con sus ceros.
Con tres estados hay seis órdenes. El programa orders los prueba todos:
$ build/orders machines/multiple_of_3.dfa
r0 r1 r2  (65 nodos)
    0*|0*1(10*1)*10*|0*1(10*1)*0(1|0(10*1)*0)*0(10*1)*10*
r0 r2 r1  (27 nodos)
    0*|0*1(10*1|01*0)*10*
r1 r0 r2  (50 nodos)
    (0|11)*|(0|11)*10(1|00|01(0|11)*10)*01(0|11)*
r1 r2 r0  (21 nodos)
    (0|11|10(1|00)*01)*
r2 r0 r1  (27 nodos)
    0*|0*1(01*0|10*1)*10*
r2 r1 r0  (14 nodos)
    (0|1(01*0)*1)*
Seis expresiones distintas para el mismo lenguaje, de 14 a 65 nodos. La mejor es la del ejemplo, y la peor es la que sale con el orden del archivo. En las dos más cortas, el estado se elimina al final. No es casualidad: es el inicial y el de aceptación, así que es el más conectado del GNFA. Eliminarlo temprano crea muchas parejas, y sus expresiones se copian después en todas las flechas que se reparan.
Idea clave. El orden de eliminación cambia la expresión que sale y no el lenguaje. Una regla práctica: eliminar primero los estados con pocas flechas, pocos que entran y pocos que salen, y dejar para el final los más conectados.
Las expresiones crecen rápido
En cada eliminación, la expresión nueva de una pareja contiene hasta cuatro expresiones anteriores: , , y . Si todas tienen tamaño a lo sumo , la nueva tiene a lo sumo nodos: las cuatro, más una unión, dos concatenaciones y una estrella. El tamaño puede cuadruplicarse en cada paso, y después de eliminar estados puede ser del orden de .
El programa growth lo mide con una familia de autómatas: para cada , el DFA de estados de los
múltiplos de en binario, que se construye igual que el de los múltiplos de 3. Elimina los estados en dos
órdenes: con primero, y con al final.
$ build/growth
 k   estados   nodos (r0 primero)   nodos (r0 al final)
 2         2                   22                     9
 3         3                   65                    14
 4         4                  110                    27
 5         5                  314                    52
 6         6                  384                    67
 7         7                 1341                   209
 8         8                 1636                   267
Con 8 estados, el DFA cabe en una tabla de 16 casillas y la expresión tiene cientos de nodos, o más de mil con el orden malo. Un buen orden ayuda mucho y no cambia el fondo: se ha demostrado que para algunos autómatas toda expresión equivalente es exponencialmente más grande que el autómata. Pasar de la máquina a la descripción es caro, y no por culpa del método.
La eliminación tampoco promete la expresión más corta. Para el autómata de las cadenas que terminan en , de la semana 1, uno de los órdenes da esto (los puntos suspensivos marcan la parte de la salida que aquí se omite):
$ build/eliminate machines/ends_01.dfa q2 q0 q1
...
Expresión: 1*0(0|10|111*0)*1
Es correcta, y cualquiera habría escrito .
$ build/regex_diff '1*0(0|10|111*0)*1' '(0|1)*01' 10
R1 = 1*0(0|10|111*0)*1
R2 = (0|1)*01
2047 cadenas de longitud a lo sumo 10
solo en R1: 0
solo en R2: 0
sin diferencias hasta esa longitud
A cambio, el método resuelve lo que a mano cuesta. El lenguaje de las cadenas sin , que en la
sesión A pidió una idea y dos intentos, sale de su DFA de tres estados, el de machines/no_11.dfa, sin pensar
nada. Ese autómata tiene un estado trampa, , al que se llega cuando aparece :
$ build/eliminate machines/no_11.dfa q2 q1 q0
...
Se elimina q2
  estados: ini q0 q1 fin
  ini -> q0 :  ε
  q0 -> q0 :  0
  q0 -> q1 :  1
  q0 -> fin :  ε
  q1 -> q0 :  0
  q1 -> fin :  ε

Se elimina q1
  estados: ini q0 fin
  ini -> q0 :  ε
  q0 -> q0 :  0|10
  q0 -> fin :  ε|1

Se elimina q0
  estados: ini fin
  ini -> fin :  (0|10)*(ε|1)

Expresión: (0|10)*(ε|1)
Es exactamente la expresión de la sesión A. Y miren lo que pasó con la trampa: a entraba una flecha y no salía ninguna, así que no había ninguna pareja que reparar, y el estado desapareció sin dejar rastro. Un estado desde el que no se puede llegar a la aceptación no aporta nada a la expresión.
El teorema de Kleene
Teorema (Kleene). Un lenguaje es regular si y solo si alguna expresión regular lo describe.
Demostración. Las dos direcciones ya están hechas.
Si una expresión describe el lenguaje, la construcción de Thompson da un NFA que reconoce , y la construcción de subconjuntos de la semana pasada lo convierte en un DFA. Entonces el lenguaje es regular.
Si el lenguaje es regular, algún DFA lo reconoce, y la eliminación de estados da una expresión que lo describe. ∎
El teorema lleva el nombre de Stephen Kleene, que lo demostró en 1956, y que es también el Kleene de la estrella. Con él se cierra un triángulo: tres maneras de dar un lenguaje, y una conversión de cada una a la siguiente.
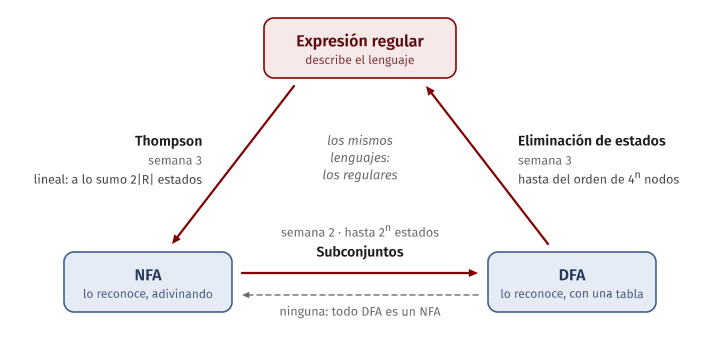
| Conversión | Construcción | Tamaño del resultado |
|---|---|---|
| Expresión NFA | Thompson, esta semana | Lineal: a lo sumo estados |
| NFA DFA | Subconjuntos, semana 2 | Hasta estados |
| DFA expresión | Eliminación de estados, esta semana | Hasta el orden de nodos |
| DFA NFA | Ninguna: todo DFA es un NFA | El mismo |
Dos de los tres lados pueden ser exponenciales. Los tres modelos tienen el mismo poder, y no la misma economía: un mismo lenguaje puede ser corto de describir y largo de reconocer con un DFA, o al revés.
Lo que el teorema permite, en la práctica:
- Elegir el modelo según el problema. Para demostrar que un lenguaje es regular basta dar un DFA, un NFA o una expresión, lo que salga más fácil. “Termina en ” es más fácil como expresión. “Múltiplo de 3” es más fácil como DFA.
- Usar las propiedades de cierre con expresiones. Las expresiones no tienen complemento ni intersección, pero los lenguajes que describen son cerrados bajo los dos. Para obtener la expresión del complemento de : de a un NFA, de ahí a un DFA, se intercambian los estados de aceptación, y se eliminan estados. La expresión existe siempre, aunque pueda ser enorme.
- Decidir preguntas sobre expresiones. ¿Describen dos expresiones el mismo lenguaje? Se convierten las dos en DFA y se comparan los autómatas, con la construcción del producto de la semana 1. Sobre las fórmulas, la pregunta no tiene por dónde tomarse. Sobre los autómatas es un recorrido de un grafo.
Idea clave. Regular es una sola clase de lenguajes con tres definiciones equivalentes: lo que reconoce un DFA, lo que reconoce un NFA y lo que describe una expresión regular. Que tres definiciones tan distintas coincidan es la señal de que la clase es natural, y no un accidente de cómo definimos la máquina.
Cómo busca un motor real
El teorema dice que una expresión se puede convertir en una máquina. Un programa como grep tiene que decidir
además cómo ejecutarla, y ahí hay dos familias de motores que se comportan de manera muy distinta.
Simular el NFA
La primera es la de este capítulo: construir el NFA de Thompson y seguirlo con el conjunto de estados activos,
como hace run_nfa.
algoritmo simular(N, w)
    activos ← clausura_ε({q0})
    para cada símbolo a de w, en orden
        siguientes ← ∅
        para cada estado q de activos
            agregar a siguientes los estados de δ(q, a)
        fin para
        activos ← clausura_ε(siguientes)
    fin para
    devolver si activos contiene un estado de F
fin algoritmo
¿Cuánto cuesta? Sea y sea el número de estados del NFA. El conjunto de activos nunca tiene más de estados. En cada vuelta del ciclo, cada estado activo se mira una vez, y la clausura es una búsqueda en un grafo, que visita cada estado y cada flecha a lo sumo una vez. En el NFA de Thompson salen a lo sumo dos flechas de cada estado, así que una vuelta cuesta . Son vueltas:
El costo es el producto de la longitud del texto por el tamaño de la expresión, siempre: no depende de qué expresión sea ni de qué cadena. La memoria es , y no crece con la cadena.
Probar los caminos uno por uno
La segunda familia hace lo que haría una persona con paciencia: backtracking. Recorre la expresión y, cada vez que hay una elección (cuál de las dos ramas de una unión, dar otra vuelta en una estrella o salir), prueba una. Si más adelante la búsqueda fracasa, vuelve a la última elección y prueba la otra.
Es fácil de programar: la función match de backtrack.h son unas veinticinco líneas, con un caso por cada
tipo de nodo. Y casi siempre es rápida, porque casi siempre la primera elección es la buena.
$ build/backtrack '(a|a)*b' aaab aaa
aaab: acepta, 15 llamadas
aaa: rechaza, 76 llamadas
La expresión es rara a propósito: las dos ramas de la unión son iguales. Describe las cadenas . Con , la búsqueda acierta a la primera. Con tiene que rechazar, y para rechazar debe convencerse de que ninguna combinación de elecciones funciona. Cada se puede leer con la rama izquierda o con la derecha. Para tres letras hay combinaciones, y todas fracasan al final por lo mismo: falta la . La búsqueda las recorre todas.
Se puede contar con exactitud. Sea el número de llamadas que hace match para la estrella cuando
quedan letras . La estrella llama a la unión, que llama a sus dos ramas, y cada rama lee una
y vuelve a llamar a la estrella con letras. Cuando las dos fracasan, sale de la estrella y
prueba la . Son 5 llamadas propias y dos llamadas recursivas:
Con la llamada inicial, la de la concatenación, el total es . Para da 76, lo que imprimió el programa. Cada letra más duplica el trabajo.
make bench compila las dos búsquedas con -O2, sin sanitizers, y las corre con cadenas cada
vez más largas. Esta es una ejecución en el contenedor del curso, en una laptop:
$ make bench
build/matchers_bench
expresión: (a|a)*b    cadena: a^n    NFA de Thompson: 10 estados

      n   backtracking: llamadas   backtracking: tiempo   NFA: tiempo
      5                      316               0.0000 s      0.0000 s
     10                    10236               0.0000 s      0.0000 s
     15                   327676               0.0013 s      0.0000 s
     20                 10485756               0.0434 s      0.0000 s
     25                335544316               1.3842 s      0.0000 s
   1000                        -                      -      0.0009 s
 100000                        -                      -      0.0871 s
Los tiempos cambian de una máquina a otra y de una ejecución a la siguiente. Las llamadas no: son las de la
fórmula. Con , el backtracking ya tarda más de un segundo. Con serían veces
más, más de veinte minutos, y con no terminaría nunca. La simulación del NFA lee una cadena de
100 000 letras en menos de una décima de segundo, y eso con la versión de nfa.h, que guarda los estados como cadenas
en un std::set y no está hecha para correr rápido.
¿Por qué una es exponencial y la otra no, si las dos exploran el mismo autómata? Porque el backtracking recorre caminos, y la simulación recorre estados. Después de leer letras hay caminos distintos, y todos están en el mismo lugar de la expresión. El backtracking no lo sabe y los visita uno por uno. La simulación guarda un conjunto: los caminos que llegan al mismo estado ocupan un solo lugar en él. Es la misma observación de la semana 1, que sostiene todo lo regular: lo único que importa de lo leído es el estado al que se llegó.
Idea clave. Simular el NFA con el conjunto de estados activos cuesta para toda expresión y toda cadena. El backtracking es correcto, y con algunas expresiones tarda un tiempo exponencial en , porque recorre uno por uno caminos que terminan en el mismo estado.
En la práctica. Las dos familias existen.
grep, y las bibliotecas de expresiones regulares de Go y de Rust, trabajan con autómatas y garantizan un tiempo lineal en el texto. Las de Perl, Python, Java y JavaScript usan backtracking. En el contenedor del curso,re.fullmatch('(a|a)*b', 'a' * n)de Python 3.14 tardó 0,05 segundos con y 1,47 segundos con .grep -xE '(a|a)*b'respondió en 0,001 segundos con una línea de 100 000 letras. Cuando el patrón o el texto vienen de un usuario, un patrón así se convierte en un ataque: basta enviar una cadena de unas decenas de caracteres para ocupar un procesador durante horas.
Un motor basado en autómatas suele ir un paso más allá: guarda cada conjunto de estados activos la primera vez que lo calcula, y también a qué conjunto lleva con cada símbolo. Eso es la construcción de subconjuntos de la semana pasada, hecha sobre la marcha: solo se construyen los estados del DFA que el texto realmente visita.
Lo que no es regular: las referencias hacia atrás
Si simular el NFA es mejor, ¿por qué tantos lenguajes usan backtracking? Una razón es histórica. La otra es
que sus patrones tienen operadores que la simulación no puede manejar. El principal es la referencia hacia
atrás: \1 significa “aquí va otra vez el mismo texto que coincidió con el primer paréntesis”.
((a|b)*)\1El primer paréntesis es entero. Con grep -xE, este patrón coincide con
y con , y no con : describe las cadenas de la forma , una
cadena cualquiera seguida de una copia exacta de sí misma. No es una
abreviatura, porque no se puede reescribir con unión, concatenación y estrella: el lenguaje
no es regular. Para reconocerlo hay que recordar la
primera mitad entera, y un autómata finito no puede recordar una cadena de longitud arbitraria. Por ahora es
solo un enunciado. La demostración llega la semana próxima, con las herramientas para probar que un lenguaje
no es regular.
Así que el nombre engaña: las regex con referencias hacia atrás describen más que los lenguajes regulares, y pagan por ello. Ningún autómata finito las ejecuta, y de ahí el backtracking.
El código de la semana
code/week-03/
├── regex.h               el árbol de una expresión, el parser y la escritura con los paréntesis justos
├── nfa.h                 struct Nfa, lectura del formato .nfa, clausura ε y estados activos
├── thompson.h            construcción de Thompson: de expresión a NFA
├── dfa.h                 struct Dfa, el de la semana 1
├── gnfa.h                autómata generalizado y eliminación de estados: de DFA a expresión
├── backtrack.h           el buscador con backtracking, que cuenta sus llamadas
├── words.h               todas las cadenas hasta una longitud
├── regex_tree.cpp        muestra el árbol de una expresión
├── regex_lang.cpp        lista las cadenas más cortas del lenguaje de una expresión
├── regex_diff.cpp        compara dos expresiones con todas las cadenas cortas
├── thompson.cpp          escribe el NFA de una expresión en formato .nfa
├── run_nfa.cpp           sigue un NFA con una cadena, mostrando los estados activos
├── eliminate.cpp         elimina los estados de un DFA en el orden que se le pida
├── orders.cpp            prueba todos los órdenes de eliminación
├── growth.cpp            mide cuánto crece la expresión con el número de estados
├── backtrack.cpp         busca con backtracking y cuenta las llamadas
├── matchers_bench.cpp    backtracking frente a simulación del NFA (make bench)
├── machines/             los autómatas del capítulo, en formato .dfa y .nfa
├── errors/               expresiones mal formadas
├── test_regex.cpp        el parser: precedencia, ε y ∅, errores
├── test_thompson.cpp     cada expresión contra un predicado; la forma del NFA; las identidades
├── test_elimination.cpp  DFA → expresión → NFA, con todos los órdenes de eliminación
├── test_backtrack.cpp    el backtracking contra el NFA, y la fórmula de las llamadas
└── lab/mini_grep/        el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Tardan unos segundos: la simulación de
nfa.h trabaja con nombres de estados, y bajo los sanitizers es lenta.
$ make test
test_regex: ok (9 expresiones mal formadas rechazadas)
test_thompson: ok (15 expresiones contra su predicado)
test_elimination: ok (4 autómatas, 20 órdenes de eliminación, 511 cadenas cada uno)
test_backtrack: ok (14 expresiones, 511 cadenas cada una)
Todas las pruebas pasaron.
Las pruebas comprueban con assert lo que este capítulo afirma.
test_regexrevisa la precedencia con la forma del árbol, que%y@se lean como y , que lo que el programa escribe se pueda volver a leer, y que cada expresión deerrors/malformed.txtse rechace.test_thompsonconvierte en NFA cada expresión de la sesión A y la compara con una función de C++ que decide el mismo lenguaje mirando la cadena completa, sobre las 1023 cadenas binarias de longitud a lo sumo 9. Comprueba además la forma del autómata (un estado de aceptación, a lo sumo dos flechas por estado, exactamente estados), las identidades de la tabla y la ejecución de copiada arriba.test_eliminationes la prueba del teorema de Kleene con ejemplos. Para cada DFA demachines/y cada orden de eliminación, toma la expresión que sale, la escribe, la vuelve a leer, la convierte en un NFA con Thompson y compara ese NFA con el DFA original sobre las 511 cadenas de longitud a lo sumo 8. También comprueba las expresiones intermedias de los ejemplos y los tamaños de la tabla degrowthhasta .test_backtrackcomprueba que el backtracking responde lo mismo que el NFA, que termina con estrellas anidadas como , y que con hace exactamente llamadas para de 0 a 14.
Los archivos de machines/ son:
| Archivo | Lenguaje | Estados |
|---|---|---|
even_ones.dfa |
Cantidad par de unos, de la semana 1 | 2 |
multiple_of_3.dfa |
Múltiplos de 3 en binario, de la semana 1 | 3 |
ends_01.dfa |
Termina en , de la semana 1 | 3 |
no_11.dfa |
No contiene , con estado trampa | 3 |
ends_in_1.nfa |
El NFA de Thompson de | 10 |
ab_or_a_star.nfa |
El NFA de Thompson de | 10 |
Para experimentar: escriban un DFA propio en machines/, pásenlo por orders, tomen la expresión más corta
y compárenla con regex_diff contra la que ustedes habrían escrito. O al revés: escriban una expresión,
conviértanla con thompson, guarden la salida en un archivo .nfa y síganla con run_nfa.
Dos decisiones del código que conviene conocer.
- En
nfa.h, es unstd::mapde (estado, símbolo) a unstd::setde nombres, y una transición se guarda con el carácter'\0'en el lugar del símbolo. Se eligió así para que el código se lea como la definición, , y no por velocidad. Para el laboratorio hace falta otra representación. gnfa.haplica al construir cada expresión las identidades de y de , y ninguna otra. No reconoce, por ejemplo, que . Por eso las expresiones que imprime son correctas y no siempre las más cortas.
El laboratorio
En lab/mini_grep está el enunciado, un esqueleto y los casos. El problema es un grep pequeño: la entrada
es una expresión regular con |, concatenación, * y paréntesis, seguida de una lista de líneas, y la salida
dice por cada línea si la expresión la describe completa.
cd lab/mini_grep
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Son los tres pasos de la sesión A, uno detrás de otro: el árbol de la expresión, respetando la precedencia; el NFA de Thompson; y la simulación con el conjunto de estados activos. Entre los casos están la expresión contra líneas largas de letras , y estrellas anidadas, que forman ciclos de transiciones . Una solución con backtracking pasa los casos pequeños y se queda sin tiempo en esos.
Como en la semana 1, solution.cpp se escribe sin incluir los encabezados de esta carpeta: el juez compila
ese único archivo. Pueden leer regex.h y thompson.h cuanto quieran, pero no les conviene copiarlos tal
cual, porque con nombres de estados en un std::set la simulación es demasiado lenta. Numeren los estados y
usen arreglos.
Resumen
- Una expresión regular se define por casos: un símbolo, , , y la unión, la concatenación y la estrella de expresiones más pequeñas. es el lenguaje que describe.
- Precedencia: estrella, concatenación, unión. es . Una expresión es un árbol, y su tamaño es el número de nodos.
- En la teoría la unión se escribe , y en el código y en las herramientas,
|. - Para escribir una expresión se piensa en cómo se parte una cadena en trozos. Se prueba con cadenas de los dos lados: una expresión puede describir de menos o de más.
- Identidades: , , y . Son falsas y .
- La construcción de Thompson convierte una expresión en un NFA: una pieza por nodo del árbol, con una entrada y una salida, unidas con transiciones . Se demuestra por inducción sobre la estructura de la expresión. El NFA tiene a lo sumo estados, y de cada uno salen a lo sumo dos flechas.
- Las abreviaturas de las herramientas (
+,?,[a-z],{n,m}) se reescriben con las tres operaciones y no agregan poder.grepbusca el patrón dentro de la línea: . - Un GNFA lleva expresiones en las flechas, tiene un estado inicial sin flechas que entren y un único estado de aceptación sin flechas que salgan. Un DFA se normaliza con dos estados nuevos y transiciones .
- Eliminar el estado : cada pareja pasa a llevar . No hay que olvidar el ciclo ni ninguna pareja. Cuando quedan dos estados, la expresión de la única flecha es la respuesta.
- El orden de eliminación cambia la expresión y no el lenguaje. Conviene dejar para el final los estados más conectados. La expresión puede crecer del orden de .
- Teorema de Kleene: un lenguaje es regular si y solo si alguna expresión regular lo describe. DFA, NFA y expresiones regulares tienen el mismo poder, con tamaños que pueden diferir exponencialmente.
- Simular el NFA con el conjunto de estados activos cuesta siempre. El backtracking puede tardar un tiempo exponencial: con contra hace llamadas.
- Las referencias hacia atrás de las herramientas describen lenguajes que no son regulares, como . Se demuestra en la semana 4.
Ejercicios
- Para cada expresión, digan en palabras qué lenguaje describe, y den dos cadenas que estén y dos que no:
(a) ; (b) ;
(c) ; (d) . Comprueben con
build/regex_lang. - Dibujen el árbol de , de
y de , y escriban cada una con todos sus paréntesis. Den una cadena que
esté en el lenguaje de la primera y no en el de la segunda, y una que esté en el de la tercera y en ninguna
de las otras dos. Comprueben con
build/regex_tree. - Escriban una expresión regular para cada lenguaje sobre : (a) las cadenas con un
número de ceros múltiplo de 3; (b) las que tienen al menos dos unos; (c) las que empiezan y terminan con el
mismo símbolo; (d) las que no contienen ; (e) las de longitud impar. Para cada una, prueben con
build/regex_langy busquen a mano una cadena que deba estar y otra que no. - Digan cuáles de estas igualdades valen para todas las expresiones y . Demuestren las que valen y den un contraejemplo de las que no: (a) ; (b) ; (c) ; (d) ; (e) ; (f) .
- Un estudiante propone para las cadenas con un número par de ceros. ¿Describe
de más o de menos? Den la cadena más corta en la que falla, y comprueben con
build/regex_diff '(00|1)*' '(1|01*0)*'. Después demuestren por doble inclusión que describe exactamente ese lenguaje. - Conviertan en un NFA con la construcción de Thompson, a mano: dibujen las
piezas en el orden en que se arman y numeren los estados como lo hace el programa. Comparen con
machines/ab_or_a_star.nfa. Después sigan y anotando los estados activos, y comprueben conbuild/run_nfa. - ¿Cuántos estados tiene el NFA de Thompson de ? Calcúlenlo con la fórmula antes de construirlo. Den una expresión de tamaño cuyo NFA de Thompson tenga exactamente estados, y otra cuyo NFA tenga .
- Eliminen los estados del DFA de
machines/even_ones.dfaen los dos órdenes posibles, a mano, escribiendo en cada paso quién entra, quién sale y cuál es el ciclo. Comprueben conbuild/eliminate. Después expliquen con palabras por qué las dos expresiones describen el mismo lenguaje. - Diseñen un DFA para las cadenas sobre con un número par de letras
y un número impar de letras . Escríbanlo en formato
.dfa, obtengan una expresión regular conbuild/ordersy quédense con la más corta. ¿Qué estado se elimina al final en ella? ¿Habrían podido escribir esa expresión directamente? - Demuestren que la clase de los lenguajes regulares es cerrada bajo reverso usando solo expresiones regulares: definan por casos, sobre la estructura de , una expresión , y demuestren por inducción sobre la estructura que . ¿En qué caso se usa que ? Comparen con la construcción sobre NFA de la semana pasada.
- En la demostración de la eliminación de estados, ¿dónde se usa que no es ni ? Den un GNFA de tres estados en el que, si se olvida el ciclo de al eliminarlo, el autómata resultante acepta menos cadenas, y digan una cadena que se pierde. ¿Puede el olvido hacer que acepte más?
- Para programar. Agreguen al parser de
regex.hlos operadores+y?de las herramientas, como abreviaturas:R+se convierte en el árbol de yR?en el de . No agreguen casos nuevos aKind. Escriban pruebas que comparen(01)+con01(01)*y0?1con(0|%)1, y muevan0+1deerrors/malformed.txta las expresiones válidas. ¿Cuántos estados tiene el NFA de Thompson deR+si el deRtiene ? - Para programar. Con
backtrack.h, midan las llamadas para contra , con de 1 a 20. ¿Cómo crecen? Encuentren la recurrencia. Después modifiquen el buscador para que recuerde las parejas (nodo, posición) desde las que ya fracasó y no las vuelva a probar. ¿Cuántas parejas distintas hay? ¿Qué cota da eso para el número de llamadas? Comparen esa cota con la de la simulación del NFA.