
Apuntes · Capítulo 4Lenguajes regulares
Lo que un autómata finito no puede hacer
Lo que un autómata finito no puede hacer
Tres semanas seguidas agrandaron la clase de los lenguajes regulares sin cambiarla. En la semana 1 la definimos con los DFA. En la semana 2 le dimos a la máquina la capacidad de adivinar, y la construcción de subconjuntos mostró que un NFA no reconoce nada que un DFA no reconozca. En la semana 3 cambiamos las máquinas por descripciones, y el teorema de Kleene mostró que las expresiones regulares describen exactamente los mismos lenguajes. Unión, intersección, complemento, concatenación, estrella y reverso tampoco sacan de la clase.
Una clase tan estable podría hacer pensar que todo lenguaje razonable es regular. No es así, y esta semana lo demostramos. Es el primer resultado de imposibilidad del curso, y conviene mirar bien su forma, porque se repite en cada parte: no decimos “nadie ha encontrado un DFA para este lenguaje”, sino “ningún DFA lo reconoce, tenga los estados que tenga”. Para afirmar algo sobre todos los autómatas a la vez no sirve probar con algunos. Hace falta un argumento que use lo único que todos tienen en común: una cantidad finita de estados.
Hay dos herramientas. La sesión A presenta el lema de bombeo, la clásica: toda cadena larga de un lenguaje regular tiene un tramo que se puede repetir. La sesión B presenta las cadenas distinguibles, que suelen dar demostraciones más cortas y además cuentan estados: con ellas pagamos una deuda de la semana 2, que el DFA de “el -ésimo símbolo desde el final es ” necesita estados. De esa misma idea salen el teorema de Myhill-Nerode, que dice exactamente cuántos estados necesita un lenguaje, y un algoritmo para minimizar cualquier DFA. Con esto se cierra la parte 1.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Contar sin tope y Un estado que se repite. Antes de la sesión B, Cadenas distinguibles hasta el primer teorema. Con eso llegan con la idea de las dos herramientas.
En clase: Sesión A, de Contar sin tope a Lo que el lema no dice. Sesión B, de Cadenas distinguibles a El DFA mínimo es único.
Después de clase: el Resumen y los Ejercicios. El código de la semana, si van a hacer el ejercicio opcional de minimización. Opcional: Streaming: una cota inferior de memoria, que no entra en las evaluaciones, y las lecturas de apoyo del recuadro siguiente.
Lectura. Sesión A: Sipser, sec. 1.4 (Nonregular Languages). Sesión B: Sipser deja Myhill-Nerode y la minimización como problemas del capítulo 1, sin desarrollarlos; Erickson, Models of Computation, nota 3, sección sobre conjuntos distinguidores (fooling sets). Para la sesión B, estos apuntes son el texto principal.
Código. Los programas de este capítulo están en
code/week-04. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El ejercicio opcional de laboratorio está enlab/minimize_dfa.
Contar sin tope
El lenguaje de esta semana ya apareció en la semana 1:
Algunos ceros, y después exactamente la misma cantidad de unos. Para decidir si una cadena está en leyendo de izquierda a derecha hay que recordar cuántos ceros hubo, y esa cantidad no tiene tope.
Intentemos construir un DFA de todos modos. Con el método de la semana 1, cada estado es un hecho sobre lo
leído: “van 0 ceros”, “van 1”, “van 2”, “van 3”. Después, por cada cantidad, estados que descuentan los unos. En
algún momento hay que parar de agregar estados, y lo natural es cerrar con uno que diga “van 3 o más”. Ese
intento está en machines/count_attempt.dfa:
$ build/show_dfa machines/count_attempt.dfa
Q  = {z0, z1, z2, z3, u2, u1, u0, x}
Σ  = {0, 1}
q0 = z0
F  = {z0, u0}

     δ   0   1
-> * z0  z1  x
     z1  z2  u0
     z2  z3  u1
     z3  z3  u2
     u2  x   u1
     u1  x   u0
   * u0  x   x
     x   x   x

estados alcanzables desde z0: 8 de 8
Los estados z0 a z3 cuentan ceros, u2, u1 y u0 cuentan los unos que faltan, y x es el estado trampa.
Con las cadenas cortas acierta:
$ build/run_dfa machines/count_attempt.dfa 000111 0010
w = 000111
  z0 -0-> z1 -0-> z2 -0-> z3 -1-> u2 -1-> u1 -1-> u0
  termina en u0, que está en F: acepta
w = 0010
  z0 -0-> z1 -0-> z2 -1-> u1 -0-> x
  termina en x, que no está en F: rechaza
Y con las largas se equivoca en los dos sentidos:
$ build/run_dfa machines/count_attempt.dfa 00000111 00001111
w = 00000111
  z0 -0-> z1 -0-> z2 -0-> z3 -0-> z3 -0-> z3 -1-> u2 -1-> u1 -1-> u0
  termina en u0, que está en F: acepta
w = 00001111
  z0 -0-> z1 -0-> z2 -0-> z3 -0-> z3 -1-> u2 -1-> u1 -1-> u0 -1-> x
  termina en x, que no está en F: rechaza
Acepta , que no está en , y rechaza , que sí está. La causa
está a la vista en la primera ejecución: después del tercer cero la máquina se queda dando vueltas en z3, y
desde ahí ya no sabe si leyó tres ceros, cinco o cien.
Se puede arreglar ese autómata agregando estados: contar hasta 4, hasta 10, hasta 1000. Cada arreglo acierta con más cadenas y deja el mismo problema un poco más lejos. Pero de ahí no se concluye nada. Que este diseño falle, o que a nadie se le ocurra uno mejor, no demuestra que no exista: podría haber un autómata que no cuente los ceros y reconozca con algún truco que no vemos. En la semana 1 ya pasó algo así, cuando para los múltiplos de 3 no hizo falta recordar el número, sino solo su resto.
Error común. Dar como demostración “un DFA no puede contar” o “no se me ocurre ningún DFA”. La primera frase es la conclusión, no el argumento, y además es falsa tal como está: un DFA cuenta sin problemas hasta cualquier tope fijo, o módulo cualquier número. La segunda habla de quien busca, no del lenguaje. Una demostración de que no es regular tiene que empezar por “sea un DFA cualquiera” y terminar con una cadena concreta en la que se equivoca.
Un estado que se repite
Lo que le pasó al intento anterior le pasa a todo DFA, y es lo único que hay que entender esta semana.
Un DFA con estados que lee una cadena de símbolos o más pasa por estados o más, contando el inicial. No hay tantos estados distintos: alguno se repite. Entre la primera visita a ese estado y la segunda, la máquina leyó un tramo de la cadena y volvió al mismo lugar. Dio una vuelta por un ciclo.
Ahora, el estado es todo lo que la máquina recuerda. Si está otra vez en el mismo estado, no sabe si dio la vuelta o no, y lo que haga después será igual en los dos casos. Entonces podemos quitar ese tramo de la cadena, o repetirlo dos, tres o cien veces, y la máquina terminará en el mismo estado final que con la cadena original.
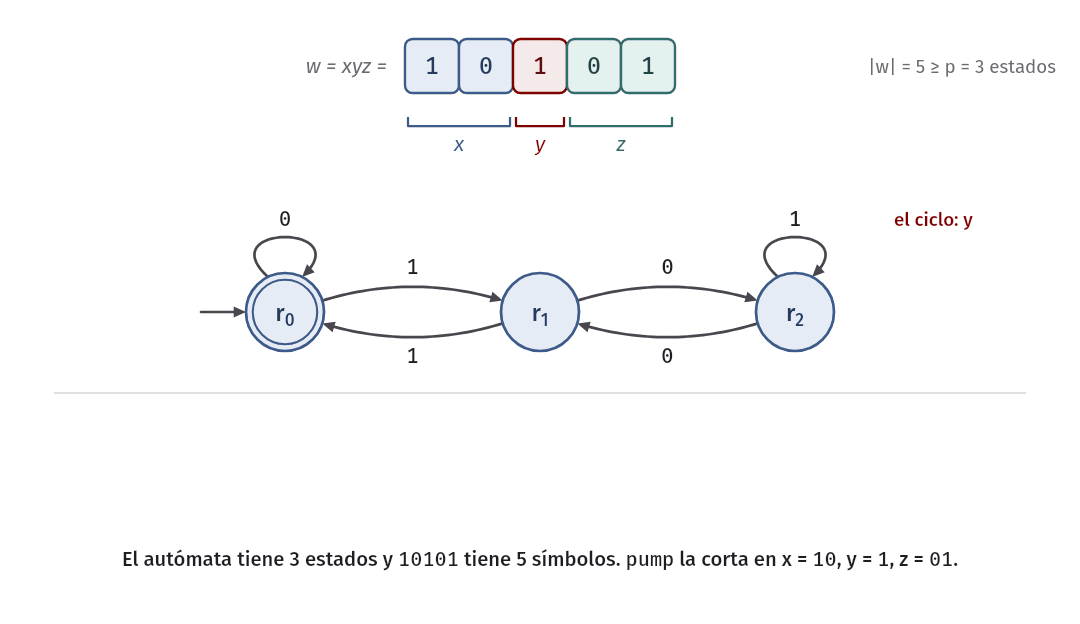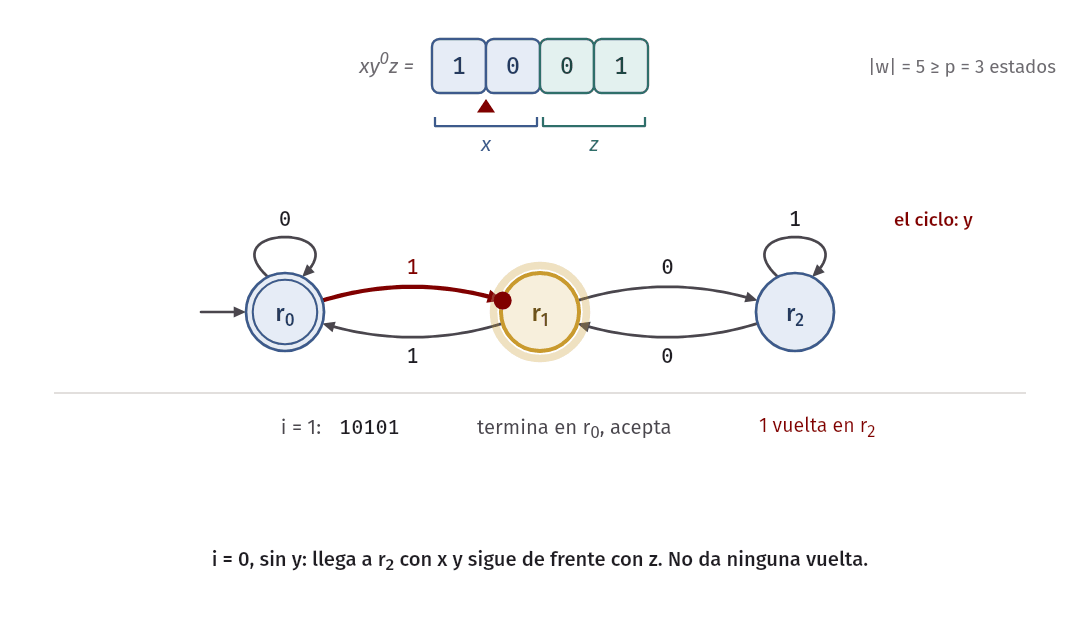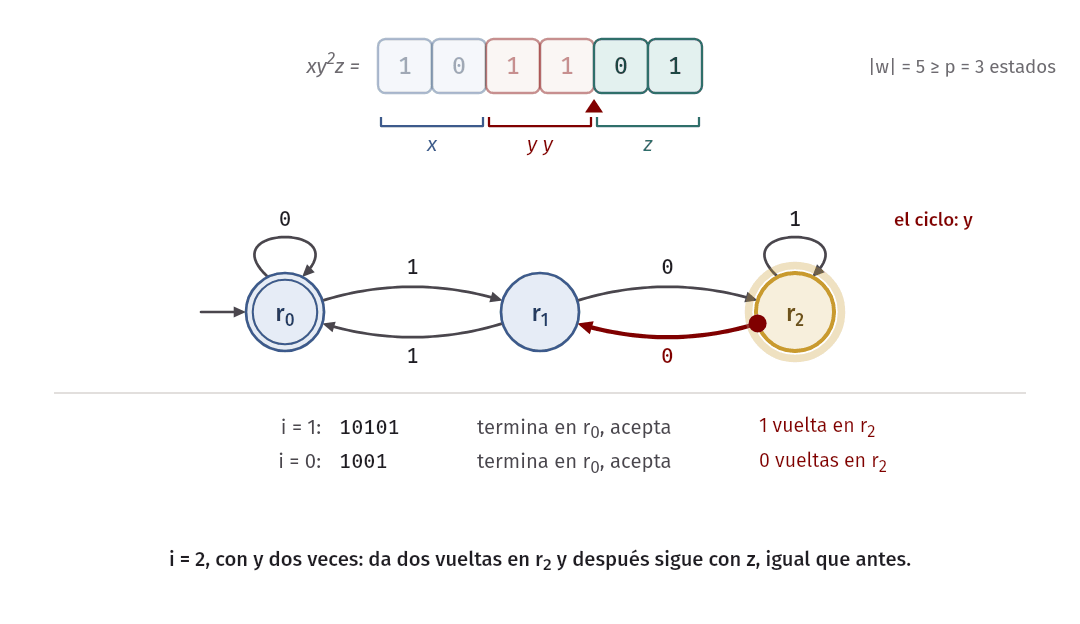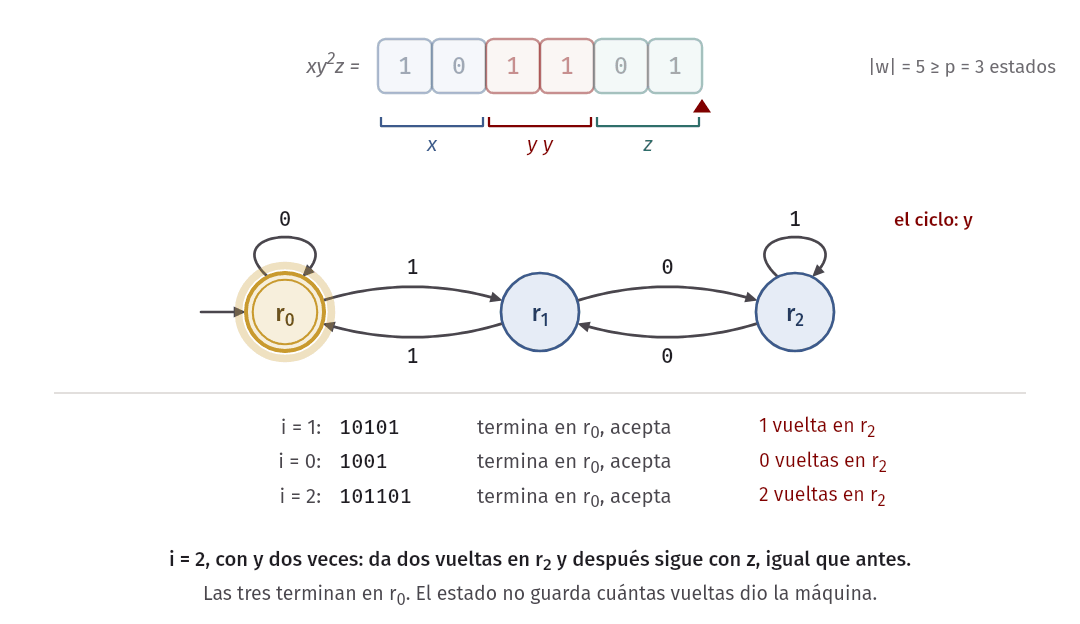
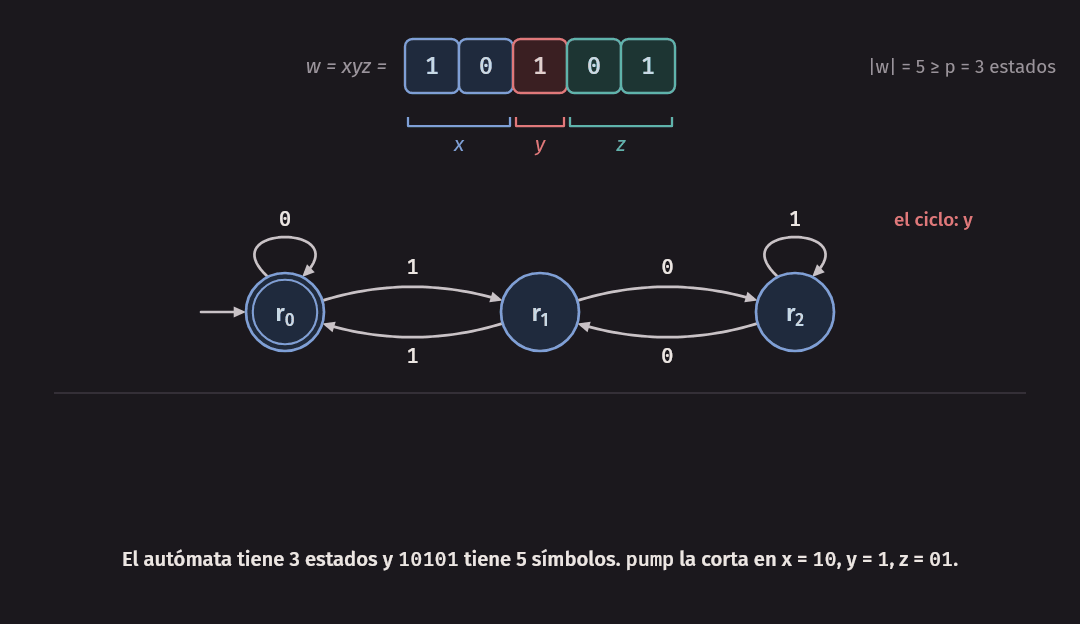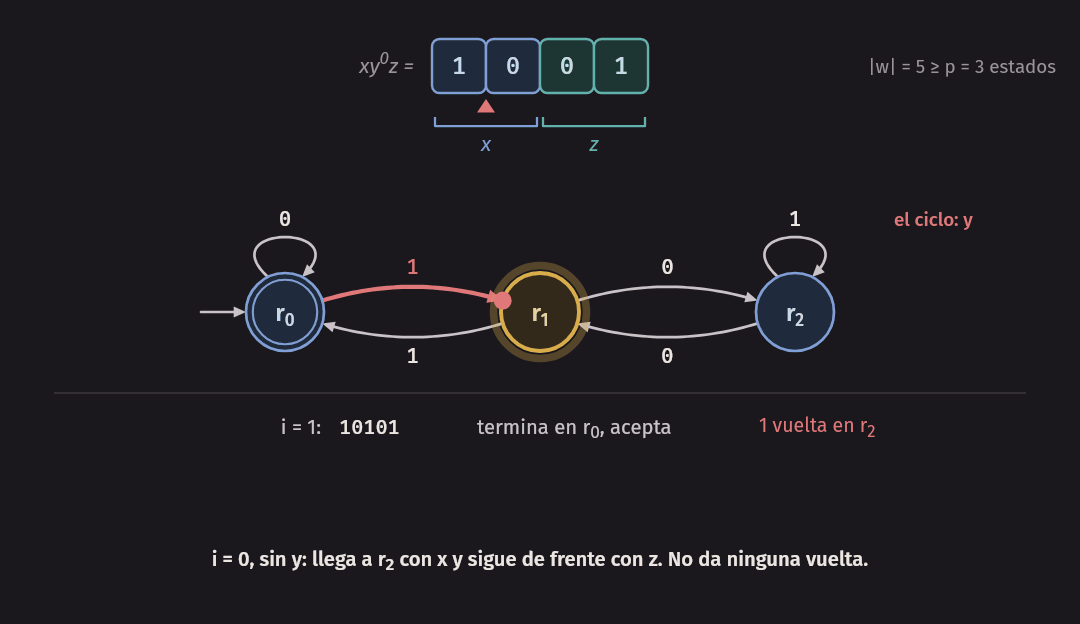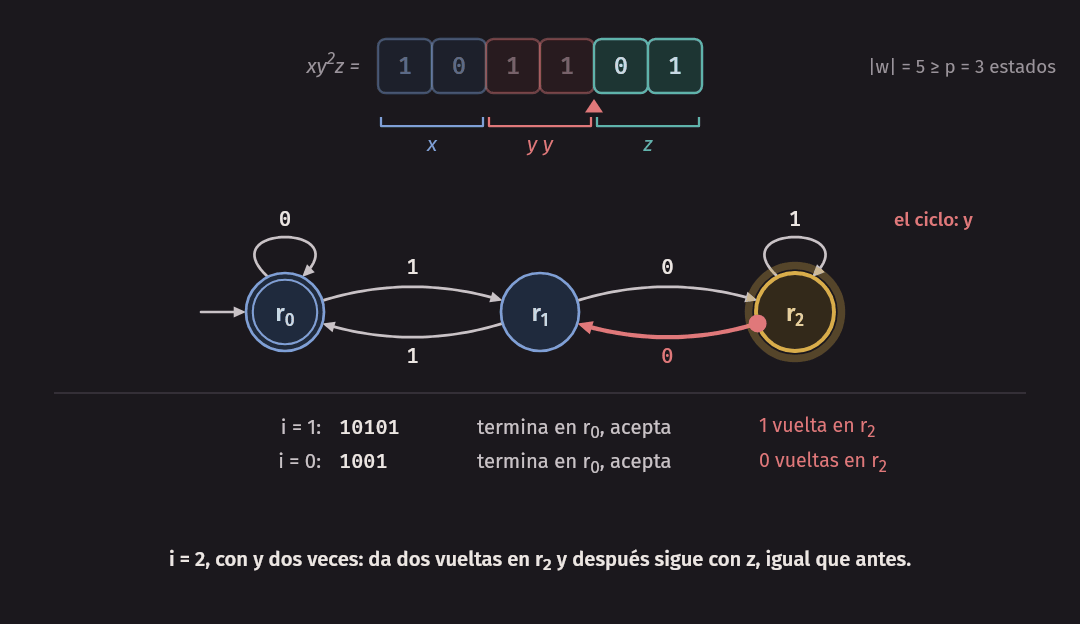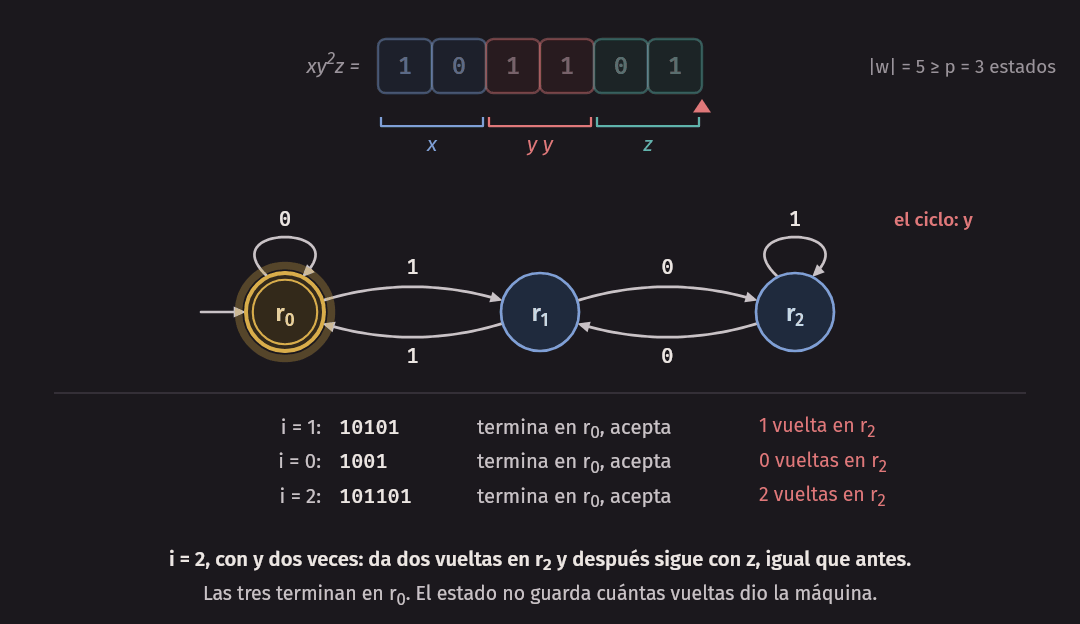
El programa pump hace exactamente eso con un DFA de verdad. Recibe un autómata y una cadena con al menos
tantos símbolos como estados, busca el primer estado que se repite y parte la cadena en tres: , lo leído
antes de la primera visita; , lo leído entre las dos visitas; , el resto. Con el autómata de los múltiplos
de 3 de la semana 1, que tiene 3 estados, y la cadena :
$ build/pump machines/multiple_of_3.dfa 10101
p = |Q| = 3, w = 10101, |w| = 5
  r0 -1-> r1 -0-> r2 -1-> r2 -0-> r1 -1-> r0
primer estado que se repite: r2, después de leer 2 y 3 símbolos
x = 10, y = 1, z = 01    |y| = 1 > 0, |xy| = 3 ≤ 3
  i = 0: 1001 termina en r0, acepta
  i = 1: 10101 termina en r0, acepta
  i = 2: 101101 termina en r0, acepta
  i = 3: 1011101 termina en r0, acepta
  i = 4: 10111101 termina en r0, acepta
todas terminan igual que w
La ejecución pasa por r2 después de leer , y otra vez después de leer : el tercer
símbolo, un , la dejó donde estaba. Ese símbolo es . Las cinco cadenas de la lista son
para de 0 a 4, y las cinco terminan en r0. En efecto, son 9, 21, 45, 93 y 189 en binario, todos
múltiplos de 3. El autómata no puede distinguirlas: en todas hace el mismo recorrido, salvo el número de vueltas
en r2.
Para un lenguaje regular eso no es un defecto. Los múltiplos de 3 sí tienen esa propiedad. El problema aparece cuando el lenguaje no la tiene, y el intento de la sección anterior lo muestra:
$ build/pump machines/count_attempt.dfa 00000000111
p = |Q| = 8, w = 00000000111, |w| = 11
  z0 -0-> z1 -0-> z2 -0-> z3 -0-> z3 -0-> z3 -0-> z3 -0-> z3 -0-> z3 -1-> u2 -1-> u1 -1-> u0
primer estado que se repite: z3, después de leer 3 y 4 símbolos
x = 000, y = 0, z = 0000111    |y| = 1 > 0, |xy| = 4 ≤ 8
  i = 0: 0000000111 termina en u0, acepta
  i = 1: 00000000111 termina en u0, acepta
  i = 2: 000000000111 termina en u0, acepta
  i = 3: 0000000000111 termina en u0, acepta
  i = 4: 00000000000111 termina en u0, acepta
todas terminan igual que w
El ciclo es la vuelta en z3, y es un cero. Repetirlo o quitarlo cambia la cantidad de ceros sin cambiar la
de unos, y el autómata acepta todas esas cadenas, aunque ninguna tiene tantos ceros como unos. Eso no es un
accidente de este diseño. Cualquier DFA, con una cadena de suficientemente larga, tiene que repetir un
estado mientras todavía está leyendo ceros, y entonces acepta cadenas que no están en .
Idea clave. En un DFA con estados, toda ejecución de pasos o más repite un estado. El tramo de la cadena leído entre las dos visitas se puede quitar o repetir sin que cambie el estado final.
El lema de bombeo
El lema dice lo anterior sin mencionar ningún autómata: es una propiedad que tienen todos los lenguajes regulares. “Bombear” una cadena es repetir un tramo suyo.
Lema de bombeo (pumping lemma). Si es un lenguaje regular, existe un número , la longitud de bombeo (pumping length) de , tal que toda cadena con se puede dividir en tres partes, , que cumplen:
- para todo ;
- ;
- .
Cada condición tiene su papel.
- La primera es el bombeo: se puede repetir cualquier número de veces. Con sale . Con sale , la cadena sin : también tiene que estar en . Con sale .
- La segunda dice que no es vacía. Sin ella el lema no diría nada: con , todas las cadenas son la misma .
- La tercera dice dónde está el tramo que se repite: dentro de los primeros símbolos de . Es la que hace cómodo usar el lema, porque limita lo que puede contener.
Nada impide que o sean vacías.
El lema solo habla de las cadenas de longitud al menos . Sobre las más cortas no dice nada. Por eso un lenguaje finito lo cumple sin esfuerzo: si su cadena más larga mide , basta tomar , y no hay ninguna cadena de a la que se le exija algo.
Demostración. Por construcción de la división, con el principio del palomar. Como es regular, hay un DFA con . Tomamos , el número de estados.
Sea una cadena de con , y sea la ejecución de con : y . Como acepta , .
Un estado se repite pronto. Miremos solo los primeros estados de la ejecución: . Existen, porque . Son estados y tiene solo distintos, así que por el principio del palomar dos de ellos son el mismo: hay índices y con y .
La división. Partimos en los dos lugares donde aparece ese estado:
Por la definición de la ejecución, lleva de a , lleva de a , y lleva de a . Como , llamemos a ese estado:
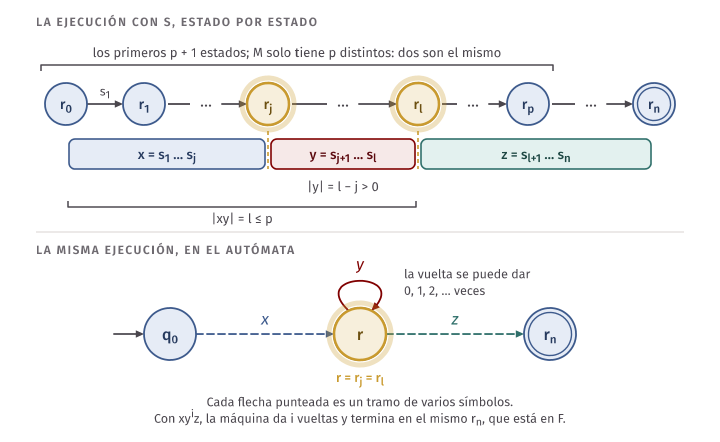
Condición 2. , porque .
Condición 3. .
Condición 1. Primero, para todo , por inducción sobre . Para , y . Si vale para , entonces por el lema de la concatenación de la semana 1,
Con eso, y otra vez con el lema de la concatenación:
Luego acepta , es decir, , para todo . ∎
La demostración es el programa pump de la sección anterior, línea por línea: tomar , mirar los
primeros estados de la ejecución y cortar en la primera repetición. Las pruebas de la semana lo
comprueban con siete autómatas y todas las cadenas de longitud entre y 11: en cada una, la división que
encuentra pump cumple las tres condiciones.
Dos observaciones sobre lo que la demostración da y lo que no.
- no es único. Si sirve, cualquier número mayor también sirve: hay menos cadenas a las que exigirles algo, y es más fácil de cumplir. La demostración da para un DFA cualquiera de . No hace falta conocerlo, y de hecho al usar el lema nunca lo conocemos.
- La división la decide el autómata. Depende de qué estado se repite, y eso depende de un DFA que no tenemos. El lema solo promete que alguna división funciona.
El lema como un juego
Para demostrar que un lenguaje no es regular, el lema se usa al revés. Si un lenguaje regular tiene siempre la propiedad de bombeo, un lenguaje que no la tiene no puede ser regular. Hay que escribir con cuidado qué significa “no tenerla”, porque el enunciado tiene cuatro cuantificadores encadenados:
Al negar la propiedad, cada “existe” se vuelve “para todo” y al revés. no tiene la propiedad de bombeo si:
Y si no tiene la propiedad, no es regular: es el lema, leído por la contrarrecíproca.
Esa alternancia de “para todo” y “existe” se recuerda mejor como un juego entre dos jugadores. Nosotros queremos demostrar que no es regular. El adversario sostiene que sí lo es. Lo que en la fórmula es “para todo” lo elige él, y lo que es “existe” lo elegimos nosotros.
| Jugada | Quién | Qué elige |
|---|---|---|
| 1 | El adversario | Un número . Dice que es la longitud de bombeo de |
| 2 | Nosotros | Una cadena con . Puede y debe depender de |
| 3 | El adversario | Una división con y |
| 4 | Nosotros | Un exponente . Ganamos si |
Demostrar que no es regular es dar una estrategia ganadora: una manera de jugar que gana sin importar qué haga el adversario. En la práctica eso quiere decir:
- No conocemos . La cadena se da como una fórmula en la que aparece , por ejemplo , y el argumento tiene que valer para cualquier valor.
- No elegimos la división. Lo único que sabemos de , , son las dos condiciones que el adversario está obligado a respetar: y . La demostración tiene que cubrir todas las divisiones que las cumplen.
- Sí elegimos e , y ahí está todo el trabajo. Una buena es una en la que la condición deja al adversario sin margen: por ejemplo, una que empieza con símbolos iguales, de modo que solo pueda estar hecha de ese símbolo.
El programa pumping_game juega una partida completa para un valor concreto de . Usa nuestra cadena y
nuestro exponente, y recorre todas las divisiones permitidas:
$ build/pumping_game 0n1n 3
L = { 0^n 1^n : n ≥ 0 }
el adversario elige p = 3
nosotros elegimos s = 000111, con |s| = 6 y s ∈ L
nuestro exponente: i = 2
divisiones posibles con |xy| ≤ 3 y |y| > 0: 6
  x   y    z      x y^i z
  ε   0    00111  0000111    ∉ L
  ε   00   0111   00000111   ∉ L
  ε   000  111    000000111  ∉ L
  0   0    0111   0000111    ∉ L
  0   00   111    00000111   ∉ L
  00  0    111    0000111    ∉ L
en las 6 divisiones la cadena bombeada sale de L
Con , las divisiones permitidas son : aquí, 6. El programa no demuestra nada, porque juega con un solo valor de y la demostración tiene que valer para todos. Sirve para lo contrario: para ver qué puede hacer el adversario y encontrar el error en un argumento antes de escribirlo.
Error común. Elegir uno mismo la división: “sea , , ; entonces ”. Eso solo muestra que una división falla, y el lema promete que alguna funciona, no que todas. La división es la jugada del adversario. El otro error gemelo es usar una cadena que no depende de , como : si el adversario dice , esa cadena es más corta que y el lema no dice nada sobre ella.
Cinco demostraciones
Las cinco siguen el mismo esquema, con las cuatro jugadas a la vista. En cada una hay que comprobar tres cosas de nuestra cadena: que está en el lenguaje, que mide al menos , y que con cualquier división permitida hay un exponente que la saca.
El lenguaje 0ⁿ1ⁿ
Teorema. no es regular.
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es regular.
Jugada 1: el adversario elige . Por el lema, tiene una longitud de bombeo . No sabemos cuánto vale.
Jugada 2: elegimos . Tomamos . Está en , con , y .
Jugada 3: el adversario elige la división. Por el lema, con y . No sabemos cuál es, pero esas dos condiciones dicen bastante. Los primeros símbolos de son todos ceros, y es un prefijo de de longitud a lo sumo : entonces e están hechas solo de ceros. Es decir,
Todas las divisiones permitidas son de esta forma, para algún y algún .
Jugada 4: elegimos . Tomamos . Entonces
Como , esta cadena tiene más ceros que unos: no está en .
Pero la condición 1 del lema dice que . Es una contradicción, y vino de suponer que es regular. ∎
Es la partida que pumping_game jugó arriba con : en las 6 divisiones, es ,
o , y la cadena bombeada tiene 4, 5 o 6 ceros y 3 unos.
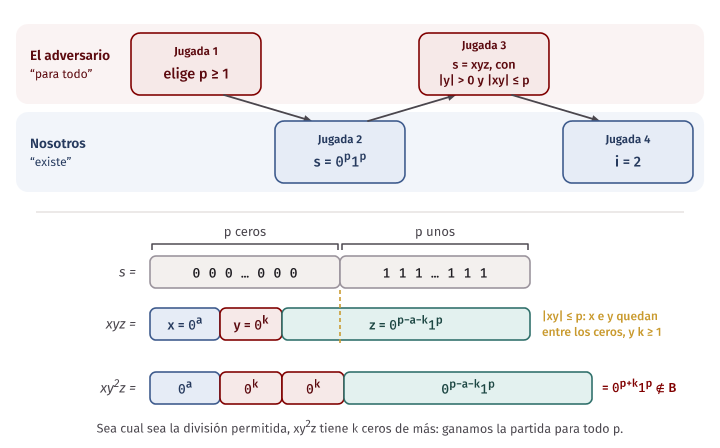
Dos comentarios. Con también se gana: tiene menos ceros que unos. Y la condición 3 hizo casi todo el trabajo. Sin ella, el adversario podría elegir una con ceros y unos, o solo con unos, y habría que tratar esos casos aparte. Se puede, pero es más largo y es fácil olvidar uno.
Igual número de ceros y unos
Teorema. no es regular.
Aquí los símbolos pueden venir en cualquier orden: y están en .
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es regular.
Jugada 1. El adversario elige .
Jugada 2. Elegimos , la misma cadena de antes. Tiene ceros y unos, así que está en , y .
Jugada 3. El adversario elige con y . Como antes, cae dentro de los primeros símbolos, que son ceros: con .
Jugada 4. Elegimos . La cadena tiene ceros y unos, con : no está en . Contradicción con la condición 1. ∎
La demostración es la misma porque la cadena es la misma. Lo que cambia es que aquí importa cuál se elige. Una cadena igual de natural, , también está en y mide . Con ella perdemos:
$ build/pumping_game iguales-mal 3
L = { w : w tiene tantos 0 como 1 }
el adversario elige p = 3
nosotros elegimos s = 010101, con |s| = 6 y s ∈ L
nuestro exponente: i = 2
divisiones posibles con |xy| ≤ 3 y |y| > 0: 6
  x   y    z      x y^i z
  ε   0    10101  0010101    ∉ L
  ε   01   0101   01010101   ∈ L: el adversario resiste
  ε   010  101    010010101  ∉ L
  0   1    0101   0110101    ∉ L
  0   10   101    01010101   ∈ L: el adversario resiste
  01  0    101    0100101    ∉ L
el adversario tiene 2 divisiones que resisten: con esta jugada no se demuestra nada
El adversario elige , y . Es una jugada permitida si , porque . Y entonces está en para todo : no hay exponente que nos salve. Eso no demuestra que sea regular. Demuestra que con esa cadena no se llega a ninguna contradicción, y que hay que buscar otra.
Error común. Concluir algo de una partida perdida. Si para la cadena que eligieron el adversario tiene una división que resiste, lo único que saben es que eligieron mal. La cadena buena es la que usa la condición para arrinconar a .
El lenguaje ww
Teorema. no es regular.
tiene las cadenas que son una mitad repetida: , con , y , con . Para reconocerlas habría que recordar la primera mitad entera.
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es regular.
Jugada 1. El adversario elige .
Jugada 2. Elegimos . Está en , con , y .
Jugada 3. El adversario elige con y . Los primeros símbolos de son ceros, así que con , y está dentro del primer bloque de ceros.
Jugada 4. Elegimos :
Falta ver que esta cadena no está en . Supongamos que sí: para alguna cadena . La cadena termina en , así que termina en . La cadena tiene exactamente dos unos, y como las dos mitades son iguales, cada una tiene exactamente uno. Entonces tiene un solo y está al final: para algún , y
Comparando con : el primer bloque de ceros da y el segundo da . Como , no pueden cumplirse las dos. Luego , y eso contradice la condición 1. ∎
Aquí también hay cadenas que no sirven. Con , que está en con , el adversario elige y todas las cadenas bombeadas son : una cantidad par de ceros, que siempre está en . Los unos de nuestra cadena son marcas que dicen dónde termina cada mitad, y por eso el adversario no puede desordenarla sin que se note.
En la práctica. En la semana 3 quedó pendiente por qué las referencias hacia atrás no son regulares. Muchas herramientas aceptan patrones como
^(.*)\1$, donde\1significa “aquí, otra vez, el mismo texto que coincidió con el primer paréntesis”. Sobre el alfabeto , ese patrón describe exactamente el lenguaje . Acabamos de demostrar que ningún DFA lo reconoce, así que un motor que acepte\1no puede funcionar simulando un autómata finito: tiene que usar backtracking, con el costo que vieron en la semana 3.
El lenguaje de los cuadrados
Teorema. no es regular.
El alfabeto es : las cadenas son , , , , , … Con un solo símbolo no hay orden que desordenar. Lo único que el bombeo cambia es la longitud, y el argumento es aritmético: los cuadrados están cada vez más separados, y bombear suma poco.
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es regular.
Jugada 1. El adversario elige .
Jugada 2. Elegimos . Está en , y porque .
Jugada 3. El adversario elige con y . Sea . Entonces , porque .
Jugada 4. Elegimos . La cadena tiene un bloque más que , así que su longitud es , y
La longitud de está estrictamente entre dos cuadrados consecutivos, y . No es un cuadrado, y . Contradicción con la condición 1. ∎
La elección de fue otra vez lo que importó. El salto de al cuadrado siguiente es , y el adversario solo puede sumar entre 1 y .
Más ceros que unos: bombear hacia abajo
Teorema. no es regular.
Un primer intento. Elegimos , que está en , y como siempre queda hecha solo de ceros. Si bombeamos con , sale : más ceros todavía. La cadena sigue en , y lo mismo con cualquier exponente mayor. Bombear hacia arriba no saca a ninguna cadena de este lenguaje:
$ build/pumping_game mas-ceros-mal 3
L = { 0^i 1^j : i > j }
el adversario elige p = 3
nosotros elegimos s = 0000111, con |s| = 7 y s ∈ L
nuestro exponente: i = 2
divisiones posibles con |xy| ≤ 3 y |y| > 0: 6
  x   y    z       x y^i z
  ε   0    000111  00000111    ∈ L: el adversario resiste
  ε   00   00111   000000111   ∈ L: el adversario resiste
  ε   000  0111    0000000111  ∈ L: el adversario resiste
  0   0    00111   00000111    ∈ L: el adversario resiste
  0   00   0111    000000111   ∈ L: el adversario resiste
  00  0    0111    00000111    ∈ L: el adversario resiste
el adversario tiene 6 divisiones que resisten: con esta jugada no se demuestra nada
Queda un exponente por probar: , que quita .
Demostración. Por contradicción, con el lema de bombeo. Supongamos que es regular.
Jugada 1. El adversario elige .
Jugada 2. Elegimos . Está en , porque , y .
Jugada 3. El adversario elige con y . Los primeros símbolos son ceros, así que con .
Jugada 4. Elegimos :
Como , la cantidad de ceros es : ya no es mayor que la de unos. Luego , y eso contradice la condición 1, que vale también para . ∎
$ build/pumping_game mas-ceros 3
L = { 0^i 1^j : i > j }
el adversario elige p = 3
nosotros elegimos s = 0000111, con |s| = 7 y s ∈ L
nuestro exponente: i = 0
divisiones posibles con |xy| ≤ 3 y |y| > 0: 6
  x   y    z       x y^i z
  ε   0    000111  000111   ∉ L
  ε   00   00111   00111    ∉ L
  ε   000  0111    0111     ∉ L
  0   0    00111   000111   ∉ L
  0   00   0111    00111    ∉ L
  00  0    0111    000111   ∉ L
en las 6 divisiones la cadena bombeada sale de L
La cadena se eligió justa: con un solo cero de ventaja, quitar cualquier no vacía ya rompe la condición. Con el argumento falla, porque el adversario elige y al quitarla quedan ceros, que siguen siendo más que unos cuando .
Idea clave. El exponente es una elección, y es tan legítimo como . Si el lenguaje pide “al menos tantos” de algo, bombear hacia arriba no lo rompe y hay que bombear hacia abajo. La cadena se elige en el borde de la condición, para que el menor cambio la saque.
Combinar con las propiedades de cierre
A veces el lenguaje es incómodo para el lema, pero se puede transformar en uno que ya sabemos que no es regular. Las propiedades de cierre de las semanas 1 y 2 se usan entonces al revés.
El esquema es este. Queremos demostrar que no es regular. Suponemos que lo es. Le aplicamos operaciones bajo las que los lenguajes regulares son cerrados, con otros lenguajes que sí son regulares, y llegamos a un lenguaje que sabemos que no es regular. Como las operaciones conservan la regularidad, eso es una contradicción.
Otra demostración de que no es regular. Por contradicción, usando cierre bajo intersección. Supongamos que , el lenguaje de las cadenas con tantos ceros como unos, es regular. El lenguaje es regular, porque lo describe una expresión regular. Los lenguajes regulares son cerrados bajo intersección, por la construcción del producto de la semana 1, así que sería regular. Pero
porque una cadena de la forma tiene tantos ceros como unos exactamente cuando . Y no es regular. Contradicción. ∎
La intersección hizo de filtro: de todas las cadenas de se quedó con las ordenadas, y ahí el problema difícil queda a la vista.
Con el complemento. El lenguaje de las cadenas binarias con distinta cantidad de ceros y unos tampoco es regular. Usar el lema de bombeo directamente es incómodo: hay que encontrar una cadena que, bombeada, caiga justo en la igualdad. Con cierre es una línea: su complemento es , y si un lenguaje es regular su complemento también lo es. Como no es regular, este tampoco.
Error común. Usar el cierre en la dirección que no vale. De ” contiene a un lenguaje no regular” no se concluye nada: contiene a todos los lenguajes y es regular. De ” está contenido en un lenguaje no regular” tampoco: está contenido en todos. Y de ” es regular” no sale que lo sea. Lo que dicen las propiedades de cierre es una sola cosa: si los datos son regulares, el resultado es regular. Para usarlas en una demostración de imposibilidad, el lenguaje sospechoso tiene que estar entre los datos, y todos los demás datos tienen que ser regulares.
Lo que el lema no dice
No sirve para demostrar que un lenguaje es regular. El lema es una implicación en un solo sentido: si es regular, entonces tiene la propiedad de bombeo. Lo que usamos toda la sesión es su contrarrecíproca: si no tiene la propiedad, no es regular. La implicación en el otro sentido, “si tiene la propiedad, es regular”, es otra afirmación, y es falsa.
Un lenguaje que lo muestra, sobre el alfabeto :
Si la cadena empieza con exactamente una , se le exige tener tantas como . Si empieza con cero, dos o más, no se le exige nada.
tiene la propiedad de bombeo, con . Sea con . Damos una división con , según con cuántas empieza :
- Ninguna. es el primer símbolo de , una o una . Bombearla cambia cuántas hay de esa letra, la cadena sigue siendo de la forma , y con no se le exige nada.
- Exactamente una. . Las cadenas bombeadas son con : están en para porque , y para los demás porque no se exige nada.
- Exactamente dos. . Las cadenas bombeadas empiezan con letras : nunca con exactamente una.
- Tres o más. . Las cadenas bombeadas empiezan con al menos dos letras .
En los cuatro casos , y todas las cadenas están en . El adversario gana siempre: con el lema de bombeo no se puede demostrar que no es regular.
Y no es regular. Si lo fuera, también lo sería , por cierre bajo intersección. Ese lenguaje es , y que no es regular se demuestra igual que para : con , la condición deja a dentro de . Si contiene la , con la cadena ya no empieza con y sale del lenguaje. Si no, con , y con hay más letras que .
Así que el lema de bombeo es una herramienta incompleta: detecta muchos lenguajes no regulares, pero no todos. La herramienta de la sesión B no tiene ese defecto: caracteriza a los lenguajes regulares exactamente, y con ella sale en dos líneas.
Error común. “Encontré una división que se puede bombear, así que el lenguaje es regular.” No: ni siquiera mostrar que toda cadena larga se puede bombear alcanza, como acaba de verse con . Para demostrar que un lenguaje es regular se da un DFA, un NFA o una expresión regular, o se lo arma con operaciones de cierre a partir de lenguajes regulares.
Un resumen de qué herramienta sirve para qué:
| Quiero demostrar que … | Sirve | No sirve |
|---|---|---|
| es regular | Un DFA, un NFA, una expresión regular; cierre a partir de lenguajes regulares | El lema de bombeo |
| no es regular | El lema de bombeo; cierre hasta un lenguaje que no es regular; cadenas distinguibles | “No se me ocurre un DFA” |
Cadenas distinguibles
La segunda herramienta parte de la misma limitación, mirada de otro modo. El lema de bombeo sigue una cadena larga y encuentra un estado que se repite. Ahora vamos a comparar dos cadenas y preguntar si un autómata puede permitirse confundirlas.
Piensen otra vez en y en un DFA que ya leyó . Para responder bien más adelante tiene que recordar que fueron tres ceros y no cinco: si después llegan tres unos debe aceptar, y si hubiera leído y llegan esos mismos tres unos debe rechazar. Las cadenas y tienen futuros distintos, y un autómata que las confunda se equivoca en alguno de los dos.
Definición. Sea un lenguaje sobre . Dos cadenas son distinguibles (distinguishable) respecto de si existe una cadena tal que exactamente una de las cadenas e está en . De esa se dice que es un sufijo que distingue a de . Si no existe ninguna, e son indistinguibles respecto de , y se escribe :
Tres cosas que conviene leer despacio en la definición.
- Siempre es respecto de un lenguaje. Las mismas dos cadenas pueden ser distinguibles para un lenguaje e indistinguibles para otro.
- e no tienen que estar en . Lo que se compara es lo que pasa después de ellas. El sufijo es el mismo para las dos.
- puede ser . Entonces la condición dice que exactamente una de , está en : una cadena de y una de fuera de son siempre distinguibles.
Algunos ejemplos, respecto de :
- y son distinguibles: con , y .
- y son indistinguibles. Las dos están en , así que no las separa. Y con cualquier no vacía, ni ni están en : si empieza con hay un cero después de un uno, y si empieza con sobran unos.
- y son indistinguibles: ninguna cadena que empiece con está en , así que y quedan fuera para toda .
Cuando el lenguaje es regular y tenemos un DFA suyo, la pregunta se puede responder con un programa. El más directo hace lo que dice la definición: prueba sufijos, del más corto al más largo. Con el autómata de 8 estados de la sección siguiente, que reconoce “el tercer símbolo desde el final es ”:
$ build/distinguish machines/last_3.dfa 011 001
x = 011 llega a 011, y = 001 llega a 001
sufijos probados, del más corto al más largo: 2
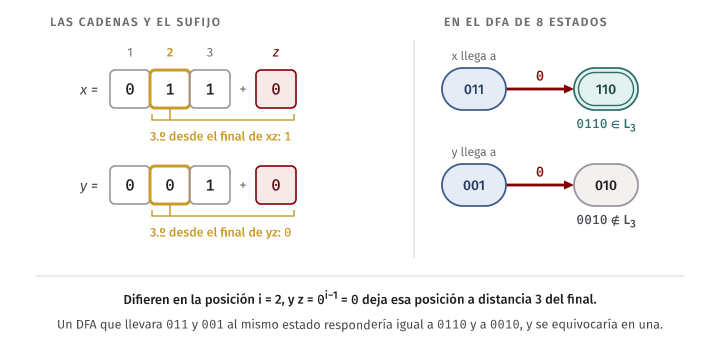
z = 0 las distingue: xz = 0110 se acepta, yz = 0010 se rechaza
El sufijo no las separa, porque ninguna de las dos tiene un en la tercera posición desde el final. Con , lo que queda en esa posición es el segundo símbolo de cada una, y ahí difieren.
Dos cadenas distinguibles no pueden terminar en el mismo estado
Lema (de los estados distintos). Sea un DFA que reconoce . Si e son distinguibles respecto de , entonces .
Demostración. Por la contrarrecíproca: si e llegan al mismo estado, son indistinguibles. Supongamos , y sea una cadena cualquiera. Por el lema de la concatenación,
Las cadenas e terminan en el mismo estado, así que acepta las dos o rechaza las dos. Como , eso dice que . Vale para toda : ninguna distingue a de . ∎
Es la observación que cerraba la sección de en la semana 1: después de leer , el estado es todo lo que la máquina recuerda. Si dos cadenas tienen futuros distintos, la máquina está obligada a recordar cuál de las dos leyó.
Teorema (cota inferior de estados). Sea un lenguaje y sea un conjunto de cadenas distinguibles dos a dos respecto de . Entonces todo DFA que reconoce tiene al menos estados.
Demostración. Por contradicción, con el principio del palomar. Supongamos que un DFA con menos de estados reconoce . Cada una de las cadenas de lleva a a algún estado, y hay menos estados que cadenas: dos cadenas distintas de , digamos e , terminan en el mismo. Por el lema de los estados distintos, e no son distinguibles. Pero todas las cadenas de lo son dos a dos. Contradicción. ∎
“Distinguibles dos a dos” quiere decir que cada par de cadenas distintas de tiene un sufijo que lo distingue. El sufijo puede ser distinto para cada par. En inglés, un conjunto así se llama fooling set, y es el nombre con el que aparece en las notas de Erickson.
Corolario. Si hay un conjunto infinito de cadenas distinguibles dos a dos respecto de , entonces no es regular.
Demostración. Por contradicción. Si fuera regular, lo reconocería un DFA con algún número de estados. Del conjunto infinito tomamos cadenas. Son distinguibles dos a dos, así que por el teorema todo DFA de tiene al menos estados. Contradicción. ∎
0ⁿ1ⁿ otra vez, en tres líneas
Teorema. no es regular.
Demostración. Con cadenas distinguibles. Sea , que es infinito. Dos cadenas distintas de son y con . El sufijo las distingue: y . Por el corolario, no es regular. ∎
No hubo adversario, ni división, ni casos. Y es el argumento informal del final de la semana 1, ahora completo: “un DFA con estados no puede distinguir cantidades” es el teorema de la cota inferior aplicado a .
Los otros lenguajes de la sesión A salen igual de rápido.
- Más ceros que unos, . Con : si , el sufijo da y .
- Los cuadrados, . Con : si , el sufijo lleva la primera a longitud , que es un cuadrado, y la segunda a , que está estrictamente entre y , y no lo es.
- El lenguaje , el que resistía al lema de bombeo. Con : si , el sufijo da y .
Idea clave. Para demostrar que no es regular con cadenas distinguibles hay que dar dos cosas: un conjunto infinito de cadenas, y para cada par de ellas un sufijo que deja a una dentro de y a la otra fuera. Las cadenas del conjunto son “lo que el autómata tendría que recordar”.
Error común. Dar un conjunto infinito de cadenas y distinguir solo algunos pares, por ejemplo cada cadena de la siguiente. Hace falta un sufijo para todo par . El otro error frecuente es usar un sufijo distinto para cada cadena del par: es una sola, y se le pega a las dos.
La deuda de la semana 2: 2ᵏ estados
En la semana 2 vimos el lenguaje
Una cadena de longitud menor que no tiene -ésimo símbolo desde el final, y no está en . Un NFA lo reconoce con estados: adivina cuál es el que importa y cuenta los símbolos que faltan. La construcción de subconjuntos dio un DFA con estados, y quedó sin demostrar que no se puede con menos. La intuición era que un DFA tiene que recordar los últimos símbolos, porque cualquiera de ellos puede terminar siendo el que decide. Ahora esa intuición es una demostración.
Teorema. Todo DFA que reconoce tiene al menos estados.
Demostración. Con cadenas distinguibles. Sea el conjunto de todas las cadenas binarias de longitud . Son . Veamos que son distinguibles dos a dos respecto de .
Sean dos cadenas de longitud . Como son distintas, difieren en alguna posición: hay un , con , tal que el símbolo de y el símbolo de son distintos. Uno es y el otro . Digamos que el de es el ; si no, se intercambian los nombres.
Tomamos . La cadena tiene longitud . Su -ésimo símbolo desde el final está en la posición
contando desde el principio, y esa posición cae dentro de : es el símbolo de , un . Luego . El mismo cálculo con da el símbolo de , un : . El sufijo distingue a de .
Por el teorema de la cota inferior, todo DFA de tiene al menos estados. ∎
El sufijo empuja la posición hasta que queda justo a distancia del final. Con ,
las cadenas y difieren en la posición 2, y el sufijo es : es lo que
encontró distinguish en la sección anterior.
La cota se alcanza. El autómata que recuerda los últimos símbolos tiene exactamente estados: su
estado es una cadena de bits, al leer un símbolo olvida el más antiguo y agrega el nuevo al final, y acepta
si el más antiguo es . Mientras no ha leído símbolos, cuenta los que faltan como ,
de modo que el estado inicial es y una cadena corta se rechaza. Es el autómata de la construcción
de subconjuntos de la semana 2 con otros nombres para los estados. En esta carpeta lo escribe directamente el
programa kth_from_end, sin pasar por el NFA, y machines/last_3.dfa es su salida para :
$ build/show_dfa machines/last_3.dfa
Q  = {000, 001, 010, 011, 100, 101, 110, 111}
Σ  = {0, 1}
q0 = 000
F  = {100, 101, 110, 111}

     δ    0    1
->   000  000  001
     001  010  011
     010  100  101
     011  110  111
   * 100  000  001
   * 101  010  011
   * 110  100  101
   * 111  110  111

estados alcanzables desde 000: 8 de 8
Con el autómata en la mano, el programa fooling_set comprueba un conjunto distinguible: recibe las cadenas y
busca, para cada par, el sufijo más corto que lo distingue.
$ build/fooling_set machines/last_3.dfa 000 001 010 011 100 101 110 111
sufijo más corto que distingue a cada par (fila, columna):
       001  010  011  100  101  110  111
  000  00   0    0    ε    ε    ε    ε
  001  .    0    0    ε    ε    ε    ε
  010  .    .    00   ε    ε    ε    ε
  011  .    .    .    ε    ε    ε    ε
  100  .    .    .    .    00   0    0
  101  .    .    .    .    .    0    0
  110  .    .    .    .    .    .    00
8 cadenas distinguibles dos a dos: todo DFA de este lenguaje tiene al menos 8 estados (este tiene 8)
La tabla tiene un sufijo en cada casilla: los 28 pares son distinguibles. Coincide con la demostración. Los pares que difieren ya en la primera posición se distinguen con ; los que coinciden en la primera y difieren en la segunda, con ; y los que solo difieren en la tercera, con .
Entonces, para , el DFA más pequeño tiene exactamente estados, y el NFA tiene . La construcción de subconjuntos no desperdicia nada en este ejemplo: el salto exponencial es inevitable.
En la práctica. Este es el motivo por el que las herramientas que buscan con expresiones regulares no siempre convierten el patrón en un DFA completo antes de empezar. Un patrón corto como “una
aseguida de exactamente 20 caracteres cualesquiera, al final de la línea” tiene un NFA de 22 estados y un DFA mínimo de más de un millón. Las alternativas son simular el NFA directamente, como en el laboratorio de la semana 3, o construir los estados del DFA a medida que la entrada los necesita y guardar solo los que aparecen.
El teorema de Myhill-Nerode
El teorema de la cota inferior dice que un conjunto de cadenas distinguibles obliga a tener estados. La pregunta natural es si esa cota es siempre la mejor: si lo máximo que se puede encontrar son cadenas distinguibles dos a dos, ¿alcanza un DFA con estados? La respuesta es sí, y es el teorema que cierra la teoría de los lenguajes regulares.
Las clases de equivalencia
La relación entre cadenas, “ser indistinguibles respecto de ”, es una relación de equivalencia:
- Reflexiva: , porque .
- Simétrica: si entonces , porque la condición trata igual a las dos.
- Transitiva: si e , entonces para toda se tiene , así que .
Como en Matemática Discreta, una relación de equivalencia parte al conjunto en clases de equivalencia (equivalence classes): la clase de , que se escribe , es el conjunto de todas las cadenas indistinguibles de . Cada cadena de está en exactamente una clase. Dos cadenas de la misma clase son indistinguibles, y dos cadenas de clases distintas son distinguibles.
Dos propiedades de las clases, que salen de la definición y se usan enseguida.
Lema (de las clases). Si , entonces:
- (a) ;
- (b) para todo símbolo .
Demostración. Las dos por aplicación directa de la definición, eligiendo el sufijo. Para (a), se toma en la definición de . Para (b), sea una cadena cualquiera. Hay que ver que . Pero e , y la definición de con el sufijo dice exactamente . ∎
La parte (a) dice que cada clase está entera dentro de o entera fuera. La parte (b) dice que si a dos cadenas de una misma clase se les agrega el mismo símbolo, siguen en una misma clase. Leídas juntas, dicen que las clases se comportan como los estados de un DFA.
El programa classes calcula las clases del lenguaje de un DFA. Con el autómata de 7 estados que la semana 1
descartó por recordar de más, el que guarda los dos últimos símbolos para decidir si la cadena termina en
:
$ build/classes machines/ends_01_seven.dfa 3
clases de equivalencia: 3
  [ε] (fuera de L): ε 1 11 011 111
  [0] (fuera de L): 0 00 10 000 010 100 110
  [01] (en L): 01 001 101
el autómata de las clases:
states: [ε] [0] [01]
alphabet: 0 1
start: [ε]
accept: [01]
delta:
[ε] 0 [0]
[ε] 1 [ε]
[0] 0 [0]
[0] 1 [01]
[01] 0 [0]
[01] 1 [ε]
Hay tres clases. En cada línea está su representante, entre corchetes, y las cadenas de longitud a lo sumo 3 que caen en ella. La clase tiene las cadenas que no terminan en ni en ; la clase , las que terminan en ; la clase , las que terminan en . Son exactamente los tres hechos que anotamos al diseñar el autómata de 3 estados en la semana 1. No es casualidad, y el teorema dice por qué.
Para un lenguaje que no es regular, las clases no se acaban. Respecto de , las cadenas están cada una en una clase distinta.
El teorema
Teorema (Myhill-Nerode). Sea un lenguaje sobre .
- Si un DFA con estados reconoce , entonces tiene a lo sumo clases de equivalencia.
- Si tiene un número finito de clases de equivalencia, entonces hay un DFA con exactamente estados que reconoce .
En consecuencia, es regular si y solo si tiene un número finito de clases, y ese número es el de estados del DFA más pequeño que reconoce .
Demostración de 1. Por contradicción, con el teorema de la cota inferior. Supongamos que un DFA con estados reconoce y que tiene más de clases. Tomamos una cadena de cada una de clases distintas. Dos cadenas de clases distintas son distinguibles, así que tenemos cadenas distinguibles dos a dos, y por el teorema de la cota inferior todo DFA de tiene al menos estados. Contradicción. ∎
Demostración de 2. Por construcción. Supongamos que tiene clases.
Qué se construye. El DFA cuyos estados son las clases:
Está bien definido. Una clase tiene muchos nombres: si , entonces y son el mismo estado. La definición de y la de usan un representante, y hay que comprobar que el resultado no depende de cuál se use. Para : si , por la parte (b) del lema de las clases , es decir, . Para : si , por la parte (a), . Y es finito porque hay clases.
Por qué reconoce . Primero, una afirmación sobre dónde termina cada cadena: para toda ,
Por inducción sobre . Caso base: por la definición de . Paso inductivo: si y la afirmación vale para ,
Con eso, para toda cadena :
Luego , y tiene estados. ∎
La consecuencia. Si es regular, lo reconoce algún DFA, y por la parte 1 hay finitas clases. Si hay finitas clases, por la parte 2 es regular. Y si hay clases: la parte 2 da un DFA con estados, y la parte 1 dice que ninguno tiene menos, porque un DFA con estados obliga a que . ∎
La afirmación dice qué es el autómata : la máquina que después de leer
recuerda la clase de , y nada más. Es lo mínimo que se puede recordar, porque dos cadenas de clases
distintas tienen que distinguirse, y es suficiente, porque la clase de ya dice si y a qué clase
pasa con cada símbolo. La salida de classes de arriba termina con ese autómata, escrito en formato .dfa: sus
tres estados son [ε], [0] y [01].
Idea clave. Las clases de equivalencia de son los estados que cualquier autómata de necesita. El lenguaje, y no quien lo diseña, decide cuántos estados hacen falta. Si son infinitas, el lenguaje no es regular.
A diferencia del lema de bombeo, este teorema vale en las dos direcciones. Sirve para demostrar que un lenguaje no es regular, mostrando infinitas clases, y también que sí lo es, mostrando que son finitas. Y en este segundo caso da el número exacto de estados.
Minimizar un DFA
El teorema de Myhill-Nerode dice que existe un DFA con el menor número posible de estados, pero lo construye a partir de las clases de , que son conjuntos infinitos de cadenas. En la práctica no se parte del lenguaje, sino de un DFA que ya lo reconoce y que puede tener estados de más: el que salió de una construcción de subconjuntos, de un producto o de un diseño poco cuidadoso. Minimizarlo es encontrar el DFA más pequeño que reconoce el mismo lenguaje.
Qué estados sobran
Hay dos maneras de que un estado sobre.
Estados inalcanzables. Si ninguna cadena lleva de a un estado, ninguna ejecución pasa por él, y se puede borrar sin cambiar el lenguaje. Los vimos en la semana 1, en la construcción del producto. Se encuentran con un recorrido del grafo de transiciones desde .
Estados equivalentes. Dos estados pueden ser alcanzables los dos y, aun así, hacer exactamente lo mismo de ahí en adelante. Es la idea de las cadenas indistinguibles, ahora para estados.
Definición. Sea un DFA. Un sufijo distingue a los estados y si exactamente uno de y está en . Dos estados son equivalentes, y se escribe , si ningún sufijo los distingue:
Si , da lo mismo estar en uno que en otro: desde los dos se aceptan exactamente las mismas continuaciones. Uno de los dos sobra, y se pueden fusionar en un solo estado.
Las dos nociones de esta sesión son la misma, vista desde las cadenas o desde los estados. Si lleva a e lleva a , entonces exactamente cuando , por el lema de la concatenación, y lo mismo con y . Luego:
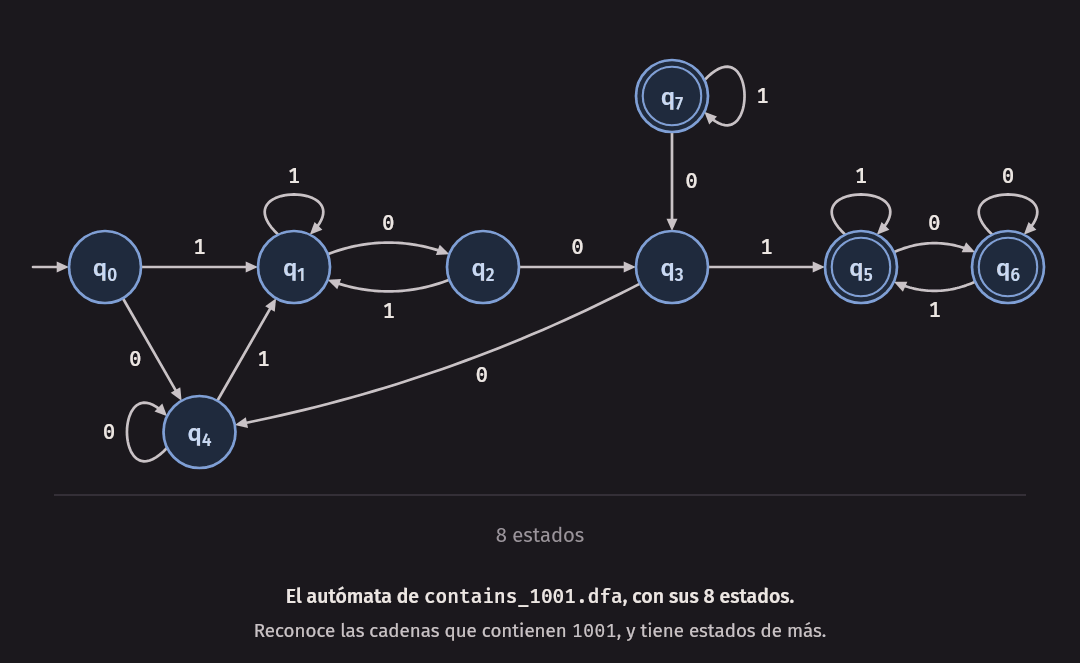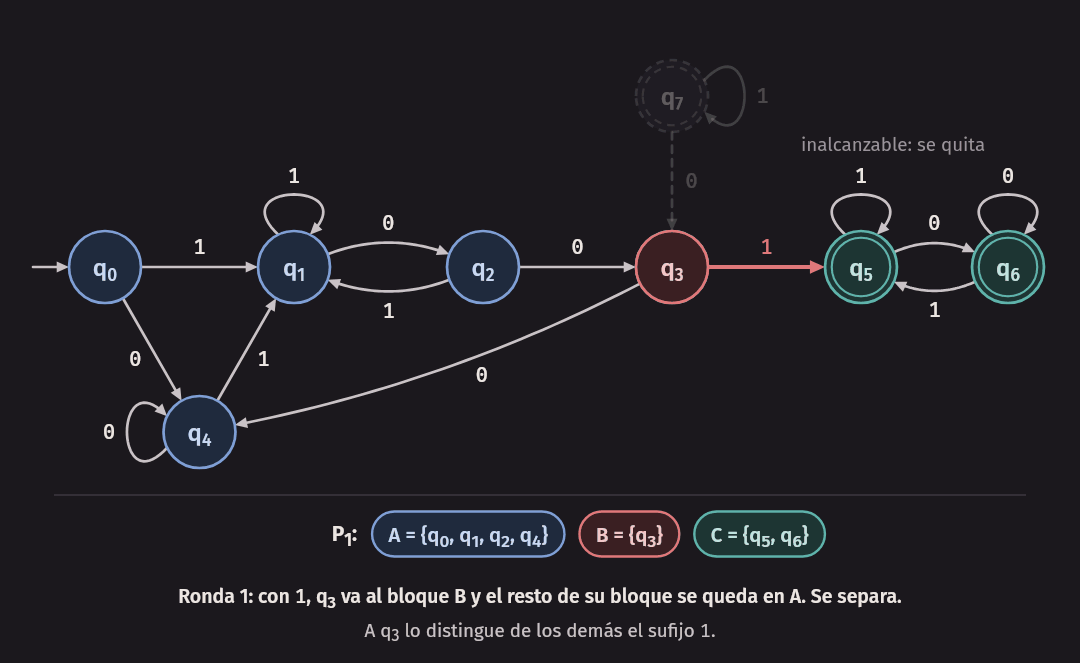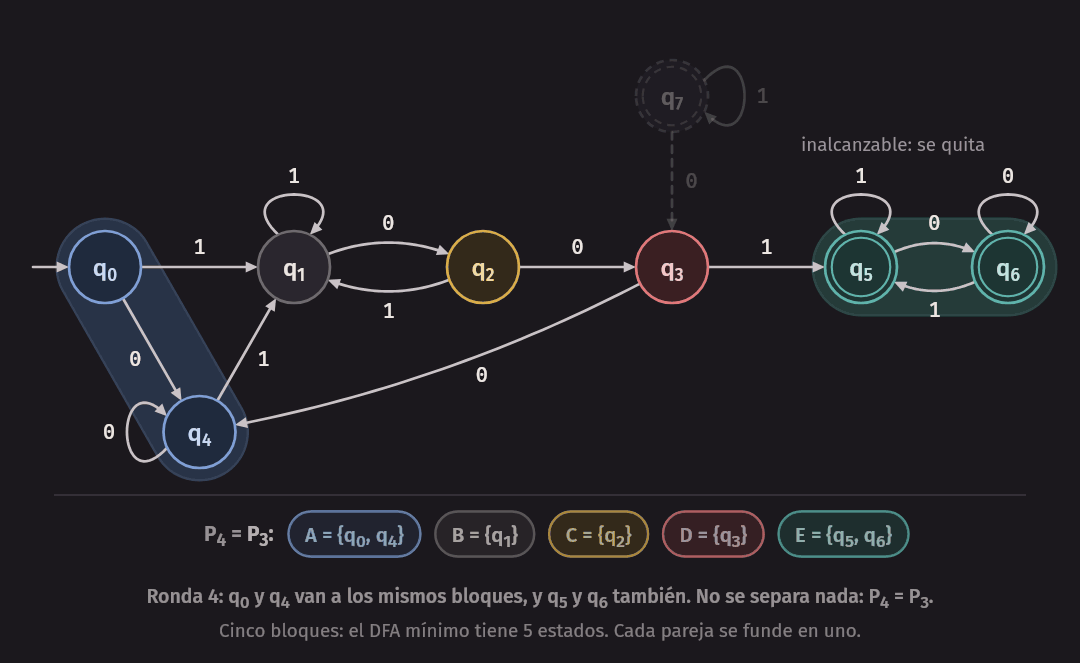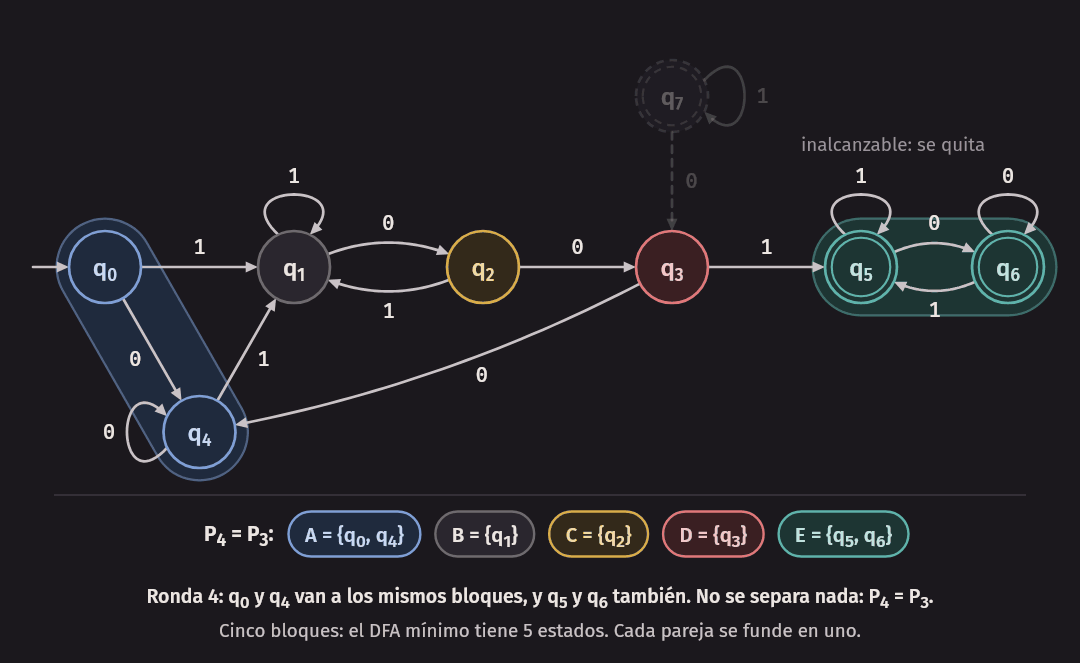
El autómata que usaremos de ejemplo está en machines/contains_1001.dfa. Reconoce las cadenas binarias que
contienen , y está escrito con descuido:
$ build/show_dfa machines/contains_1001.dfa
Q  = {q0, q1, q2, q3, q4, q5, q6, q7}
Σ  = {0, 1}
q0 = q0
F  = {q5, q6, q7}

     δ   0   1
->   q0  q4  q1
     q1  q2  q1
     q2  q3  q1
     q3  q4  q5
     q4  q4  q1
   * q5  q6  q5
   * q6  q6  q5
   * q7  q3  q7

estados alcanzables desde q0: 7 de 8| Estado | Lo que quiso decir quien lo escribió |
|---|---|
| Todavía no se leyó nada | |
| Ya se leyó algo, y no hay ningún avance hacia | |
| Lo leído termina en | |
| Lo leído termina en | |
| Lo leído termina en | |
| Ya apareció , y lo último fue un | |
| Ya apareció , y lo último fue un | |
| Quedó de una versión anterior |
La última línea de la salida dice que hay un estado inalcanzable. Es : ninguna transición de los otros
estados llega a él. Y a simple vista hay dos parejas sospechosas.
Distinguir “no se leyó nada” de “no hay avance” no sirve para nada, y una vez que apareció, da
igual cuál fue el último símbolo. El programa distinguish lo confirma para la primera pareja. La cadena
llega a y la cadena llega a :
$ build/distinguish machines/contains_1001.dfa '' 0
x = ε llega a q0, y = 0 llega a q4
ningún sufijo de longitud a lo sumo |Q| - 1 = 7 las distingue (255 probados): son indistinguibles
En cambio y , a los que llegan y , también “se parecen”: ninguno es de aceptación, y con cualquier símbolo los dos van a un estado que no es de aceptación. No son equivalentes:
$ build/distinguish machines/contains_1001.dfa '' 1
x = ε llega a q0, y = 1 llega a q1
sufijos probados, del más corto al más largo: 9
z = 001 las distingue: xz = 001 se rechaza, yz = 1001 se acepta
Hizo falta un sufijo de tres símbolos para separarlos: contiene y no. Cuando el programa responde que dos cadenas son indistinguibles, es porque probó todos los sufijos de longitud a lo sumo ; por qué eso alcanza se ve más abajo, en Por qué funciona.
Error común. Fusionar dos estados porque “se parecen”: ninguno es de aceptación, o sus filas de la tabla son casi iguales, o con un símbolo van al mismo lugar. Dos estados se fusionan solo si ningún sufijo los distingue, y el sufijo que los separa puede ser largo. Si en este ejemplo se fusionaran y , el autómata ya no podría responder distinto a y a . Y al revés: dos estados con filas distintas en la tabla, como y , pueden ser equivalentes.
distinguish prueba cadenas, y eso no sirve como algoritmo: hay demasiadas. Hace falta una manera de decidir
todos los pares de estados a la vez.
Refinar una partición
La idea es calcular la equivalencia por aproximaciones. Empezamos suponiendo que casi todos los estados son equivalentes, y vamos separando los que se demuestra que no lo son, hasta que no haya más que separar.
Una partición de es una manera de repartir los estados en bloques, de modo que cada estado esté en exactamente un bloque. El algoritmo mantiene una partición con este significado: dos estados en bloques distintos ya se sabe que son distinguibles; dos estados en el mismo bloque todavía no se han podido distinguir.
- Quitar los estados inalcanzables.
- Partición inicial: dos bloques, y . Un estado de aceptación y uno que no lo es se distinguen con el sufijo . Si o es vacío, queda un solo bloque.
- Una ronda: para cada estado y cada símbolo se mira a qué bloque va a parar. Dos estados siguen juntos si estaban en el mismo bloque y, con cada símbolo, van al mismo bloque. Si con algún símbolo van a bloques distintos, se separan: los destinos ya se distinguían con algún sufijo , así que ellos se distinguen con .
- Repetir la ronda hasta que no separe nada.
- Fusionar: el DFA mínimo tiene un estado por bloque.
En pseudocódigo:
algoritmo minimizar(M)
    quitar de M los estados a los que no se llega desde q0
    P ← {F, Q − F}, sin los bloques vacíos
    cambió ← verdadero
    mientras cambió
        para cada estado q
            firma[q] ← (bloque de q en P, bloque de δ(q, a) en P para cada símbolo a)
        fin para
        P' ← los estados agrupados por firma: un bloque por cada firma distinta
        cambió ← P' tiene más bloques que P
        P ← P'
    fin mientras
    devolver el autómata con un estado por bloque de P
fin algoritmo
La firma de un estado junta todo lo que la ronda mira de él. Como incluye el bloque en el que ya estaba, una ronda solo puede partir bloques, nunca juntarlos. Por eso, para saber si la partición cambió, basta comparar cuántos bloques hay.
El autómata que se devuelve, que llamaremos el autómata cociente, se arma así: sus estados son los bloques; desde un bloque, con el símbolo , va al bloque de , donde es cualquier estado del bloque; el estado inicial es el bloque que contiene a ; y un bloque es de aceptación si sus estados lo son. Cuando el algoritmo termina, da lo mismo qué del bloque se use: es justamente la condición de parada.
Este procedimiento se conoce como algoritmo de Moore.
Un ejemplo paso a paso
El programa minimize muestra la partición después de cada ronda. Los bloques llevan letras, y en la tabla de
cada ronda se ve a qué bloque va cada estado con cada símbolo. Con el autómata de :
$ build/minimize machines/contains_1001.dfa
estados: 8, alcanzables: 7. Se quitan: q7

P0: 2 bloques
  A = {q0, q1, q2, q3, q4}
  B = {q5, q6}

ronda 1: a qué bloque de P0 va cada estado
  estado  está en  con 0  con 1
  q0      A        A      A
  q1      A        A      A
  q2      A        A      A
  q3      A        A      B      <- se separa
  q4      A        A      A
  q5      B        B      B
  q6      B        B      B
P1: 3 bloques
  A = {q0, q1, q2, q4}
  B = {q3}
  C = {q5, q6}

ronda 2: a qué bloque de P1 va cada estado
  estado  está en  con 0  con 1
  q0      A        A      A
  q1      A        A      A
  q2      A        B      A      <- se separa
  q4      A        A      A
  q3      B        A      C
  q5      C        C      C
  q6      C        C      C
P2: 4 bloques
  A = {q0, q1, q4}
  B = {q2}
  C = {q3}
  D = {q5, q6}

ronda 3: a qué bloque de P2 va cada estado
  estado  está en  con 0  con 1
  q0      A        A      A
  q1      A        B      A      <- se separa
  q4      A        A      A
  q2      B        C      A
  q3      C        A      D
  q5      D        D      D
  q6      D        D      D
P3: 5 bloques
  A = {q0, q4}
  B = {q1}
  C = {q2}
  D = {q3}
  E = {q5, q6}

ronda 4: a qué bloque de P3 va cada estado
  estado  está en  con 0  con 1
  q0      A        A      B
  q4      A        A      B
  q1      B        C      B
  q2      C        D      B
  q3      D        A      E
  q5      E        E      E
  q6      E        E      E
P4 = P3: la partición ya no cambia

DFA mínimo: 5 estados
states: {q0,q4} q1 q2 q3 {q5,q6}
alphabet: 0 1
start: {q0,q4}
accept: {q5,q6}
delta:
{q0,q4} 0 {q0,q4}
{q0,q4} 1 q1
q1 0 q2
q1 1 q1
q2 0 q3
q2 1 q1
q3 0 {q0,q4}
q3 1 {q5,q6}
{q5,q6} 0 {q5,q6}
{q5,q6} 1 {q5,q6}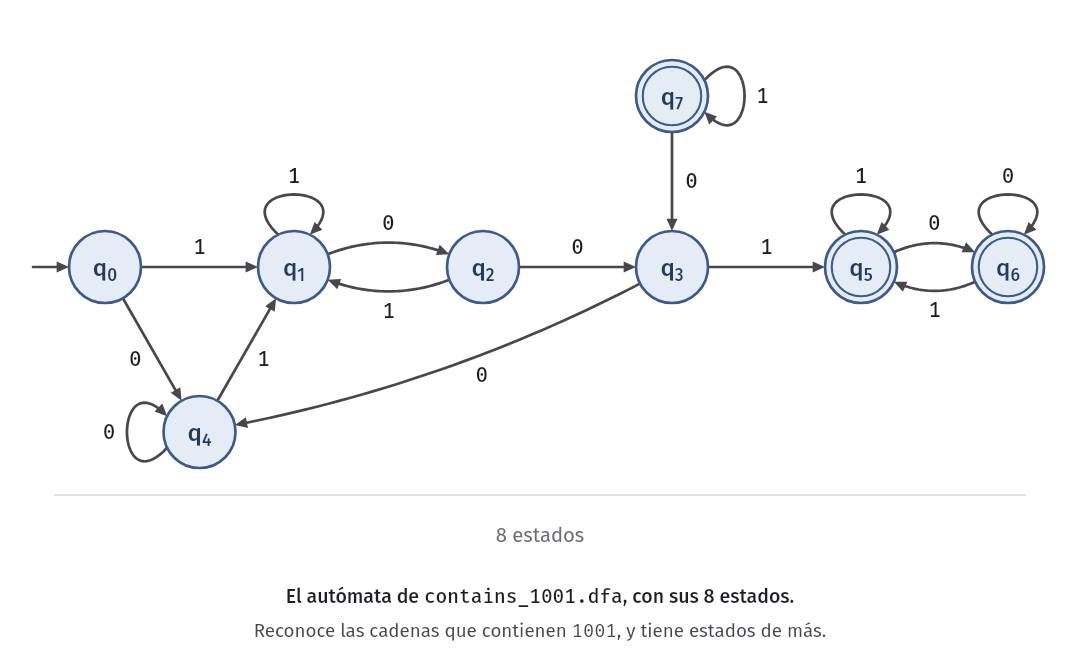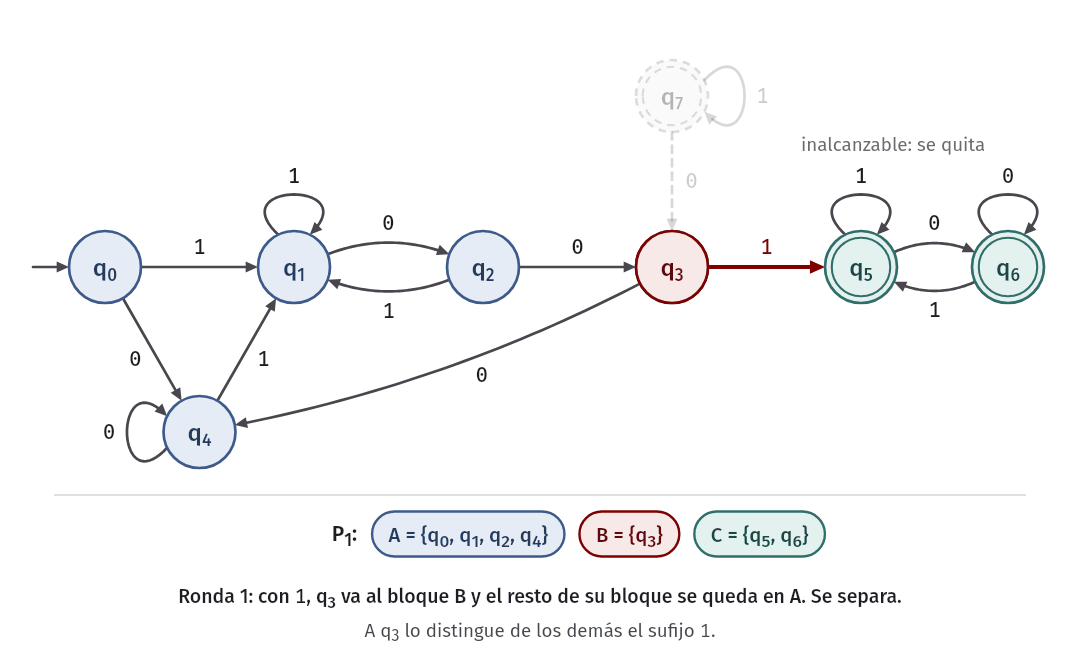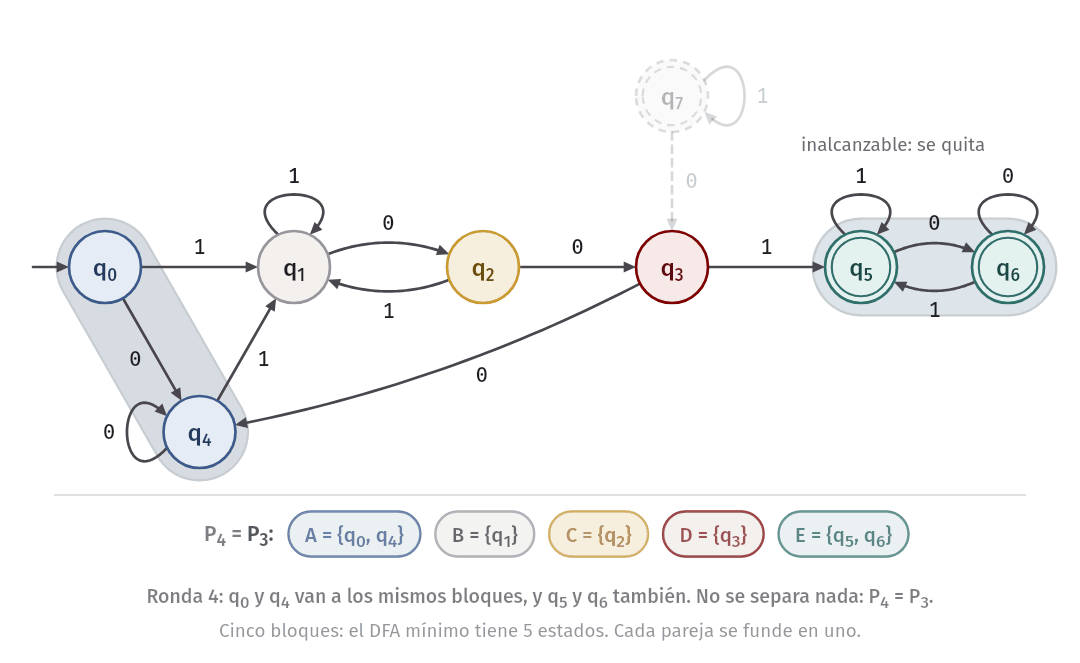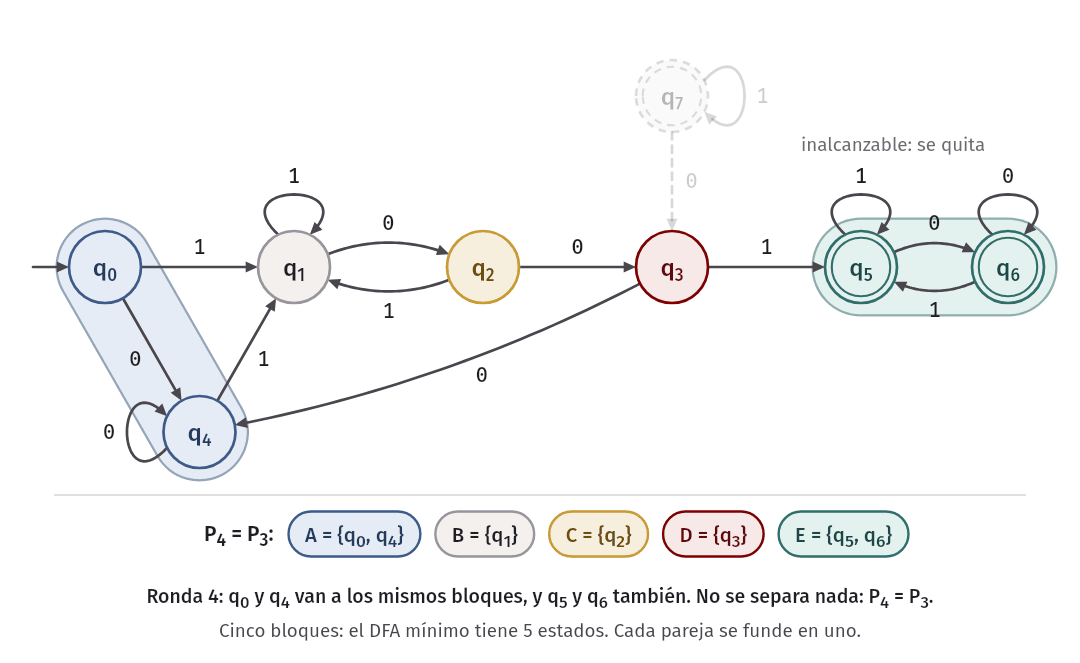
Sigámoslo a mano.
Antes de empezar. es inalcanzable y se quita. Quedan 7 estados.
. Los estados de aceptación que quedan son y :
Ronda 1. En el bloque , todos van a con . Con , todos van a salvo , que va a , del bloque . Entonces se separa: con el sufijo llega a aceptación y los otros no. En el bloque , y van a con los dos símbolos, y siguen juntos.
Ronda 2. Ahora tiene bloque propio, y eso delata a quien llega a él: va a con , y los demás de su bloque no. Se separa . El sufijo que lo distingue es .
Ronda 3. Lo mismo un paso más atrás: va a con , y y no. Se separa
, con el sufijo : el que encontró distinguish.
Ronda 4. y van los dos a con y a con . y van los dos a con cualquier símbolo. No se separa nada: , y el algoritmo termina.
El resultado. Cinco bloques, cinco estados. En la salida, un bloque de varios estados se llama con sus nombres entre llaves:
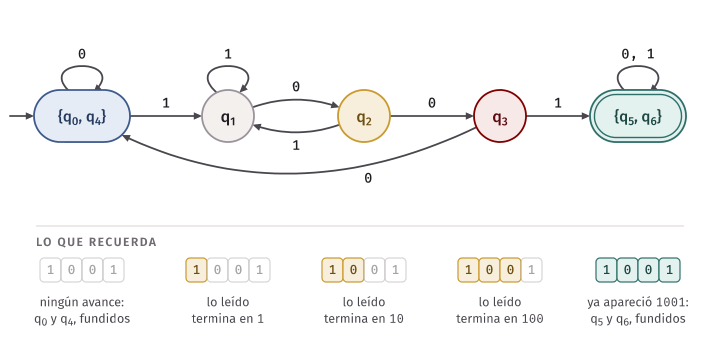
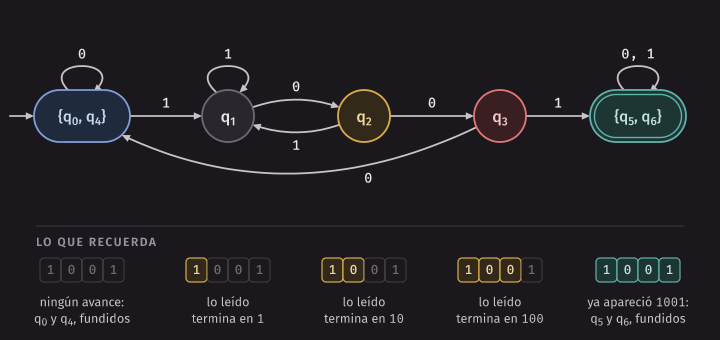
Es el autómata que habríamos diseñado con el método de la semana 1: un estado por cada avance hacia y un estado final del que no se sale. Las pruebas comprueban que acepta lo mismo que el original con todas las cadenas de longitud a lo sumo 12, y que es exactamente el lenguaje de las cadenas que contienen .
Dos cosas que el ejemplo enseña.
La información viaja hacia atrás, un paso por ronda. En solo se sabe quién acepta. En la ronda 1 se separa el que llega a aceptación en un paso, en la ronda 2 el que llega en dos, y así. Después de la ronda , dos estados están en bloques distintos exactamente si los distingue algún sufijo de longitud a lo sumo .
Hay que quitar primero los inalcanzables. Si se refina sin quitar , el algoritmo funciona igual, pero no es equivalente a ningún otro estado y se queda con un bloque propio:
$ build/minimize machines/contains_1001.dfa --todos | grep -E '^(estados|P[0-9]|DFA)'
estados: 8, alcanzables: 7. No se quita ninguno (--todos)
P0: 2 bloques
P1: 4 bloques
P2: 5 bloques
P3: 6 bloques
P4 = P3: la partición ya no cambia
DFA mínimo: 6 estados
Salen 6 estados en vez de 5. El autómata es correcto, pero no es el mínimo.
El autómata de 7 estados de Termina en 01 necesita una sola ronda:
$ build/minimize machines/ends_01_seven.dfa | grep -E '^(P[0-9]|  [A-Z] =)'
P0: 2 bloques
  A = {e, 0, 1, 00, 10, 11}
  B = {01}
P1: 3 bloques
  A = {e, 1, 11}
  B = {0, 00, 10}
  C = {01}
P2 = P1: la partición ya no cambia
Los tres bloques son las tres clases que mostró classes.
Por qué funciona
Hay que demostrar tres cosas: que el algoritmo termina, que el autómata que devuelve reconoce el mismo lenguaje, y que no hay ninguno más pequeño. Todo sale de entender qué partición hay después de cada ronda.
Sea el DFA después de quitar los inalcanzables. Para cada , digamos que si ningún sufijo de longitud a lo sumo distingue a de . Cuanto mayor es , más sufijos se prueban y más difícil es ser equivalentes: implica . Y quiere decir para todo .
Lema (de la ronda). Para todo y todos los estados , :
Demostración. Las dos direcciones, por la definición.
() Supongamos . Entonces , porque los sufijos de longitud a lo sumo están entre los de longitud a lo sumo . Sea un símbolo y un sufijo con . La cadena mide a lo sumo , así que no distingue a de : . Como , y lo mismo con , eso dice que no distingue a de . Vale para toda con : .
() Supongamos el lado derecho, y sea un sufijo con . Si , no distingue a de porque . Si no, con , y , y lo mismo con . Como , la cadena no los distingue, así que no distingue a de . ∎
Teorema (la minimización es correcta). Sea la partición después de rondas. Entonces:
- Dos estados están en el mismo bloque de si y solo si .
- El algoritmo termina después de a lo sumo rondas, y la partición final es la de .
- El autómata cociente reconoce .
- Ningún DFA que reconozca tiene menos estados.
Demostración de 1. Por inducción sobre . Caso base: el único sufijo de longitud 0 es , y . Entonces dice que y están los dos en o los dos fuera, y eso es estar en el mismo bloque de . Paso inductivo: la ronda deja juntos a y si tienen la misma firma, es decir, si están en el mismo bloque de y, para cada símbolo , y están en el mismo bloque de . Por la hipótesis de inducción, eso es y para todo . Por el lema de la ronda, eso es .
Demostración de 2. Cada ronda que cambia la partición aumenta el número de bloques al menos en uno. Hay al menos un bloque al empezar y nunca más de , así que a lo sumo rondas cambian algo, y la siguiente es la que no cambia nada.
Falta ver que, cuando una ronda no cambia nada, la partición ya es la de . Si , las relaciones y son la misma. El lema de la ronda calcula a partir de con la misma regla con la que calcula a partir de : con el mismo dato, da el mismo resultado, y es otra vez la misma relación. Repitiendo el argumento, es igual a para todo . Como quiere decir para todo , la partición final es la de .
Demostración de 3. Escribimos para el bloque de en la partición final. Por la parte 2, si y solo si . El autómata cociente es
Está bien definido. Hay que ver que y no dependen del representante. Sea , es decir, , y sea un símbolo. Si algún sufijo distinguiera a de , entonces distinguiría a de , porque y lo mismo con . No puede ser. Luego , es decir, . Y como el sufijo no distingue a de , los dos están en o ninguno.
Reconoce el mismo lenguaje. Para todo estado y toda cadena , . Por inducción sobre : para los dos lados son ; y si ,
Entonces acepta si y solo si , si y solo si , si y solo si acepta . El paso del medio usa que está bien definido: un bloque está en exactamente cuando sus estados están en .
Demostración de 4. Con cadenas distinguibles. Como en todos los estados son alcanzables, para cada bloque podemos elegir una cadena con . Sean dos bloques distintos. Entonces : algún sufijo distingue a de , es decir, exactamente uno de y está en . Pero , y lo mismo con : exactamente una de y está en . Luego y son distinguibles respecto de .
Tenemos una cadena por bloque, y son distinguibles dos a dos. Por el teorema de la cota inferior, todo DFA que reconoce tiene al menos tantos estados como bloques hay, que son los estados de . ∎
De la parte 2 sale también la cota que usa distinguish. A lo sumo rondas cambian algo, así que
ya es la partición final: si dos estados se pueden distinguir, los distingue algún sufijo de
longitud a lo sumo . Las partes 1 y 2 no usan que los estados sean alcanzables, y la cota vale para
cualquier DFA.
La parte 4 es el único lugar donde se usa el paso 1 del algoritmo. Para un estado inalcanzable no existe la cadena , y por eso con salía un estado de más.
Juntando la parte 4 con Myhill-Nerode: los bloques finales corresponden a las clases de , una por
bloque, y el autómata cociente es el autómata de las clases con otros nombres. Las pruebas de la semana
comparan los dos, para todos los autómatas de machines/.
Cuánto cuesta
Sea . Una ronda calcula firmas de números y agrupa los estados que tienen la misma: con una tabla hash, operaciones. Hay a lo sumo rondas. En total, el algoritmo de Moore cuesta en el peor caso.
El peor caso existe: un ciclo de estados con uno solo de aceptación necesita del orden de rondas, porque en cada una se separa un estado más. Pero en muchos autómatas las rondas son pocas. El de , con estados, necesita rondas que cambien algo:
$ build/kth_from_end --tabla 10
 k  estados del NFA  estados del DFA  después de minimizar  rondas con cambios
 1                2                2                     2                   0
 2                3                4                     4                   1
 3                4                8                     8                   2
 4                5               16                    16                   3
 5                6               32                    32                   4
 6                7               64                    64                   5
 7                8              128                   128                   6
 8                9              256                   256                   7
 9               10              512                   512                   8
10               11             1024                  1024                   9
La tabla dice además lo que ya demostramos: al minimizar el autómata de estados no se fusiona ninguno.
Existe un algoritmo más rápido, el de Hopcroft, que cuesta . En vez de revisar todos los estados en cada ronda, lleva una lista de bloques pendientes y solo revisa los estados que tienen una transición hacia el bloque que está procesando. Es el que usan las bibliotecas de autómatas. No lo vamos a estudiar: calcula la misma partición, y el de Moore alcanza para todo lo que hace el curso.
En C++. En
minimize.h, una partición es unstd::mapque le da a cada estado el número de su bloque. La firma de un estado es unstd::vector<int>, y los estados se agrupan con unstd::map<std::vector<int>, int>, que le asigna un número nuevo a cada firma distinta la primera vez que aparece:inline Partition refine(const Dfa& m, const Partition& p) { std::map<std::string, std::vector<int>> signature; for (const std::string& state : m.states) { std::vector<int> key = {p.block.at(state)}; for (char a : m.alphabet) { key.push_back(p.block.at(step(m, state, a))); } signature[state] = key; } return group_by(m, signature); }Un
std::vectorse puede usar como clave de unstd::mapporque los vectores se comparan en orden lexicográfico. Con elstd::mapcada búsqueda cuesta un factor más que con una tabla hash; para el laboratorio alcanza.
El DFA mínimo es único
Dos personas que minimizan el mismo autómata, o dos autómatas distintos del mismo lenguaje, ¿obtienen lo mismo? Los nombres de los estados pueden cambiar, pero nada más.
Dos DFA son iguales salvo los nombres de los estados si hay una biyección entre sus conjuntos de estados que respeta todo: lleva el estado inicial al inicial, los de aceptación a los de aceptación y los demás a los demás, y cumple para todo estado y todo símbolo. Dibujados, son el mismo diagrama con otras etiquetas en los círculos.
Teorema (unicidad). Sea un lenguaje regular cuya relación tiene clases. Todo DFA con estados que reconoce es igual, salvo los nombres de los estados, al autómata de las clases . En particular, dos DFA mínimos de son iguales salvo los nombres.
Demostración. Por construcción de la biyección. Sea un DFA con estados y .
Todos los estados de son alcanzables. Si alguno no lo fuera, al quitarlo quedaría un DFA de con menos de estados, y por Myhill-Nerode no existe.
La función. Para cada estado elegimos una cadena que llegue a él, , y definimos , la clase de . No depende de la cadena elegida: si e llegan las dos a , por el lema de los estados distintos son indistinguibles, y .
Es una biyección. Toda clase es la imagen de algún estado, el estado : es sobreyectiva. Y va de un conjunto de elementos a otro de elementos, así que una función sobreyectiva entre ellos es también inyectiva.
Respeta el autómata. El estado inicial: llega a , así que , el inicial de . Las transiciones: si llega a , entonces llega a , así que , que es . La aceptación: si y solo si acepta , si y solo si , si y solo si es de aceptación en .
Dos DFA mínimos de tienen estados cada uno. Los dos son iguales a salvo los nombres, y entonces lo son entre sí. ∎
El ejemplo está a la mano. La semana 1 diseñó el autómata de 3 estados de Termina en 01 pensando qué recordar. Esta semana minimizamos el de 7 estados con un algoritmo que no piensa nada. Tienen que haber llegado a lo mismo:
$ build/equivalent machines/ends_01_seven.dfa machines/ends_01.dfa
machines/ends_01_seven.dfa: 7 estados, mínimo de 3
machines/ends_01.dfa: 3 estados, mínimo de 3
los dos mínimos son el mismo autómata salvo los nombres: reconocen el mismo lenguaje
La correspondencia es , y .
La unicidad vale para los DFA. Un lenguaje puede tener varios NFA mínimos que no se parecen entre sí, y minimizar un NFA es un problema mucho más difícil, que no veremos.
Decidir si dos DFA son equivalentes
La unicidad da un algoritmo para una pregunta que hasta ahora respondíamos probando cadenas: ¿dos DFA sobre el mismo alfabeto reconocen el mismo lenguaje?
- Minimizar los dos.
- Comprobar si los mínimos son iguales salvo los nombres.
Si , los dos mínimos son DFA mínimos del mismo lenguaje, y por el teorema son iguales salvo los nombres. Si los lenguajes son distintos, los mínimos reconocen lenguajes distintos y no pueden ser iguales.
El paso 2 no exige probar todas las biyecciones. Si hay una, está forzada: el inicial va al inicial y, si
va a , entonces va a . Basta recorrer los dos autómatas a la vez desde los
iniciales, anotando la correspondencia, y parar si aparece una contradicción: un estado al que le tocarían dos
compañeros, o un par en el que uno acepta y el otro no. Es la función isomorphic de minimize.h. Cuando los
lenguajes son distintos, el programa muestra además la cadena más corta que los separa:
$ build/equivalent machines/contains_101.dfa machines/contains_1001.dfa
machines/contains_101.dfa: 4 estados, mínimo de 4
machines/contains_1001.dfa: 8 estados, mínimo de 5
los mínimos son distintos: no reconocen el mismo lenguaje
la cadena más corta que los separa: 101 (la acepta el primero)
Hay otro algoritmo, que salía del ejercicio 13 de la semana 1: construir el producto de los dos autómatas y buscar un par alcanzable en el que exactamente uno acepte. Los dos son correctos. Lo importante es que la pregunta tiene un algoritmo que siempre termina y siempre responde bien. En la semana 9 ese hecho tendrá nombre, ” es decidible”, y lo compararemos con la misma pregunta para modelos más potentes, donde la respuesta es otra.
En la práctica. Minimizar es el último paso del camino clásico para generar un analizador léxico, el que describen los textos de compiladores: de las expresiones regulares de los tokens a un NFA, del NFA a un DFA con la construcción de subconjuntos, y de ese DFA a su mínimo, para que la tabla de transiciones que se escribe en el programa ocupe lo menos posible. Y como el mínimo es único, sirve de forma canónica: para saber si dos expresiones regulares describen el mismo lenguaje, se llevan las dos hasta su DFA mínimo y se comparan.
Streaming: una cota inferior de memoria
Esta sección es opcional.
Un algoritmo de streaming procesa datos que llegan uno tras otro y que son demasiados para guardarlos: los paquetes que pasan por un router, las líneas de un registro de eventos, las lecturas de un sensor. Lee cada dato una sola vez, en orden, y mantiene una memoria pequeña que actualiza con cada uno. Al final, o en cualquier momento, responde una pregunta sobre todo lo que vio.
Dicho así, es un autómata. Supongamos que los datos son símbolos de un alfabeto , que la pregunta es de sí o no, y que el algoritmo es determinista y usa bits de memoria, sea cual sea la longitud de la entrada. El contenido de la memoria es una de combinaciones posibles. Cada símbolo que llega cambia ese contenido de una manera que depende solo del contenido anterior y del símbolo. Y la respuesta final depende solo del contenido final. Aquí “memoria” es todo lo que cambia mientras el algoritmo lee: sus variables y también, si las tiene, el punto del programa en el que va. Eso es un DFA:
| El algoritmo | El DFA |
|---|---|
| Un contenido posible de la memoria | Un estado: hay a lo sumo |
| El contenido al empezar | |
| Cómo se actualiza con cada dato | |
| Los contenidos con los que responde sí | |
| Las entradas con las que responde sí |
Entonces todo lo que sabemos sobre el número de estados dice algo sobre la memoria.
Teorema. Si un algoritmo de streaming determinista con bits de memoria decide un lenguaje , y hay cadenas distinguibles dos a dos respecto de , entonces .
Demostración. El algoritmo es un DFA que reconoce con a lo sumo estados. Por el teorema de la cota inferior tiene al menos . Luego . ∎
Es una cota inferior: no habla de un algoritmo concreto, sino de todos. Ningún programador, por ingenioso que sea, puede resolver el problema con menos memoria.
Un ejemplo completo. Un servicio emite una señal por segundo: si hubo un error y si no. En cualquier momento se nos puede preguntar: ¿hubo un error hace exactamente segundos? Es decir, ¿el -ésimo símbolo desde el final es ? Es el lenguaje .
- Cota inferior. Las cadenas de longitud son distinguibles dos a dos respecto de , como demostramos arriba. Por el teorema, cualquier algoritmo necesita bits.
- Cota superior. Guardar los últimos símbolos en un registro de bits, que se desplaza con cada dato,
resuelve el problema. Es el
struct Windowdestreaming.h: al leer un símbolo hacebits = ((bits << 1) | nuevo) & mask, y para responder mira el bit más antiguo.
Las dos cotas coinciden: hacen falta exactamente bits. Para preguntar por lo que pasó hace una hora, son 3600 bits, y no existe ninguna manera de resumirlos. Las pruebas comprueban que el registro responde igual que el DFA de estados, y que sus contenidos posibles son, uno por uno, los estados.
Para un lenguaje que no es regular, ninguna cantidad fija de memoria alcanza. Pero el mismo argumento todavía mide cómo crece la memoria con la longitud de la entrada. Tomemos , tantos ceros como unos, y un algoritmo que solo tiene que acertar con las entradas de longitud a lo sumo . Las cadenas se distinguen dos a dos con sufijos que no pasan de esa longitud: para , el sufijo da y , y las dos miden a lo sumo . El lema de los estados distintos sigue valiendo, porque solo usa esas cadenas: después de leer y la memoria tiene que ser distinta. Son contenidos distintos, y hacen falta al menos bits. Un contador de la diferencia entre ceros y unos lo resuelve con unos bits, así que la respuesta correcta es “del orden de ”, y ya no se puede mejorar más que en una constante.
En la práctica. Con el mismo argumento se demuestra que contar exactamente cuántos elementos distintos tiene un flujo, por ejemplo cuántos usuarios distintos visitaron un sitio, necesita una memoria proporcional al número de elementos posibles. Por eso los sistemas reales no lo calculan exactamente: estiman, con estructuras probabilísticas como HyperLogLog, que usan unos pocos kilobytes y aceptan un error pequeño. Una cota inferior no es una mala noticia: dice cuándo dejar de buscar el algoritmo exacto y cambiar la pregunta.
El código de la semana
code/week-04/
├── dfa.h                 el struct Dfa de la semana 1, sin cambios
├── pumping.h             la división del lema sacada de un DFA; las partidas del juego
├── distinguish.h         sufijos que distinguen; conjuntos distinguibles; el autómata de las clases
├── minimize.h            particiones, rondas de Moore, autómata cociente, igualdad salvo nombres
├── streaming.h           el registro de k bits y el contador
├── show_dfa.cpp          muestra un .dfa como quíntupla y como tabla (semana 1)
├── run_dfa.cpp           la ejecución de un DFA con una o más cadenas (semana 1)
├── pump.cpp              la división x, y, z de una cadena, y las cadenas bombeadas
├── pumping_game.cpp      una partida completa del juego para un p concreto
├── distinguish.cpp       ¿dos cadenas son distinguibles? por fuerza bruta
├── fooling_set.cpp       comprueba un conjunto de cadenas distinguibles dos a dos
├── classes.cpp           las clases de equivalencia del lenguaje de un DFA
├── kth_from_end.cpp      escribe el DFA de 2^k estados de L_k
├── minimize.cpp          minimiza un DFA y muestra cada ronda
├── equivalent.cpp        decide si dos DFA reconocen el mismo lenguaje
├── machines/             los autómatas del capítulo, en formato .dfa
├── test_pumping.cpp      el lema en autómatas reales; las cinco demostraciones, división por división
├── test_distinguish.cpp  cadenas distinguibles, la cota 2^k, Myhill-Nerode, streaming
├── test_minimize.cpp     las particiones del ejemplo; el mínimo es equivalente y no se reduce más
└── lab/minimize_dfa/     el ejercicio opcional de laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan.
$ make test
test_pumping: ok
test_distinguish: ok
test_minimize: ok
Todas las pruebas pasaron.
Las pruebas comprueban con assert lo que este capítulo afirma sobre máquinas y cadenas concretas.
test_pumpingrevisa que la división depumpcumple las tres condiciones del lema en siete autómatas. Para las cinco demostraciones de la sesión A, juega la partida con de 1 a 12 y comprueba que en todas las divisiones permitidas es solo ceros y que el exponente elegido saca la cadena del lenguaje. Comprueba también que las cadenas mal elegidas dejan una división que resiste, y que el lenguaje se deja bombear con en todas sus cadenas de longitud entre 2 y 8.test_distinguishrevisa los sufijos de las demostraciones de la sesión B. Para de 1 a 6, comprueba que las cadenas de longitud son distinguibles dos a dos con el sufijo , que la fuerza bruta y el recorrido de pares de estados dan sufijos igual de cortos, y que el autómata de las clases es igual, salvo nombres, al que devuelve la minimización.test_minimizecomprueba las cuatro particiones del ejemplo, una por una, y que separa exactamente a los estados que se distinguen con sufijos de longitud a lo sumo . Para cada autómata, el mínimo acepta lo mismo que el original con todas las cadenas de longitud a lo sumo 12, tiene el número de estados de la tabla siguiente, y sus estados son alcanzables y distinguibles dos a dos. También minimiza 120 autómatas al azar y compara el número de estados con un conteo por fuerza bruta.
Los archivos de machines/ son:
| Archivo | Lenguaje | Estados | Estados del mínimo |
|---|---|---|---|
count_attempt.dfa |
El intento fallido para | 8 | 8 |
multiple_of_3.dfa |
Múltiplos de 3 en binario (semana 1) | 3 | 3 |
multiple_of_3_mod6.dfa |
Múltiplos de 3, llevando el resto entre 6 | 6 | 3 |
ends_01.dfa |
Termina en (semana 1) | 3 | 3 |
ends_01_seven.dfa |
Termina en , recordando dos símbolos | 7 | 3 |
contains_101.dfa |
Contiene (semana 1) | 4 | 4 |
contains_1001.dfa |
Contiene , con estados de más | 8 | 5 |
last_3.dfa |
El tercer símbolo desde el final es | 8 | 8 |
Como en la semana 1, es un std::map con los nombres de los estados como cadenas. Se eligió para que
el código se lea como las definiciones. En el laboratorio conviene numerar los estados y trabajar con enteros.
El laboratorio
La sesión de laboratorio de esta semana es para la Práctica 1. El problema de lab/minimize_dfa queda como
ejercicio opcional: leer un DFA en formato .dfa y escribir, en el mismo formato, el DFA mínimo equivalente.
cd lab/minimize_dfa
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Hay muchas respuestas correctas, porque los estados del resultado pueden llamarse de cualquier manera y
escribirse en cualquier orden. Por eso el juez usa un verificador: comprueba que la salida sea un DFA bien
formado, que reconozca el mismo lenguaje que la entrada y que tenga el número mínimo de estados. Por el teorema
de unicidad, con eso basta para saber que es el mínimo. Los casos incluyen estados inalcanzables, un autómata
sin estados de aceptación, uno con todos de aceptación, uno que ya es mínimo, y cuatro entradas grandes en las
que decidir cada par de estados por separado da TLE. El enunciado está en el README.md de esa carpeta.
Resumen
- En un DFA con estados, toda ejecución de pasos o más repite un estado, y el tramo leído entre las dos visitas se puede quitar o repetir sin cambiar el estado final.
- Lema de bombeo: si es regular, hay un tal que toda con se divide en con para todo , y .
- Para demostrar que un lenguaje no es regular se usa como un juego: el adversario elige , nosotros , el adversario la división, nosotros . No conocemos ni elegimos la división: el argumento cubre todas las que cumplen y .
- La cadena se elige para que arrincone a , y en el borde de la condición del lenguaje. El exponente puede ser : bombear hacia abajo.
- Con las propiedades de cierre: si fuera regular, lo sería para todo regular. Se usa para llegar a un lenguaje que ya se sabe que no es regular.
- El lema no demuestra que un lenguaje es regular. Hay lenguajes no regulares que lo cumplen.
- e son distinguibles respecto de si algún sufijo deja a exactamente una de , en . Dos cadenas distinguibles no pueden terminar en el mismo estado de un DFA de .
- cadenas distinguibles dos a dos obligan a tener al menos estados. Infinitas: el lenguaje no es regular.
- “El -ésimo símbolo desde el final es ” necesita exactamente estados en un DFA, y en un NFA.
- Myhill-Nerode: es regular si y solo si tiene finitas clases de equivalencia, y ese número es el de estados del DFA mínimo. Las clases son los estados: .
- Minimizar: quitar los estados inalcanzables, partir de y refinar hasta que no cambie: dos estados siguen juntos si con cada símbolo van al mismo bloque. Después de la ronda , están separados los estados que se distinguen con sufijos de longitud a lo sumo .
- Dos estados se fusionan solo si ningún sufijo los distingue, no porque se parezcan.
- El DFA mínimo es único salvo los nombres de los estados. Por eso se puede decidir si dos DFA son equivalentes: se minimizan y se comparan.
- Opcional. Un algoritmo de streaming con bits de memoria es un DFA con a lo sumo estados: cadenas distinguibles obligan a usar al menos bits.
Ejercicios
- Para cada división de con y , escriban y y
digan si están en . ¿Cuántas divisiones hay? ¿Cuántas habría sin la
condición , y en cuáles de esas tiene ceros y unos? Comprueben la primera parte con
build/pumping_game 0n1n 3. - Corran
build/pump machines/contains_101.dfa 0110100y expliquen la división que sale: ¿qué estado se repite y cuál es el ciclo? Después elijan una cadena de longitud 6 que el autómata rechace y repitan. ¿Qué dice el lema, tal como está enunciado, sobre las cadenas que no están en el lenguaje? ¿Y la demostración? - Demuestren con el lema de bombeo que no es regular. Escriban las cuatro jugadas. ¿Qué cadena eligen y por qué? ¿Se gana bombeando hacia arriba o hacia abajo?
- Demuestren lo mismo con un conjunto infinito de cadenas distinguibles. Comparen la longitud de las dos demostraciones.
- Alguien escribe: ” no es regular. Demostración: sea , y sea , , . Entonces .” Digan qué jugada está mal y por qué eso invalida el argumento. Después expliquen por qué el lema de bombeo no demuestra que un lenguaje es regular, escribiendo su forma lógica.
- Demuestren que no son regulares: (a) los palíndromos sobre ; (b) , usando propiedades de cierre; (c) , con el lema de bombeo y el exponente , donde es la longitud de la cadena que eligieron.
- Para cada lenguaje, digan si es regular. Si lo es, den un DFA o una expresión regular; si no, demuéstrenlo. (a) . (b) . (c) . (d) . El (b) tiene trampa: prueben con cadenas cortas antes de decidir.
- ¿Cuántos estados tiene el DFA mínimo de las cadenas binarias cuyo valor es múltiplo de 5? Den el autómata y
justifiquen que no se puede con menos, con cinco cadenas distinguibles dos a dos y el sufijo de cada par.
Comprueben su conjunto con
build/fooling_set. - Describan las clases de equivalencia de para: (a) las cadenas con una cantidad par de unos; (b)
las cadenas que contienen ; (c) . En (a) y (b),
comparen con lo que imprime
build/classes. En (c), ¿en qué clase están las cadenas que no son prefijo de ninguna cadena del lenguaje? - Minimicen a mano el autómata de
machines/multiple_of_3_mod6.dfa, de seis estados, mostrando la partición después de cada ronda. Comprueben conbuild/minimize. Den la correspondencia entre el resultado y el autómata de 3 estados de la semana 1, y expliquen con aritmética por qué y son equivalentes. - Construyan con el programa
productde la semana 1 la intersección de Termina en 01 y Contiene 101, y minimícenla. ¿Cuántos estados tenía el producto, cuántos eran alcanzables y cuántos tiene el mínimo? Den un sufijo que distinga a cada par de estados del mínimo. - Den un DFA de estados, para cualquiera, en el que el refinamiento necesite rondas que cambien algo. ¿Qué tienen que ver las rondas con la longitud de los sufijos que distinguen a los estados? Después expliquen por qué, con un alfabeto de dos símbolos, un DFA mínimo al que le basta una sola ronda que cambie algo tiene a lo sumo 8 estados.
- Para programar. Agreguen a
minimize.huna función que reciba un DFA y diga si su lenguaje es finito, sin probar cadenas. Pista: minimicen, quiten el estado trampa si lo hay, y busquen un ciclo. ¿Qué tiene que ver con el lema de bombeo? Pruébenla con los autómatas demachines/. - Para programar. Escriban un programa que reciba dos archivos
.dfay decida si reconocen el mismo lenguaje con el producto, sin minimizar. Compárenlo conbuild/equivalenten todos los pares de autómatas demachines/. ¿Cuál de los dos algoritmos da además un DFA que sirve para otras cosas? - Opcional. Un flujo de símbolos de , y la pregunta: ¿hay algún entre los últimos símbolos? Den un algoritmo y cuenten sus bits de memoria. Después den una cota inferior con cadenas distinguibles. ¿Coinciden? Comparen con los bits de y expliquen la diferencia.