
Apuntes · Capítulo 12Complejidad
Tiempo: P y NP
Tiempo: P y NP
Las semanas 9 a 11 trazaron una frontera: de un lado los lenguajes decidibles, del otro los que ninguna máquina de Turing decide, como y el problema de la parada. Esa frontera no dice nada sobre el costo. Para ella da lo mismo un problema que se decide en un segundo que uno que necesita más pasos que átomos tiene el universo: los dos son “decidibles”. Esta semana empieza la cuarta parte del curso, la complejidad, que mira dentro de lo decidible y pregunta cuánto cuesta.
En Análisis y Diseño de Algoritmos ya trabajaron con esa pregunta. Contaron operaciones, escribieron , y en las últimas semanas conocieron P, NP y los problemas NP-completos. Pero todo eso se apoyaba en una idea informal de “algoritmo” y de “operación”. ¿Una suma de dos números de mil dígitos es una operación? ¿Leer una casilla de un arreglo lo es, aunque el arreglo tenga casillas? Para comparar algoritmos esas preguntas casi nunca importan. Para demostrar que un problema no tiene algoritmo rápido, o que todos los problemas de una clase se reducen a uno solo, importan: hay que razonar sobre todos los algoritmos posibles a la vez, y eso exige una definición. Ya la tenemos, desde la semana 7: la máquina de Turing.
Esta semana redefine P y NP sobre máquinas de Turing, con cuidado.
- En la sesión A se define el tiempo de una máquina, se cuenta de verdad cuántos pasos dan tres máquinas para un mismo lenguaje, y se demuestra que la clase P no depende de los detalles del modelo. También se mira un detalle que en Algoritmos pasó rápido y que aquí es central: cómo se escribe la entrada.
- En la sesión B se define NP de dos maneras, con verificadores y con máquinas no deterministas, y se demuestra que las dos definiciones dan la misma clase. Se ubica a NP entre P y EXPTIME, y aparece coNP.
No vamos a repetir el catálogo de reducciones de Algoritmos. Las reducciones vuelven la semana 13, cuando se demuestre el teorema que allá solo se enunció: que SAT es NP-completo.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, De «¿se puede?» a «¿cuánto cuesta?» y El tiempo de una máquina. Antes de la sesión B, Encontrar frente a comprobar. Con eso llegan con la definición de tiempo y con la idea de certificado.
En clase: Sesión A, de El tiempo de una máquina a El no determinismo parece costar caro. Sesión B, de Encontrar frente a comprobar a coNP: el lado del no.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, Verificadores y la clase NP, Cinco problemas de NP y sus certificados y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 7.1 (Measuring Complexity), 7.2 (The Class P) y 7.3 (The Class NP). Barak, capítulo 13 (Modeling running time) y la primera parte del capítulo 15 (NP, NP completeness, and the Cook-Levin Theorem). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-12. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/verifiers.
De «¿se puede?» a «¿cuánto cuesta?»
Hasta la semana pasada, una máquina podía hacer tres cosas con una entrada: aceptarla, rechazarla o no detenerse nunca. Toda la parte de computabilidad giró alrededor de la tercera posibilidad.
En esta parte del curso esa posibilidad desaparece. Todas las máquinas de las semanas 12 a 15 son decididores: se detienen con todas las entradas. Y todos los lenguajes de los que hablaremos son decidibles. La pregunta ya no es si la máquina termina, sino después de cuántos pasos.
Conviene tener a la vista qué cambia y qué no respecto de lo que hicieron en Algoritmos.
| En Algoritmos | Aquí | |
|---|---|---|
| Qué se mide | Operaciones de un algoritmo en pseudocódigo | Pasos de una máquina de Turing |
| Qué se clasifica | Algoritmos: mergesort es | Lenguajes: en qué clase está un problema |
| Tamaño de la entrada | Lo que conviene: elementos, vértices | La longitud de la cadena que codifica la entrada |
| P y NP | Presentadas sobre algoritmos, sin modelo fijo | Definidas sobre máquinas, y demostradas robustas |
La segunda fila es el cambio de punto de vista más importante. En Algoritmos el objeto de estudio era un algoritmo, y la pregunta era cuánto tarda. Aquí el objeto es un problema, escrito como lenguaje, y la pregunta es cuánto tarda el mejor algoritmo posible para él. Decir que un lenguaje está en una clase es decir que existe una máquina que lo decide dentro de cierto costo. Decir que no está es afirmar algo sobre todas las máquinas.
El tiempo de una máquina
Un paso de una máquina de Turing es una aplicación de su función de transición : leer el símbolo bajo el cabezal, escribir, mover el cabezal y cambiar de estado. Contar pasos no tiene ninguna ambigüedad, y esa es la ventaja de tener un modelo fijo.
La cantidad de pasos depende de la entrada. Para resumirla en una función se hace lo mismo que en Algoritmos: se agrupan las entradas por su longitud y se toma el peor caso.
Definición. Sea una máquina de Turing determinista que se detiene con todas las entradas. El tiempo de , o su complejidad en tiempo (time complexity), es la función donde
Si el tiempo de es , decimos que corre en tiempo , o que es una máquina de tiempo .
Tres cosas de esta definición que vale la pena leer despacio.
- es la longitud de la cadena de entrada, en símbolos. No es “el número ” que la entrada pueda representar, ni la cantidad de vértices de un grafo. Si la entrada es , es cuántos símbolos tiene esa codificación. Volveremos sobre esto, porque es la fuente del error más frecuente de la semana.
- Es el peor caso. Para cada longitud hay entradas, y es el máximo sobre todas. Una máquina que casi siempre termina rápido y con una sola entrada de cada longitud tarda muchísimo tiene un tiempo grande.
- Solo tiene sentido para decididores. Si no se detiene con alguna entrada, el máximo no existe.
La función exacta suele ser incómoda: depende de detalles de la máquina que no dicen nada del problema. Se usa la notación asintótica de Algoritmos. Recuerden: si existen constantes y tales que para todo . La es una cota superior que ignora las constantes y los valores pequeños de . También usaremos , que significa “a lo sumo para alguna constante ”: aquí la constante está en el exponente, y no se puede sacar.
Con eso se pueden clasificar los lenguajes.
Definición. Sea una función. La clase es el conjunto de los lenguajes que decide alguna máquina de Turing determinista, de una cinta, que corre en tiempo .
Por ejemplo, tiene a todos los lenguajes que se pueden decidir con una cantidad cuadrática de pasos. Como , también tiene a los que se deciden en tiempo lineal: las clases crecen con la función, .
Idea clave. es una clase de lenguajes, no de máquinas. Para demostrar que basta exhibir una máquina. Para demostrar que hay que descartar todas, y eso es mucho más difícil: casi todas las preguntas abiertas de esta parte del curso son de ese tipo.
La definición fija el modelo: determinista y de una cinta. Las dos secciones que siguen muestran por qué hay que fijarlo, y después por qué, para lo que nos interesa, no importa tanto.
Tres máquinas para 0ᵏ1ᵏ
Tomemos un lenguaje que conocen desde la primera semana:
No es regular, así que ningún DFA lo reconoce. Una máquina de Turing sí lo decide, y la de la semana 7 lo hace. ¿En cuánto tiempo? Vamos a ver tres máquinas, cada una más rápida que la anterior, y a contar sus pasos con un simulador.
Antes, un intento que no funciona, para tener claro qué es lo difícil. Lo más rápido que puede hacer una máquina
es leer la entrada una sola vez, de izquierda a derecha: pasos, contando el que lee el primer blanco. El
archivo errors/zeros_ones_one_pass.tm hace eso, recordando en el estado solo si ya empezaron los unos:
$ build/run_tm errors/zeros_ones_one_pass.tm 001
w = 001
  acepta en 4 pasos
Acepta , que no está en . Lo que comprueba es la forma , que es un lenguaje regular. Una máquina que solo avanza y nunca escribe algo que vuelva a leer es un autómata finito, y un autómata finito no puede comparar dos cantidades sin tope. Para decidir hay que volver sobre la cinta.
La máquina cuadrática
La máquina de la semana 7 empareja cada con un . Descripción de implementación:
M1 = "Con la entrada w:
  1. Si el cabezal está sobre un 0, cambiarlo por X. Si está sobre una Y, ir al paso 4.
     Si está sobre un blanco, aceptar. Si está sobre un 1, rechazar.
  2. Avanzar a la derecha, saltando ceros y letras Y, hasta el primer 1. Cambiarlo por Y.
     Si no hay ningún 1, rechazar.
  3. Retroceder hasta la X más cercana, quedar a su derecha, y volver al paso 1.
  4. Avanzar a la derecha saltando letras Y. Si se llega al blanco, aceptar.
     Si aparece otro símbolo, rechazar."
Y su descripción formal, que es el archivo machines/zeros_ones_quadratic.tm. Es la misma máquina que sirve de
ejemplo en code/formats.md. Las casillas vacías llevan a .
El programa run_tm ejecuta una máquina en formato .tm y cuenta sus pasos. Con --watch '*' imprime cada
configuración , con el estado entre corchetes:
$ build/run_tm machines/zeros_ones_quadratic.tm --watch '*' 0011
w = 0011
   [q0] 0011
  X [q1] 011
  X0 [q1] 11
  X [q2] 0Y1
   [q2] X0Y1
  X [q0] 0Y1
  XX [q1] Y1
  XXY [q1] 1
  XX [q2] YY
  X [q2] XYY
  XX [q0] YY
  XXY [q3] Y
  XXYY [q3] _
  XXYY_ [q_accept] _
  acepta en 13 pasos
Son 14 configuraciones y 13 pasos: un paso lleva de cada configuración a la siguiente. Se ven las dos idas y vueltas, una por cada , y el recorrido final sobre las .
¿Cuántos pasos da con ? Se puede contar a mano. Hay rondas, una por cada . En cada ronda:
- lee un y lo marca: 1 paso.
- avanza sobre los símbolos que hay entre esa X y el primer sin marcar (son ceros y letras Y, y siempre suman ): pasos. Después lee el y lo marca: 1 paso.
- retrocede sobre los mismos símbolos, y lee la X: pasos y 1 paso más.
Cada ronda cuesta pasos, y las rondas, . Al final, lee una Y (1 paso), recorre las otras (otros pasos) y lee el blanco (1 paso): pasos más. En total:
Para da , lo que imprimió run_tm. Las pruebas de la semana comprueban la fórmula para
todos los hasta 300.
Esa cuenta es para una entrada particular de cada longitud. El tiempo de la máquina es el máximo sobre todas las entradas, así que falta una cota que valga siempre.
Afirmación. corre en tiempo .
Demostración. Por conteo directo. Sea una entrada de longitud . El cabezal nunca pasa de la celda , porque ningún estado avanza después de leer un blanco. Cada ronda (pasos 1 a 3) cambia un por una X, y nunca se borra una X: hay a lo sumo rondas. En una ronda, solo avanza y solo retrocede, así que la ronda da a lo sumo pasos. El paso 4 solo avanza: a lo sumo pasos. En total, a lo sumo pasos. ∎
Y la cuenta de muestra que la cota no se puede mejorar para esta máquina: con esas entradas da más de pasos. El tiempo de es cuadrático, ni más ni menos. Con eso, .
Tachar uno de cada dos: O(n log n)
es lenta porque cada viaje de ida y vuelta, que cuesta pasos, elimina un solo y un solo . La segunda máquina hace que cada viaje elimine la mitad de los que quedan.
La idea es comparar las dos cantidades sin emparejar los símbolos uno por uno. Supongan que quedan ceros y unos sin tachar. Entonces:
Es cierto porque todo número se escribe como : el cociente y el resto de dividir entre 2 determinan el número. La paridad se puede calcular con dos estados en una sola pasada, y pasar de a también: basta tachar un cero sí y uno no, empezando por el primero. Si había , quedan . Después se repite la pregunta con las mitades.
M2 = "Con la entrada w:
  1. Recorrer la cinta de izquierda a derecha. Si aparece un 0 después de un 1, rechazar.
     Durante el recorrido, tachar un 0 sí y uno no, empezando por el primero sin tachar,
     y lo mismo con los unos. Recordar en el estado la paridad de los ceros y la de
     los unos que estaban sin tachar.
  2. Si en el recorrido no había ningún símbolo sin tachar, aceptar.
  3. Si las dos paridades son distintas, rechazar.
  4. Volver al borde izquierdo y repetir desde el paso 1."
La descripción formal está en machines/zeros_ones_nlogn.tm. Tiene nueve estados además de los dos finales.
| Estado | Qué recuerda |
|---|---|
| Solo se usa en el primer paso: marca la primera celda con , para reconocer después el borde izquierdo | |
| Pasada en curso; todavía no vio ningún símbolo sin tachar | |
| , | Está en los ceros: vio una cantidad impar (), o par y mayor que cero () |
| , , , | Está en los unos: la primera letra es la paridad de los ceros y la segunda la de los unos (e par, o impar) |
| Vuelve al borde izquierdo |
La tabla completa, con X para un símbolo tachado. Las casillas vacías llevan a .
Cómo leerla. Un símbolo se tacha cuando es el primero, el tercero, el quinto de su grupo: es decir, cuando la paridad de los vistos antes era par. Por eso tacha el que lee y lo deja. El primer de la entrada es siempre el primero sin tachar, y en lugar de X recibe la marca , que cumple dos funciones: cuenta como tachado y señala el borde. Al llegar al blanco, la máquina vuelve solo desde , y , los estados donde las dos paridades coinciden; en los demás no hay transición y rechaza. Y en los estados de los unos no hay transición con : un cero después de un uno rechaza.
Con --watch n, run_tm imprime la configuración cada vez que la máquina entra al estado , es
decir, al empezar cada pasada después de la primera. Con cinco ceros y cinco unos:
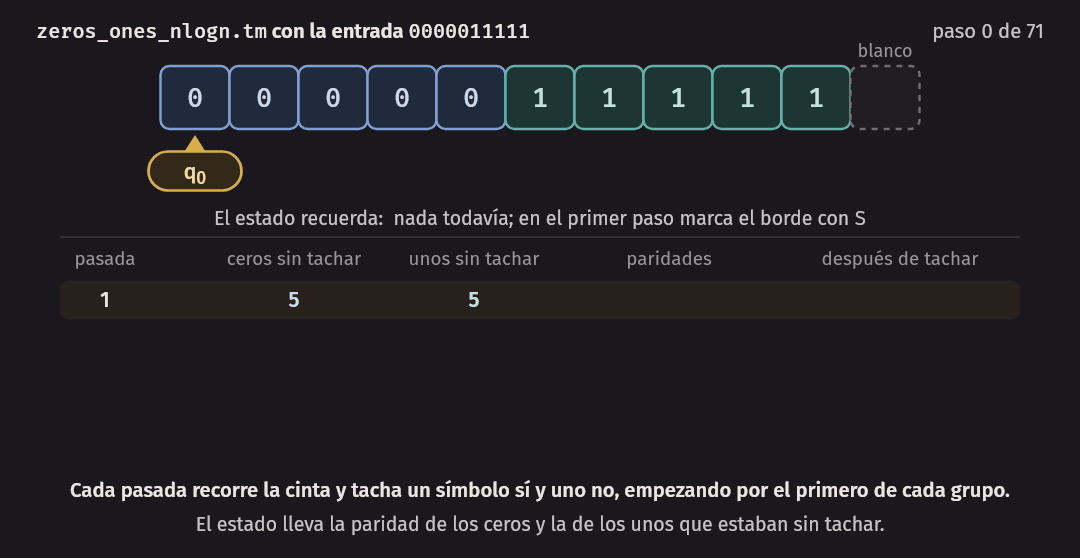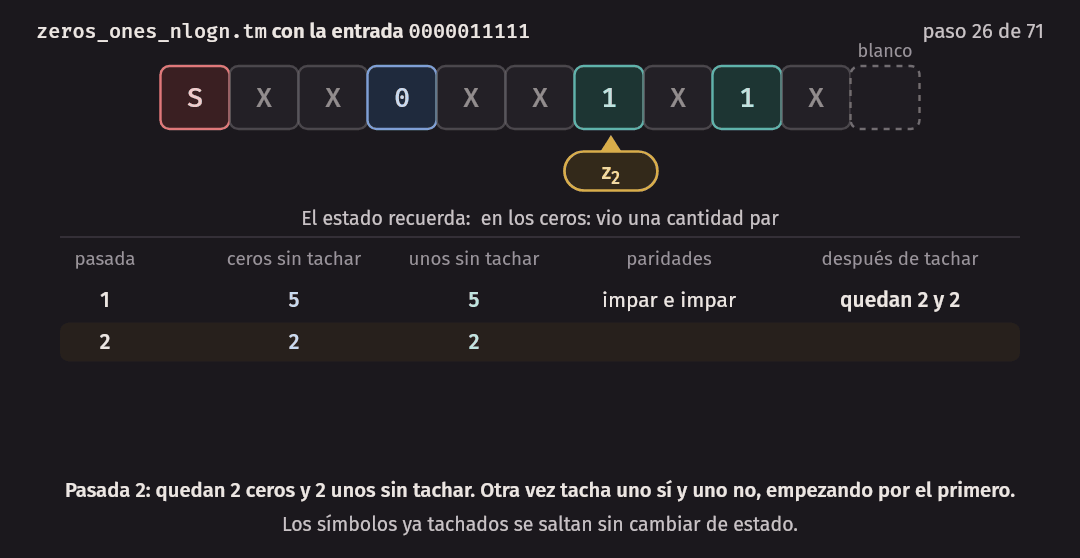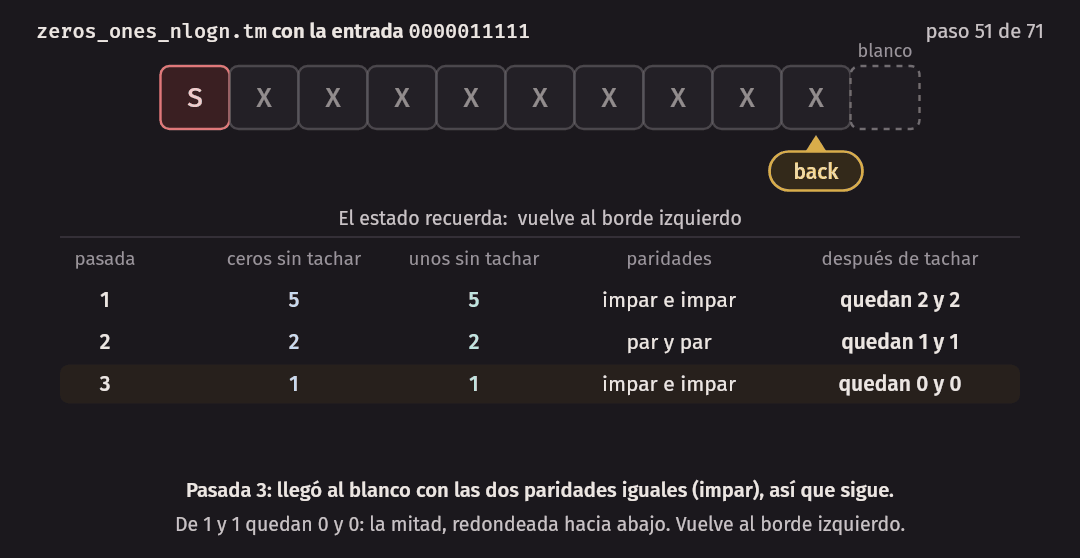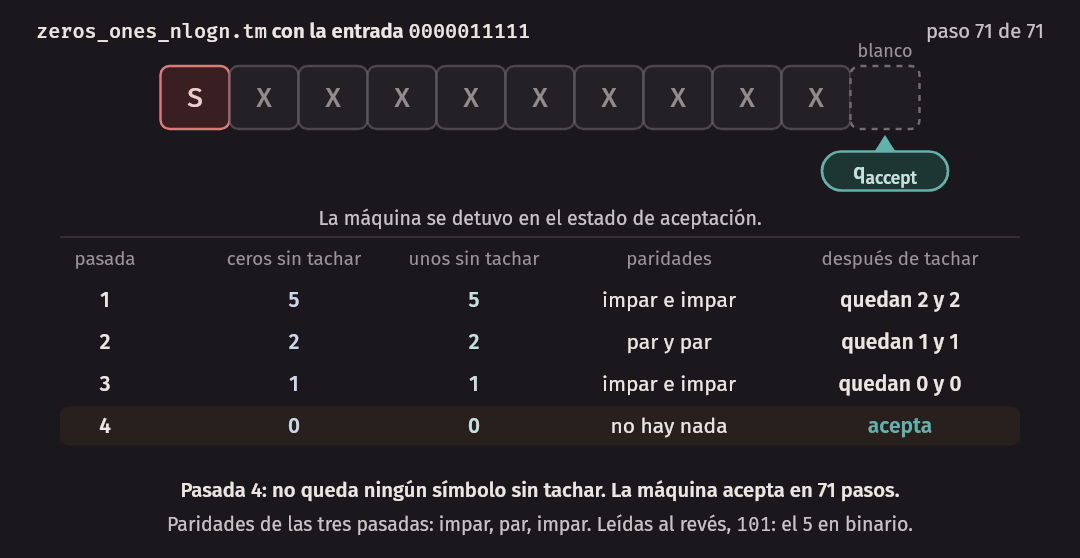
$ build/run_tm machines/zeros_ones_nlogn.tm --watch n 0000011111
w = 0000011111
  S [n] 0X0XX1X1X
  S [n] XX0XXXX1X
  S [n] XXXXXXXXX
  acepta en 71 pasos
Después de la primera pasada quedan 2 ceros y 2 unos sin tachar: . Después de la segunda, 1 y 1. Después de la tercera, ninguno, y la cuarta pasada no encuentra nada y acepta. Las paridades que la máquina vio en las tres pasadas fueron impar, par, impar: leídas al revés son , el número 5 en binario. La máquina compara, sin saberlo, la escritura en binario de la cantidad de ceros con la de unos, un bit por pasada, empezando por el menos significativo.
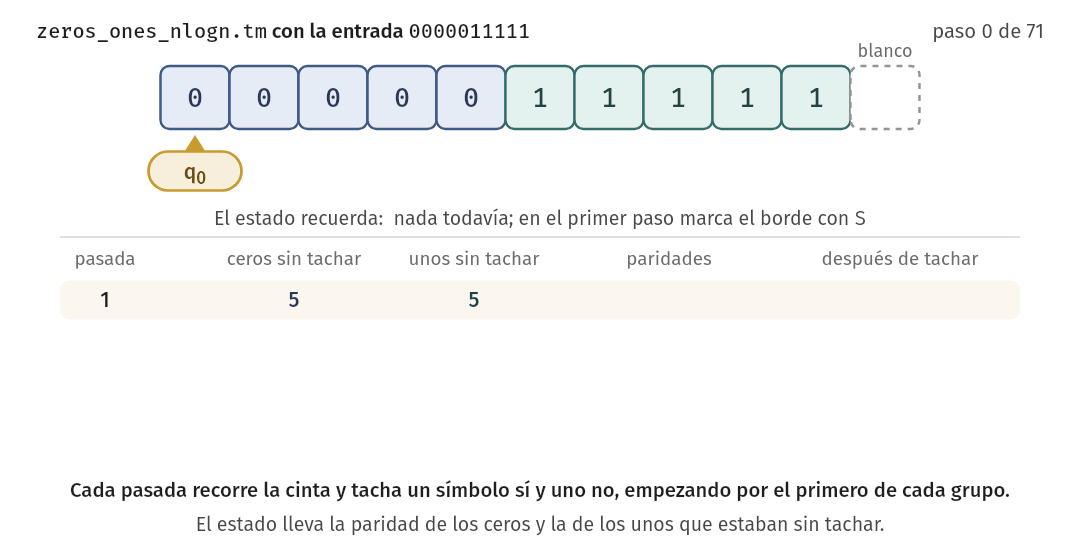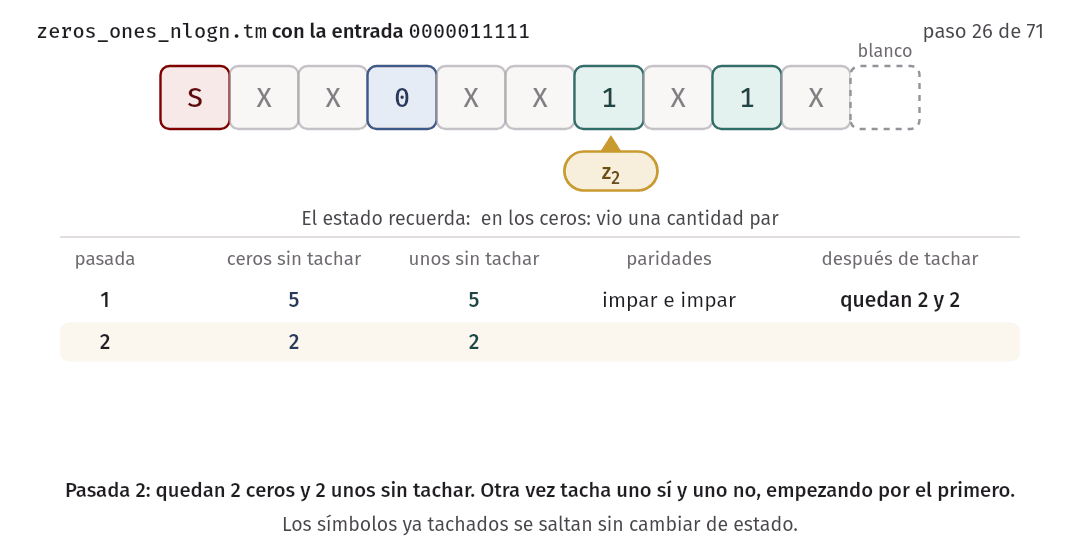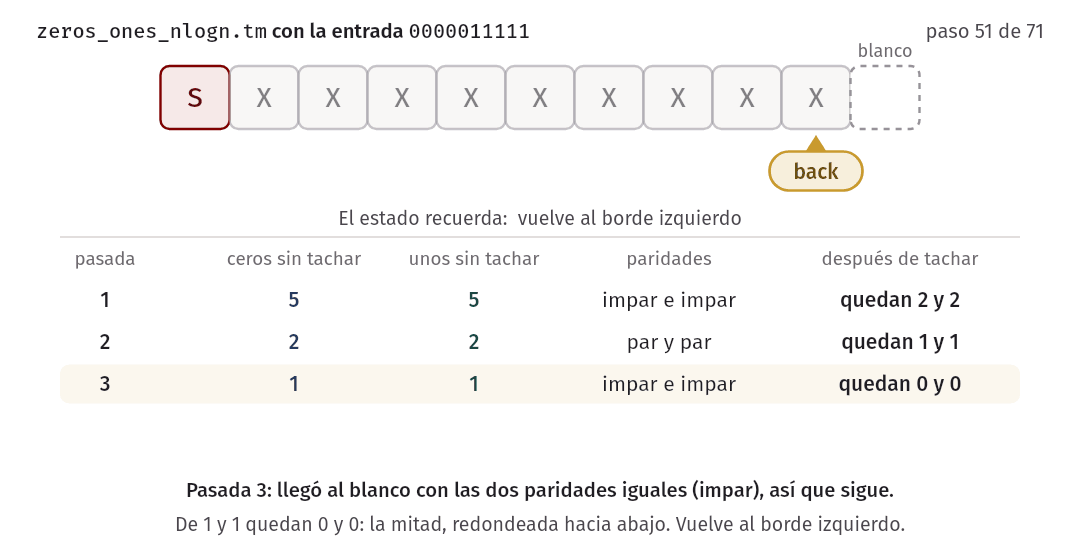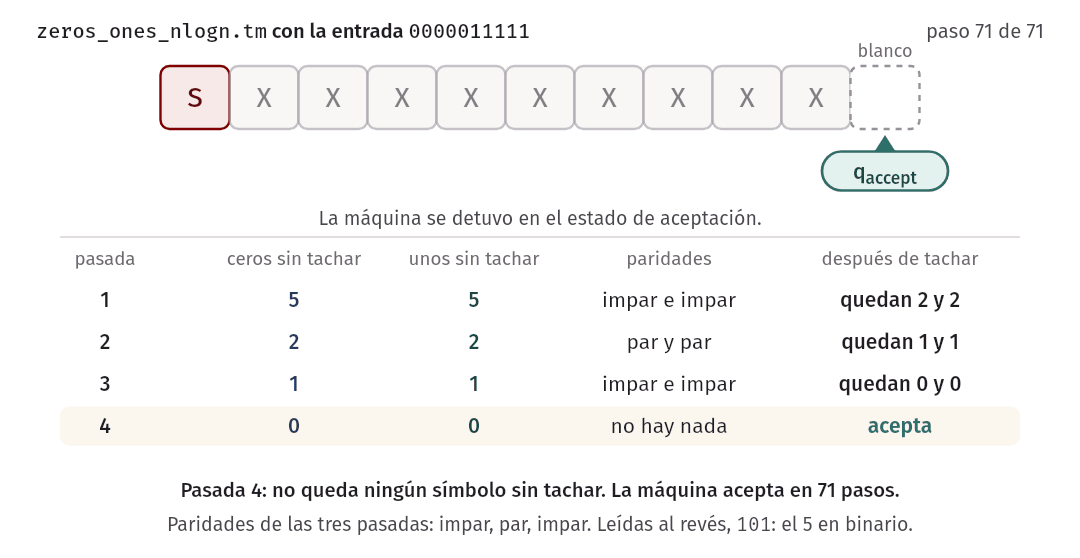
Con cinco ceros y tres unos, la primera pasada ve dos cantidades impares y continúa. La segunda encuentra 2 ceros y 1 uno, y rechaza:
$ build/run_tm machines/zeros_ones_nlogn.tm --watch n 00000111
w = 00000111
  S [n] 0X0XX1X
  rechaza en 25 pasos
Afirmación. decide .
Demostración. Por inducción sobre la cantidad de símbolos sin tachar. Primero la forma: en la primera pasada todos los símbolos están sin tachar, así que cualquier que venga después de un se lee en un estado de los unos y la máquina rechaza. Si la entrada empieza con , rechaza en el primer paso, y es correcto: ninguna cadena de empieza con . Si la entrada pasa de ahí, es de la forma , y tachar símbolos no cambia eso. Queda ver que, si al empezar una pasada hay ceros y unos sin tachar, la máquina termina aceptando si y solo si .
Caso base: . La pasada no encuentra símbolos sin tachar, llega al blanco en el estado (o en , si la entrada es ) y acepta. Es correcto, porque .
Paso inductivo: . Si y tienen distinta paridad, la máquina rechaza al llegar al blanco, y es correcto porque . Si tienen la misma paridad, la pasada deja ceros y unos, que suman menos que . Por hipótesis de inducción, desde ahí la máquina acepta si y solo si , y con paridades iguales eso equivale a , por la equivalencia del comienzo de esta sección. ∎
Afirmación. corre en tiempo .
Demostración. Por conteo. Una pasada completa recorre la cinta hasta el primer blanco y vuelve: a lo sumo pasos. Falta contar las pasadas. Sea la mayor de las dos cantidades y de la entrada; . Después de pasadas que tachan, de la cantidad mayor quedan símbolos, que es 0 en cuanto , es decir, cuando . Después de esas hay a lo sumo una pasada más, la que no encuentra nada. Son a lo sumo pasadas, y
∎
Con la entrada la cuenta se puede hacer exacta, y da
pasos para . Para son , lo que imprimió run_tm. Las pruebas
comprueban esa fórmula, y que la cota de la demostración vale para todas las cadenas de longitud a lo sumo 12.
Entonces . ¿Se puede bajar más con una cinta? No. Se demuestra que todo lenguaje que una máquina de una cinta decide en tiempo estrictamente menor que (en el sentido de la minúscula) es regular, y no lo es. No lo demostraremos, pero conviene saberlo: con una cinta, es lo mejor posible para este lenguaje.
Con dos cintas: O(n)
Con una segunda cinta el problema se vuelve trivial. La máquina copia los ceros a la cinta 2 y después, por cada que lee en la cinta 1, retrocede un en la cinta 2. Los dos cabezales se mueven a la vez, y nadie tiene que cruzar la entrada de ida y vuelta.
M3 = "Con la entrada w en la cinta 1:
  1. Si la entrada es vacía, aceptar. Si empieza con 1, rechazar.
  2. Escribir $ en la primera celda de la cinta 2.
  3. Avanzar en la cinta 1 mientras haya ceros, copiando cada uno a la cinta 2.
  4. Avanzar en la cinta 1 mientras haya unos, retrocediendo una celda en la cinta 2 por
     cada uno. Si aparece un 0, rechazar.
  5. Si la cinta 1 llega al blanco justo cuando la cinta 2 vuelve al $, aceptar.
     Si no, rechazar."
La cinta 2 funciona como la pila del autómata de la semana 6: guarda una marca de fondo y un símbolo por cada
cero. code/formats.md no define un formato para máquinas de varias cintas, así que esta máquina no tiene
archivo: está escrita en C++ en multitape.h, con una función de transición que recibe un símbolo por cinta, y
tres estados además de los finales.
Cada paso avanza el cabezal de la cinta 1, salvo dos: el que escribe la marca $ y el que pasa de copiar a
comparar. Con el paso final que acepta, son a lo sumo pasos. El tiempo de es .
Contar los pasos de verdad
El programa count_steps ejecuta las tres máquinas. Su primera tabla aplica la definición de tiempo al pie de la
letra: para cada longitud hasta 12, prueba las entradas y se queda con el máximo.
$ build/count_steps
Peor caso sobre las 2^n entradas de longitud n: pasos, y la primera entrada que los alcanza
 n   cuadrática            n log n               dos cintas
 0    1  ε                  1  ε                  1  ε
 1    2  0                  2  0                  3  0
 2    5  01                 7  00                 5  01
 3    8  001                4  000                6  001
 4   13  0011              21  0000               7  0001
 5   18  00011              6  00000              8  00001
 6   25  000111            31  000001             9  000001
 7   32  0000111            8  0000000           10  0000001
 8   41  00001111          57  00000000          11  00000001
 9   50  000001111         10  000000000         12  000000001
10   61  0000011111        71  0000000001        13  0000000001
11   72  00000011111       12  00000000000       14  00000000001
12   85  000000111111      85  000000000011      15  000000000001
Vale la pena detenerse en tres cosas.
El peor caso no siempre es una cadena del lenguaje. Para la máquina cuadrática con , la entrada más lenta es , que se rechaza: la máquina hace dos rondas completas y recién en la tercera descubre que falta un uno. En estas longitudes, su tiempo exacto es .
El tiempo no tiene por qué crecer con . La máquina de tarda 57 pasos en el peor caso con y solo 10 con . Con longitud impar, las cantidades de ceros y de unos tienen distinta paridad, y la máquina rechaza al terminar la primera pasada, en a lo sumo pasos. La definición de tiempo no pide que sea creciente, y la notación absorbe estas irregularidades: lo que se afirma es una cota superior.
Varias entradas pueden empatar. Para , la máquina de tarda lo mismo con que con : 4 y 0 tienen la misma paridad, y 2 y 0 también, así que hacen falta tres pasadas para rechazar. La tabla muestra la primera entrada, en orden, que alcanza el máximo.
La segunda tabla usa solo las entradas , para llegar a longitudes grandes:
Pasos con la entrada 0^k 1^k, de longitud n = 2k
    n   cuadrática   pasos/n²    n log n   pasos/(n·log₂ n)   dos cintas
   16          145      0.566        145              2.266           19
   32          545      0.532        353              2.206           35
   64         2113      0.516        833              2.169           67
  128         8321      0.508       1921              2.144          131
  256        33025      0.504       4353              2.125          259
  512       131585      0.502       9729              2.111          515
 1024       525313      0.501      21505              2.100         1027
 2048      2099201      0.500      47105              2.091         2051
 4096      8392705      0.500     102401              2.083         4099
 8192     33562625      0.500     221185              2.077         8195
Con las dos máquinas de una cinta empatan en 145 pasos. Con , la cuadrática da más de 33 millones de pasos y la otra 221 185: unas 150 veces menos. Cada vez que se duplica, la primera columna se multiplica por casi 4 y la tercera por algo más de 2. Las columnas de cocientes confirman las dos fórmulas: la primera tiende a , y la segunda baja despacio hacia 2. La máquina de dos cintas da siempre pasos.
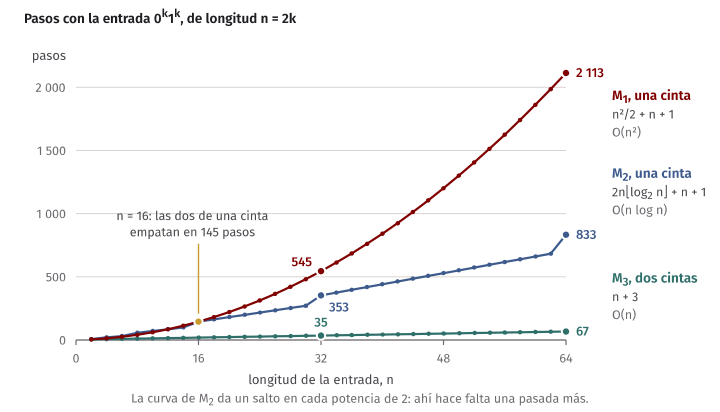
Son conteos de pasos y no tiempos de reloj: salen iguales en cualquier computadora.
Idea clave. Para un mismo lenguaje, el costo depende del modelo: es lo mejor con una cinta, y con dos se llega a . En computabilidad esto no pasaba: todos los modelos razonables decidían los mismos lenguajes. En complejidad, el modelo cambia el exponente.
El modelo importa, pero solo polinomialmente
Si la clase depende de cuántas cintas tiene la máquina, ¿sirve de algo una teoría construida sobre un modelo tan arbitrario? Sirve, porque la diferencia entre modelos está acotada. En la semana 7 vieron que una máquina de una cinta simula a una de varias, y contaron sus pasos. Ahora lo decimos en función de .
Teorema. Sea una función con . Toda máquina de Turing de varias cintas que corre en tiempo tiene una máquina equivalente de una cinta que corre en tiempo .
La condición solo descarta máquinas que no alcanzan a leer su entrada.
Demostración. Por construcción: es la simulación de la semana 7, con el mismo conteo de pasos, que repasamos.
Qué se construye. Sea una máquina de cintas que corre en tiempo . La máquina , de una cinta, guarda en su cinta el contenido de las cintas de , una después de otra, separadas por el símbolo . En cada tramo, un símbolo lleva una marca: es la posición del cabezal de en esa cinta.
cintas de M:    0 1 [1] 0 _ ...        a [b] _ ...        [_] ...
cinta de S: # 0 1 1' 0 # a b' # _' # (la comilla es la marca del cabezal)trabaja así:
S = "Con la entrada w:
  1. Dar a la cinta el formato inicial: # w con su primer símbolo marcado, y después
     k − 1 tramos con un solo blanco marcado, cada uno cerrado por #.
  2. Para simular un paso de M: recorrer la cinta desde el primer # hasta el último,
     recordando en el estado los k símbolos marcados.
  3. Volver al inicio y recorrer otra vez, aplicando la transición de M en cada tramo:
     escribir el símbolo nuevo y mover la marca una celda.
  4. Si una marca debe pasar a la derecha del último símbolo de su tramo, cae sobre un #.
     En ese caso, escribir ahí un blanco marcado y desplazar una celda a la derecha
     todo lo que sigue, hasta el último #.
  5. Si M entra a su estado de aceptación, aceptar; si entra al de rechazo, rechazar.
     Si no, repetir desde el paso 2."
Por qué es equivalente. Es lo que se demostró en la semana 7: después de simular cada paso, la cinta de describe exactamente las cintas y los cabezales de . acepta, rechaza o sigue según lo haga .
Cuánto cuesta. Todo depende de qué tan larga es la parte usada de la cinta de .
- En pasos, cada cabezal de se aleja a lo sumo celdas del inicio de su cinta. La cinta 1 tiene además la entrada, de longitud . Así que cada tramo tiene a lo sumo celdas, y la parte usada de la cinta de tiene a lo sumo celdas. Como es una constante de , eso es .
- El paso 1 cuesta : hay que correr la entrada una celda para poner el primer , llevando cada símbolo en el estado, y escribir los otros tramos. Como , es .
- Simular un paso de cuesta dos recorridos de la parte usada, cada uno, más a lo sumo desplazamientos, uno por cinta, y cada desplazamiento recorre a lo sumo la parte usada: cada uno. En total, un paso de cuesta pasos de .
- da a lo sumo pasos.
Sumando:
∎
El cuadrado sale de multiplicar dos cosas que crecen con : la cantidad de pasos simulados, y la longitud de cinta que recorre para simular cada uno. La máquina de varias cintas tiene sus cabezales donde los necesita, y la de una cinta tiene que ir a buscarlos.
El teorema da una cota superior y no dice que la simulación sea la mejor manera de pasar a una cinta. Para nuestro lenguaje , la máquina de dos cintas corre en y el teorema promete una de una cinta en ; ya vimos que existe una mejor, en .
La clase P
Entre y hay una diferencia enorme si uno compara algoritmos. Pero hay una propiedad que el cuadrado no rompe: si es un polinomio, también lo es.
Definición. es la clase de los lenguajes que una máquina de Turing determinista de una cinta decide en tiempo polinomial:
Un lenguaje está en P si para algún fijo hay una máquina que lo decide en tiempo . El exponente puede ser cualquiera, pero no depende de la entrada.
Corolario. P es la misma clase si se define con máquinas de varias cintas.
Demostración. Si una máquina de una cinta decide en tiempo , ella misma es una máquina de varias cintas que no usa las demás. En la otra dirección, si una máquina de cintas decide en tiempo , con , el teorema anterior da una de una cinta en tiempo , que sigue siendo polinomial. ∎
Esto es lo que responde la primera pregunta de repaso de la guía: la cota que se usa es , y lo que importa de ella es que el cuadrado de un polinomio es un polinomio.
Lo mismo pasa con los demás modelos deterministas que conocen. Una máquina con la cinta infinita en los dos sentidos, una con una cinta de dos dimensiones, una computadora con memoria de acceso directo, un programa en C++: cada uno se puede simular en una máquina de Turing de una cinta de modo que pasos del modelo cuesten a lo sumo pasos de la máquina, para alguna constante que depende del modelo y no de la entrada. Se dice que esos modelos son polinomialmente equivalentes. No es un teorema, porque “modelo razonable” no tiene una definición: es una observación que se ha comprobado con cada modelo determinista propuesto hasta hoy, del mismo modo que la tesis de Church-Turing.
Hay una condición escondida en la palabra “razonable”: el modelo no puede hacer en un paso una cantidad de trabajo que crezca sin control. Una computadora idealizada que multiplica en un solo paso dos números de cualquier tamaño no es razonable: elevando al cuadrado veces fabrica un número de bits en pasos. En los modelos razonables, una operación sobre números cuesta según la cantidad de bits que tienen.
Idea clave. P no depende del modelo determinista que se use para definirla. Por eso desde ahora se puede volver a escribir en alto nivel: para mostrar que un lenguaje está en P no hace falta dar la tabla de una máquina de una cinta. Basta un algoritmo y una cuenta de que es polinomial.
Cómo se demuestra que un lenguaje está en P
Desde aquí, las máquinas se describen otra vez en alto nivel, como desde la semana 9, y se agrega el análisis del tiempo. Para mostrar que un algoritmo corre en tiempo polinomial hay que comprobar tres cosas.
- La cantidad de etapas es polinomial en la longitud de la entrada, contando las repeticiones de los ciclos.
- Cada etapa se puede hacer en tiempo polinomial en un modelo determinista razonable. Recorrer la entrada, comparar dos números, buscar un arco en una lista: todo eso es polinomial.
- La entrada está codificada de una manera razonable, que es el tema de la sección siguiente.
Funciona porque los polinomios son cerrados bajo las operaciones que aparecen: la suma, el producto y la composición de dos polinomios son polinomios. Una cantidad polinomial de etapas, cada una de costo polinomial, da un costo polinomial.
¿Por qué “polinomial” como sinónimo de “tratable”? No porque sea rápido. Las razones son tres. Primera, la que acabamos de ver: es la clase más pequeña que contiene al tiempo lineal y no cambia al cambiar de modelo. Segunda, es cerrada por composición: un algoritmo polinomial que llama a subrutinas polinomiales sigue siendo polinomial, y eso es lo que hará funcionar a las reducciones de la semana 13. Tercera, una observación empírica: los problemas naturales que están en P casi siempre terminan con algoritmos de exponente pequeño, y la diferencia entre polinomial y exponencial es la que en la práctica separa lo que se puede calcular de lo que no. Con , es un millón y tiene 31 dígitos.
La codificación de la entrada
El tiempo se mide contra la longitud de la cadena de entrada. Entonces importa cómo se escriben los objetos como cadenas. En la semana 7 se introdujo la notación para la codificación de un grafo y para la de una máquina, y se dijo que cualquier codificación servía. Para la computabilidad es verdad. Para el tiempo hay que pedir un poco más: que la codificación sea razonable, es decir, que no infle la entrada.
Para casi todos los objetos, todas las codificaciones naturales dan longitudes parecidas, y la elección no cambia nada.
- Un grafo de vértices se puede escribir como matriz de adyacencia, con bits, o como lista de arcos, con a lo sumo pares de números de bits. Cada longitud está acotada por un polinomio en la otra, y las dos están entre y un polinomio en . Por eso, para grafos, “polinomial en la longitud de ” y “polinomial en la cantidad de vértices” son lo mismo, y se puede seguir contando en vértices y arcos como en Algoritmos. Vértice y nodo son lo mismo, y un arco es una arista con dirección; las semanas 13 y 14 dicen nodo y arista también para los grafos dirigidos.
- Una fórmula, una gramática, un autómata: lo mismo. Su longitud es, salvo un factor logarítmico por los nombres, la cantidad de símbolos que uno escribe en el papel.
Hay un objeto con el que sí hay que tener cuidado: los números.
Binario y unario
Un número se puede escribir en binario, con bits, o en unario, con
palotes: el 5 como . La primera tabla de encoding_demo compara:
$ build/encoding_demo
Un número x, en binario y en unario
        x   en binario             bits   símbolos en unario
        5   101                       3                    5
       12   1100                      4                   12
      100   1100100                   7                  100
     1000   1111101000               10                 1000
  1000000   11110100001001000000     20              1000000
La escritura en unario es exponencialmente más larga que la binaria: un número de bits vale hasta . Entre binario, decimal y cualquier otra base mayor que 1 no hay ese problema, porque las longitudes difieren en un factor constante: .
La convención de este curso, y de toda la teoría de la complejidad, es:
Los números se escriben en binario. La longitud de un número en la entrada es , aproximadamente .
La consecuencia sorprende la primera vez. Un algoritmo que recibe el número y da ” pasos” no es de tiempo lineal: es de tiempo exponencial. Su entrada mide símbolos, y da pasos.
El ejemplo clásico es decidir si un número es primo probando divisores. El lenguaje es
y el algoritmo prueba mientras . Si es primo, hace divisiones. La segunda tabla del programa lo ejecuta con el mayor primo de bits, para varios :
¿Es primo x? Divisiones de prueba hasta la raíz, con el mayor primo de b bits
 b                  x    divisiones
 8                251            14
16              65521           254
24           16777213          4094
32         4294967291         65534
40      1099511627689       1048574
La entrada crece de 8 en 8 bits, y las divisiones se multiplican por 16 cada vez. Un número de bits es cercano a , su raíz a , y . La cantidad de divisiones es , con la longitud de la entrada: exponencial. Con un número de 2048 bits, como los que se usan en criptografía, serían unas divisiones.
Es la segunda pregunta de repaso de la guía. ¿Es polinomial probar divisores hasta ? Es polinomial en el valor de , y hasta mejor: es . Pero no es polinomial en la longitud de la entrada, que es lo que cuenta. (Que este algoritmo sea exponencial no dice que el problema sea difícil: en 2002, Agrawal, Kayal y Saxena demostraron que está en P, con un algoritmo completamente distinto.)
Error común. Medir el tiempo en función del valor de un número de la entrada, y no de la longitud de su representación. “El ciclo da vueltas, así que es lineal” es falso si es un número de la entrada: la entrada tiene símbolos, y vueltas son exponenciales en eso. Antes de decir “polinomial”, pregunten: ¿polinomial en qué?
Pseudopolinomial: la mochila otra vez
En Algoritmos resolvieron la mochila 0/1 con programación dinámica, en tiempo , donde es la cantidad de objetos y la capacidad. Allá se dijo que ese costo “parece polinomial y no lo es”, y se le dio un nombre: pseudopolinomial. Con la definición de esta semana se ve exactamente por qué.
Tomemos un pariente más simple de la mochila, que usaremos toda la semana. En suma de subconjuntos hay una lista de números positivos y un objetivo , y se pregunta si algunos de los números suman exactamente :
La programación dinámica es la misma de la mochila: una tabla que dice, para cada suma de 0 a , si se
puede alcanzar con los números vistos hasta ahora. Son casillas. La tercera tabla de
encoding_demo toma 10 números de bits y como objetivo la mitad de su suma, y cuenta las casillas:
SUBSET-SUM con la tabla de Algoritmos: 10 números de b bits, objetivo la mitad de la suma
 b   bits de la entrada   casillas de la tabla
 4                   46                    550
 8                   90                   8730
12                  134                 139530
16                  178                2232330
La cantidad de números no cambia: siempre son 10. Solo cambia cuántos bits tiene cada uno. La entrada crece de 46 a 178 bits, menos de 4 veces, y la tabla crece 4000 veces: se multiplica por 16 cada vez que los números ganan 4 bits. Con números de 64 bits, la entrada tendría unos 700 bits y la tabla más de casillas.
La cuenta general: si los números tienen bits, la entrada mide unos bits, y puede valer hasta . La tabla tiene unas casillas: polinomial en , exponencial en .
Definición. Un algoritmo es de tiempo pseudopolinomial si su tiempo es polinomial en la longitud de la entrada y en el valor de los números que contiene. Dicho de otro modo: sería polinomial si los números se escribieran en unario.
El algoritmo de la tabla es pseudopolinomial. Si los números vinieran en unario, la entrada mediría más de símbolos, porque el propio ocuparía palotes, y más de , y las casillas serían menos que el cuadrado de su longitud. Es decir: suma de subconjuntos con los números en unario está en P, y con los números en binario no se sabe. La codificación cambió la clase del problema.
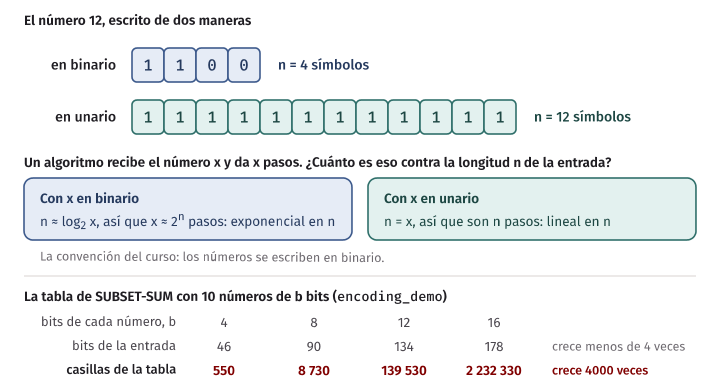
Esto responde una pregunta que quedó de Algoritmos: si la mochila se resuelve en y la mochila es NP-completa, ¿por qué eso no demuestra que ? Porque no es tiempo polinomial en la longitud de la entrada.
En la práctica. Pseudopolinomial no quiere decir inútil. Si los números de la entrada son pequeños (capacidades de unos miles, montos en céntimos), la tabla es la mejor herramienta. El adjetivo avisa de qué depende: de la magnitud de los números, y no de cuántos son.
Dos problemas en P: PATH y los lenguajes libres de contexto
Dos ejemplos con el patrón completo: un intento que no es polinomial, el algoritmo que sí lo es, y la cuenta.
PATH
El intento que no sirve. Probar todos los caminos posibles. Si tiene vértices, un camino sin vértices repetidos es una secuencia de a lo sumo vértices, y hay del orden de secuencias. Revisarlas todas es exponencial.
El algoritmo. El de Algoritmos: marcar lo alcanzable. No hace falta la cola de la búsqueda en anchura, porque aquí no importa ser lineal, solo polinomial.
M = "Con la entrada ⟨G, s, t⟩, donde G es un grafo dirigido con los vértices s y t:
  1. Marcar el vértice s.
  2. Repetir hasta que no se marque ningún vértice nuevo:
  3.     Recorrer todos los arcos de G. Si un arco (a, b) va de un vértice marcado
         a uno sin marcar, marcar b.
  4. Si t está marcado, aceptar. Si no, rechazar."
Es correcto. Un vértice queda marcado si y solo si hay un camino de a él. Todo vértice marcado es alcanzable, por inducción sobre el momento en que se marca: lo es, y se marca por un arco desde un vértice que ya era alcanzable. Y todo vértice alcanzable queda marcado, por inducción sobre la longitud del camino: si el último arco del camino es y quedó marcado, el ciclo no puede terminar con sin marcar.
Es polinomial. Las etapas 1 y 4 se ejecutan una vez. La etapa 3 se repite a lo sumo veces: cada repetición, salvo la última, marca al menos un vértice nuevo, y hay vértices. Cada repetición recorre todos los arcos, que son a lo sumo , y para cada uno consulta y cambia marcas, que en una máquina de Turing es recorrer la cinta: polinomial. Una cantidad polinomial de etapas, cada una polinomial. Entonces .
La máquina de Turing que hace esto es mucho más lenta que la búsqueda en anchura de Algoritmos, que es en una computadora real. No importa: para estar en P solo hace falta algún polinomio.
Todo lenguaje libre de contexto está en P
Teorema. Todo lenguaje libre de contexto está en P.
Demostración. Por construcción de un decididor: el algoritmo CYK de la semana 5. Sea un lenguaje libre de contexto. Tiene una gramática en forma normal de Chomsky, donde cada regla es o , más si la cadena vacía está en .
El intento que no sirve. En la semana 9 se usó el teorema de la semana 5: en forma normal de Chomsky, una derivación de una cadena de longitud tiene exactamente pasos, y eso bastó para decidir : se prueban todas las derivaciones de esa longitud. Para decidir alcanza, pero cada paso puede elegir entre varias reglas, y la cantidad de derivaciones crece exponencialmente con .
El algoritmo. Programación dinámica sobre las subcadenas. es el conjunto de las variables que generan la subcadena de que va de la posición a la .
algoritmo cyk(w, G)
    n ← |w|
    si n = 0 entonces
        devolver (S → ε es una regla de G)
    fin si
    para i desde 0 hasta n − 1
        T[i][i] ← { A : A → w[i] es una regla de G }
    fin para
    para l desde 2 hasta n                      // l es la longitud de la subcadena
        para i desde 0 hasta n − l
            j ← i + l − 1
            T[i][j] ← ∅
            para k desde i hasta j − 1          // la subcadena se parte después de la posición k
                para cada regla A → BC de G
                    si B ∈ T[i][k] y C ∈ T[k + 1][j] entonces
                        agregar A a T[i][j]
                    fin si
                fin para
            fin para
        fin para
    fin para
    devolver (S ∈ T[0][n − 1])
fin algoritmo
Es correcto. Es lo que se demostró en la semana 5: una variable genera una subcadena de longitud al menos 2 si y solo si alguna regla la parte en dos trozos, con generando el primero y el segundo.
Es polinomial. Hay tres ciclos anidados sobre posiciones, cada uno de a lo sumo vueltas, y uno sobre las reglas. El punto fino es este último: la gramática no es parte de la entrada. es un lenguaje fijo, es una gramática fija para él, y la cantidad de reglas es una constante. La entrada es solo . El algoritmo hace operaciones sobre la tabla, cada una polinomial en una máquina de Turing. Entonces . ∎
Con esto, las clases de las dos primeras partes del curso quedan ubicadas dentro de la cuarta: todo lenguaje regular se decide en tiempo lineal, con un DFA, y todo lenguaje libre de contexto, en tiempo polinomial.
La segunda inclusión es estricta porque no es libre de contexto, y una máquina lo decide en tiempo polinomial con la misma idea de .
El no determinismo parece costar caro
Queda la otra variante de la semana 7: la máquina no determinista. Primero hay que decir qué es su tiempo.
Definición. Sea una máquina de Turing no determinista que es un decididor: con toda entrada, todas las ramas de su ejecución se detienen. El tiempo de es la función que da el máximo número de pasos de cualquier rama, con cualquier entrada de longitud .
Es la profundidad máxima del árbol de ejecuciones. No cuenta cuántas ramas hay: una máquina no determinista de tiempo puede tener ramas, cada una de pasos.
Recuerden cuándo acepta: acepta si alguna rama termina en , y la rechaza si todas terminan en .
Teorema. Sea una función con . Toda máquina de Turing no determinista de una cinta que corre en tiempo tiene una máquina determinista de una cinta equivalente que corre en tiempo .
Demostración. Por construcción: una variante de la simulación de la semana 7, que recorre el árbol de ejecuciones por niveles. Allí la máquina guardaba una cola de configuraciones. Aquí guarda solo la lista de decisiones que lleva a cada nodo, que es más fácil de contar.
Sea la máquina no determinista y la mayor cantidad de opciones que su función de transición ofrece en algún par de estado y símbolo. Con una entrada de longitud :
- El árbol de ejecuciones tiene profundidad a lo sumo , y cada nodo tiene a lo sumo hijos. Tiene a lo sumo hojas, y en total a lo sumo nodos, cuando .
- La simulación visita los nodos por niveles, y para llegar a un nodo vuelve a ejecutar desde la raíz siguiendo la lista de decisiones que lleva a él: pasos por nodo.
El total es . Para ponerlo en la forma del enunciado:
porque es una constante y . Esa simulación se describe con varias cintas: una para la entrada, una para la cinta de y una para la lista de decisiones. Por el teorema anterior, pasar a una cinta eleva el tiempo al cuadrado, y : el cuadrado solo duplica la constante del exponente. ∎
Comparen los dos teoremas de simulación.
| De | A una cinta determinista | Un polinomio se vuelve |
|---|---|---|
| Varias cintas, tiempo | Otro polinomio | |
| No determinista, tiempo | Una exponencial |
El primero dice que agregar cintas no saca de P. El segundo no dice lo mismo del no determinismo: la única simulación que conocemos convierte tiempo polinomial en tiempo exponencial. Es solo una cota superior. Nadie ha demostrado que haga falta tanto, y nadie ha encontrado una simulación mejor. La distancia entre esas dos cosas es la pregunta contra , y es el tema de la sesión B.
Idea clave. Las máquinas de varias cintas y las de una cinta son polinomialmente equivalentes. Las deterministas y las no deterministas, no se sabe. Por eso la definición de P dice “determinista”, y la clase que se obtiene quitando esa palabra recibe otro nombre.
Encontrar frente a comprobar
Un camino hamiltoniano en un grafo dirigido es un camino que pasa por cada vértice exactamente una vez.
Se parece a , y cambia una sola palabra: el camino tiene que pasar por todos los vértices. Con ese cambio, la idea de marcar lo alcanzable ya no sirve, y nadie conoce un algoritmo de tiempo polinomial. Todos los que se conocen tardan tiempo exponencial. El más directo prueba los ordenamientos de los vértices, y un grafo de vértices tiene ordenamientos.
Pero tiene una propiedad que lo distingue de un problema arbitrario. Si alguien les entrega un camino hamiltoniano, comprobar que lo es resulta fácil: se revisa que estén todos los vértices, que no se repita ninguno, que empiece en , que termine en y que cada paso siga un arco del grafo. Eso es tiempo polinomial, sin duda.
El programa verify_demo lo hace con un grafo de 5 vértices:
$ build/verify_demo
HAMPATH: grafo dirigido con 5 vértices y los arcos
  1→2 2→3 3→4 4→5 1→3 3→2 2→4 5→1
  s = 1, t = 5
  c = 1 2 3 4 5     válido
  c = 1 3 2 4 5     válido
  c = 1 3 4 5       inválido   tiene 4 vértices y no 5
  c = 1 2 2 4 5     inválido   repite el vértice 2
  c = 1 2 3 4 6     inválido   el vértice 6 no existe
  c = 1 2 4 3 5     inválido   no hay arco 4→3
  c = 2 3 4 5 1     inválido   es un camino hamiltoniano, pero no de s a t
Hay 120 ordenamientos de 5 vértices, y solo esos dos son caminos hamiltonianos de 1 a 5. Quien busca tiene que dar con uno de los dos. Quien comprueba solo mira la lista que recibió.
Esa asimetría entre encontrar una solución y comprobar una que ya está escrita es la idea de la clase NP. La conocen de la vida diaria: resolver un sudoku lleva un rato, y revisar uno resuelto, un minuto. En Algoritmos la usaron con el nombre de certificado. Ahora va la definición precisa.
Verificadores y la clase NP
Definición. Un verificador (verifier) de un lenguaje es un algoritmo tal que
La cadena es un certificado (certificate) de que . El tiempo de un verificador se mide solo en función de la longitud de . Un verificador de tiempo polinomial corre en tiempo polinomial en .
Definición. es la clase de los lenguajes que tienen un verificador de tiempo polinomial.
La definición es corta y cada parte hace falta. Léanla como dos condiciones sobre , que tienen nombre propio:
- Completitud. Si , existe algún certificado con el que acepta .
- Solidez. Si , rechaza para toda cadena . Ningún certificado, por ingenioso o mal formado que sea, lo convence.
Y tres observaciones.
El verificador no confía en el certificado. es una cadena cualquiera: puede ser basura, puede estar armada por alguien que quiere engañar. Si el verificador de no revisara que los vértices no se repiten, aceptaría una lista que da vueltas por el mismo ciclo, para un grafo que no tiene ningún camino hamiltoniano, y dejaría de ser un verificador de ese lenguaje.
El certificado es corto. El tiempo se mide en , así que un verificador de tiempo polinomial da a lo sumo pasos, para algún polinomio . En ese tiempo no puede leer más de símbolos de . Si existe un certificado, existe uno de longitud a lo sumo : los certificados de un problema de NP tienen longitud polinomial. Un “certificado” que lista todos los caminos del grafo no cuenta.
El verificador no dice de dónde sale el certificado. La definición solo pide que exista. No hay ningún algoritmo que lo produzca, y esa es toda la gracia: NP describe los problemas donde una respuesta “sí” se puede justificar brevemente, aunque no sepamos hallar la justificación.
Idea clave. Un lenguaje está en NP si sus respuestas “sí” tienen demostraciones cortas que se comprueban rápido. El certificado es la demostración, y el verificador, quien la revisa.
Error común. Dar como “verificador” un algoritmo que busca la solución. Un programa que recibe un grafo, prueba todos los ordenamientos y responde si alguno es un camino hamiltoniano decide , pero no es un verificador de tiempo polinomial: no usa ningún certificado y tarda tiempo exponencial. El verificador recibe el certificado como parte de su entrada y solo comprueba. Si en su descripción aparece “para cada subconjunto” o “probar todas las asignaciones”, no es un verificador.
Cinco problemas de NP y sus certificados
Para mostrar que un lenguaje está en NP se dan tres cosas: qué es el certificado, qué hace el verificador, y por
qué corre en tiempo polinomial. Cinco ejemplos. Los cinco están programados en verifiers.h, y la salida de
verify_demo que se copia en cada uno sigue a la de la sección anterior.
HAMPATH
- Certificado: una lista de vértices .
- Verificador:
V = "Con la entrada ⟨⟨G, s, t⟩, c⟩, donde G tiene m vértices:
  1. Comprobar que c es una lista de exactamente m vértices de G.
  2. Comprobar que ningún vértice se repite en la lista.
  3. Comprobar que el primero es s y el último es t.
  4. Para cada par de vértices consecutivos de la lista, comprobar que G tiene
     el arco del primero al segundo.
5. Si todas las comprobaciones pasan, aceptar. Si alguna falla, rechazar."- Tiempo: el paso 2 compara a lo sumo pares y el paso 4 busca arcos en una lista de a lo sumo . Polinomial en , y por lo tanto en la longitud de .
- Tamaño del certificado: vértices, cada uno un número de bits.
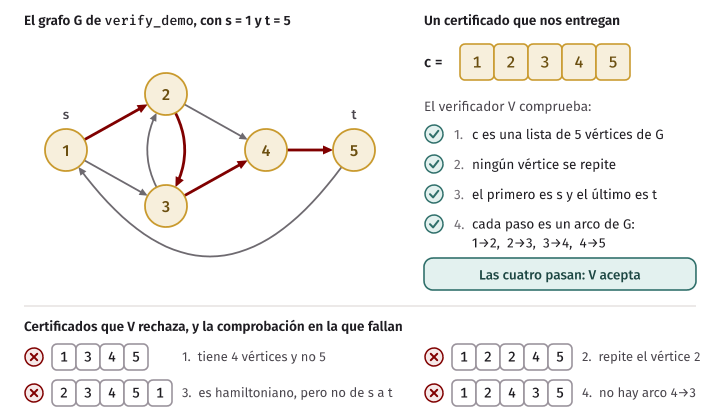
Por qué es un verificador de . Si tiene un camino hamiltoniano de a , la lista de sus vértices pasa las cuatro comprobaciones. Y si alguna lista las pasa, esa lista es un camino hamiltoniano de a : tiene todos los vértices, una vez cada uno, y sus pasos son arcos. Las dos direcciones juntas dicen que acepta algún certificado exactamente cuando está en el lenguaje.
CLIQUE
Un clique de un grafo no dirigido es un conjunto de vértices unidos todos entre sí.
- Certificado: una lista de vértices.
- Verificador: comprobar que son vértices de , que son distintos, y que para cada par de ellos tiene la arista que los une. Aceptar si todo pasa.
- Tiempo: hay pares, con , y cada uno se busca en la lista de aristas. Polinomial. Es la tercera pregunta de repaso de la guía.
CLIQUE: grafo no dirigido con 6 vértices y las aristas
  1-2 1-3 1-4 2-3 2-4 3-4 4-5 5-6
  k = 4
  c = 1 2 3 4       válido
  c = 4 2 1 3       válido   el orden no importa
  c = 1 2 3 5       inválido   falta la arista 1-5
  c = 1 2 3 3       inválido   repite el vértice 3
  c = 1 2 3         inválido   son 3 vértices y se pedían 4
Un detalle sobre el número : forma parte de la entrada, y el verificador revisa pares. ¿No es eso “polinomial en el valor de un número”? Aquí no hay problema, porque un clique no puede tener más vértices que el grafo: si el verificador rechaza sin mirar nada, y si , entonces está acotado por la longitud de la entrada.
SUBSET-SUM
- Certificado: las posiciones de los números elegidos.
- Verificador: comprobar que las posiciones existen y son distintas, sumar los números de esas posiciones y comparar con .
- Tiempo: a lo sumo sumas de números de la entrada. Sumar dos números de bits cuesta : polinomial en la longitud, sin ninguna tabla que dependa del valor de .
SUBSET-SUM: los números 8 13 21 5 17 2, objetivo 28. El certificado son posiciones.
  c = 1 2 4 6       válido   8 + 13 + 5 + 2 = 28
  c = 3 4 6         válido   21 + 5 + 2 = 28
  c = 1 3           inválido   8 + 21 = 29
  c = 4 4 4 2       inválido   5 + 5 + 5 + 13 = 28, pero repite la posición 4
  c = 1 2 4 7       inválido   no hay posición 7
El cuarto certificado muestra por qué hay que revisar las repeticiones. Con los mismos números y objetivo 4 no hay solución: ningún subconjunto suma 4. Pero un verificador descuidado, que solo suma, aceptaría el certificado “posición 6, posición 6”, porque . Estaría aceptando un certificado para una instancia que no está en el lenguaje: dejaría de cumplir la solidez.
Comparen con la sección sobre la mochila. La tabla de Algoritmos decide el problema en tiempo pseudopolinomial. El verificador comprueba un certificado en tiempo polinomial de verdad. Que el problema esté en NP no depende de que los números sean pequeños.
SAT
Una fórmula booleana se arma con variables, , y . Una asignación le da a cada variable un valor, verdadero o falso, y satisface la fórmula si con esos valores la fórmula vale verdadero.
- Certificado: una asignación, es decir, un bit por variable.
- Verificador: comprobar que la asignación le da un valor a cada variable de , reemplazar y evaluar la fórmula. Aceptar si vale verdadero.
- Tiempo: evaluar una fórmula es un recorrido de su estructura, polinomial en su longitud.
En el código las fórmulas están en CNF, una conjunción de cláusulas, que es la forma que usan los solucionadores y la del formato DIMACS que vieron en Algoritmos. El certificado es una lista de literales: dice que es verdadera, y que es falsa.
SAT: φ = (x1 ∨ ¬x2) ∧ (¬x1 ∨ x2 ∨ x3) ∧ (¬x3 ∨ ¬x1). El certificado son literales.
  c = 1 2 -3        válido
  c = -3 2 1        válido   el orden no importa
  c = -1 -2 3       válido
  c = 1 -2 -3       inválido   la segunda cláusula queda falsa
  c = 1 2           inválido   x3 no tiene valor
  c = 1 -1 2 -3     inválido   x1 tiene dos valores
  c = 1 2 -4        inválido   no hay variable x4
COMPOSITES
Un número es compuesto si es el producto de dos enteros mayores que 1.
- Certificado: un divisor de , con .
- Verificador: comprobar que , dividir entre y aceptar si el resto es 0.
- Tiempo: una división de números de bits, que con el método de la escuela cuesta .
COMPOSITES: x = 8633. El certificado es un divisor.
  c = 89            válido   8633 = 89 · 97
  c = 97            válido
  c = 7             inválido   8633 = 7 · 1233 + 2
  c = 1             inválido   1 divide a todos: no demuestra nada
  c = 8633          inválido   x se divide a sí mismo: tampoco
  Con x = 8641, de los certificados 0, 1, ..., 8641 el verificador acepta 0.
Es el ejemplo más limpio de la diferencia entre encontrar y comprobar. Hallar el factor 89 probando divisores cuesta, como vimos, un tiempo exponencial en la cantidad de bits. Comprobar que 89 es un factor es una división.
La última línea es el otro lado: 8641 es primo, y el verificador rechaza todos los certificados posibles. Eso se puede comprobar por fuerza bruta porque el número es pequeño.
Este ejemplo trae además una advertencia. está en NP, y también está en P: es el complemento de , salvo por los números 0 y 1. Estar en NP no dice que un problema sea difícil. Dice que comprobar es fácil.
| Lenguaje | Certificado | Bits del certificado | Qué hace el verificador |
|---|---|---|---|
| Una lista de los vértices | Revisa que estén todos, una vez, de a , y cada arco | ||
| vértices | Revisa que sean distintos y cada par de ellos | ||
| Un subconjunto de los números | , con un bit por número | Suma y compara con | |
| Una asignación | Uno por variable | Evalúa la fórmula | |
| Un divisor | A lo sumo los de | Divide |
En C++. En
verifiers.h, cada verificador es una función que recibe la instancia y el certificado y devuelve unbool. Ninguna tiene un ciclo sobre “todas las posibilidades”: los únicos ciclos recorren el certificado o la instancia. Para saber si un arco existe,verify_hampathpasa los arcos a unstd::set<std::pair<int, int>>, y cada consulta cuesta . En el laboratorio verán que esa decisión, que para la teoría no importa, separa un programa que pasa de uno que daTLE.
La otra definición: máquinas no deterministas
El nombre NP no viene de los verificadores. Viene de Nondeterministic Polynomial time: tiempo polinomial no determinista. Es la definición original, y usa la máquina de la sección El no determinismo parece costar caro.
Definición. es la clase de los lenguajes que decide alguna máquina de Turing no determinista que corre en tiempo .
Una máquina no determinista de tiempo polinomial para :
N = "Con la entrada ⟨G, s, t⟩, donde G tiene m vértices:
  1. Escribir una lista de m números p1, ..., pm, eligiendo cada uno de forma
     no determinista entre 1 y m.
  2. Si algún número se repite, rechazar.
  3. Si p1 ≠ s o pm ≠ t, rechazar.
  4. Para cada i de 1 a m − 1: si G no tiene el arco de pi a pi+1, rechazar.
  5. Aceptar."
El paso 1 abre ramas, una por cada lista posible. Cada rama, por separado, es corta: escribe números y hace las mismas comprobaciones que el verificador. La máquina acepta si alguna rama llega al paso 5, y eso pasa exactamente cuando alguna lista es un camino hamiltoniano de a . Su tiempo, que es la longitud de la rama más larga, es polinomial.
Miren los pasos 2 a 4: son el verificador de la sección anterior. Y el paso 1 es “adivinar el certificado”. No es una coincidencia.
Error común. Leer “la máquina adivina” como si tuviera suerte o inteligencia. Una máquina no determinista no elige bien: su definición de aceptar dice “existe una rama que acepta”. Es la misma idea de los NFA de la semana 2, que aceptaban si algún camino terminaba en un estado de aceptación. Nadie sabe construir un aparato que haga eso en tiempo polinomial. La máquina no determinista es una definición matemática, y no un modelo de computadora.
Las dos definiciones coinciden
Teorema. Un lenguaje tiene un verificador de tiempo polinomial si y solo si alguna máquina de Turing no determinista de tiempo polinomial lo decide. Es decir:
La idea, en una frase por dirección: la máquina adivina el certificado, y el certificado es la lista de decisiones de la máquina.
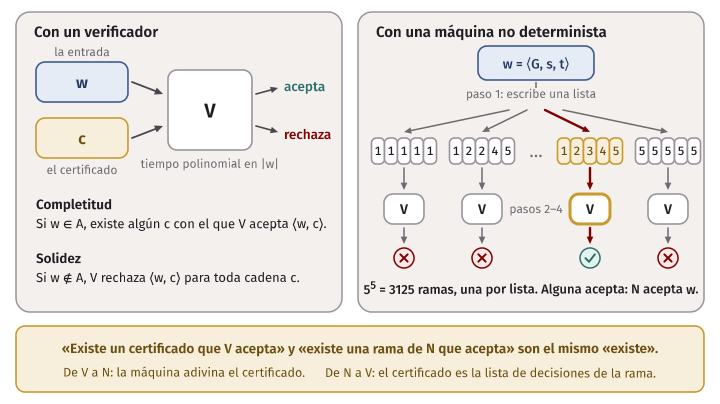
Demostración. Por construcción, en las dos direcciones. Para fijar ideas, la entrada de un verificador se escribe , con un separador que no aparece en ni en .
De un verificador a una máquina no determinista. Sea un verificador de que da a lo sumo pasos con entradas donde , con un polinomio.
Qué se construye.
N = "Con la entrada w, de longitud n:
  1. Marcar p(n) celdas. Escribir en ellas, de forma no determinista, una cadena c
     de longitud a lo sumo p(n): en cada celda, elegir un símbolo del alfabeto de
     los certificados, o terminar.
  2. Ejecutar V con la entrada ⟨w, c⟩.
  3. Si V acepta, aceptar. Si V rechaza, rechazar."
Por qué decide . Hay que ver que acepta si y solo si .
- Si acepta , alguna rama acepta. Esa rama escribió alguna cadena y aceptó . Por la definición de verificador, .
- Si , acepta para alguna cadena . Falta ver que hay una así de longitud a lo sumo , que es lo único que puede escribir. da a lo sumo pasos, y en cada paso el cabezal avanza a lo sumo una celda: nunca llega más allá de la celda de su cinta, así que no lee más que los primeros símbolos de , menos de . Sea el prefijo de de longitud , o entera si es más corta. Con , hace exactamente lo mismo que con , porque las dos entradas solo difieren en celdas que nunca visita. Así que acepta , y la rama de que escribe acepta.
Por qué es de tiempo polinomial. En cualquier rama, el paso 1 cuesta un tiempo polinomial: calcular , marcar las celdas y escribir en ellas. El paso 2 da a lo sumo pasos. Todas las ramas se detienen, así que es un decididor, y su tiempo es polinomial.
De una máquina no determinista a un verificador. Sea una máquina no determinista que decide y cuyas ramas dan a lo sumo pasos. Sea la mayor cantidad de opciones que ofrece su función de transición. Para cada par de estado y símbolo, numeramos sus opciones en un orden fijo. Entonces una rama de la ejecución queda descrita por la lista de números que eligió, uno por paso: una cadena sobre el alfabeto .
Qué se construye.
V = "Con la entrada ⟨w, c⟩, donde c = c1 c2 ... es una cadena sobre {1, ..., b}:
  1. Simular N con la entrada w. En el paso i de la simulación, tomar la opción
     número ci de la función de transición de N.
  2. Si en algún paso la opción ci no existe, o c se acaba antes de que N se
     detenga, rechazar.
  3. Si esa rama de N acepta, aceptar. Si rechaza, rechazar."
Por qué es un verificador de . Hay que ver que si y solo si acepta para alguna .
- Si , acepta : alguna rama termina en . Sea la lista de las opciones que esa rama eligió. Con ese , sigue esa misma rama y acepta.
- Si acepta , entonces siguió, paso a paso, una rama real de con la entrada , y esa rama terminó en . Entonces acepta , y .
Por qué es de tiempo polinomial en . es determinista: le dice qué hacer en cada paso. Toda rama de se detiene en a lo sumo pasos, así que simula a lo sumo pasos de , sea cual sea la longitud de : si es más larga, lo que sobra no se lee. Con dos cintas la cuenta es directa: copia a la segunda cinta, en pasos, y queda con el primer cabezal al comienzo de ; después, cada paso de es un paso de , que lee un símbolo de y avanza. Son pasos. Esa máquina nunca mira más allá de los primeros símbolos de su entrada, así que pasarla a una cinta cuesta, como en el teorema de las varias cintas, a lo sumo el cuadrado: sigue siendo polinomial en . ∎
La segunda dirección explica por qué el certificado de un problema de NP siempre puede tomarse corto: es, a lo sumo, la lista de las decisiones de una rama. Y la primera es la cuarta pregunta de repaso de la guía.
Idea clave. Las dos definiciones de NP dicen lo mismo con palabras distintas. “Existe un certificado que el verificador acepta” y “existe una rama que acepta” son el mismo “existe”. Para demostrar que un problema está en NP, casi siempre es más cómodo el verificador. Para demostrar algo sobre todos los problemas de NP, como en la semana 13, es más cómoda la máquina.
P, NP y EXPTIME
¿Dónde queda NP respecto de lo que ya tenemos? Hace falta una clase más:
Son los lenguajes que una máquina determinista decide en tiempo exponencial.
Teorema. .
Demostración de . Por construcción de un verificador que no necesita el certificado. Sea , y una máquina determinista que decide en tiempo polinomial.
V = "Con la entrada ⟨w, c⟩:
  1. Ignorar c. Ejecutar M con la entrada w.
  2. Si M acepta, aceptar. Si M rechaza, rechazar."
Si , acepta con cualquier ; en particular, con alguno. Si , rechaza con todos. Y corre en tiempo polinomial en porque lo hace. Entonces es un verificador de tiempo polinomial de . ∎
Con la otra definición es todavía más corto: una máquina determinista es una máquina no determinista que nunca tiene más de una opción.
Demostración de . Por construcción de un decididor que prueba todos los certificados. Sea y un verificador de que da a lo sumo pasos, con un polinomio. Sea el alfabeto de los certificados, con símbolos.
D = "Con la entrada w, de longitud n:
  1. Para cada cadena c sobre Γ de longitud a lo sumo p(n), en orden:
  2.     Ejecutar V con la entrada ⟨w, c⟩. Si acepta, aceptar.
  3. Si ningún certificado fue aceptado, rechazar."
Decide : en la demostración anterior vimos que, si algún certificado sirve, alguno de longitud a lo sumo sirve. los prueba todos, así que acepta si y solo si .
Tiempo: hay a lo sumo cadenas de longitud a lo sumo . Con cada una, ejecuta , que da a lo sumo pasos, y prepara la siguiente, que cuesta . El total es
Si , eso es a lo sumo para alguna constante , que es . Entonces . ∎
Esta segunda demostración es un programa que ustedes ya saben escribir: la fuerza bruta. search.h la tiene
para suma de subconjuntos, tal cual: recorre los subconjuntos y le pasa cada uno al verificador.
find_vs_check la ejecuta.
$ build/find_vs_check
Números 8 13 21 5 17 2, objetivo 28: certificado 1 2 4 6, hallado después de probar 44 de 64
Números 8 13 21 5 17 2, objetivo 4: ningún certificado sirve; se probaron los 64

Instancias sin solución: los números 2, 4, ..., 2n y un objetivo impar, cerca de la mitad de la suma
 n   certificados que prueba la búsqueda   sumas del verificador con un certificado
 4                      16                                     4
 8                     256                                     8
12                    4096                                    12
16                   65536                                    16
Con una instancia que sí tiene solución, la búsqueda puede tener suerte y detenerse antes. Con una que no la tiene, no hay atajo: para responder “no” hay que haber descartado los certificados. La segunda tabla usa instancias sin solución (una suma de números pares nunca es impar) y cuenta. Cada número que se agrega a la lista duplica el trabajo de la búsqueda y le suma una sola operación al verificador. Con 60 números serían certificados, más de . Son conteos de operaciones, no tiempos.
Esa es la distancia entre comprobar y encontrar con el único método general que conocemos. La pregunta es si existe otro.
La pregunta P contra NP
En Algoritmos la conocieron como “¿todo problema cuya solución se comprueba rápido se puede resolver rápido?”. Con las definiciones de esta semana se puede decir sin ninguna palabra informal:
¿Es cierto que todo lenguaje que tiene un verificador de tiempo polinomial es decidido por alguna máquina de Turing determinista de tiempo polinomial?
O, con la otra definición: ¿toda máquina no determinista de tiempo polinomial tiene una determinista equivalente que también sea de tiempo polinomial? Sabemos que tiene una de tiempo exponencial. No sabemos si se puede bajar.
Qué se sabe y qué no:
- , demostrado arriba.
- . Es un teorema, que sale del teorema de jerarquía de tiempo de la semana 15: hay lenguajes que se deciden en tiempo exponencial y no en tiempo polinomial.
- Por lo tanto, al menos una de las dos inclusiones es estricta. No se sabe cuál. Podría ser , y podría ser , aunque no las dos a la vez.
- Casi todos los investigadores creen que . La evidencia es de dos tipos: décadas de buscar algoritmos polinomiales para miles de problemas de NP sin encontrar ninguno, y el hecho de que bastaría encontrarlo para uno solo de los NP-completos. Pero no hay demostración.
La dificultad está en el tipo de afirmación. Para mostrar que bastaría un algoritmo. Para mostrar que hay que demostrar que ninguna máquina de tiempo polinomial decide, por ejemplo, : ni la fuerza bruta, ni ninguna idea que a alguien se le ocurra dentro de cien años. En computabilidad teníamos una herramienta para afirmaciones así, la diagonalización. La semana 15 muestra por qué esa herramienta, tal como la conocemos, no alcanza aquí.
La semana 13 retoma la pregunta desde el otro lado: los problemas NP-completos, y la demostración de que es uno de ellos.
Lo que NP no es
NP es probablemente la sigla peor entendida de la computación. Cinco confusiones frecuentes.
NP no significa “no polinomial”. La N es de nondeterministic. Es un error grave, porque dice lo contrario de la verdad: todo problema de P está en NP. Decidir si una lista está ordenada, y todo lenguaje regular están en NP.
NP no es “los problemas que tardan tiempo exponencial”. es una cota superior: dice que tiempo exponencial alcanza, y no que haga falta. De ningún problema de NP se ha demostrado que necesite tiempo exponencial. Si alguien lo hiciera, habría resuelto .
Estar en NP no es ser difícil. NP es una cota superior de dificultad. Los problemas difíciles de NP son los NP-completos, que son otra cosa: los más difíciles dentro de NP. está en NP y también en P.
NP es una clase de problemas de decisión. “Hallar el camino hamiltoniano más corto” no es un lenguaje, y no está ni deja de estar en NP. Lo que se clasifica es la versión con respuesta sí o no. En la semana 1 se vio por qué eso no pierde generalidad.
El certificado solo existe para las respuestas “sí”. Esta es la más sutil, y merece su propia sección.
coNP: el lado del no
La definición de verificador es asimétrica. Si , pide que exista un certificado. Si , no pide ninguna justificación: solo que nada convenza al verificador. Para :
- ¿Qué probaría que una fórmula tiene una asignación que la satisface? La asignación. Es corta, y se comprueba evaluando.
- ¿Qué probaría que una fórmula no tiene ninguna?
Piénsenlo un momento antes de seguir. Mostrar una asignación que falla no prueba nada: puede haber otra que
funcione. Mostrar que fallan mil tampoco. Lo único evidente es la lista de las asignaciones de las
variables, con la comprobación de que todas fallan, y esa lista no tiene longitud polinomial. La fórmula de
ejemplo example_unsatisfiable, con las cuatro cláusulas posibles sobre dos variables, no tiene solución: las
pruebas lo comprueban revisando sus 4 asignaciones. Con 300 variables no hay universo que alcance para la lista.
No se conoce ningún certificado corto de que una fórmula no tiene solución. Y no se ha demostrado que no exista.
Definición. es la clase de los lenguajes cuyo complemento está en NP:
Dicho con certificados: en un lenguaje de coNP, las respuestas “no” son las que tienen demostraciones cortas. El complemento de está en coNP por definición, igual que el complemento de : los grafos que no tienen camino hamiltoniano. La pregunta de arriba es si está también en NP, y es la quinta pregunta de repaso de la guía: no es evidente, porque no se ve qué podría servir de certificado.
Error común. Creer que coNP es el complemento de NP, es decir, “los lenguajes que no están en NP”. No lo es. coNP es la clase de los complementos de los lenguajes de NP. Las dos clases se solapan: todo lenguaje de P está en las dos.
¿Por qué no basta intercambiar aceptar y rechazar? Con las máquinas deterministas ese truco funciona: si decide en tiempo polinomial, la máquina que hace lo mismo y responde al revés decide en el mismo tiempo. Por eso P es cerrada bajo complemento, y de ahí sale que
Con una máquina no determinista el truco falla, y vale la pena ver dónde. Sea la máquina que resulta de intercambiar y en . Entonces acepta si alguna rama de rechaza. Pero significa que todas las ramas de rechazan. Si es la máquina que adivina una asignación y la evalúa, acepta las fórmulas que tienen alguna asignación que falla, que son casi todas, y no las que no tienen solución. Es lo mismo que pasaba con los NFA en la semana 2: cambiar los estados de aceptación de un NFA no da el complemento.
El “existe” de la definición de NP se convierte, al complementar, en un “para todo”. NP es la clase de los problemas de la forma “existe un corto tal que…”, y coNP la de los problemas “para todo corto…”.
Lo que se sabe:
- .
- Si , entonces : P es cerrada bajo complemento, así que NP también lo sería. Al revés: si alguien demuestra que , demuestra que .
- No se sabe si . Se cree que no.
Hay problemas que están en las dos clases sin que eso sea evidente. está en coNP, porque su complemento es en esencia : un divisor certifica que un número no es primo. Mucho antes de saberse que está en P, se demostró que también está en NP: existe un certificado corto de que un número sí es primo, aunque es bastante menos obvio que un divisor.
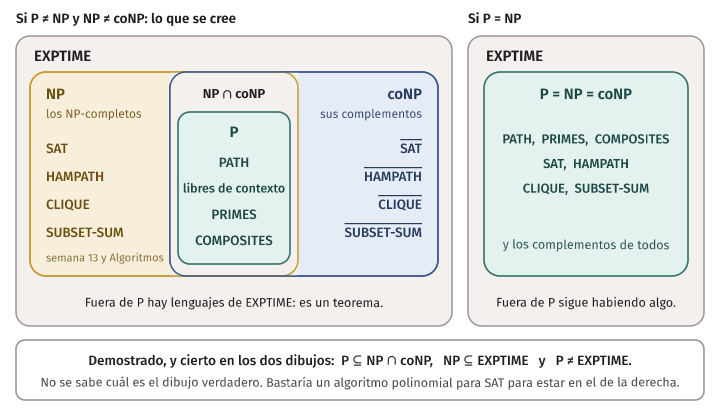
La semana 13 vuelve a coNP con más herramientas.
En la práctica. Los solucionadores SAT viven esta asimetría. Cuando responden “satisfacible”, entregan la asignación, y cualquiera la comprueba en un instante con un verificador como el del laboratorio. Cuando responden “insatisfacible”, lo más que pueden entregar es un registro de su razonamiento, paso por paso, para que otro programa lo revise. Ese registro es un certificado, pero no es corto: en problemas difíciles ocupa gigabytes.
El código de la semana
code/week-12/
├── tm.h                  struct Tm, lectura del formato .tm y ejecución contando pasos
├── multitape.h           máquina de k cintas, y la de dos cintas para 0^k 1^k
├── run_tm.cpp            ejecuta una máquina .tm: veredicto, pasos y configuraciones
├── count_steps.cpp       las dos tablas de pasos de las tres máquinas
├── encoding_demo.cpp     binario y unario; divisiones de prueba; la tabla de SUBSET-SUM
├── verifiers.h           los cinco verificadores: HAMPATH, CLIQUE, SUBSET-SUM, SAT, COMPOSITES
├── search.h              búsqueda exhaustiva, tabla de sumas y divisiones de prueba
├── examples.h            las instancias de ejemplo de este capítulo
├── verify_demo.cpp       cada verificador con certificados buenos, malos y mal formados
├── find_vs_check.cpp     cuántos certificados prueba la búsqueda y cuánto cuesta comprobar uno
├── machines/             las dos máquinas de una cinta, en formato .tm
├── errors/               el intento de una sola pasada, que no decide el lenguaje
├── test_time.cpp         las máquinas deciden 0^k 1^k; fórmulas y tablas de pasos
├── test_encoding.cpp     longitudes en binario, divisiones y casillas de la tabla
├── test_verifiers.cpp    los certificados del capítulo; existe certificado si y solo si la respuesta es sí
└── lab/verifiers/        el laboratorio: tres verificadores
make compila todo, y make test corre las pruebas con ASan y UBSan. Las pruebas comprueban con assert lo
que este capítulo afirma. test_time compara las tres máquinas con una función de C++ que decide
mirando la cadena, sobre las 8191 cadenas de longitud a lo sumo 12; comprueba
el peor caso de cada longitud, las fórmulas exactas de pasos, las cotas de las demostraciones y cada número de
las tablas. test_encoding comprueba las longitudes en binario, las divisiones de la tabla de primos y las
casillas de la tabla de sumas, y que la tabla y la búsqueda exhaustiva deciden lo mismo en 300 instancias al
azar. test_verifiers comprueba cada certificado copiado en este capítulo y, en instancias pequeñas, la
definición de NP completa: para , que el verificador acepta algún ordenamiento exactamente
cuando un algoritmo independiente dice que el camino existe.
$ make test
test_time: ok (3 máquinas, 8191 cadenas cada una)
test_encoding: ok
test_verifiers: ok
Todas las pruebas pasaron.
Los archivos de máquinas son:
| Archivo | Qué hace | Estados, sin los finales | Tiempo |
|---|---|---|---|
machines/zeros_ones_quadratic.tm |
Decide emparejando de uno en uno | 4 | |
machines/zeros_ones_nlogn.tm |
Decide el mismo lenguaje tachando uno de cada dos | 9 | |
errors/zeros_ones_one_pass.tm |
Solo comprueba la forma : no decide el lenguaje | 2 |
Para experimentar, usen run_tm con sus propias cadenas, y con --watch y el nombre de un estado para ver la
cinta cada vez que la máquina entra en él. Es el mismo formato .tm de su simulador de la semana 7: pueden
correr estas máquinas ahí y comparar la cantidad de pasos.
En tm.h, es un std::map con los nombres de los estados, para que el struct se lea como la
definición. Antes de ejecutar, run_tm la pasa a una tabla indexada por números: con 33 millones de pasos, buscar
nombres en un mapa en cada uno se nota.
El laboratorio
En lab/verifiers hay tres problemas, cada uno en su carpeta: hampath, sat y subset_sum. En los tres, el
programa lee una instancia y varios certificados, y responde válido o inválido por cada uno.
cd lab/verifiers/subset_sum
make        # compila solution.cpp
make test   # corre el juez con todos los casos
Son los verificadores de este capítulo, con dos exigencias más. La primera es la de la definición, tomada en
serio: rechazar los certificados mal formados. Los casos traen vértices repetidos, variables sin valor,
índices fuera de rango y cantidades equivocadas. La segunda no es de la definición sino del juez: los casos
grandes piden un verificador de tiempo lineal o casi lineal. Un verificador cuadrático sigue siendo un
verificador de tiempo polinomial, pero da TLE. En suma de subconjuntos, además, los números llegan a
y las sumas a : no caben en un int, y sí en un long long.
El enunciado general, con las preguntas que deben responder, está en lab/verifiers/README.md.
Resumen
- Desde esta semana todas las máquinas son decididores. La pregunta es cuántos pasos dan.
- El tiempo de una máquina determinista es : el máximo número de pasos sobre las entradas de longitud . es la clase de los lenguajes que una máquina determinista de una cinta decide en tiempo . Es una clase de lenguajes, no de máquinas.
- Para : emparejar de uno en uno cuesta ; tachar uno de cada dos y comparar paridades, , que es lo mejor con una cinta; con dos cintas, . El costo exacto depende del modelo.
- Una máquina de varias cintas de tiempo se simula en una cinta en tiempo : pasos, y cada uno cuesta recorrer celdas.
- . Como el cuadrado de un polinomio es un polinomio, P no cambia con la cantidad de cintas, ni con ningún otro modelo determinista razonable. Por eso se puede describir en alto nivel: etapas polinomiales, cada una de costo polinomial.
- El tiempo se mide contra la longitud de la entrada, y los números se escriben en binario. Un algoritmo que da pasos para el número es exponencial. Un algoritmo pseudopolinomial, como la tabla de la mochila, es polinomial en el valor de los números y no en su longitud.
- está en P, y todo lenguaje libre de contexto también, por CYK con la gramática fija.
- Una máquina no determinista de tiempo se simula de forma determinista en tiempo . No se conoce nada mejor.
- Un verificador de es un algoritmo tal que si y solo si acepta para algún certificado . Su tiempo se mide en . NP es la clase de los lenguajes con verificador de tiempo polinomial. Los certificados tienen longitud polinomial, y el verificador rechaza los que están mal formados.
- : la máquina adivina el certificado, y el certificado es la lista de decisiones de la máquina.
- , , , y están en NP. Sus certificados: un camino, un conjunto de vértices, un subconjunto, una asignación, un divisor.
- . Un decididor es un verificador que ignora el certificado, y probar todos los certificados cuesta tiempo exponencial. Como , alguna de las dos inclusiones es estricta. No se sabe cuál: esa es la pregunta contra .
- NP no es “no polinomial”, ni “exponencial”, ni “difícil”. Y sus certificados son solo para las respuestas “sí”.
- es la clase de los lenguajes cuyo complemento está en NP: los que tienen certificados cortos para el “no”. . No se sabe si ; intercambiar aceptar y rechazar en una máquina no determinista no da el complemento.
Ejercicios
- Para cada función, digan si es , si es , si es y si es polinomial: (a) ; (b) ; (c) ; (d) ; (e) ; (f) . Dos de ellas son la misma función: ¿cuáles? ¿Es cierto que ? ¿Y que ?
- Sigan a mano la máquina
machines/zeros_ones_nlogn.tmcon la entrada : escriban la cinta al final de cada pasada y el estado en que la máquina llega al blanco. Comprueben conbuild/run_tm machines/zeros_ones_nlogn.tm --watch back 000111. ¿Cuántos pasos da? Compárenlo con la fórmula del capítulo. Después hagan lo mismo con y digan en qué pasada rechaza y por qué. - Den una descripción de implementación de una máquina de una cinta que decida y demuestren que corre en tiempo . Después den una de dos cintas que lo decida en . ¿Qué cota da el teorema de simulación para la segunda, pasada a una cinta?
- Para programar. Escriban en formato
.tmuna máquina que decida con la idea de tachar uno de cada dos, y midan sus pasos conrun_tmpara . ¿Cuánto crece al duplicar ? Agreguen una prueba que la compare con una función de C++ en todas las cadenas de longitud a lo sumo 9 sobre . - En la demostración de que varias cintas se simulan en : (a) ¿dónde se usa que ? (b) ¿Por qué cada tramo de la cinta de tiene a lo sumo celdas? (c) Si tiene cintas, ¿cuántos desplazamientos puede hacer falta al simular un solo paso, y cuánto cuesta cada uno? (d) El teorema da una cota superior. Den un ejemplo del capítulo donde la máquina de una cinta que sale de la simulación no es la más rápida posible para ese lenguaje.
- Un algoritmo recibe un número en binario y calcula con un ciclo de multiplicaciones. ¿Es de tiempo polinomial? Den dos razones distintas por las que no: una sobre la cantidad de vueltas y otra sobre el tamaño del resultado. ¿Cuántos bits tiene, aproximadamente, ?
- Sea el lenguaje de suma de subconjuntos con todos los números escritos en unario. Demuestren que está en P, con el patrón del capítulo: el algoritmo, por qué es correcto y la cuenta del tiempo en función de la longitud de la entrada. ¿Por qué la misma demostración no sirve para ?
- Demuestren que P es cerrada bajo unión, intersección, complemento y concatenación. Para la concatenación: dadas máquinas de tiempo polinomial para y , describan una para y cuenten cuántas veces llama a cada una. Después demuestren que NP es cerrada bajo unión e intersección, con verificadores. ¿Qué pasa cuando intentan lo mismo con el complemento?
- Demuestren que estos lenguajes están en NP, dando el certificado, el verificador y su tiempo: (a) ; (b) ; (c) . En cada uno, digan cuántos bits tiene el certificado y den un certificado mal formado que su verificador deba rechazar.
- Alguien propone este “verificador” para : “Con la entrada : ignorar ; llenar la tabla de sumas alcanzables; aceptar si es alcanzable.” (a) ¿Cumple que acepta algún si y solo si la instancia está en el lenguaje? (b) ¿Es un verificador de tiempo polinomial? (c) Otra persona propone: “sumar los números de las posiciones que dice y aceptar si dan ”, sin revisar nada más. Den una instancia que no está en el lenguaje y un certificado que este segundo verificador acepta.
- En la demostración de que un verificador da una máquina no determinista, se usó que basta adivinar certificados de longitud a lo sumo . (a) Escriban ese argumento con sus palabras. (b) ¿Qué saldría mal si la definición de verificador midiera el tiempo en función de y no de ? Muestren que, con esa definición, tendría un “verificador de tiempo polinomial”, tomando como certificado la historia de cómputo de la semana 10.
- Demuestren: (a) si , entonces ; (b) ; (c) un lenguaje está en coNP si y solo si existe un algoritmo de tiempo polinomial en tal que exactamente cuando acepta para toda cadena de longitud a lo sumo . Usen (c) para decir qué “verifica” el verificador de .
- Para programar. Agreguen a
search.huna búsqueda exhaustiva para que pruebe los ordenamientos constd::next_permutationy llame averify_hampath, contando cuántos prueba. Midan con grafos sin camino hamiltoniano de 6, 8 y 10 vértices (por ejemplo, un grafo con un vértice sin arcos de entrada distinto de ). ¿Cómo crece? Compárenlo con el crecimiento de la búsqueda de suma de subconjuntos. ¿Cuál de los dos certificados tiene más bits, y cómo se relaciona eso con la cantidad de candidatos?