
Apuntes · Capítulo 13Complejidad
NP-completitud, demostrada
NP-completitud, demostrada
La semana pasada definimos NP sobre máquinas de Turing, de dos maneras que resultaron ser la misma: los lenguajes que tienen un verificador de tiempo polinomial, y los que decide una máquina no determinista de tiempo polinomial. Quedó planteada la pregunta de si , ahora con una definición precisa de cada lado.
En Análisis y Diseño de Algoritmos usaron esa pregunta sin poder tocar el fondo. Aprendieron a reducir un problema a otro, redujeron 3-SAT a conjunto independiente, a 3-coloreo y a suma de subconjuntos, y concluyeron que todos son NP-completos. Pero toda esa cadena colgaba de un teorema que solo se enunció: SAT es NP-completo. Sin él, las reducciones dicen que esos problemas son tan difíciles como SAT, y nada dice que SAT sea difícil.
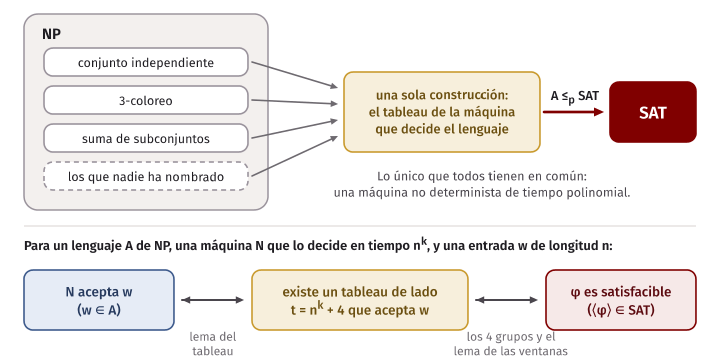
Esta semana se demuestra. La demostración no se parece a las reducciones que ya conocen, porque no parte de un problema: parte de todos los problemas de NP a la vez. Lo único que tienen en común es que cada uno tiene una máquina no determinista de tiempo polinomial, y de eso sale la fórmula. La ejecución completa de la máquina se escribe en una tabla, el tableau, y la fórmula dice, celda por celda, que la tabla es una ejecución que acepta.
Es una demostración por construcción, y la vamos a ejecutar: un programa recibe una máquina, una entrada y el
tamaño de la tabla, escribe la fórmula, minisat la resuelve y de la asignación sale la ejecución de la
máquina. En la segunda sesión se completa el cuadro: de SAT a 3-SAT, una reducción nueva con gadgets, el borde
entre 2-SAT y 3-SAT, la clase coNP y qué significaría que P fuera igual a NP.
Ruta de lectura.
Antes de clase (15–20 minutos): la introducción, Lo que ya saben: reducciones y NP-completitud y El primer problema NP-completo. Antes de la sesión B, De la fórmula del tableau a una fórmula en CNF. Con eso llegan sabiendo qué hay que demostrar y por qué no alcanza con una reducción de las de siempre.
En clase: Sesión A, de Una máquina de ejemplo a La reducción, ejecutada. Sesión B, de De la fórmula del tableau a una fórmula en CNF a Los solucionadores SAT en la práctica.
Después de clase: el Resumen y los Ejercicios, para repasar. Antes del laboratorio, Ventanas legales otra vez y El código de la semana. Para ampliar, las lecturas de apoyo del recuadro siguiente.
Lectura. Sipser, sec. 7.4 (NP-completeness) y 7.5 (Additional NP-complete Problems). Barak, capítulos 14 (Polynomial-time reductions), 15 (NP, NP completeness, and the Cook-Levin Theorem) y 16 (What if P equals NP?). Son apoyo: estos apuntes se pueden estudiar solos.
Código. Los programas de este capítulo están en
code/week-13. Dentro del entorno del curso, entren a esa carpeta y corranmakepara compilar los ejemplos ymake testpara comprobarlos. Los comandos de este capítulo se corren desde ahí. El laboratorio está enlab/cook_levin.
Lo que ya saben: reducciones y NP-completitud
Una página de repaso, con la notación de este curso. Las reducciones de la semana 10 pedían que la función fuera computable. Ahora además tiene que ser rápida.
Definición. Un lenguaje se reduce en tiempo polinomial (polynomial-time reduction) a un lenguaje , y se escribe , si existe una función , computable por una máquina de Turing determinista de tiempo polinomial, tal que para toda cadena :
La función traduce preguntas sobre en preguntas sobre sin cambiar la respuesta. Tres hechos, que en Algoritmos usaron todo el tiempo:
- Si y , entonces . Para decidir si se calcula y se le pregunta al algoritmo de . Como tarda un tiempo polinomial, es polinomial en , y un polinomio de un polinomio es un polinomio.
- Leído al revés: si y , entonces . Es la forma en que se usa para mostrar dificultad: es al menos tan difícil como .
- Es transitiva: si y , entonces , componiendo las dos funciones.
Definición. Un lenguaje es NP-difícil si todo lenguaje cumple . Es NP-completo si es NP-difícil y además .
Un problema NP-completo es, entonces, un problema de NP al que se reducen todos los demás. De la definición y de los tres hechos salen las dos consecuencias que importan.
Teorema. Si es NP-completo y , entonces .
Demostración. Sea . Como es NP-difícil, , y como , el primer hecho da . Entonces , y la otra inclusión ya la tenemos de la semana pasada. ∎
Teorema. Si es NP-completo, y , entonces es NP-completo.
Demostración. Sea . Entonces porque es NP-difícil, y por hipótesis. Por transitividad, . Eso vale para todo de NP, así que es NP-difícil, y está en NP por hipótesis. ∎
El segundo teorema es la receta de Algoritmos: para mostrar que un problema nuevo es NP-completo se muestra que está en NP y se reduce desde un problema NP-completo conocido hacia . La dirección es la misma que en la semana 10, donde se reducía desde un problema indecidible conocido hacia el nuevo.
Error común. Demostrar que un problema es NP-completo y olvidar mostrar que está en NP. La reducción desde 3-SAT solo prueba que es NP-difícil. El problema de la parada también es NP-difícil, y no está en NP: ni siquiera es decidible. La definición tiene dos partes y hay que escribir las dos, aunque la primera sean dos líneas: cuál es el certificado y por qué se comprueba en tiempo polinomial.
El primer problema NP-completo
La receta necesita un problema NP-completo para empezar, y ese primero no puede salir de la receta.
La dificultad. Para mostrar que un problema es NP-difícil sin apoyarse en otro, hay que dar una reducción para cada lenguaje de NP: conjunto independiente, coloreo, suma de subconjuntos, y también todos los problemas de NP que nadie ha estudiado ni nombrado. No se puede ir uno por uno. Hace falta una sola construcción que sirva para todos, y entonces solo puede usar lo que todos tienen en común. Por la definición de NP con máquinas, eso es:
para cada existe una máquina de Turing no determinista que decide en tiempo polinomial.
Nada más. La reducción tiene que tomar una cadena y convertir la pregunta “¿acepta a ?” en una pregunta del problema . Así que debe ser un problema lo bastante expresivo para describir la ejecución de una máquina de Turing cualquiera. Cook, en 1971, e independientemente Levin, mostraron que las fórmulas booleanas alcanzan.
Definición. Una fórmula booleana (Boolean formula) se arma con variables, que valen verdadero o falso, y las operaciones (y), (o) y (no). Una asignación (assignment) da un valor a cada variable. La fórmula es satisfacible si alguna asignación la hace verdadera.
Por ejemplo, es satisfacible, con verdadera e falsa. En cambio no lo es.
SAT está en NP: el certificado es la asignación, y el verificador evalúa la fórmula, lo que toma un tiempo lineal en su longitud. Lo vieron la semana pasada. Lo nuevo es la otra mitad.
Teorema (Cook-Levin). SAT es NP-completo.
El plan de la demostración, que ocupa toda la sesión:
- Fijar un lenguaje cualquiera y una máquina no determinista que lo decide en tiempo .
- Escribir la ejecución de con una entrada como una tabla, el tableau, con una configuración por fila. La máquina acepta si y solo si existe una tabla así que llega a .
- Dar una fórmula cuyas variables dicen qué hay en cada celda de la tabla, y que es verdadera exactamente cuando la tabla es una ejecución de que acepta .
- Comprobar que tiene tamaño polinomial en y que se escribe en tiempo polinomial.
Con eso, es una reducción de a SAT. Como era cualquiera, SAT es NP-difícil.
Una máquina de ejemplo
Para tener algo concreto que mirar en cada paso de la demostración, usaremos una máquina no determinista muy pequeña. Decide el lenguaje de las cadenas binarias que contienen . Ese lenguaje es regular y no necesita no determinismo; la máquina se eligió por chica, y por tener una sola decisión que adivinar.
$ cat machines/contains_11.tm
# Acepta las cadenas binarias que contienen 11.
# No determinista: en q0, al leer un 1, sigue de largo o apuesta a que ahí empieza el 11.
states: q0 q1 q_accept q_reject
alphabet: 0 1
tape: 0 1 _
start: q0
accept: q_accept
reject: q_reject
delta:
q0 0 -> q0 0 R
q0 1 -> q0 1 R
q0 1 -> q1 1 R
q1 1 -> q_accept 1 R
Es el formato .tm de la semana 7 para máquinas no deterministas: hay dos líneas para el par . En
una máquina no determinista, es un conjunto de movimientos, y cada línea es uno. Como tabla:
| Estado | Lee | Lee | Lee |
|---|---|---|---|
| o | ninguno | ||
| ninguno | ninguno |
Una casilla con “ninguno” es un par sin línea: la rama que llega ahí no tiene cómo seguir, y rechaza. La máquina recorre la entrada hacia la derecha en . Cada vez que lee un elige: seguir en , o pasar a apostando a que el símbolo siguiente también es . Si acierta, acepta.
El programa run_ntm recorre el árbol de ejecuciones por niveles, como la simulación determinista de la semana
7, e imprime las configuraciones de cada nivel en el formato :
$ build/run_ntm machines/contains_11.tm 011
N = machines/contains_11.tm, no determinista; w = 011
paso 0:  q0 011
paso 1:  0 q0 11
paso 2:  01 q0 1  |  01 q1 1
paso 3:  011 q0 _  |  011 q1 _  |  011 q_accept _
acepta: hay una rama de 3 pasos
  q0 011
  0 q0 11
  01 q1 1
  011 q_accept _
En el paso 2 hay dos configuraciones, porque en el paso 1 la máquina leyó un en . En el paso 3 hay tres, y una de ellas acepta. Con eso basta: una máquina no determinista acepta si alguna rama acepta. Con ninguna lo hace:
$ build/run_ntm machines/contains_11.tm 010
N = machines/contains_11.tm, no determinista; w = 010
paso 0:  q0 010
paso 1:  0 q0 10
paso 2:  01 q0 0  |  01 q1 0
paso 3:  010 q0 _
rechaza: todas las ramas se detuvieron sin aceptar
La rama que apostó en el paso 2 quedó en leyendo un , sin movimiento posible. La otra llegó al blanco y tampoco tiene cómo seguir.
Con una entrada de longitud , toda rama de esta máquina se detiene en a lo sumo pasos, porque en cada paso avanza una celda y al llegar al blanco ya no hay movimientos. Es una máquina de tiempo polinomial, como pide la demostración.
Dos convenciones sobre las máquinas, que vienen de la semana 7 y que la demostración va a usar:
- La cinta es infinita solo hacia la derecha. Un movimiento en la primera celda deja el cabezal donde está.
- Desde y desde no sale ninguna transición.
El tableau
Fijamos para toda la demostración un lenguaje y una máquina no determinista que decide en tiempo : con una entrada de longitud , toda rama de se detiene en a lo sumo pasos. Si la cota de fuera otro polinomio, por ejemplo , se pone esa expresión donde aquí dice . La demostración solo usa que es un polinomio en .
Definición. Un tableau de lado para es una tabla de celdas. Cada celda contiene un elemento de
es decir, un símbolo de la cinta, un estado o el separador , que no está en ni en .
Queremos que cada fila sea una configuración. Una configuración se escribe en una fila así:
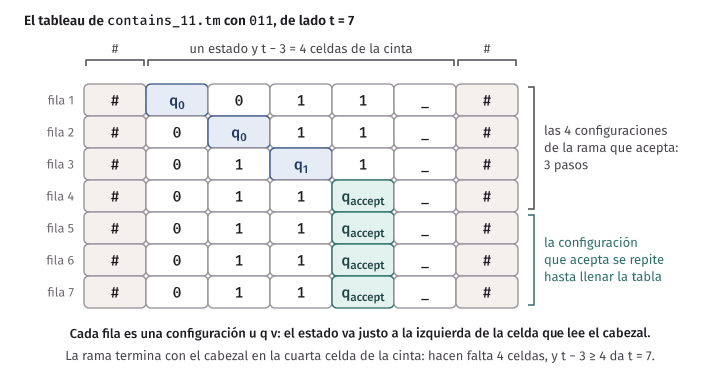
La primera celda y la última contienen . Entre ellas quedan celdas: una para el estado y para las primeras celdas de la cinta, con los blancos que hagan falta al final. El estado va justo a la izquierda de la celda que lee el cabezal, como en la semana 7.
Definición. Una fila de celdas es una configuración si empieza y termina con , tiene exactamente un estado, todas sus otras celdas son símbolos de , y a la derecha del estado hay al menos un símbolo de . Lo último dice que la celda que lee el cabezal está dentro de la fila: un estado nunca queda pegado a la derecha.
Una configuración cabe en una fila de celdas si el cabezal está en una de las primeras celdas de la cinta y todo lo que hay más allá de esas celdas es blanco. Las no son parte de la cinta: marcan dónde termina la fila, y la de la izquierda hace además que una ventana pueda saber que está junto a la primera celda de la cinta, donde un movimiento se comporta distinto.
Definición. Un tableau de lado acepta si:
- la fila 1 es la configuración inicial de con , es decir, ;
- cada fila es una configuración, y la que está debajo sale de ella por un paso de ; o bien la fila ya está en y la que está debajo es igual;
- alguna fila está en .
La segunda parte de la condición 2 es una convención: una configuración que acepta se repite hasta llenar la tabla. Hace falta porque una rama puede aceptar en menos pasos que las filas que hay, y desde la máquina no tiene transiciones.
Para la máquina de ejemplo con , la rama que acepta tiene 3 pasos y al final el cabezal está en la cuarta celda. Hacen falta 4 celdas de cinta, así que , y el tableau más chico es el de lado 7:
#        q0       0        1        1        _        #
#        0        q0       1        1        _        #
#        0        1        q1       1        _        #
#        0        1        1        q_accept _        #
#        0        1        1        q_accept _        #
#        0        1        1        q_accept _        #
#        0        1        1        q_accept _        #
Las cuatro primeras filas son las cuatro configuraciones de la rama. Las tres últimas repiten la que acepta.
Cada fila tiene 7 celdas, y las columnas están alineadas con el nombre más largo, q_accept.
¿De qué lado tiene que ser la tabla para una entrada de longitud ? La máquina da a lo sumo pasos. En cada paso el cabezal avanza a lo sumo una celda, así que después de pasos está, cuando más, en la celda de la cinta. Y la entrada ocupa celdas. Entonces alcanza con:
- filas, una por configuración;
- celdas de cinta, más la del estado, más las dos : columnas.
Tomamos la tabla cuadrada, con
Es la “tabla de ” de la demostración; el son las dos , la celda del estado y la celda que el cabezal alcanza en el último paso. No cambia nada del argumento, pero hace que las cuentas cierren exactamente, y el programa necesita que cierren. Con la máquina de ejemplo, cuya cota es pasos, da : para , el lado 7 de la tabla de arriba.
Lema (del tableau). acepta si y solo si existe un tableau de lado que acepta .
Demostración. En las dos direcciones.
Si acepta : alguna rama acepta, con configuraciones , donde es la inicial, está en y . En el cabezal está cuando más en la celda , y la máquina solo pudo escribir en las celdas por donde pasó, así que cada cabe en una fila. Se pone en la fila , para , y en todas las filas siguientes. Son a lo sumo filas distintas. La tabla cumple las tres condiciones.
Si existe un tableau que acepta : sea la primera fila que está en . Las filas son configuraciones, la primera es la inicial con , y cada una sale de la anterior por un paso de , porque ninguna antes de la está en . Eso es una rama de que acepta . ∎
La primera dirección usa la cota de tiempo: sin ella no sabríamos de qué tamaño hacer la tabla. La segunda no la usa.
Idea clave. El tableau cambia una pregunta sobre un proceso, “¿hay alguna forma de ejecutar que termine aceptando?”, por una pregunta sobre un objeto, “¿existe una tabla con estas propiedades?”. El no determinismo desaparece: todas las decisiones de la máquina están escritas en la tabla. Es la misma idea de las historias de cómputo de la semana 10, puesta en dos dimensiones.
Las variables de la fórmula
Ahora la fórmula. Tiene una variable por cada celda y cada cosa que la celda puede contener:
La variable se lee: “la celda de la fila y la columna contiene ”. Son variables, con .
Una asignación cualquiera de estas variables no describe una tabla: puede decir que una celda contiene dos cosas a la vez, o ninguna. La fórmula es la conjunción de cuatro grupos de cláusulas, y cada uno impone una condición:
| Grupo | Qué dice |
|---|---|
| Cada celda contiene exactamente un símbolo de | |
| La fila 1 es la configuración inicial con | |
| Cada ventana de celdas es legal | |
| Alguna celda contiene |
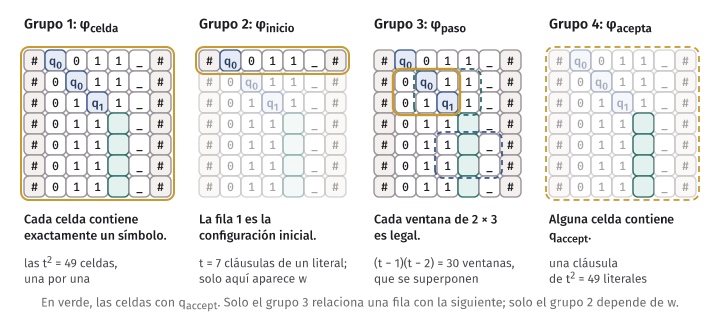
En C++. Un solucionador SAT no conoce los índices , , : en DIMACS las variables son los enteros Hay que elegir una numeración. En
cook_levin.h, los elementos de se numeran desde 0, primero , después y al final , y la variable es el entero((i - 1) * t + (j - 1)) * |C| + s + 1. Con la máquina de ejemplo, , y con las variables de las celdas son las primeras. Es la misma técnica que usaron para el sudoku en Algoritmos, con una variable por cada fila, columna y dígito.
Grupo 1: cada celda tiene exactamente un símbolo
Para cada celda hay que decir dos cosas: contiene al menos un símbolo, y a lo sumo uno.
La primera parte es una cláusula con literales. La segunda es una cláusula de dos literales por cada par de símbolos distintos, que dice “no los dos”: son pares. Es la codificación de “exactamente uno” que usaron en Algoritmos.
Cuando una asignación cumple , tiene sentido hablar de la tabla de esa asignación: la que tiene en cada celda el único símbolo cuya variable es verdadera. Los otros tres grupos hablan de esa tabla.
Grupo 2: la primera fila es la configuración inicial
Con , la fila 1 tiene que ser . Se dice celda por celda:
Son cláusulas de un solo literal. Este es el único lugar de la fórmula donde aparece . Los otros tres grupos dependen de la máquina y de , y son los mismos para todas las entradas de la misma longitud.
Grupo 4: alguna celda contiene el estado de aceptación
Antes del grupo difícil, el más corto:
Una sola cláusula, con literales.
Con estos tres grupos la fórmula todavía no dice nada sobre la máquina. La tabla que tiene la configuración inicial en la fila 1 y en todas las demás celdas los cumple. Falta decir que cada fila sale de la anterior por un paso de , y ahí está toda la demostración.
Ventanas legales
Decir “la fila sale de la fila por un paso” parece necesitar una condición sobre dos filas enteras, de celdas. Si se escribiera así, la fórmula tendría que enumerar pares de filas, y hay una cantidad exponencial. La salida es la observación que ya hicieron con las historias de cómputo en la semana 10: un paso solo cambia lo que está junto al cabezal. Para comprobar que una fila sale de la anterior basta mirar trozos pequeños, uno por uno.
Definición. Una ventana es un bloque de celdas del tableau: las columnas , , de dos filas seguidas, e . La escribimos con su fila de arriba y su fila de abajo:
En un tableau de lado hay ventanas: pares de filas seguidas y posiciones para la columna izquierda. Las ventanas se superponen: cada celda que no está en el borde aparece en varias.
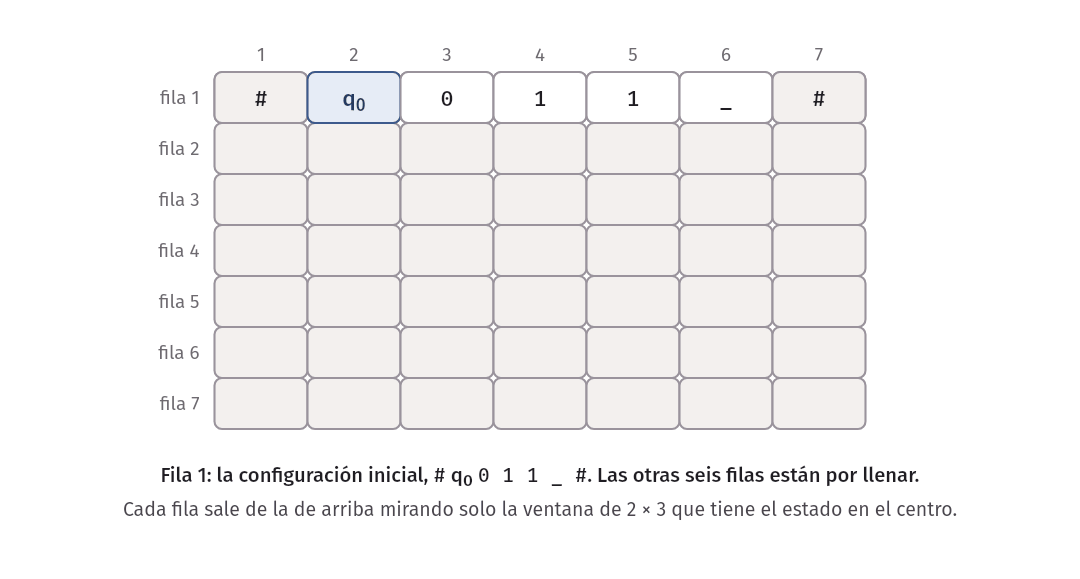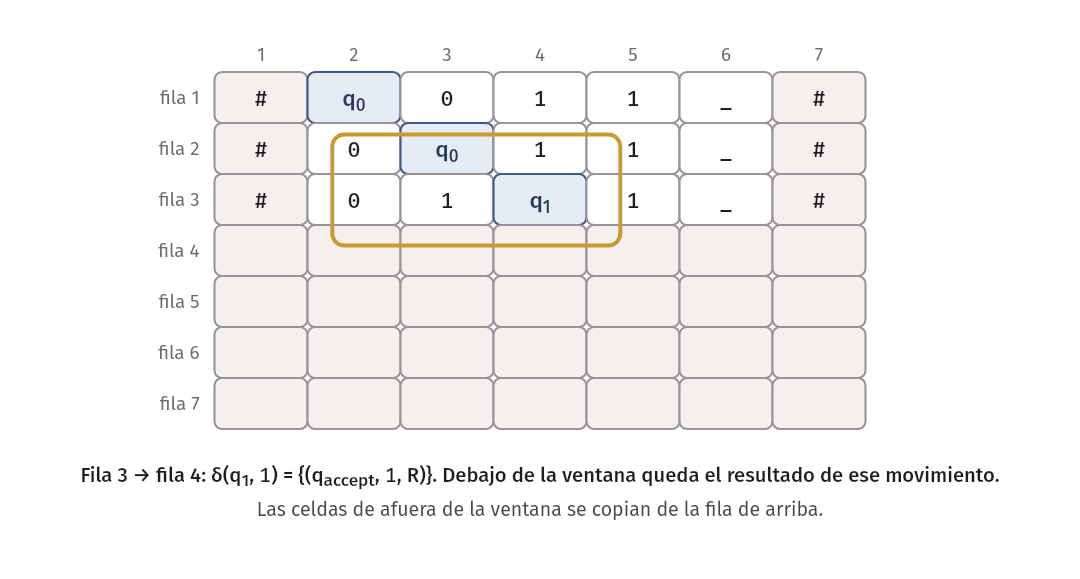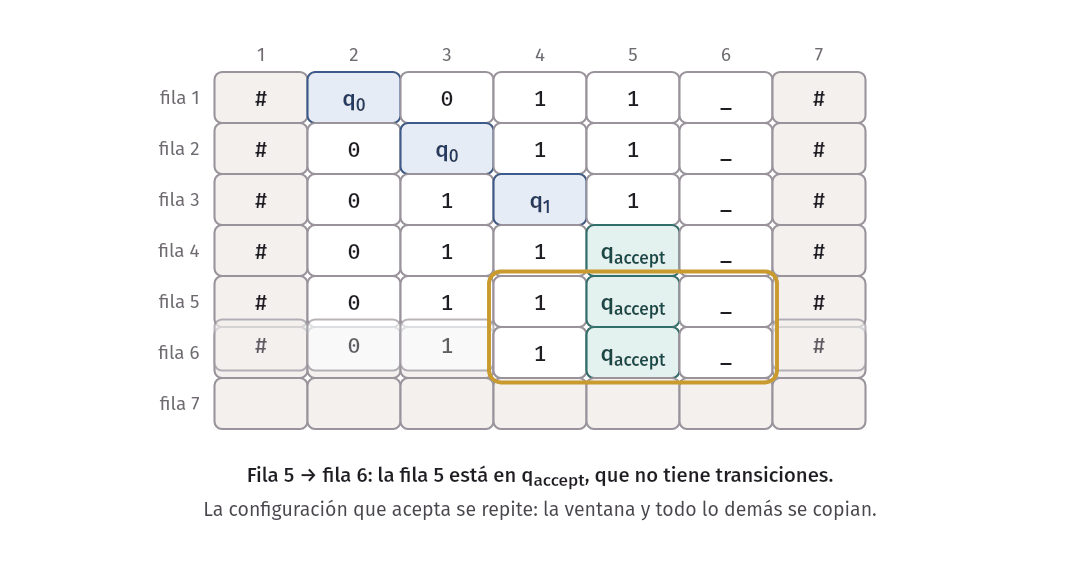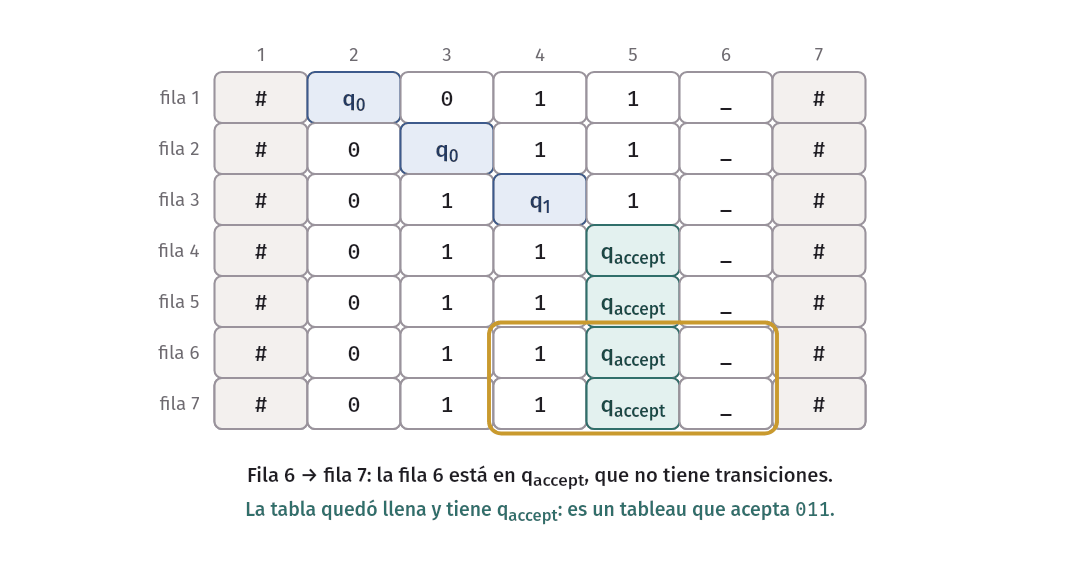
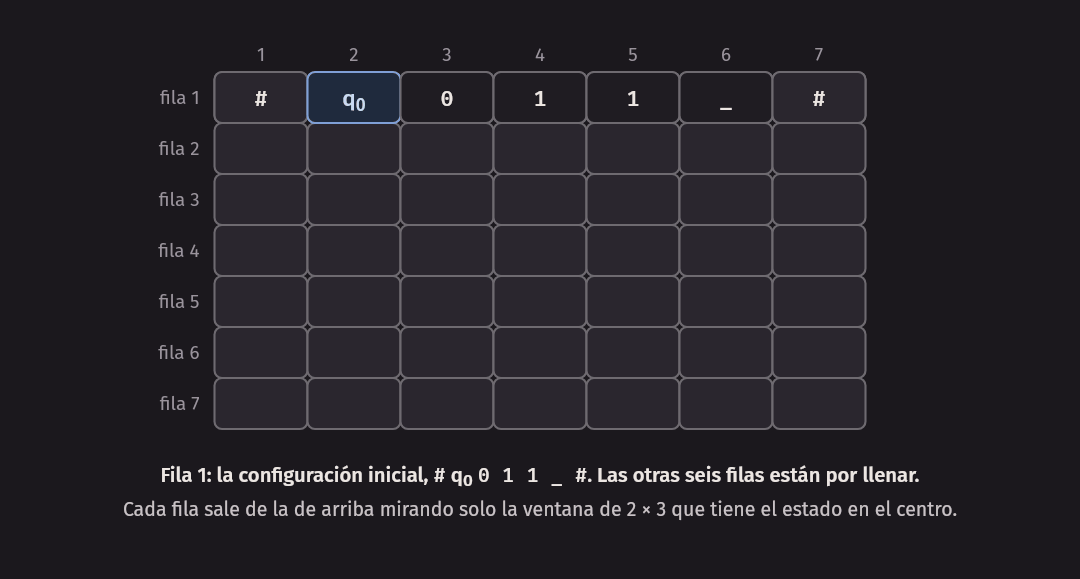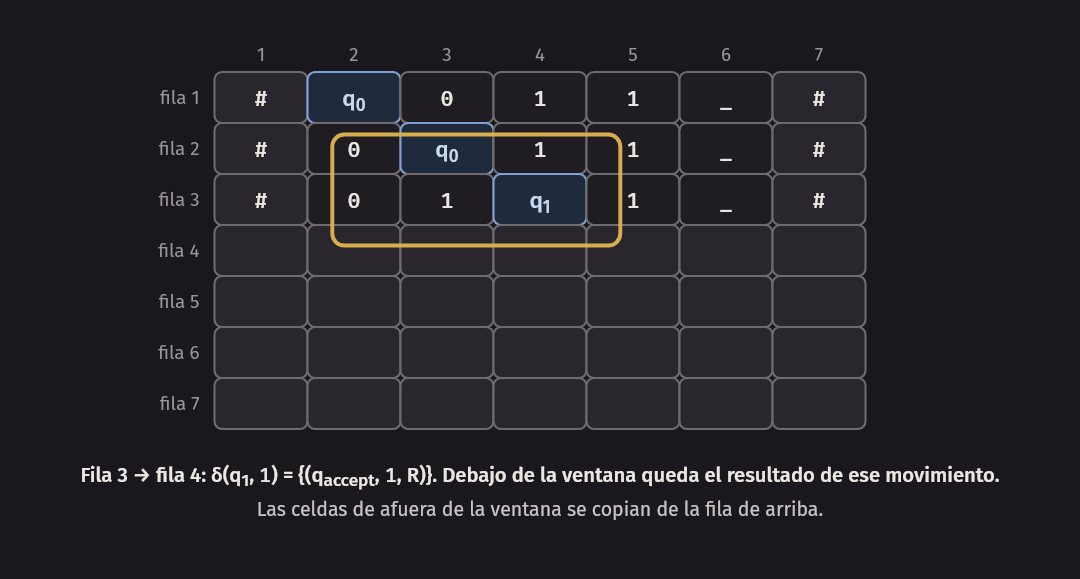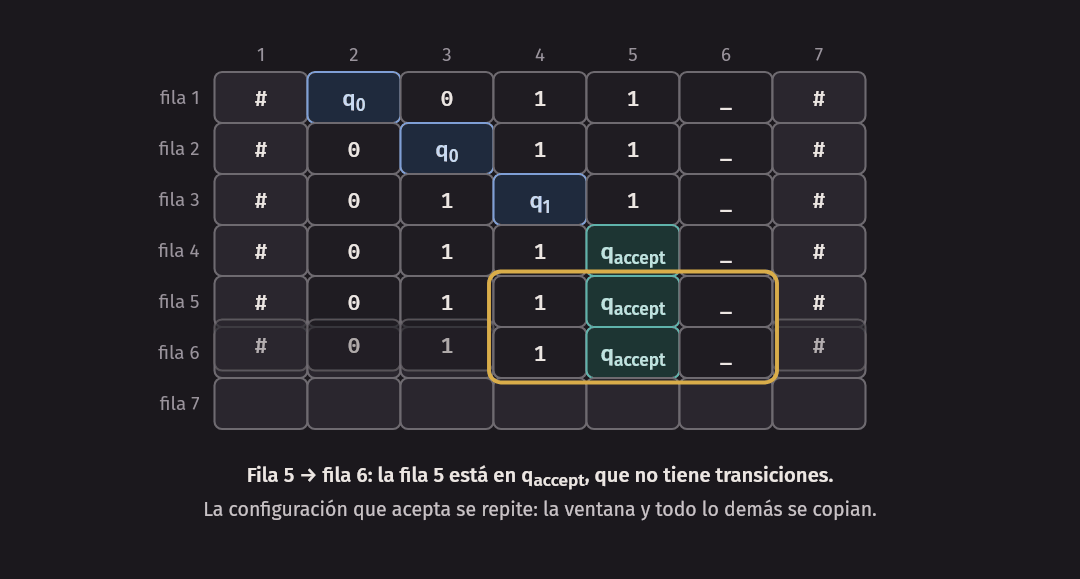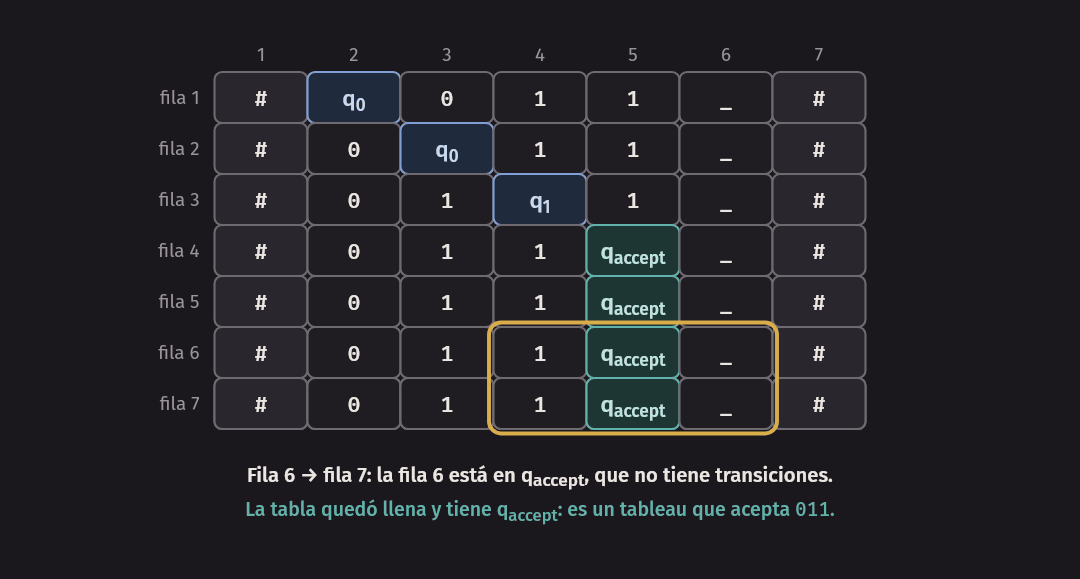
Definición. Una ventana es legal para si aparece en algún paso de . Con precisión: si existen un ancho y dos filas de celdas que son configuraciones, y debajo , tales que
- sale de por un paso de , o bien está en y ,
y la ventana es el bloque de tres columnas seguidas de esas dos filas.
Que una ventana sea legal depende solo de . No depende de ni de : es una lista finita que se calcula una vez por máquina.
Con la máquina de ejemplo y el movimiento , estas son tres ventanas legales y tres ilegales:
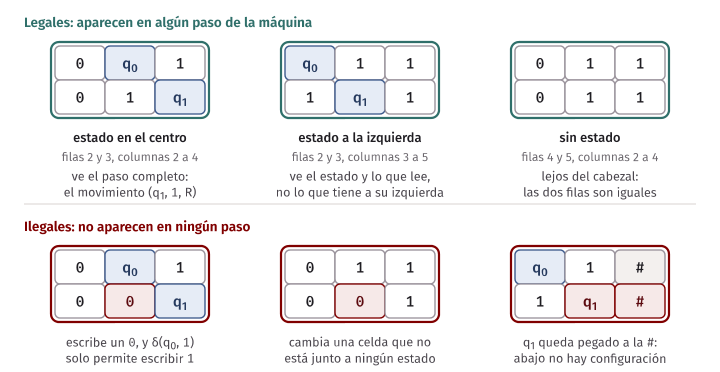
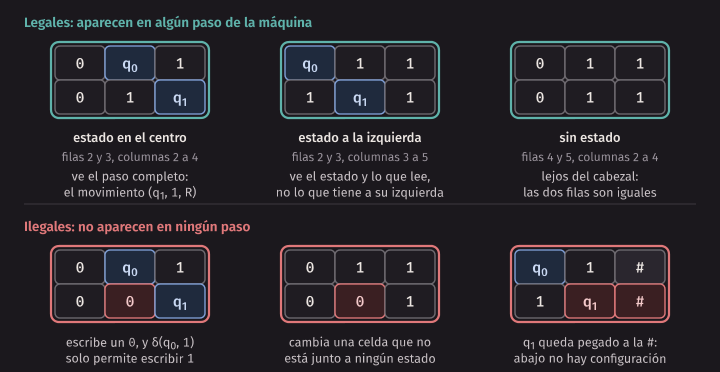
Las dos primeras legales están entre las filas 2 y 3 del tableau de arriba, y la tercera entre las filas 4 y 5. La primera tiene el estado en el centro y ve el paso completo: el estado, lo que lee y lo que tiene a la izquierda. La segunda tiene el estado a la izquierda. La tercera está lejos del cabezal, y sus dos filas son iguales.
En la primera ilegal, la máquina escribe un , y solo permite escribir
. En la segunda cambia una celda que no está junto a ningún estado. En la tercera el estado
queda pegado a la , y esa fila de abajo no es parte de ninguna configuración. El programa
windows responde por cualquier ventana:
$ build/windows machines/contains_11.tm 0 q0 1 0 1 q1
0 q0 1
0 1 q1
legal
$ build/windows machines/contains_11.tm 0 q0 1 0 0 q1
0 q0 1
0 0 q1
ilegal
Las cuatro formas
Para programar la lista hay que saber qué ventanas aparecen en un paso. Sea la columna del estado en la fila de arriba. Un paso con el movimiento cambia solo las columnas , y :
columna:    p-1  p   p+1            p-1  p   p+1            p-1  p   p+1
arriba:      x   q    a              x   q    a              #   q    a
abajo:       x   b    r              r   x    b              #   r    b
            movimiento R            movimiento L        L en la primera celda
Con , el símbolo escrito queda donde estaba el estado y el estado nuevo avanza. Con , el estado retrocede y el símbolo que tenía a la izquierda pasa a su derecha. Si a la izquierda está la , el cabezal ya está en la primera celda y no se mueve.
Una ventana ocupa tres columnas seguidas, y según dónde caiga respecto de ve todo el paso, una parte o nada. De ahí salen cuatro formas. En la tabla, es un movimiento de la máquina.
| Forma | Arriba | Abajo | Cuándo |
|---|---|---|---|
| 1. Estado en el centro | , con | ||
| y | |||
| y | |||
| 2. Estado a la izquierda | , con | y | |
| , para cada | |||
| 3. Estado a la derecha | , con y | para algún | |
| para algún | |||
| 4. Sin estado | , con e , no los dos | siempre | |
| para algún | |||
| para algún | |||
| y para algunos , | |||
| Aceptación | , , , con y | igual a la de arriba | siempre |
Cada línea sale de mirar el dibujo del paso desde una ventana corrida:
- Forma 1. La ventana ocupa las columnas , , : ve todo lo que cambia, y su fila de abajo es exactamente el resultado de un movimiento.
- Forma 2. La ventana ocupa , , . Ve el estado y lo que lee, pero no el símbolo de su izquierda. Con , ese símbolo desconocido baja a su primera celda, y por eso vale cualquier ; o el cabezal estaba en la primera celda y se queda. Con , el estado nuevo queda en la columna y necesita leer la : si ahí está la , la configuración siguiente no cabe en la fila, y no hay ventana legal.
- Forma 3. La ventana ocupa , , . No ve qué lee el estado, así que vale el efecto de cualquier movimiento desde .
- Forma 4. No hay estado en la fila de arriba. Si el estado está lejos, nada cambia. Si está justo a la izquierda de la ventana, lee y puede cambiar esa celda. Si está justo a la derecha, puede entrar con un movimiento . La celda del centro siempre se copia.
- Aceptación. La convención de repetir la configuración que acepta.
El programa las cuenta:
$ build/windows machines/contains_11.tm
|Γ| = 3, |Q| = 4, |C| = 8
ventanas posibles: 8^6 = 262144
ventanas legales:  193
  con el estado en el centro:    28
  con el estado a la izquierda:  24
  con el estado a la derecha:    48
  sin estado arriba:             93
De las maneras de llenar seis celdas con ocho símbolos, 193 son legales. La opción --lista las escribe
todas. Las que tienen arriba , por ejemplo, son ocho: dos movimientos posibles por cuatro
valores de .
$ build/windows machines/contains_11.tm --lista | grep ' q0 1 /'
0 q0 1 / 0 1 q0
0 q0 1 / 0 1 q1
1 q0 1 / 1 1 q0
1 q0 1 / 1 1 q1
_ q0 1 / _ 1 q0
_ q0 1 / _ 1 q1
# q0 1 / # 1 q0
# q0 1 / # 1 q1
La tabla de las cuatro formas es una manera de calcular la lista, y la definición es la de arriba: aparecer en
un paso. Que las dos coinciden se comprueba mirando los casos, y también por fuerza bruta: test_tableau
recorre todas las configuraciones de la máquina en filas con hasta 6 celdas entre las dos (7 con
las máquinas más chicas), da todos los pasos posibles, junta las ventanas que aparecen y compara con lo que da
la tabla. Lo hace con las máquinas de machines/ y con 30 máquinas al azar.
Grupo 3: cada ventana es legal
Sea el conjunto de las ventanas legales de . El grupo dice que en cada una de las posiciones hay alguna de ellas:
Para cada posición hay una disyunción con un término por ventana legal, y cada término es la conjunción de seis variables: “en estas seis celdas está exactamente esta ventana”. Esta parte de la fórmula no está en CNF, y para el teorema no hace falta: SAT admite cualquier fórmula. En la sesión B la pasamos a CNF.
Por qué bastan las ventanas
Falta la parte de la demostración que justifica todo lo anterior: si la fila de arriba es una configuración y todas las ventanas entre dos filas son legales, la fila de abajo es una configuración que sale de la de arriba por un paso. No es evidente. Las ventanas se revisan por separado, y con una máquina no determinista cada una podría, en principio, corresponder a un movimiento distinto.
De la definición de ventana legal salen cuatro propiedades. En todas, la ventana aparece en un paso entre dos filas que son configuraciones, con el estado de la fila de arriba en la columna .
- (P1) Sin estado arriba, el centro se copia. Si , , no son estados, entonces . Por qué: un paso solo cambia las columnas , y . Si la columna del centro fuera una de esas, alguna de las tres columnas de la ventana sería la , y arriba habría un estado.
- (P2) Con el estado en el centro, la ventana ve el paso completo. Si es un estado distinto de , entonces es lo que deja en las columnas , , un movimiento , como en el dibujo del paso. Si , la fila de abajo es igual a la de arriba. Por qué: las tres columnas de la ventana son justo las que el paso cambia.
- (P3) Las no se mueven. si y solo si , y lo mismo con y . Por qué: en las dos filas, las están en la primera y en la última columna, y en ninguna otra.
- (P4) Ningún estado queda pegado a la derecha. En una ventana legal no pasa que sea un estado y . Por qué: la fila de abajo es una configuración.
Lema (de las ventanas). Sea la fila de una tabla una configuración , y supongamos que las ventanas entre las filas e son legales. Entonces la fila es una configuración , y o bien sale de por un paso de , o bien está en y .
Demostración. Directa, columna por columna. Sean las celdas de la fila y las de la fila . Como la fila es una configuración, tiene un solo estado, , con . A su derecha está el símbolo que lee, , y a su izquierda , que es un símbolo de o, si , la .
Las tres columnas del cabezal. La ventana de las columnas , , existe, porque y , y tiene el estado en el centro. Por (P2), es el resultado de un solo movimiento , o es una copia si . Aquí se elige el movimiento, una sola vez y para las tres celdas juntas.
Las demás columnas. Sea una columna distinta de , y . Si , la ventana de las columnas , , no tiene ningún estado arriba, porque ninguna de las tres es la . Por (P1), . Si o , la celda es y está en la esquina de una ventana, y por (P3) .
Entonces la fila es la fila con las columnas , , cambiadas por el resultado del movimiento elegido. Eso es, celda por celda, lo que el movimiento hace con .
La fila de abajo es una configuración. Tiene las en su lugar, un solo estado y símbolos de en lo demás. Falta ver que el estado tiene una celda a su derecha. Si el movimiento es o es la copia, el estado queda en la columna o en la , y a su derecha hay un símbolo. Si es , el estado queda en la columna . La ventana de las columnas , , existe, porque , y tiene abajo a en el centro. Por (P4), : hay una celda de cinta a la derecha de .
Así que la fila es la configuración que deja ese movimiento, y cabe en la fila. ∎
La demostración muestra dónde está el peligro y por qué no ocurre. Las ventanas vecinas a la del cabezal (formas 2 y 3) admiten varios movimientos, pero comparten celdas con la ventana del centro, y esa ya fijó las tres celdas que cambian. Las ventanas se superponen, y la superposición las obliga a ponerse de acuerdo.
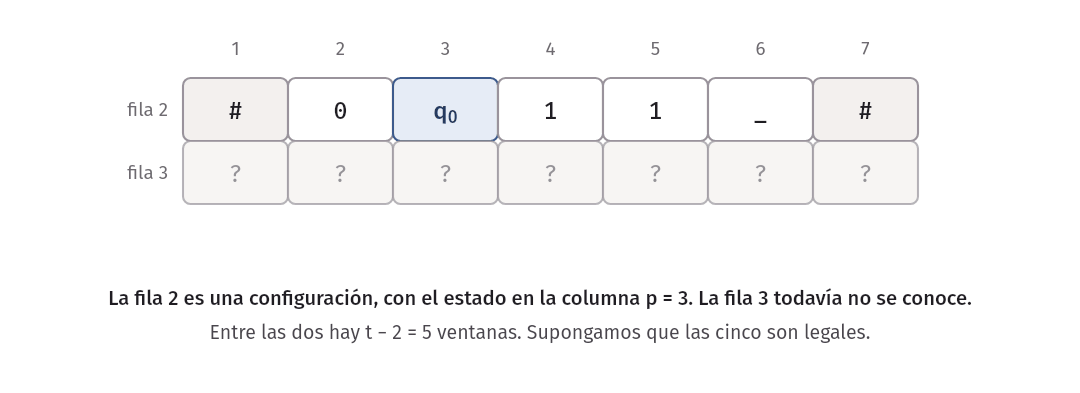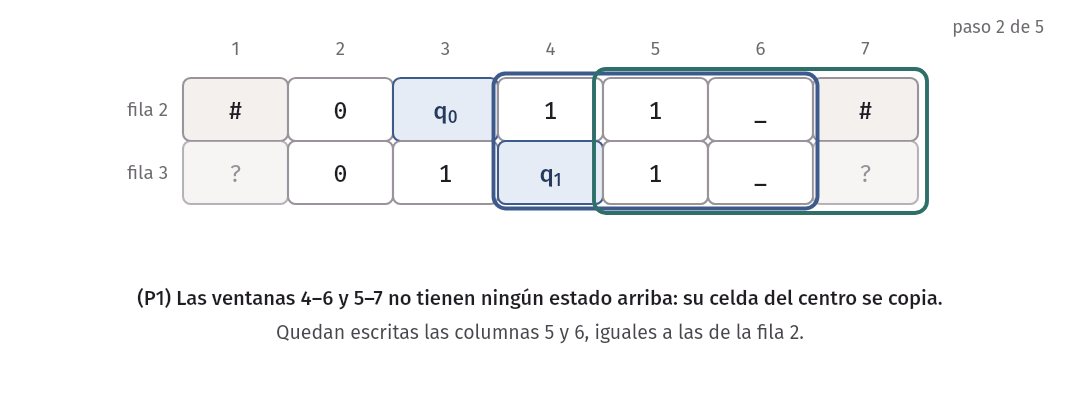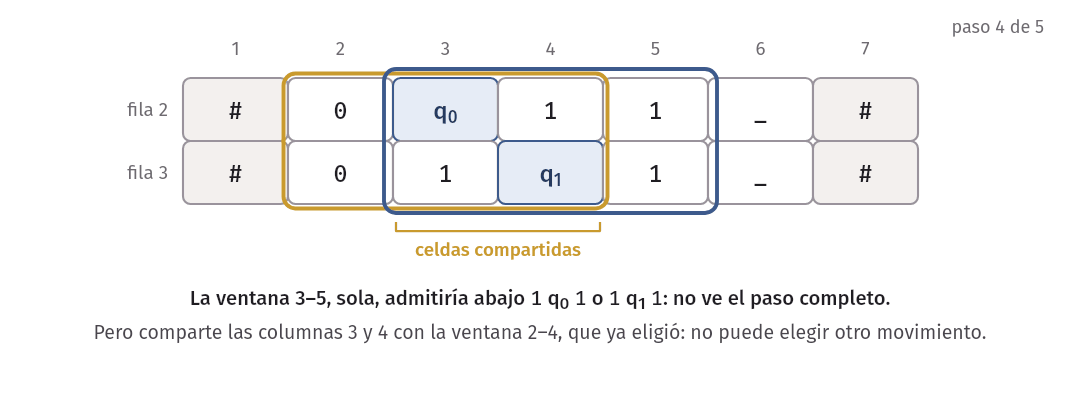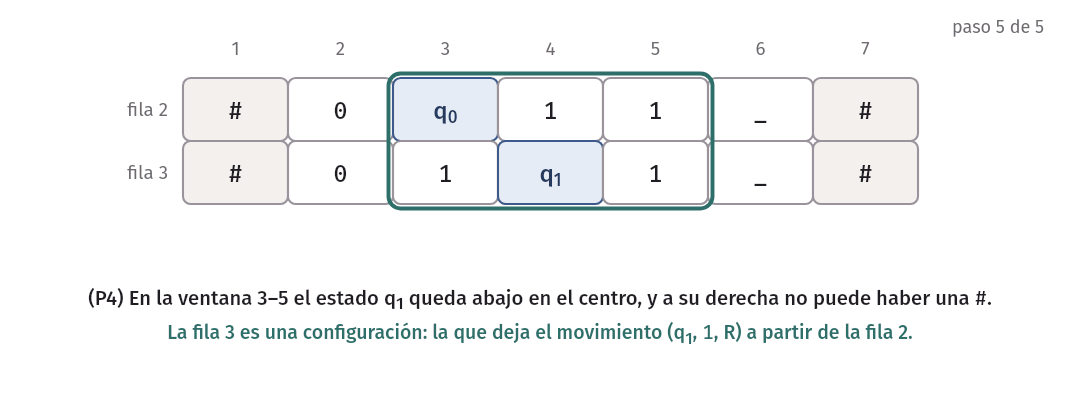
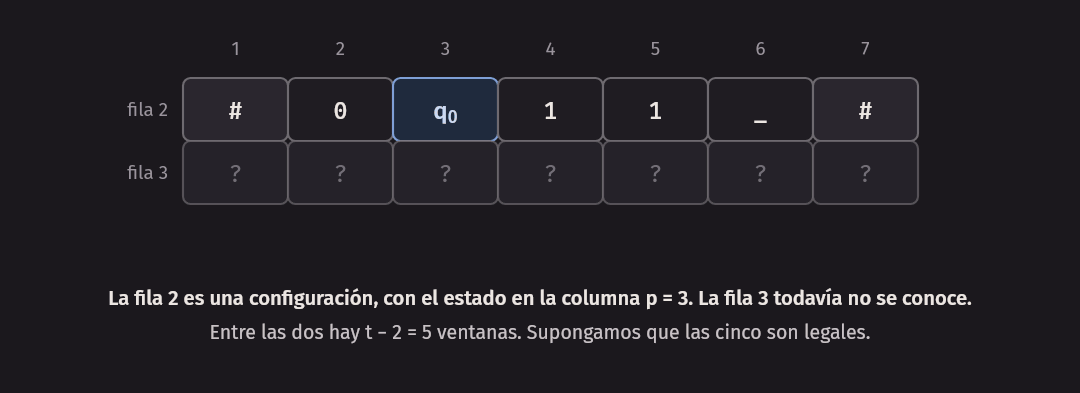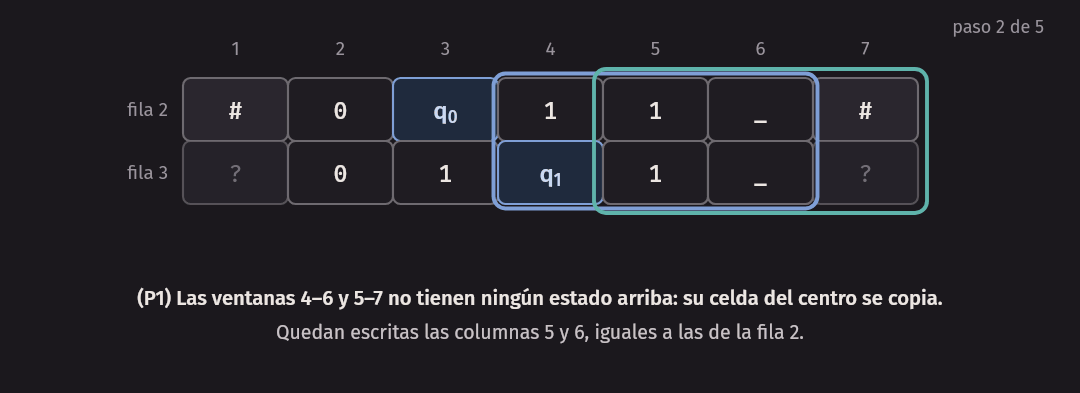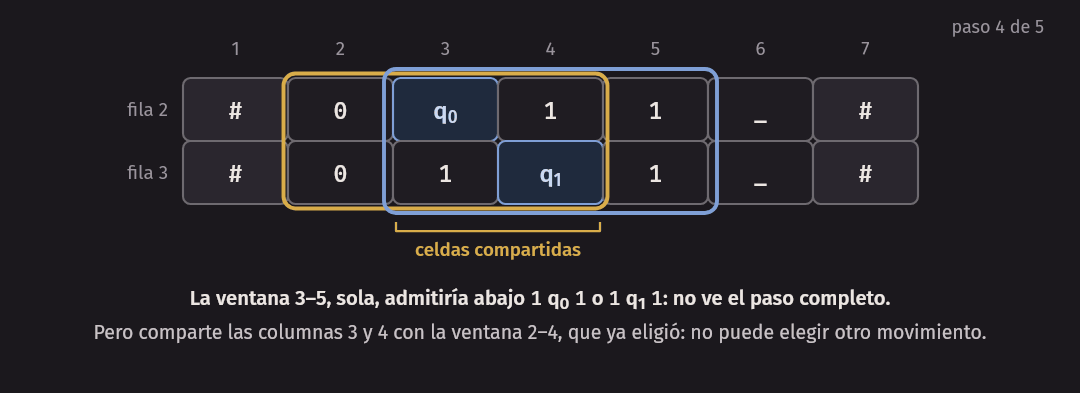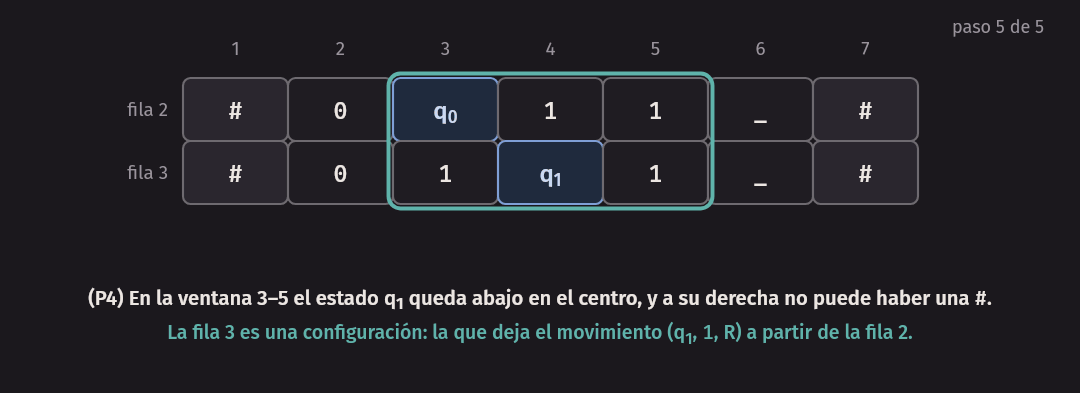
El lema también vale al revés, y esa dirección es inmediata: si sale de por un paso y las dos caben, todas las ventanas entre sus filas son legales, porque “aparecer en un paso” es la definición.
test_tableau comprueba el lema sin pasar por la demostración. Para cada configuración que cabe en una fila
de 4, 5 o 6 celdas, busca todas las filas de abajo que dejan legales las ventanas, probando los
símbolos en cada celda, y compara con las configuraciones que da un paso de la máquina:
test_tableau: ok (el lema de las ventanas con 5358 filas)Idea clave. La máquina de Turing es local: en un paso solo cambia lo que está junto al cabezal. Por eso una condición sobre toda la tabla se puede partir en condiciones sobre trozos de tamaño fijo, y por eso la fórmula tiene un tamaño razonable. Las historias de cómputo de la semana 10 usaban la misma localidad con fichas de PCP y con gramáticas. Aquí se usa con cláusulas.
El tamaño de la fórmula
Una reducción tiene que calcularse en tiempo polinomial, así que hay que contar. Sea y sea la cantidad de ventanas legales. Las cantidades y dependen de la máquina y no de la entrada: para la demostración son constantes. Como una ventana tiene seis celdas, .
| Parte | Cuánto mide |
|---|---|
| Variables | variables |
| celdas, cada una con literales | |
| literales | |
| posiciones, cada una con literales | |
| literales |
En total hay variables y literales, con constantes que dependen de . Cada variable se escribe con su número, que tiene dígitos, así que la fórmula ocupa símbolos. Es un polinomio en .
Y se escribe en tiempo polinomial. La lista de ventanas legales se calcula una vez, mirando . Después, la fórmula son cuatro ciclos sobre las celdas, que escriben siempre el mismo patrón. La reducción no ejecuta la máquina: solo copia su tabla de transiciones, convertida en ventanas, en cada posición de la tabla.
La respuesta a la pregunta de repaso 3 queda así: si la máquina corre en tiempo , la fórmula tiene
variables.
La fórmula es satisfacible si y solo si la máquina acepta
Con los dos lemas, lo que queda es corto.
Afirmación. es satisfacible si y solo si acepta .
Demostración. Por el lema del tableau, basta mostrar que es satisfacible si y solo si existe un tableau de lado que acepta .
Si existe un tableau que acepta : se hace verdadera exactamente cuando la celda del tableau contiene . Cada celda tiene un solo símbolo, y se cumple . La fila 1 es la configuración inicial, y se cumple . Dos filas seguidas son un paso de o la repetición de una configuración que acepta, así que cada ventana entre ellas aparece en un paso: es legal por definición, y se cumple . Alguna fila está en , y se cumple .
Si es satisfacible: se toma una asignación que la cumple. Por describe una tabla. Por , la fila 1 es la configuración inicial con , que es una configuración porque . Por todas las ventanas son legales, y el lema de las ventanas, aplicado a las filas por inducción, dice que cada fila es una configuración que sale de la anterior por un paso, o la repite si ya aceptó. Por , alguna celda contiene : alguna fila está en ese estado. La tabla es un tableau que acepta . ∎
Demostración del teorema de Cook-Levin. SAT está en NP. Para ver que es NP-difícil, sea un lenguaje de NP y una máquina no determinista que lo decide en tiempo . La función que a cada le asigna , la fórmula construida con , y , se calcula en tiempo polinomial, y
Entonces . Como era un lenguaje cualquiera de NP, SAT es NP-difícil. ∎
Hay una reducción distinta para cada lenguaje , porque cada uno tiene su máquina y su exponente . Lo que es común a todas es la manera de construir la fórmula.
La reducción, ejecutada
Todo lo anterior se puede correr. El programa tableau_cnf recibe una máquina, una entrada y el lado , y
escribe la fórmula en DIMACS. El lado se da a mano: el programa no sabe cuál es la cota de tiempo de la
máquina. Lo que garantiza, por los dos lemas, es esto:
la fórmula es satisfacible si y solo si acepta con una ejecución que cabe en el tableau de lado : a lo sumo pasos, y el cabezal dentro de las primeras celdas de la cinta.
Con igual a la cota de tiempo más 4 caben todas las ejecuciones, y es el teorema.
$ build/tableau_cnf machines/contains_11.tm 011 7 > build/f.cnf
$ minisat -verb=0 build/f.cnf build/f.res
SATISFIABLE
$ build/decode_tableau machines/contains_11.tm 011 7 build/f.res
#        q0       0        1        1        _        #
#        0        q0       1        1        _        #
#        0        1        q1       1        _        #
#        0        1        1        q_accept _        #
#        0        1        1        q_accept _        #
#        0        1        1        q_accept _        #
#        0        1        1        q_accept _        #
es una ejecución de la máquina: acepta en 3 pasos
minisat deja en build/f.res una asignación de las variables. decode_tableau mira, en cada celda, cuál de
sus ocho variables es verdadera, imprime la tabla y la comprueba sin usar la fórmula: revisa con el
simulador que cada fila sale de la anterior por un paso de la máquina. Es el tableau que escribimos a mano
unas secciones atrás.
Miren la fila 3. En la fila 2 la máquina estaba en leyendo un , y tenía dos movimientos.
Nadie programó cuál elegir: en ningún lugar del generador hay una búsqueda. La fórmula solo dice que alguna
celda debe contener q_accept, y minisat encontró que para eso la fila 3 debía tener q1.
Con la fórmula no se puede cumplir, aunque la máquina acepta :
$ build/tableau_cnf machines/contains_11.tm 011 6 > build/g.cnf
$ minisat -verb=0 build/g.cnf build/g.res
UNSATISFIABLE
$ build/decode_tableau machines/contains_11.tm 011 6 build/g.res
UNSAT: ningún tableau de 6 × 6 acepta
En una fila de 6 celdas hay 3 de cinta, y la rama que acepta termina con el cabezal en la cuarta. La ejecución no cabe. Por eso en la demostración importa elegir el lado con cuidado: una tabla demasiado chica cambia la respuesta. Y con una entrada que la máquina rechaza, ningún lado sirve:
$ build/tableau_cnf machines/contains_11.tm 010 8 > build/g.cnf
$ minisat -verb=0 build/g.cnf build/g.res
UNSATISFIABLE
Con una máquina determinista hay un solo tableau posible, y minisat no tiene nada que elegir. Esta es la
máquina de de la semana 7 con la entrada , que acepta en 5 pasos:
$ build/tableau_cnf machines/zeros_ones.tm 01 7 > build/g.cnf
$ minisat -verb=0 build/g.cnf build/g.res
SATISFIABLE
$ build/decode_tableau machines/zeros_ones.tm 01 7 build/g.res
#        q0       0        1        _        _        #
#        X        q1       1        _        _        #
#        q2       X        Y        _        _        #
#        X        q0       Y        _        _        #
#        X        Y        q3       _        _        #
#        X        Y        _        q_accept _        #
#        X        Y        _        q_accept _        #
es una ejecución de la máquina: acepta en 5 pasos
De la fila 2 a la fila 3 el estado retrocede, y el símbolo X que tenía a la izquierda pasa a su derecha: es
la segunda línea de la forma 1.
Cuánto mide
La opción --cuenta dice cuántas variables y cláusulas tiene la fórmula que escribe el programa. Su grupo 3
está ya en CNF, con unas variables adicionales que se explican en la sesión B; por eso hay “variables de
ventanas”.
$ build/tableau_cnf machines/contains_11.tm 011 7 --cuenta
t = 7, |C| = 8, ventanas legales = 193
variables de celdas:    392
variables de ventanas:  5790
variables en total:     6182
cláusulas del grupo 1:  1421
cláusulas del grupo 2:  7
cláusulas del grupo 3:  34770
cláusulas del grupo 4:  1
cláusulas en total:     36199
Las cuentas de la sección anterior dan esos números. Las variables de las celdas son . El grupo 1 tiene, por celda, una cláusula de “al menos uno” y de “no los dos”: . El grupo 2 tiene . El grupo 3 tiene posiciones de ventana.
Al crecer , todo crece como :
| Variables | Cláusulas | |
|---|---|---|
| 5 | 2516 | 14 639 |
| 10 | 14 696 | 86 359 |
| 20 | 69 206 | 407 999 |
| 40 | 298 826 | 1 764 079 |
Son las salidas de build/tableau_cnf machines/contains_11.tm 11 t --cuenta para cada . Al duplicar ,
las cláusulas se multiplican por 5,9, por 4,7 y por 4,3: se acercan a 4, que es lo que da un polinomio de grado
2. Para una máquina fija, la fórmula es cuadrática en el lado de la tabla.
La constante es grande. Una máquina de cuatro estados con una entrada de tres símbolos da una fórmula de 36 199 cláusulas. Con la máquina de , que tiene 1109 ventanas legales, la tabla de lado 7 da 202 941. Nadie resuelve un problema así; la reducción existe para demostrar el teorema.
Error común. Creer que la fórmula “simula” a la máquina. La fórmula no calcula nada: es una lista de condiciones que describe cómo se vería una ejecución que acepta. Encontrar esa ejecución es trabajo de quien resuelve SAT, y ahí queda toda la dificultad. Tampoco la reducción simula: para escribir la fórmula se mira la tabla de transiciones y la longitud de , y no se da ni un paso de la máquina. Si la reducción tuviera que recorrer el árbol de ejecuciones para escribir la fórmula, tardaría un tiempo exponencial y no sería una reducción.
En la práctica. Esta manera de usar un solucionador SAT tiene nombre en la industria: verificación acotada de modelos (bounded model checking). Para saber si un circuito o un protocolo puede llegar a un estado de error en pasos, se escribe una fórmula con una copia de las variables del sistema por cada paso, cláusulas que dicen que cada copia sale de la anterior, y una cláusula que dice que alguna copia es el error. Es el tableau, con el estado de un circuito en lugar de la configuración de una máquina.
De la fórmula del tableau a una fórmula en CNF
La sesión A terminó con SAT NP-completo. Para diseñar reducciones, SAT es incómodo: una fórmula cualquiera tiene paréntesis anidados y operaciones mezcladas. En Algoritmos todas las reducciones partían de 3-SAT, donde la fórmula es una lista de cláusulas de tres literales. Esta sesión baja de SAT a 3-SAT en dos escalones, y en los dos aparece la misma idea.
Definición. Un literal es una variable o su negación. Una cláusula (clause) es una disyunción de literales. Una fórmula está en forma normal conjuntiva, o CNF, si es una conjunción de cláusulas.
El primer escalón es mostrar que SAT sigue siendo NP-completo cuando la fórmula está en CNF. Para eso alcanza con escribir en CNF la fórmula del tableau. Tres de sus cuatro grupos ya lo están:
| Grupo | Forma | ¿CNF? |
|---|---|---|
| Cláusulas de literales y de 2 literales | sí | |
| cláusulas de 1 literal | sí | |
| 1 cláusula de literales | sí | |
| Conjunción de disyunciones de conjunciones | no |
Queda . Para cada posición de ventana tiene una subfórmula de esta forma, con un término por ventana legal:
Hay tres maneras de pasarla a CNF. Las tres sirven para el teorema y solo una sirve para programar.
Primera manera: distribuir
La ley distributiva convierte una disyunción de conjunciones en una conjunción de disyunciones: equivale a . Hay una cláusula por cada manera de elegir un literal de cada término. Con términos de 6 literales salen cláusulas, cada una de literales.
Eso es exponencial en . Pero depende de la máquina y no de la entrada: para una fija, es una constante, y la fórmula en CNF sigue teniendo tamaño . Para la demostración alcanza. Para un programa, no: con la máquina de ejemplo, y es un número de 151 dígitos, porque .
Si se distribuyera una fórmula cualquiera, la constante dejaría de serlo. La fórmula tiene literales, y al distribuirla salen cláusulas. Por eso “pasar a CNF” con equivalencias no es, en general, una reducción de tiempo polinomial.
Segunda manera: prohibir las ventanas ilegales
Cuando se cumple , en cada posición hay exactamente una ventana: la que forman los seis símbolos de esas celdas. Decir “es alguna de las legales” es lo mismo que decir “no es ninguna de las ilegales”, y lo segundo ya es CNF. Por cada posición y cada ventana ilegal se pone una cláusula de seis literales negados:
Son cláusulas por posición, sin variables nuevas. Con la máquina de ejemplo, . Es una constante mucho más razonable que , y aun así la tabla de lado 7, con sus 30 posiciones, tendría cláusulas solo en este grupo.
Tercera manera: variables nuevas
Es la que usa tableau_cnf. Por cada posición y cada ventana legal se agrega una variable nueva
, que se lee “en esta posición está la ventana ”. La subfórmula se reemplaza
por estas cláusulas:
La primera dice que alguna ventana legal está en esa posición. Las otras dicen que, si la elegida es la ,
sus seis celdas contienen lo que la ventana dice: es la implicación . Son
cláusulas y variables nuevas por posición. Con la máquina de ejemplo,
cláusulas en lugar de 261 951. Con las 30 posiciones de la tabla de lado 7 dan las 34 770 cláusulas del grupo 3
y las 5790 “variables de ventanas” que informó --cuenta.
La fórmula nueva no es equivalente a la vieja: tiene otras variables, y ni siquiera tiene sentido comparar sus tablas de verdad. Lo que se conserva es otra cosa.
Afirmación. Para cada asignación de las variables : se cumple si y solo si existen valores de con los que se cumplen todas las cláusulas nuevas.
Demostración. En las dos direcciones.
Si se cumple : algún es verdadero. Se pone verdadera y todas las demás falsas. La cláusula larga se cumple por . Las cláusulas con se cumplen porque es falsa. Las seis con se cumplen porque las seis variables de son verdaderas.
Si existen esos valores de las : por la cláusula larga, alguna es verdadera. Las seis cláusulas obligan entonces a que las seis variables de sean verdaderas. se cumple. ∎
Entonces la fórmula con las es satisfacible si y solo si la original lo es, y de una asignación que cumple
la nueva, la parte de las cumple la original. Por eso decode_tableau puede leer el tableau mirando solo
las primeras variables e ignorar las demás.
Idea clave. Una reducción no tiene que producir una fórmula equivalente. Tiene que conservar la respuesta: satisfacible va a satisfacible, e insatisfacible a insatisfacible. Dos fórmulas así se llaman equisatisfacibles. Agregar variables nuevas que nombran partes de la fórmula es la manera de evitar el crecimiento exponencial, y vuelve a aparecer en el escalón siguiente.
Lo mismo se puede hacer con cualquier fórmula, no solo con la del tableau. Se agrega una variable nueva por cada subfórmula , con unas pocas cláusulas que dicen que vale lo que vale en función de las variables de sus partes. Por ejemplo, para son , y . Al final se agrega la cláusula de un literal que dice que la variable de la fórmula completa es verdadera. La fórmula que sale está en CNF, tiene un tamaño lineal en el de la original y es equisatisfacible con ella. Se llama transformación de Tseitin, y es lo que hacen las herramientas que le pasan un circuito a un solucionador SAT. Con eso, para toda fórmula.
De CNF a 3-SAT
El segundo escalón es acortar las cláusulas.
Definición. En 3-SAT, la entrada es una fórmula en CNF en la que cada cláusula tiene exactamente tres literales, de tres variables distintas. La pregunta es si es satisfacible.
Es la definición de Algoritmos. Sipser permite que una cláusula repita un literal; las dos versiones son NP-completas con la misma demostración.
Teorema. 3-SAT es NP-completo.
Demostración. Por reducción desde SAT en CNF, que es NP-completo por lo anterior. La dirección es la de siempre: desde el problema que ya se sabe difícil, hacia el nuevo.
Está en NP: una fórmula de 3-SAT es una fórmula, y el certificado es la asignación.
Qué se construye. Cada cláusula se limpia y se reemplaza. Limpiar es quitar los literales repetidos y borrar la cláusula si contiene una variable y su negación, porque siempre se cumple. Una cláusula limpia de literales, , se reemplaza según . Las variables son nuevas y no se comparten entre cláusulas.
| Se reemplaza por | |
|---|---|
| 1 | |
| 2 | |
| 3 | la misma cláusula |
| la cadena de abajo, con variables nuevas y cláusulas |
Una cláusula vacía, que no se puede cumplir, se reemplaza por las 8 cláusulas sobre tres variables nuevas, que tampoco se pueden cumplir todas.
En la cadena, se lee “el literal verdadero está más adelante, después de ”. La primera cláusula dice: es , es o está más adelante. Cada una del medio dice: si está más adelante de , entonces es o está todavía más adelante. La última ya no puede pasar el encargo.
El programa three_sat aplica la construcción. Con la cláusula de la pregunta de repaso 4:
$ build/three_sat --ver < formulas/five.cnf
entrada, con 5 variables y 1 cláusulas:
  (x1 ∨ x2 ∨ x3 ∨ x4 ∨ x5)
salida, con 7 variables y 3 cláusulas:
  (x1 ∨ x2 ∨ x6)
  (¬x6 ∨ x3 ∨ x7)
  (¬x7 ∨ x4 ∨ x5)
Las variables nuevas son x6 y x7: son e , con el número siguiente al de la última variable de
la entrada.
Por qué conserva la respuesta. Como las variables nuevas de cada cláusula son solo suyas, alcanza con mostrar, para una cláusula y lo que la reemplaza, que una asignación de las variables originales cumple si y solo si se puede extender a las variables nuevas de modo que se cumpla todo el reemplazo. Limpiar no cambia cuándo se cumple una cláusula.
Cadena, si la asignación cumple : sea el primer literal verdadero. Se pone verdadera para y falsa para : las anteriores al literal verdadero dicen “está más adelante”, y las siguientes ya no. Hay que revisar las tres clases de cláusulas.
- La primera, : si se cumple por ; si , es verdadera.
- Una del medio, , con : si , es verdadera. Si , el literal del medio es , que es verdadero. Si , es falsa.
- La última, : si se cumple por ; si , entonces e es falsa.
Cadena, si la asignación no cumple : todos los son falsos, y ninguna elección de las sirve. La primera cláusula obliga a verdadera. Con verdadera y falso, la segunda obliga a verdadera. Así hasta verdadera, y entonces la última cláusula tiene sus tres literales falsos.
Cláusulas cortas. Con : si se cumple, las dos cláusulas se cumplen con cualquier ; si no, una pide y la otra . Con es igual, con las cuatro combinaciones de e .
Tiempo polinomial. Una cláusula de literales produce a lo sumo cláusulas, así que la salida es lineal en la entrada. ∎
Error común. Decir que la fórmula de 3-SAT “es equivalente” a la original. No lo es. Con la cláusula de cinco literales y la asignación que hace verdadera solo a , la salida de arriba se cumple si y son verdaderas, y no se cumple si es falsa: la primera cláusula quedaría con sus tres literales falsos. La misma asignación de las variables originales sirve o no según las variables nuevas. Lo que se conserva es que exista una asignación.
Aplicada a la fórmula del tableau de la sesión A, la construcción parte sobre todo las cláusulas largas: las 30 de 193 literales del grupo 3 y la de 49 del grupo 4. Y rellena las cortas, que son la mayoría.
$ build/three_sat < build/f.cnf > build/f3.cnf
entrada: 6182 variables, 36199 cláusulas, la más larga de 193 literales
salida:  48299 variables, 78323 cláusulas, todas de 3 literales
$ minisat -verb=0 build/f3.cnf build/f3.res
SATISFIABLE
$ build/decode_tableau machines/contains_11.tm 011 7 build/f3.res
El último comando imprime el mismo tableau de antes, y termina con es una ejecución de la máquina: acepta en 3 pasos. Las variables de las celdas conservan sus números, así que el decodificador no nota la diferencia.
Con , la fórmula de 3-SAT es insatisfacible, igual que la original.
Juntando las dos sesiones: de una máquina no determinista y una entrada sale, en tiempo polinomial, una fórmula de 3-SAT que es satisfacible exactamente cuando la máquina acepta.
Lo que queda demostrado hasta el fondo
Con 3-SAT NP-completo, todo lo que hicieron en las semanas 13 y 14 de Algoritmos queda apoyado en una demostración completa. Ahí redujeron 3-SAT a conjunto independiente, con un triángulo por cláusula; 3-SAT a 3-coloreo, con gadgets de variable y de cláusula; conjunto independiente a cobertura de vértices y a clique; y cobertura de vértices a suma de subconjuntos. No repetimos esas construcciones. Lo que cambia es lo que se puede concluir de ellas.
todo lenguaje de NP
        │   Cook-Levin: el tableau
        ▼
       SAT
        │   variables nuevas
        ▼
      3-SAT ──► conjunto independiente ──► cobertura de vértices ──► suma de subconjuntos
        │               └──► clique
        ├──► 3-coloreo
        └──► camino hamiltoniano (la sección siguiente)
Cada flecha es una reducción en tiempo polinomial, y las reducciones se componen. Antes de esta semana, el dibujo empezaba en SAT y decía “estos problemas son al menos tan difíciles como SAT”. Ahora empieza en todo NP: cualquier problema de NP se reduce a cualquiera de los de abajo. Y como todos los de abajo están en NP, se reducen también entre sí, pasando por SAT. Son, en un sentido preciso, el mismo problema escrito de maneras distintas.
De ahí la frase que resume la teoría: basta que uno solo de ellos esté en P para que todos lo estén, y con ellos todo NP. Un algoritmo polinomial para colorear grafos con tres colores sería también uno para la suma de subconjuntos, para SAT y para cualquier problema cuyas soluciones se puedan verificar rápido. Y al revés: si alguno no está en P, ninguno lo está.
Se conocen miles de problemas NP-completos, de todas las áreas: horarios, rutas, empaquetado, plegamiento de proteínas, rompecabezas. Ninguno tiene un algoritmo polinomial conocido, y de ninguno se ha demostrado que no lo tenga.
De 3-SAT a camino hamiltoniano
Una reducción nueva, de un estilo distinto a las de Algoritmos. Allá, los gadgets usaban aristas para prohibir combinaciones: dos literales opuestos no podían estar juntos en el conjunto independiente. Aquí los gadgets obligan a un camino a recorrer el grafo de cierta manera.
Definición. Un camino hamiltoniano en un grafo dirigido es un camino que pasa por cada nodo exactamente una vez.
Teorema. HAMPATH es NP-completo.
Está en NP. Lo vieron la semana pasada: el certificado es la lista de los nodos en el orden del camino, y el verificador comprueba que están todos una vez, que empieza en , termina en y que cada par de nodos seguidos es una arista.
Es NP-difícil. Por reducción desde 3-SAT: de una fórmula se construye de modo que es satisfacible si y solo si tiene un camino hamiltoniano de a .
La construcción
Sea una fórmula con variables y cláusulas . El grafo tiene tres clases de piezas.
Un rombo por variable. El rombo de tiene una punta de arriba, , una punta de abajo, que es la
punta de arriba del rombo siguiente, , y una fila horizontal de nodos entre dos extremos, izq y
der. De la punta de arriba salen aristas a los dos extremos, y de los dos extremos salen aristas a la punta
de abajo. Los nodos de la fila están unidos con sus vecinos en los dos sentidos.
          ┌───────────────────────── d_i ─────────────────────────┐
          ▼                                                       ▼
         izq ⇄ sep0 ⇄ c1a ⇄ c1b ⇄ sep1 ⇄ c2a ⇄ c2b ⇄ sep2 ⇄ ··· ⇄ der
          │                                                       │
          └───────────────────────► d_i+1 ◄───────────────────────┘
Un camino que entra por y tiene que pasar por toda la fila tiene dos opciones: bajar a izq y recorrer
la fila de izquierda a derecha, o bajar a der y recorrerla de derecha a izquierda. Esa elección va a ser el
valor de : de izquierda a derecha es verdadero, de derecha a izquierda es falso.
La fila tiene un par de nodos por cláusula. Entre izq y der hay nodos: para cada cláusula
, un par de nodos seguidos, cja y cjb, y entre los pares, antes del primero y después del último,
un nodo separador. Son nodos de pares y separadores.
Un nodo por cláusula, con desvíos. Cada cláusula tiene un nodo propio, fuera de los rombos. Se conecta con el par de en el rombo de cada variable que aparece en ella:
x_i aparece en c_j                      ¬x_i aparece en c_j

          c_j                                     c_j
         ↗   ↘                                   ↙   ↖
··· ⇄ cja ⇄ cjb ⇄ ···                   ··· ⇄ cja ⇄ cjb ⇄ ···
Si aparece en , las aristas son cja cjb: un desvío que solo se puede tomar
recorriendo la fila de izquierda a derecha. Si aparece , son cjb cja: solo de
derecha a izquierda.
Finalmente, y .
El grafo tiene nodos: las puntas, las filas con sus dos extremos, y los nodos de cláusula. Las aristas son de los rombos, de las filas y 2 por cada literal de la fórmula. Todo es polinomial en el tamaño de , y se escribe recorriendo la fórmula una vez.
El programa hampath construye el grafo y busca el camino con backtracking. Con la fórmula :
$ build/hampath < formulas/two_clauses.cnf
fórmula: 3 variables, 2 cláusulas
  (x1 ∨ x2 ∨ ¬x3)
  (¬x1 ∨ x2 ∨ x3)
grafo: 33 nodos, 72 aristas
camino hamiltoniano de s a t:
  s x1.izq x1.sep0 x1.c1a x1.c1b x1.sep1 x1.c2a x1.c2b x1.sep2 x1.der d2 x2.izq x2.sep0 x2.c1a
  x2.c1b x2.sep1 x2.c2a c2 x2.c2b x2.sep2 x2.der d3 x3.der x3.sep2 x3.c2b x3.c2a x3.sep1 x3.c1b c1
  x3.c1a x3.sep0 x3.izq t
asignación leída del camino: x1 = V x2 = V x3 = F
cumple la fórmula
Las cuentas dan nodos y aristas. En el camino, los
rombos de y se recorren de izquierda a derecha y el de de derecha a izquierda. El nodo c2
se visita con un desvío desde el rombo de , entre x2.c2a y x2.c2b: la cláusula 2 tiene a , que es
verdadera. El nodo c1 se visita desde el rombo de , entre x3.c1b y x3.c1a: la cláusula 1 tiene a
, y es falsa.
Con las ocho cláusulas posibles sobre tres variables, que ninguna asignación cumple a la vez, no hay camino:
$ build/hampath < formulas/all_eight.cnf
...
grafo: 93 nodos, 216 aristas
no hay camino hamiltoniano de s a t
Una dirección, completa
Afirmación. Si es satisfacible, tiene un camino hamiltoniano de a .
Demostración. Por construcción del camino. Se toma una asignación que cumple .
El camino sin desvíos. Para , en orden: desde , si es verdadera se va a izq,
se recorre la fila de izquierda a derecha hasta der, y se baja a . Si es falsa, se va a der, se
recorre la fila de derecha a izquierda hasta izq, y se baja a . Todas esas aristas existen. El
camino empieza en , termina en y pasa una vez por cada nodo de los rombos. Solo le
faltan los nodos de cláusula.
Los desvíos. Para cada cláusula se elige uno de sus literales verdaderos; existe porque la asignación cumple .
- Si el elegido es , entonces es verdadera y la fila de su rombo se recorre de izquierda a derecha:
el camino pasa de
cjaacjb. Ese paso se reemplaza porcjacjb, que son las dos aristas que se pusieron por aparecer en . - Si el elegido es , entonces es falsa y la fila se recorre de derecha a izquierda: el camino
pasa de
cjbacja. Se reemplaza porcjbcja.
Es hamiltoniano. Cada nodo de cláusula se agrega una sola vez, porque se eligió un solo literal. Los desvíos no se estorban: el de reemplaza un paso dentro del par de , y cláusulas distintas tienen pares distintos. El resultado es un camino de a que pasa una vez por cada nodo. ∎
test_hampath hace exactamente esto con cada asignación que cumple cada fórmula de prueba: construye el camino
con la función path_from_assignment y comprueba que es hamiltoniano.
La otra dirección, en una idea
Afirmación. Si tiene un camino hamiltoniano de a , es satisfacible.
No la demostramos completa. La idea es que un camino hamiltoniano no tiene más remedio que ser como los de arriba: recorre los rombos en orden, cada fila entera en un solo sentido, y cada desvío vuelve al mismo par del que salió. Lo único que podría romper eso es un camino que entra a un nodo de cláusula desde un rombo y sale hacia otro rombo. Los separadores existen para impedirlo.
Supongan que el camino recorre la fila de de izquierda a derecha, llega a cja, pasa a , y de ahí
sale a otro rombo. El nodo cjb de ese par quedó sin visitar. A cjb solo llegan aristas desde cja, desde
y desde el separador de su derecha. Los dos primeros ya están usados: el sucesor de cja en el camino
es , y el de es un nodo de otro rombo. Entonces a cjb solo se puede llegar desde el separador.
Pero de cjb solo salen aristas hacia cja, que ya fue visitado, y hacia ese mismo separador. El camino
moriría en cjb, que no es . Los otros casos se tratan igual: siempre queda un nodo de la fila al que solo
se puede entrar y salir por el mismo vecino.
Entonces el camino es de la forma normal, y de él se lee una asignación: es verdadera si su fila se recorre de izquierda a derecha. Cada nodo de cláusula se visita con un desvío desde algún rombo, y por cómo están orientadas sus aristas, ese desvío solo se puede tomar si el literal correspondiente es verdadero. Cada cláusula tiene un literal verdadero.
test_hampath comprueba las dos direcciones con 210 fórmulas pequeñas: la búsqueda encuentra un camino
exactamente cuando la fuerza bruta dice que la fórmula es satisfacible, y la asignación leída del camino
siempre cumple la fórmula.
De aquí salen más problemas. El camino hamiltoniano en grafos no dirigidos también es NP-completo, y de él se llega al problema del viajante. El contraste que vieron en Algoritmos sigue ahí: pasar una vez por cada arista es fácil, y se decide mirando los grados; pasar una vez por cada nodo es NP-completo.
2-SAT está en P
La construcción de la cadena parte cláusulas hasta dejarlas de tres literales. ¿Por qué no seguir hasta dos? Porque no se puede: al partir con una variable nueva sale , y la primera sigue teniendo tres. El eslabón necesita un lugar para el literal propio, uno para recibir el encargo y otro para pasarlo. Y no es una limitación de esta construcción: del otro lado del borde, el problema es fácil.
Teorema. 2-SAT, la satisfacibilidad de fórmulas en CNF con cláusulas de dos literales, está en P.
Lo vieron al final de Algoritmos, y lo recordamos con su criterio. Una cláusula dice dos implicaciones: si es falso, es verdadero, y si es falso, es verdadero. El grafo de implicaciones tiene un nodo por cada literal y, por cada cláusula , las aristas y .
Criterio. Una fórmula de 2-SAT es satisfacible si y solo si ninguna variable tiene a y a en la misma componente fuertemente conexa del grafo de implicaciones.
Idea de la demostración. Una asignación que cumple la fórmula no puede tener una arista de un literal verdadero a uno falso, y entonces tampoco un camino. Si y están en la misma componente, hay caminos de a y de a ; uno de los dos literales es verdadero y el otro falso, y uno de los dos caminos iría de verdadero a falso. No hay asignación.
Al revés, si ninguna variable tiene sus dos literales en la misma componente, se ordenan las componentes topológicamente y se hace verdadero, de cada par , , el literal cuya componente queda más tarde en el orden. Que eso no deja ninguna arista de verdadero a falso sale de la simetría del grafo: la arista existe si y solo si existe . ∎
Las componentes fuertemente conexas se calculan en tiempo lineal, con el algoritmo que vieron en Algoritmos. Por ejemplo, da las aristas
y con ellas : los cuatro literales están en una sola componente, y la fórmula no se puede cumplir. Son las cuatro cláusulas posibles sobre dos variables.
Idea clave. El borde entre lo fácil y lo difícil pasa entre 2 y 3. Con dos literales por cláusula, fijar un valor obliga a otro, y una cadena de obligaciones es un camino en un grafo. Con tres, fijar un valor solo deja una alternativa entre dos, y las alternativas se multiplican. El mismo borde aparece en el coloreo: con 2 colores es un recorrido del grafo, y con 3 es NP-completo.
coNP
NP está hecho de preguntas cuya respuesta sí tiene un certificado corto. La definición no trata igual al sí y al no, y eso se ve al dar vuelta un problema.
Los dos son, en el fondo, el mismo problema: es una tautología si y solo si no es satisfacible. Para convencer a alguien de que una fórmula es satisfacible basta mostrarle una asignación. ¿Qué se le muestra para convencerlo de que no lo es? La lista de las asignaciones, todas fallando, no es un certificado corto. Nadie conoce uno.
Recuerden la definición de la semana 12: es la clase de los lenguajes cuyo complemento está en NP:
Un lenguaje está en coNP si las respuestas no tienen certificado corto. UNSAT, que la semana 12 escribió , está en coNP, porque su complemento es SAT, salvo por las cadenas que no son fórmulas, que se reconocen en tiempo polinomial. TAUTOLOGY también.
no es el complemento de como conjunto de lenguajes. Las dos clases se superponen. P es cerrada bajo complemento, porque en una máquina determinista que siempre se detiene se pueden intercambiar aceptar y rechazar, y entonces
Un lenguaje de tiene certificados cortos para las dos respuestas. El ejemplo más conocido es la factorización, escrita como problema de decisión: dados y , ¿tiene un divisor con ? Para el sí, el certificado es el divisor. Para el no, es la factorización completa de en primos, todos mayores que : se multiplican para comprobar que dan , y que cada factor es primo se comprueba en tiempo polinomial. No se sabe si este problema está en P, y casi nadie cree que sea NP-completo, por lo que sigue.
Teorema. Si algún lenguaje NP-completo está en coNP, entonces .
Demostración. Sea NP-completo con , es decir, .
: sea . Hay una reducción con . Negando los dos lados, : la misma reduce a . Como , también : el certificado de es el de . Entonces .
: sea . Entonces , y por lo anterior , es decir, . ∎
Es la respuesta a la pregunta de repaso 5: si alguien demuestra que 3-SAT está en coNP, entonces , y toda fórmula insatisfacible tendría una demostración corta de que lo es.
Por qué se cree que . Porque nadie ha encontrado esos certificados, y se han buscado mucho: un sistema de demostración en el que toda tautología tenga una demostración de longitud polinomial es un objetivo viejo de la lógica. Para los sistemas que se conocen bien hay familias de fórmulas cuyas demostraciones más cortas son exponenciales; una aparece en la última sección de este capítulo.
Las dos conjeturas están relacionadas en un solo sentido. Si , entonces , porque P es cerrada bajo complemento. Dicho al revés: si , entonces . La segunda conjetura es más fuerte que la primera.
Lo que se cree, entonces, es este dibujo, con las cuatro regiones no vacías:
        ┌──────────── NP ────────────┐
        │   SAT, 3-SAT, HAMPATH      │
        │         ┌──────────────────┼───────────── coNP ─┐
        │         │  factorización   │                    │
        │         │      ┌─── P ───┐ │   UNSAT, TAUTOLOGY │
        │         │      │  2-SAT  │ │                    │
        │         │      └─────────┘ │                    │
        └─────────┼──────────────────┘                    │
                  └───────────────────────────────────────┘
Solo se sabe que P está dentro de la intersección. Todo lo demás del dibujo es conjetura.
Más allá. NP es “existe un certificado” y coNP es “para todo certificado”. Hay preguntas que necesitan los dos cuantificadores: “¿existe una fórmula más corta que y equivalente a ella?” pide que exista una fórmula tal que para toda asignación las dos coincidan. Las clases que se obtienen alternando una cantidad fija de cuantificadores forman la jerarquía polinomial, con NP y coNP en el primer nivel. No la estudiamos. La semana próxima veremos qué pasa cuando la cantidad de alternancias no tiene tope: las fórmulas booleanas cuantificadas, y la clase PSPACE.
Qué pasaría si P = NP
La pregunta lleva abierta desde 1971 y la mayoría de quienes trabajan en el área cree que . No hay demostración en ningún sentido. Conviene saber qué diría cada respuesta, sin exagerar ninguna.
Si :
- Todo problema de NP tendría un algoritmo polinomial: SAT, coloreo, horarios, rutas. Y no solo la versión de decisión. Con un algoritmo para SAT se encuentra una asignación preguntando variable por variable: se fija en verdadero y se pregunta si la fórmula sigue siendo satisfacible; si no, se fija en falso; y se sigue con . Son preguntas.
- , y la jerarquía polinomial entera sería igual a P.
- Encontrar demostraciones sería tan fácil como revisarlas. “¿Tiene este enunciado una demostración de a lo sumo símbolos?” está en NP, con la demostración como certificado y escrito en unario, para que el certificado tenga longitud polinomial en la entrada.
- La criptografía de clave pública que se usa hoy no sería segura. Romper un cifrado es, en esencia, un problema de NP: la clave es un certificado que se comprueba rápido.
Lo que no diría:
- Que los algoritmos sean prácticos. Un algoritmo de tiempo es polinomial. Y una demostración podría mostrar que el algoritmo existe sin decir cuál es.
- Nada sobre lo indecidible. El problema de la parada seguiría sin tener algoritmo. Tampoco diría que .
Si se demostrara que :
- Ningún problema NP-completo tendría un algoritmo polinomial. Es lo que ya se supone al diseñar: en la práctica cambiaría poco.
- No bastaría para la criptografía. Dice que cada algoritmo falla en algunas entradas, en el peor caso. Un cifrado necesita que casi todas las claves sean difíciles de romper, y eso es una afirmación sobre el caso típico, que no se sigue de la otra.
- No diría que los solucionadores SAT sean inútiles: siguen resolviendo las instancias que resuelven.
- Existirían problemas intermedios. Un teorema de Ladner dice que, si , hay lenguajes de NP que no están en P y tampoco son NP-completos.
Lo que una demostración traería, en cualquiera de los dos sentidos, es una técnica nueva. Las que conocemos no alcanzan, y en la semana 15 veremos una razón precisa: la diagonalización, que resolvió el problema de la parada, no puede resolver este.
Los solucionadores SAT en la práctica
Queda una aparente contradicción. SAT es NP-completo, y en este capítulo le dimos a minisat fórmulas de
decenas de miles de cláusulas que resolvió al instante.
NP-completo es una afirmación sobre el peor caso: no se conoce un algoritmo que sea rápido con todas las fórmulas. No dice nada de una fórmula en particular. Las del tableau son fáciles, y se ve en lo que informa el solucionador. Esta es la fórmula de la máquina de ejemplo con una entrada de 10 símbolos y , que tiene 69 206 variables y 407 999 cláusulas en un archivo de 5,9 MB:
$ build/tableau_cnf machines/contains_11.tm 0000000110 20 > build/big.cnf
$ minisat build/big.cnf build/big.res
...
restarts              : 1
conflicts             : 1              (32 /sec)
decisions             : 41             (0.00 % random) (1313 /sec)
propagations          : 71470          (2289018 /sec)
...
SATISFIABLE
Una decisión es una variable a la que el solucionador le da un valor por probar. Un conflicto es una vez que tuvo que volver atrás. Aquí decidió 41 veces y se equivocó una. Todo lo demás, 71 470 valores, salió por propagación: cláusulas en las que todos los literales menos uno ya eran falsos, y que obligan al que queda. La fórmula del tableau está hecha de implicaciones cortas, y fijada la primera fila casi todo se sigue solo. Las cifras entre paréntesis son velocidades y cambian de una corrida a otra; las cuentas no.
El peor caso existe, y no hace falta una fórmula grande. El principio del palomar dice que palomas no caben en casillas sin compartir alguna. Escrito como fórmula, con una variable por paloma y casilla, es insatisfacible, y el solucionador tiene que demostrarlo:
$ build/pigeonhole 9 > build/php.cnf
$ minisat build/php.cnf build/php.res
...
conflicts             : 551941         (231206 /sec)
decisions             : 669045         (0.00 % random) (280260 /sec)
...
UNSATISFIABLE| Casillas | Variables | Cláusulas | Conflictos |
|---|---|---|---|
| 6 | 42 | 133 | 1206 |
| 7 | 56 | 204 | 10 495 |
| 8 | 72 | 297 | 76 178 |
| 9 | 90 | 415 | 551 941 |
Son corridas del minisat del entorno del curso; otra versión puede dar otros números. Cada casilla más
multiplica los conflictos por más de 7. Con 90 variables y 415 cláusulas, medio millón de conflictos; con
69 206 variables y 407 999 cláusulas, uno. El tamaño de una fórmula dice poco de su dificultad.
Y esta familia no es mala suerte de un programa. Los solucionadores de este tipo, cuando responden
UNSATISFIABLE, han construido una demostración en un sistema llamado resolución, y está demostrado que toda
demostración por resolución del principio del palomar es exponencial. Es un caso concreto de lo que
afirma en general: fórmulas insatisfacibles sin demostración corta.
En la práctica. Que un problema sea NP-completo no cierra la conversación: la cambia. Reducir el problema a SAT y probar un solucionador es hoy una técnica normal de ingeniería, en verificación de circuitos, en planificación, en la resolución de dependencias de paquetes. Funciona porque las instancias que salen de problemas reales tienen estructura, como las del tableau. Lo que la teoría dice es qué no se puede prometer: que funcione siempre.
El código de la semana
code/week-13/
├── ntm.h                 struct Ntm, el formato .tm con varias líneas por par, configuraciones y pasos
├── tableau.h             las celdas, las filas, las ventanas legales y la comprobación de un tableau
├── cnf.h                 fórmulas en CNF: DIMACS, fuerza bruta y la llamada a minisat
├── cook_levin.h          la fórmula del tableau, grupo por grupo, y el paso de la asignación al tableau
├── three_sat.h           de CNF a 3-SAT
├── hampath.h             de 3-SAT a HAMPATH, el camino de una asignación y la búsqueda
├── random_ntm.h          máquinas pequeñas al azar, para las pruebas
├── run_ntm.cpp           el árbol de ejecuciones de una máquina, por niveles
├── windows.cpp           las ventanas legales de una máquina
├── tableau_cnf.cpp       la reducción: máquina, entrada y lado; sale la fórmula en DIMACS
├── decode_tableau.cpp    del resultado de minisat al tableau
├── three_sat.cpp         de una fórmula en DIMACS a una de 3-SAT
├── hampath.cpp           de una fórmula al grafo, y la búsqueda del camino
├── pigeonhole.cpp        el principio del palomar como fórmula
├── machines/             las máquinas del capítulo, en formato .tm
├── formulas/             las fórmulas pequeñas del capítulo, en DIMACS
├── errors/               tres descripciones que no son una máquina de Turing
├── test_ntm.cpp          el simulador y los lenguajes de las máquinas
├── test_tableau.cpp      las ventanas legales y el lema de las ventanas
├── test_cook_levin.cpp   la fórmula es satisfacible exactamente cuando la máquina acepta
├── test_three_sat.cpp    la reducción a 3-SAT conserva la respuesta
├── test_hampath.cpp      la reducción a HAMPATH, en las dos direcciones
└── lab/cook_levin/       el laboratorio
make compila todo, y make test corre las pruebas con ASan y UBSan. Necesitan minisat, que está en el
entorno del curso.
$ make test
test_ntm: ok (5 máquinas, 511 cadenas)
test_tableau: ok (el lema de las ventanas con 5358 filas)
test_cook_levin: ok (262 fórmulas, 64 satisfacibles)
test_three_sat: ok (400 fórmulas al azar, 300 satisfacibles)
test_hampath: ok (210 fórmulas, 155 satisfacibles)
Todas las pruebas pasaron.
Cada prueba comprueba una afirmación de este capítulo.
test_ntmcompara cada máquina demachines/con una función de C++ que decide el mismo lenguaje, sobre las 511 cadenas binarias de longitud a lo sumo 8.test_tableaucomprueba que la tabla de las cuatro formas da exactamente las ventanas que aparecen en pasos de verdad, las propiedades (P1) a (P4) y el lema de las ventanas, por fuerza bruta.test_cook_levines el teorema, ejecutado. Para cada máquina, entrada y lado, compara lo que respondeminisatcon un recorrido completo del árbol de ejecuciones, rama por rama. Cuando la fórmula es satisfacible, decodifica el tableau y comprueba que es una ejecución que acepta. También comprueba que las cantidades de variables y de cláusulas son las de las cuentas de la sección Cuánto mide, y que pasar la fórmula a 3-SAT no cambia la respuesta. De las 262 fórmulas, 144 salen de 36 máquinas generadas al azar.test_three_satcompara la fórmula original, resuelta por fuerza bruta, con la de 3-SAT, resuelta conminisat.test_hampathcomprueba el tamaño del grafo y las dos direcciones de la reducción.
Las máquinas de machines/ son:
| Archivo | Qué hace | Ventanas legales |
|---|---|---|
contains_11.tm |
Acepta las cadenas con . No determinista | 193 |
contains_01_back.tm |
Acepta las cadenas con : marca un y retrocede. No determinista | 453 |
left_end_accept.tm |
Acepta las que empiezan con , con un movimiento en la primera celda | 355 |
loop.tm |
No se detiene nunca | 189 |
wait.tm |
Acepta todo, cuando quiera: tiene ramas que no terminan | 282 |
zeros_ones.tm |
La máquina determinista de de la semana 7 | 1109 |
Para experimentar, prueben left_end_accept.tm con la entrada 0 y : en el tableau, el estado no cambia de
columna entre las filas 1 y 2. Es la tercera línea de la forma 1. Después prueben loop.tm con cualquier
entrada: la fórmula es insatisfacible con todo , y la única razón es el grupo 4.
El laboratorio
En lab/cook_levin está el enunciado, un esqueleto, el verificador, un decodificador y los casos. El problema
es escribir la reducción: la entrada es una máquina, una cadena y el lado del tableau, y la salida es la
fórmula en DIMACS.
cd lab/cook_levin
make        # compila solution.cpp y decode.cpp
make test   # corre el juez con todos los casos
El esqueleto trae la lectura, la numeración de las variables y el grupo 1. Ustedes escriben los otros tres:
la primera fila, las ventanas y la aceptación. solution.cpp se escribe sin incluir los encabezados de esta
carpeta, que ya tienen todo resuelto; pueden leerlos cuanto quieran.
Una fórmula no es única, y el juez no compara textos. El verificador corre minisat con su fórmula y mira
tres cosas: que la respuesta sea la esperada; que la fórmula admita los tableaux que son ejecuciones que
aceptan; y que rechace varios tableaux que no lo son, cada uno elegido para que falle un solo grupo. Así una
fórmula a la que le falta un grupo no pasa por casualidad. Después del juez, el enunciado pide decodificar el
tableau, compararlo con su simulador de la semana 7 y contar variables y cláusulas para , 10 y 20.
Resumen
- si una función de tiempo polinomial traduce en sin cambiar la respuesta. es NP-difícil si todo NP se reduce a él, y NP-completo si además está en NP. Las dos partes se demuestran.
- Si un problema NP-completo está en P, entonces . Para mostrar que un problema nuevo es NP-completo se reduce desde uno conocido hacia el nuevo.
- El primer problema NP-completo no puede salir de una reducción desde otro. Cook-Levin: SAT es NP-completo. La demostración reduce todos los lenguajes de NP a la vez, usando solo que cada uno tiene una máquina no determinista de tiempo .
- El tableau es una tabla con una configuración por fila, entre dos columnas de , de lado . acepta si y solo si existe un tableau que acepta .
- La fórmula tiene una variable por celda y símbolo, y cuatro grupos: cada celda tiene exactamente un símbolo; la fila 1 es la configuración inicial con ; cada ventana de es legal; alguna celda contiene .
- Una ventana es legal si aparece en algún paso de la máquina. Bastan las ventanas porque un paso solo cambia las tres columnas del cabezal, y la ventana que tiene el estado en el centro las ve a las tres. Es la localidad de las historias de cómputo de la semana 10.
- La fórmula tiene variables y literales, y se escribe en tiempo polinomial sin ejecutar la máquina. No simula: describe cómo se ve una ejecución que acepta.
- Una reducción conserva que la fórmula sea satisfacible, no que sea equivalente. Con variables nuevas se pasa a CNF sin crecimiento exponencial, y se parten las cláusulas largas en cláusulas de tres literales: 3-SAT es NP-completo.
- Con eso, las reducciones de Algoritmos quedan completas hasta el fondo, y todos los problemas NP-completos son reducibles entre sí: basta que uno esté en P para que todos lo estén.
- HAMPATH es NP-completo: un rombo por variable, que se recorre en uno de dos sentidos, y un nodo por cláusula que se visita con un desvío.
- 2-SAT está en P, por las componentes fuertemente conexas del grafo de implicaciones. El borde entre fácil y difícil pasa entre 2 y 3.
- coNP tiene los lenguajes cuyo complemento está en NP: UNSAT, TAUTOLOGY. . Si un problema NP-completo está en coNP, entonces . Se cree que son distintas, y eso implicaría .
- daría algoritmos polinomiales para todo NP, no necesariamente prácticos. no bastaría para la criptografía. Las dos preguntas siguen abiertas.
- NP-completo habla del peor caso. Un solucionador SAT resuelve fórmulas enormes con estructura, y se atasca con fórmulas pequeñas como el principio del palomar.
Ejercicios
- Para la máquina de
machines/contains_11.tm, escriban a mano el tableau de lado 6 que acepta . Después digan cuál es el menor lado con el que existe un tableau que acepta , y comprueben las dos respuestas contableau_cnf,minisatydecode_tableau. - Para el movimiento de la misma máquina, den dos
ventanas legales de formas distintas y dos ilegales, y expliquen por qué cada una lo es. Comprueben con
build/windows. Es la pregunta de repaso 2. - La máquina
machines/left_end_accept.tmtiene 355 ventanas legales y . Sin correr el programa, calculen cuántas variables y cuántas cláusulas tiene la fórmula detableau_cnfcon . Comprueben con--cuenta. - En la demostración del lema de las ventanas, ¿dónde se usa que la fila de arriba tiene un solo estado?
Den una fila de arriba con dos estados y una fila de abajo tales que todas las ventanas entre ellas sean
legales para
contains_11.tm, y expliquen por qué eso no contradice el lema. - Supongan que se quita de la definición de ventana legal el caso de la aceptación, de modo que una configuración en no tiene fila siguiente. ¿Para qué entradas sigue siendo satisfacible la fórmula? Propongan otro cambio que arregle la demostración sin repetir la configuración, y digan qué grupo de cláusulas habría que modificar.
- La cláusula se parte en una cadena. Escriban la cadena. Para la asignación que hace verdadero solo a , den los valores de las variables nuevas que cumplen la cadena, y digan si son los únicos.
- Demuestren que la construcción de las variables nuevas sigue siendo correcta si se quita la cláusula “a lo sumo una es verdadera”, que nunca pusimos. Después demuestren que deja de serlo si se quita la cláusula larga : ¿qué tableaux admite entonces la fórmula?
- Demuestren que sin hacer ninguna construcción nueva. ¿Qué propiedad de las reducciones usan? ¿Vale también ? ¿Por qué?
- Para la fórmula , tratada como una fórmula en CNF con
cláusulas de dos literales, dibujen el grafo de la reducción a HAMPATH y den un camino hamiltoniano para
cada asignación que la cumple. Comprueben el tamaño del grafo con
build/hampath. - Dibujen el grafo de implicaciones de , encuentren sus componentes fuertemente conexas y den una asignación con el criterio del capítulo. Después agreguen una cláusula de dos literales que la vuelva insatisfacible y muestren el ciclo.
- Demuestren que es cerrada bajo reducciones: si y , entonces . Con eso, demuestren que TAUTOLOGY restringido a fórmulas en CNF está en P. ¿Por qué eso no dice nada sobre SAT en CNF?
- Supongan que tienen una función
sat(f)de tiempo polinomial que solo responde sí o no. Escriban, en pseudocódigo, un algoritmo de tiempo polinomial que encuentre una asignación de una fórmula satisfacible. ¿Cuántas veces llama asat? ¿Qué cambia sisatsolo acepta fórmulas de 3-SAT? - Para programar. Agreguen a
tableau_cnfuna opción que escriba el grupo 3 por la segunda manera, con una cláusula por ventana ilegal, y comparen los tamaños con y paramachines/loop.tm. Comprueben conminisatque las dos fórmulas responden lo mismo, y condecode_tableauque el tableau que sale es una ejecución de la máquina. - Para programar. Escriban un programa que reciba una fórmula de 2-SAT en DIMACS y decida si es
satisfacible con el criterio de las componentes fuertemente conexas. Compárenlo con
minisatsobre fórmulas al azar de 50 variables. Después pásenle la salida dethree_satpara una fórmula cualquiera y expliquen por qué su programa no puede usarse con ella.